Seed Audio 1.0: генератор аудио с ИИ для коротких сериалов и анимации
Создавайте до двух минут диалогов, фоновых звуков, эффектов и полного аудиоряда сцены одним нажатием. Задавайте исполнение, время событий и атмосферу в одном запросе.
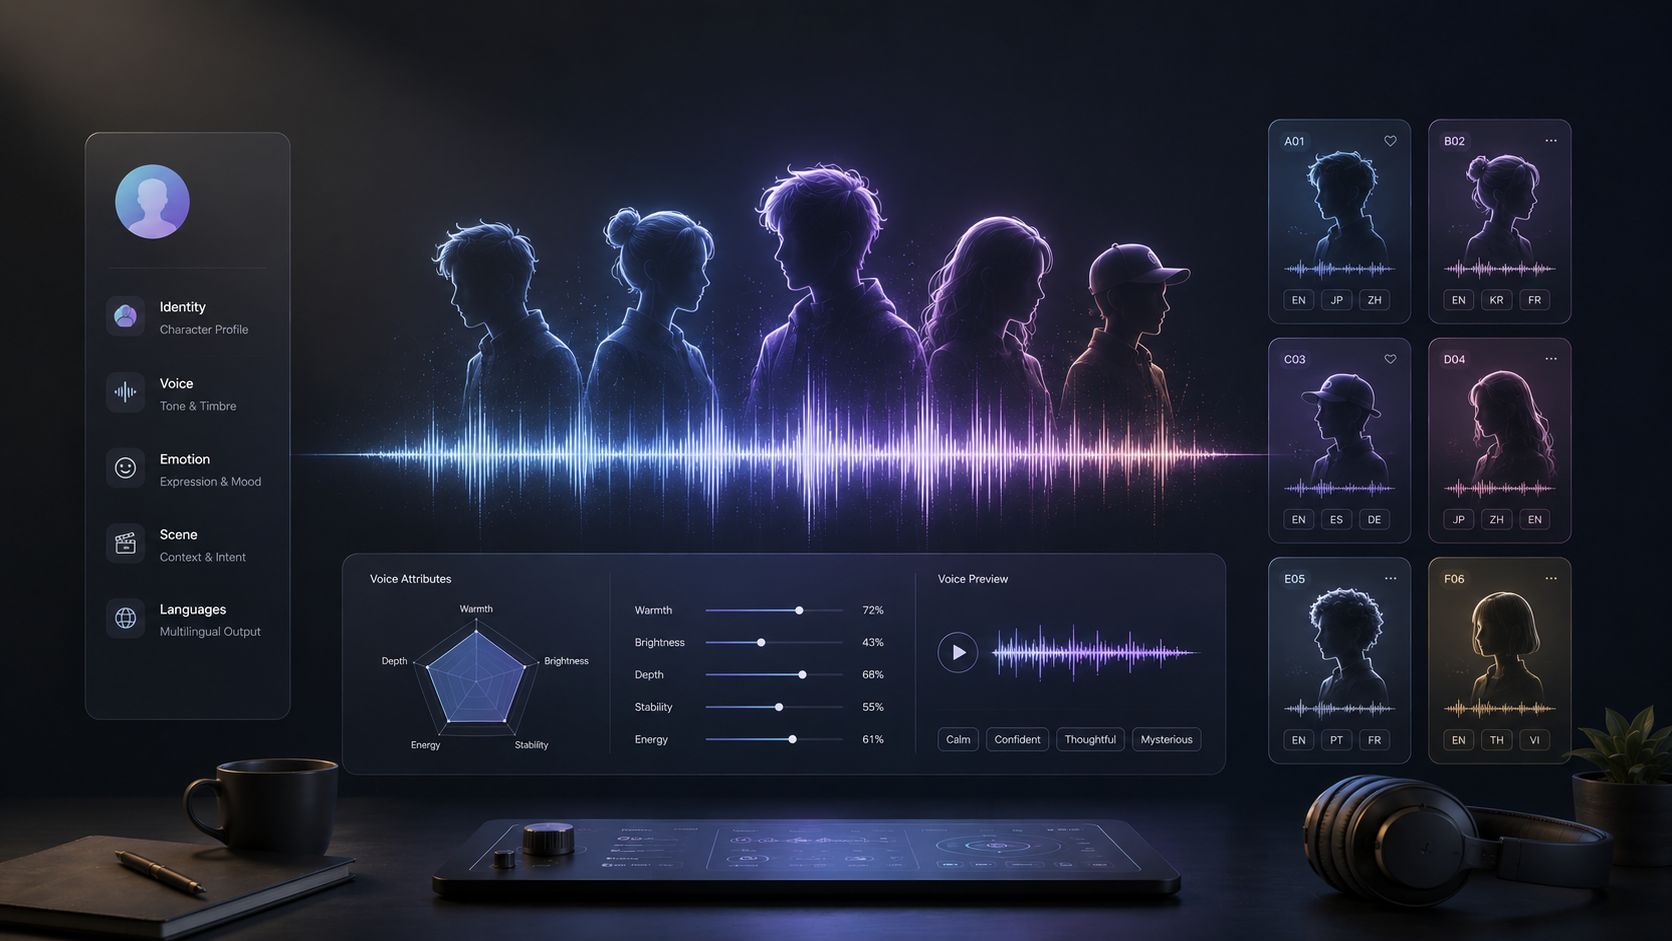
Выберите голос
Нажмите кнопку воспроизведения для прослушивания
日语中年男性人生鼓励音频模板 Prompt to audio
英文女性午夜电台陪伴音频模板 Prompt to audio
日语欢迎回家安慰音频模板 Prompt to audio
韩语旧爱复合电话音频模板 Prompt to audio
雨夜女性晚安 ASMR 音频模板 Prompt to audio
日语夜行电车少女安慰音频模板 Prompt to audio
日语温泉旅馆老板娘晚安音频模板 Prompt to audio
霸凌者忏悔AI语音提示词 Prompt to audio
Почему Seed Audio 1.0 подходит для озвучивания сцен
Создавайте полный аудиоряд сцены за одну генерацию
Диалоги, звуки окружения, музыка и эффекты создаются вместе, с готовым балансом громкости. Во время реплик музыка автоматически становится тише. Вы получаете готовую дорожку, а не четыре отдельных слоя, которые ещё нужно сводить.
Создавайте полный аудиоряд сцены одним нажатием
Опишите сцену в порядке событий — аудио будет следовать ему с точностью до 100 миллисекунд. Третья реплика прозвучит третьей, а дверь откроется именно между теми репликами, где это указано. Так монтаж можно выстраивать по аудио, а не подгонять звук под готовый видеоряд.
Генерируйте до 2 минут аудио
Этого хватит для целой сцены или законченного закадрового текста с одним и тем же голосом от первого слова до последнего. Если сцена длиннее, продолжите с того места, где остановились.
Озвучивайте персонажей на более чем 20 языках
Китайский, английский, японский, корейский, испанский, немецкий, французский, тайский, вьетнамский и другие языки — выпускайте сериал на нескольких языках без нового подбора голосов.
Как пользоваться Seed Audio 1.0 в Arcloop
Выберите голос
Выберите голос персонажа или добавьте подходящий сцене голосовой референс, на использование которого у вас есть разрешение.
Опишите сцену
Введите диалог и задайте эмоции, темп, время событий, звуки окружения и нужные эффекты.
Создайте аудио
Создайте сцену, прослушайте результат и уточняйте запрос, пока голоса и звуки не будут соответствовать вашему замыслу.
Как написать запрос для Seed Audio 1.0
Seed Audio читает запрос как сценарий: кто говорит, как звучит голос и что происходит между репликами. Один раз опишите голос каждого персонажа, затем запишите сцену в порядке событий.
Пример запроса
Робот-охранник (робот с ИИ, монотонный низкий голос, медленный темп): «Сеанс истёк».

Фэй (молодая девушка, ясный звонкий голос, торопливая речь) говорит: «Нет, пожалуйста, это срочно. Мне нужно передать сообщение».

Робот-охранник говорит: «Не удалось подтвердить гражданство. Вас проводят в камеру задержания».

Открывается большая механическая дверь, и к Фэй подходит мужчина.

Джет (мужчина в возрасте, глубокий низкий голос, ровный темп) говорит: «Фэй, прошу прощения за неудобства. Идёмте со мной».
Опишите голос персонажа при первой реплике.
Укажите в скобках возраст, особенности голоса и темп. Дальше достаточно писать «Имя говорит:» — голос сохранится.
Выделяйте звуки и действия в отдельные строки.
Описывайте события между репликами в том порядке, в котором они происходят. Слово «одновременно» само по себе не заставляет модель наложить звуки. Если эффект должен прозвучать внутри реплики, разделите её на две части и поместите эффект между ними.
Помечайте музыку как звуковое сопровождение.
Напишите «Soundtrack:», опишите музыку и её длительность. Одно лишь описание настроения часто превращается в двухсекундный эффект вместо музыкального сопровождения.
Добавьте референс, если важно сохранить голос.
Текстовое описание само задаёт голос. Если персонаж должен одинаково звучать в разных эпизодах, загрузите до трёх клипов по 30 секунд и используйте этот образец для всех его реплик.
Советы экспертов в блоге
Практические руководства по настройке голосов, составлению запросов и созданию аудио в ArcLoop.
Seed Audio 1.0 — модель генерации аудио от ByteDance Seed. Она создаёт диалоги, голоса персонажей, звуки окружения, эффекты и другие элементы аудиоряда по тексту и аудиореференсам. Подходит для коротких сериалов, анимации и сюжетного контента.
2. Чем Seed Audio 1.0 отличается от преобразования текста в речь?
Обычный синтез речи в основном озвучивает написанный текст. Seed Audio 1.0 создаёт полноценную аудиосцену: несколько персонажей, эмоции, темп, звуки окружения и эффекты в общем контексте.
Seed Audio 1.0 создаёт аудио длительностью до двух минут. Этого достаточно для длинных диалогов, закадрового текста, анимационных сцен и эпизодов короткого сериала без разделения каждой реплики на отдельный клип.
4. Чем отличаются T2A и A2A?
T2A создаёт новое аудио по текстовому описанию: голоса, диалоги, звуки окружения и эффекты. A2A использует готовое аудио как референс и создаёт новый звук на основе его голосовых или акустических особенностей.
5. Какие языки поддерживает Seed Audio 1.0?
Seed Audio 1.0 поддерживает более 20 языков, в том числе английский, китайский, японский, корейский, французский, немецкий, испанский и тайский. Это удобно для многоязычных персонажей, локализации анимации и международного производства сериалов.
6. Почему один и тот же запрос даёт разное звучание?
Генерация аудио с ИИ не полностью детерминирована: один запрос может давать разную подачу, темп, голоса и звуковые детали. Для более стабильного результата чётко описывайте персонажа, эмоции, время событий, обстановку и звуковые акценты.
7. Seed Audio 1.0 или ElevenLabs: что выбрать для моего проекта?
Seed Audio 1.0 больше подходит для целых аудиосцен, где диалоги, актёрская подача, фоновые звуки и эффекты должны работать вместе. ElevenLabs часто удобнее, когда главное — отдельная генерация голоса, закадровый текст или клонирование голоса. Выбирайте с учётом того, создаёте ли вы полноценную сцену или прежде всего речь.
Модели ИИ
Seedance 2.0
Seedance 2.5
Nano Banana Pro
Kling Omni
GPT Image 2
Seedream 5.0
Grok Imagine
Seed Audio 1.0
ElevenLabs
Seedance 2.0
Seedance 2.5
Nano Banana Pro
Kling Omni
GPT Image 2
Seedream 5.0
Grok Imagine
Seed Audio 1.0
ElevenLabs
Начните с одной сцены
Опишите персонажей, напишите реплики и получите диалоги, звуки окружения и музыку в одном готовом дубле.