Introducción
Un cortodrama puede sobrevivir un fondo imperfecto mucho mejor de lo que puede sobrevivir voces confusas. Tres personajes comparten una escena, pero sus voces nunca se configuraron en los character assets, así que dos roles acaban sonando igual, la cara y la edad de la protagonista cambian entre cortes porque nunca se construyó como un asset persistente, y nadie sabe qué toma fue aprobada. El montaje empieza a sentirse pegado con cinta aunque las imágenes se vean bien.
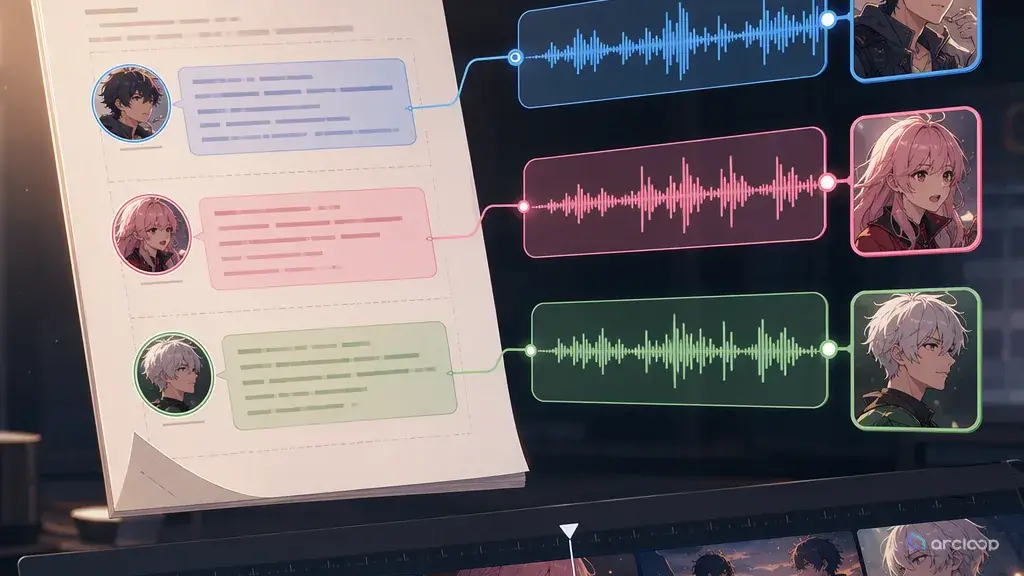
El text to speech con múltiples personajes necesita un plan que parta del guion antes del video final. Abre un mundo creativo, usa las guías de cortodrama IA para mantener el diálogo ligado a los shot cards, y conecta los roles recurrentes con las referencias de Character Sheet para que la misma cara lleve la misma lógica de voz.
Cada rol tiene su propia lane de voz: speaker ID, impresión de edad, textura, ritmo, rango emocional, notas de pronunciación y advertencias de continuidad. Después, la lista de Shot puede decidir qué líneas necesitan labios, cuáles van sobre reacciones y dónde el silencio debe sostener el beat.
Por qué la voz necesita su propia lane
La voz no es solo decoración sonora. Le dice al público quién tiene poder, quién miente, quién esconde dolor y quién cambia. En el cortodrama, donde las escenas avanzan rápido, la voz puede transmitir más contexto que la exposición.
Una lane de voz mantiene la interpretación estable. Define cómo suena un personaje en estado neutro, enojado, asustado, de broma, susurrando o desmoronándose. También define qué no debe cambiar: impresión de edad, acento, velocidad al hablar, calidad aérea, rango de tono y techo emocional.
Las lanes de voz también evitan la confusión entre personajes. Si el guion tiene tres mujeres en la misma habitación, el generador necesita speaker IDs y notas de interpretación bien diferenciadas. «Voz femenina 1» y «voz femenina 2» no son suficientes. Cada voz debe coincidir con el rol, el estatus y la función emocional del personaje.
La ubicación del diálogo también importa. Algunas líneas deben estar en cámara. Otras son más potentes sobre un shot de reacción. Algunas deberían comenzar fuera de cámara antes de que el personaje entre. Si el TTS se crea después del video, el montaje puede no tener suficiente silencio ni tiempo de rostro para sostener la interpretación.
Flujo de trabajo de TTS con el guion primero
Empieza extrayendo todo el diálogo del guion. Conserva los nombres de los personajes, los paréntesis de actuación, las pausas, las interrupciones y el contexto emocional. No aplanar las líneas convirtiéndolas en narración.
Crea lanes de voz para los personajes recurrentes. Para cada lane, escribe el speaker ID, la voz base, el ritmo, el rango emocional, el comportamiento bajo tensión, las notas de pronunciación y las derivas prohibidas. Vincula la lane de voz al mismo ID de personaje que usa la biblioteca de Visual reference.
Marca la ubicación de cada línea. Decide si cada línea es en cámara, fuera de cámara, en voz en off, por audio de teléfono, audio de memoria o sobre un shot de reacción. Esto afecta la duración del Shot y la cámara.
Genera voces de borrador antes del video final. Un primer pase de voz puede revelar que la escena necesita pausas más largas, menos líneas o un orden de Shot diferente. Es más barato corregir el timing antes del render pulido.
Revisa las voces entre escenas. Escucha la continuidad. ¿Sigue sonando el protagonista como la misma persona en la escena tres? ¿La voz pública del villano difiere de la privada de forma intencional? ¿Los picos emocionales ocurren en los momentos correctos?
Aprueba la voz antes del corte final. El video final debe apoyar la interpretación aprobada en lugar de obligar a la voz a encajar en un timing de clip aleatorio.
Ajusta la voz a la cobertura del Shot
La misma línea puede necesitar una cobertura de video diferente según su función. Una confesión puede pertenecer al rostro del personaje porque la boca, los ojos y la respiración importan. Una mentira puede funcionar mejor sobre la reacción del oyente porque el público necesita ver formarse la duda. Una línea amenazante puede empezar fuera de cámara para que la entrada se sienta más pesada.
Planifica esto antes de finalizar el TTS. Si una línea está en cámara, el Shot necesita suficiente tiempo estable de rostro y un encuadre favorable a la boca. Si una línea está fuera de cámara, el Shot puede centrarse en manos, props o reacciones. Si una línea llega por teléfono, la lane de voz debe incluir notas de compresión o distancia sin cambiar la identidad del personaje. La planificación de voz es, por tanto, también planificación de cámara.
Por eso el TTS con múltiples personajes pertenece dentro del flujo de producción y no después de él. La voz le dice al montaje dónde respirar.
Ejemplo 1: especificación de lane de voz
Create multi-character TTS voice lanes for this short drama episode.

Characters:
MAYA, 27, courier, controlled under pressure, hiding grief.
LEO, 30, husband, warm when defensive, avoids direct answers.
AVA, 26, sister, bright public tone, sharp private anger.

For each character, output:
- Speaker ID
- Base voice description
- Pace and pause rules
- Emotional range
- Line delivery risks
- Pronunciation notes
- Forbidden drift
- Example delivery for one neutral line and one emotional line

Rule:
Keep each voice lane stable across scenes unless the script explicitly calls for disguise, phone distortion, or memory audio.
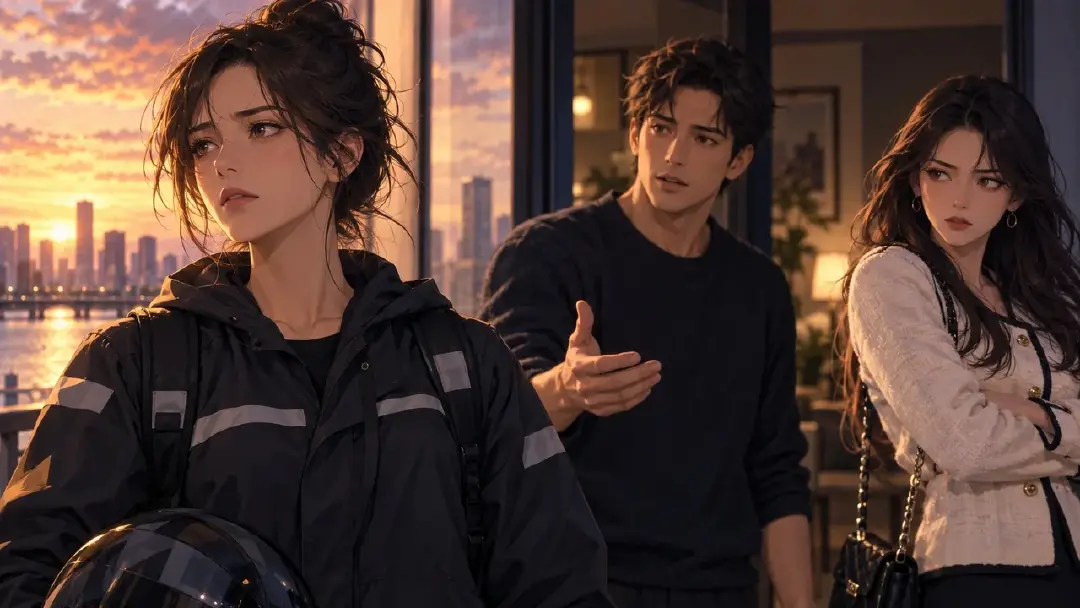
Esto crea continuidad de voz antes de que el episodio se monte.
Ejemplo 2: plan de timing de diálogo
Scene: elevator confrontation

Line plan:
LEO, off camera, low defensive pace:
"You were not supposed to see that."
Placement: start over close-up of Maya's hand holding the contract. Do not show Leo yet.

MAYA, on camera, quiet controlled voice:
"That is the first honest thing you said tonight."
Placement: tight close-up, 0.4 second pause before "honest."

AVA, phone speaker, bright tone turning cold:
"Maya, are you with him right now?"
Placement: phone audio under Maya reaction shot. Slight compression to signal phone source.

Cut rule:
Hold silence for 0.7 seconds after Ava's line before the elevator doors open.
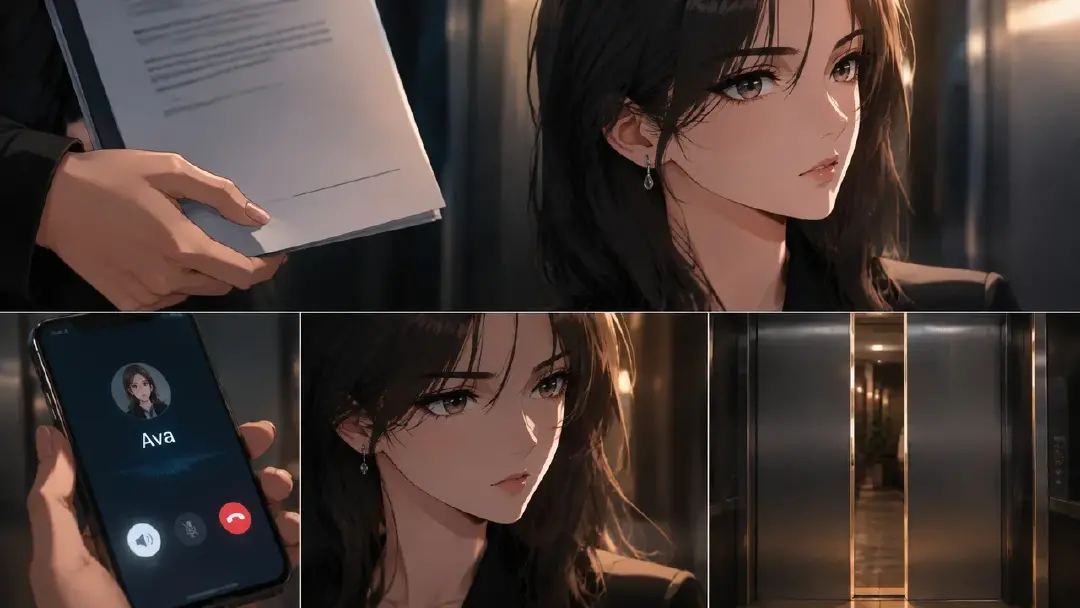
Este plan vincula voz, cámara y timing de montaje.
Ejemplo 3: revisión de continuidad de voz
Review the draft TTS pass for multi-character continuity.

Scenes:
S01 apartment discovery
S02 elevator confrontation
S03 rooftop decision

Check:
1. MAYA keeps the same low, controlled voice across all scenes.
2. MAYA's emotional break appears only in S03, not in S01.
3. LEO's defensive pace speeds up in S02 but does not change age or pitch identity.
4. AVA's phone voice remains recognizable after compression.
5. No speaker lane swaps between reaction shots.
6. Pauses leave enough room for the planned close-ups.
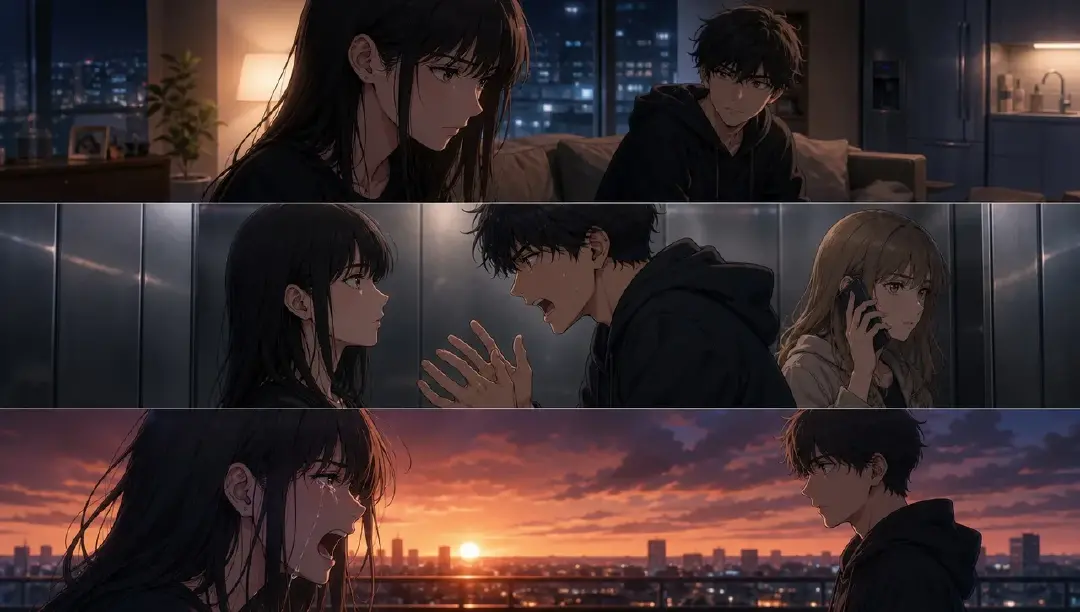
Esta revisión detecta la deriva de voz antes del ensamblaje final.
Errores frecuentes
El error más grande es generar voces después de que el montaje está bloqueado. El timing del diálogo debe dar forma al montaje, no pelearse con él.
Otro error es usar voces similares para personajes parecidos. Un reparto necesita contraste en ritmo, textura, cadencia y comportamiento emocional.
Los creadores también olvidan las líneas fuera de cámara. La voz fuera de cámara puede crear tensión, pero igualmente debe estar vinculada a un speaker ID.
Por último, no sobreactúes cada línea. El cortodrama necesita picos y contención. Si cada línea suena como un clímax, el clímax real no tiene a dónde ir.
Preguntas frecuentes
¿Cuántas lanes de voz necesita un cortodrama?
Crea una lane para cada rol con diálogo recurrente, más lanes separadas para narrador, audio de teléfono, audio de memoria o voz disfrazada si el guion las necesita.
¿Debo generar la voz antes o después del video?
Genera un borrador de voz antes del video final. Ayuda a establecer la duración de los Shot, el timing de las reacciones, las pausas y los puntos de corte.
¿Cómo mantengo la consistencia de voces entre episodios?
Reutiliza los speaker IDs, las descripciones de voz, las reglas de ritmo, las notas de pronunciación y los límites emocionales. Revisa las nuevas líneas frente a la lane de voz aprobada antes de la mezcla final.