引言
AI 漫剧可以忍受粗糙背景,却很难忍受让人分不清角色的声音。场景里有三个人,但没人把声音绑到对应的角色资产上,于是两个角色说话是同一种语气;女主没有建成一个持续复用的角色资产,脸和年龄感在镜头之间跟着变;也没人说得清哪条配音才是审核通过的那条。即使画面还不错,剪辑也会像后期硬拼起来的。
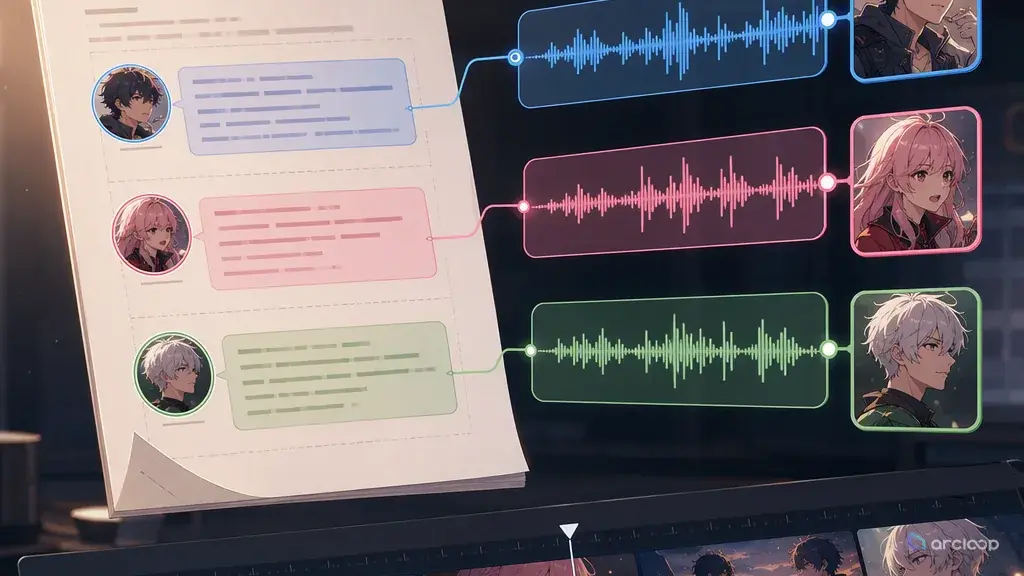
多角色文本转语音需要在最终视频前先做剧本优先的计划。打开 创作世界,用 AI 短剧指南 把对白和镜头卡绑在一起,再通过 人物三视图 连接常驻角色,让同一张脸承载同一套声音逻辑。
每个角色都要有一条声音轨道:说话人 ID、年龄感、声线质感、语速、情绪范围、发音备注和连续性警报。然后分镜表再决定哪些台词需要对口型,哪些台词放在反应镜头上,哪些地方该用沉默稳住节拍。
为什么声音需要自己的轨道
声音不是音频装饰。它告诉观众谁掌控局面,谁在撒谎,谁在藏痛,谁发生了变化。AI 漫剧节奏快,声音承担的上下文有时比解释性台词更多。
声音轨道能稳住表演。它定义角色在中性、愤怒、害怕、开玩笑、低声耳语或崩溃时听起来是什么样。它也定义哪些不该变:年龄感、口音选择、说话速度、气息感、音高范围和情绪天花板。
声音轨道也能避免说话人混乱。如果剧本里三个女性角色同处一室,生成前就需要说话人 ID 和清晰不同的表演备注。"女声 1" 和 "女声 2" 不够用。每条声音都应该匹配角色的身份、地位和情绪功能。
对白位置同样重要。有些台词应该让角色出镜说。有些放在听者的反应镜头上更有力。有些应该在角色进场前从画外先响起。如果视频做完后才补 TTS,剪辑里可能没有足够的静默或正脸时间承接表演。
剧本优先的 TTS 流程
先从剧本中提取所有对白。保留说话人名字、括号里的表演提示、停顿、打断和情绪上下文。不要把台词压平成人声旁白。
为常驻角色创建声音轨道。每条轨道写清说话人 ID、基础声线、语速、情绪范围、压力下的反应、发音备注和禁止跑偏。把声音轨道和视觉角色资产库里使用的同一个角色 ID 绑起来。
标注台词位置。决定每句台词是出镜、画外、旁白、电话音、回忆音,还是压在反应镜头下。这会影响镜头时长和机位。
最终视频前先生成草稿声音。粗配音能提前暴露这场戏需要更长停顿、更少台词或不同的分镜顺序。在精修渲染前修时间,比之后补救便宜。
跨场景审核声音。听连续性。女主到第三场听起来还是同一个人吗?反派的公开声线和私下声线是有意区分的吗?情绪峰值有没有落在正确时刻?
最终成片前先通过声音审核。最终视频应该服务已经确认的表演,而不是强行让声音去贴随机剪出来的片段时长。
让声音匹配镜头覆盖
同一句台词会因为功能不同,需要不同的视频覆盖。告白可能要落在说话人的脸上,因为嘴、眼神和呼吸都重要。谎言可能更适合压在听者反应上,因为观众需要看到怀疑形成。威胁台词可以先从画外响起,让入场更有重量。
这些都要在 TTS 定稿前规划。如果台词出镜,镜头就需要足够稳定的正脸时间和适合对口型的构图。如果台词在画外,镜头可以专注手部、道具或反应。如果台词来自电话,声音轨道可以加入压缩或距离备注,但不要改变说话人的身份。声音规划本质上也是机位规划。
所以多角色 TTS 应该放在制作流程里,而不是最后补上去。声音会告诉剪辑哪里该呼吸。
示例 1:声音轨道规格
为这集 AI 漫剧创建多角色 TTS 声音轨道。

角色:
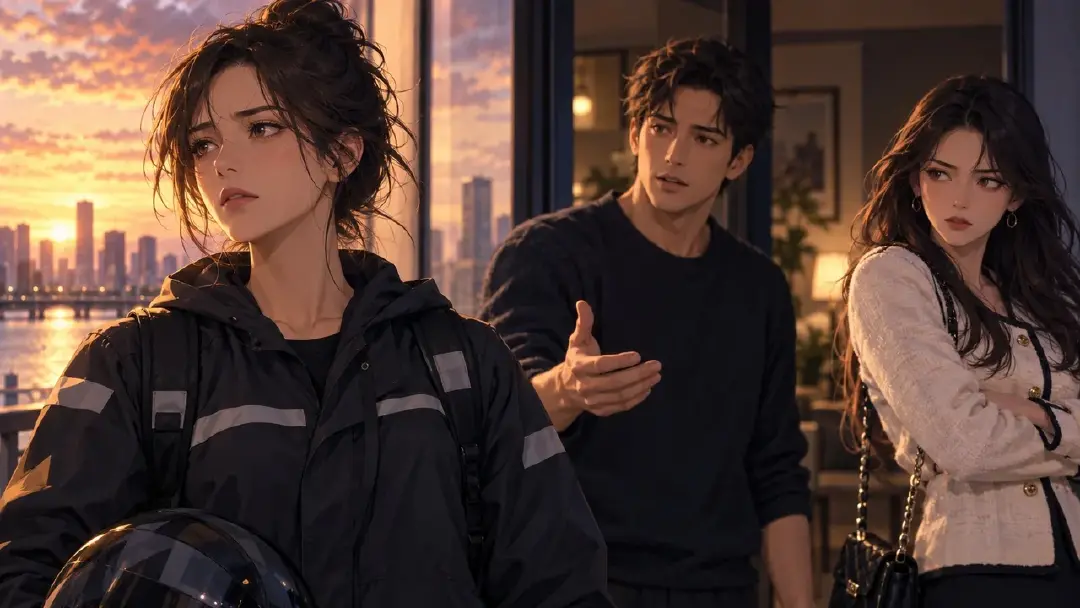
MAYA,27 岁,配送员,高压下保持克制,隐藏悲伤。
LEO,30 岁,丈夫,防御时仍显得温和,回避直接回答。
AVA,26 岁,妹妹,公开场合语气明亮,私下愤怒尖锐。

请为每个角色输出:
- 说话人 ID
- 基础声线描述
- 语速和停顿规则
- 情绪范围
- 台词表演风险
- 发音备注
- 禁止跑偏
- 一句中性台词和一句情绪台词的表演示例

规则:
除非剧本明确要求伪装、电话失真或回忆音频,否则每条声音轨道都要跨场景保持稳定。
这会在剪辑这一集之前先建立声音连续性。
示例 2:对白时间计划
场景:电梯对峙

台词计划:
LEO,画外,低声防御性语速:
"你不该看到那个。"
位置:从 Maya 手握合同的特写开始。暂时不要露出 Leo。

MAYA,出镜,安静克制的声音:
"这是你今晚说的第一句实话。"
位置:紧特写,在"实话"前停顿 0.4 秒。

AVA,电话扬声器,明亮语气转冷:
"Maya,你现在和他在一起吗?"
位置:电话音压在 Maya 的反应镜头下。轻微压缩,提示声音来自电话。

剪辑规则:
Ava 的台词结束后留 0.7 秒静默,再打开电梯门。
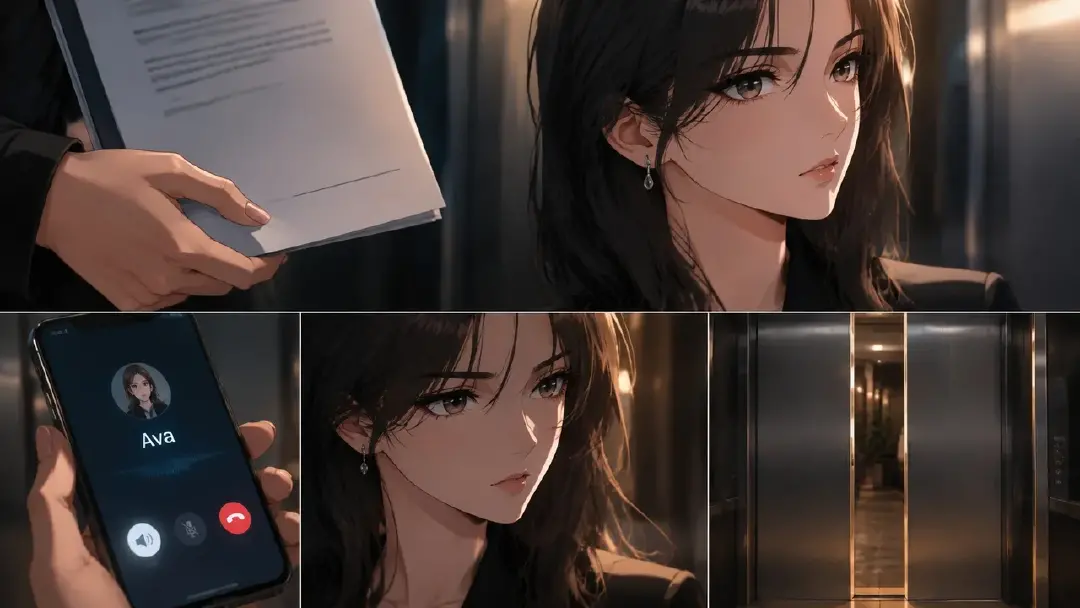
这个计划把声音、机位和剪辑节奏绑在一起。
示例 3:声音连续性审核
审核这版多角色 TTS 草稿的连续性。

场景:
S01 公寓发现
S02 电梯对峙
S03 天台决定

检查:
1. MAYA 在所有场景里都保持同一条低沉、克制的声音。
2. MAYA 的情绪崩口只出现在 S03,不出现在 S01。
3. LEO 在 S02 的防御性语速变快,但年龄和音高身份不变。
4. AVA 的电话声在压缩后仍然能被认出。
5. 反应镜头之间没有说话人轨道互换。
6. 停顿给计划中的特写留出足够空间。
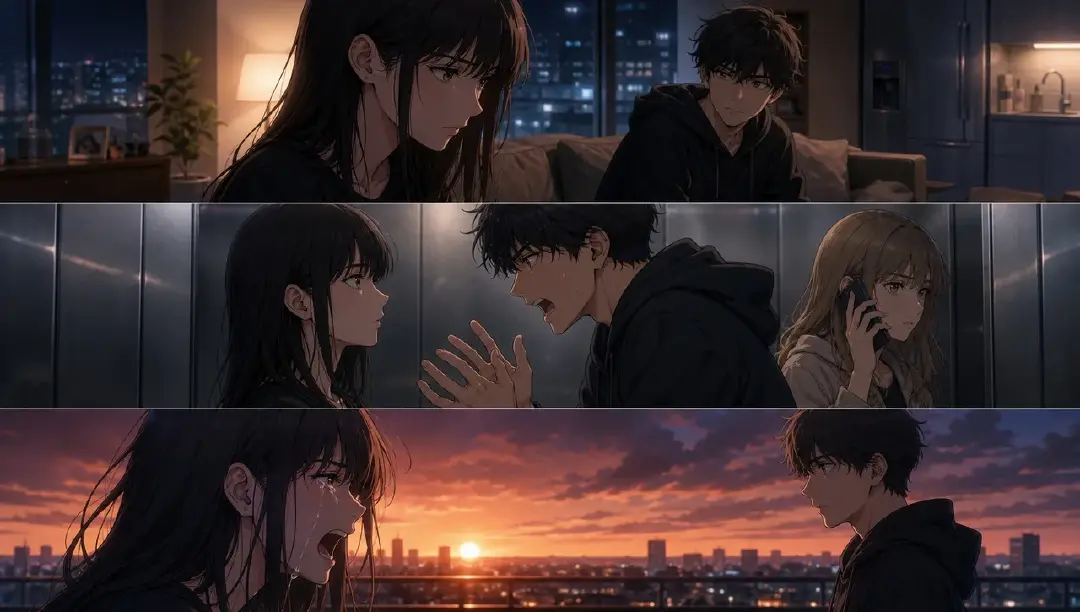
这类审核能在最终合成前抓住声音跑偏。
常见踩坑
最大的坑,是剪辑锁死后才生成声音。对白时间应该塑造剪辑,而不是和剪辑硬撞。
另一个坑,是给相似角色使用相似声音。一个演员阵容需要在语速、质感、节奏和情绪反应上有对比。
创作者也常忘记画外台词。画外声音可以制造张力,但它仍然必须绑定说话人 ID。
最后,不要每句都演到爆。AI 漫剧需要峰值,也需要克制。如果每句都像高潮,真正的高潮就没地方上去了。
FAQ
AI 漫剧需要多少条声音轨道?
每个常驻说话角色一条。如果剧本需要旁白、电话音、回忆音或伪装声,也要单独建轨道。
应该在视频前还是视频后生成声音?
最终视频前先生成草稿声音。它能帮助确定镜头时长、反应节奏、停顿和剪辑点。
怎么让跨集声音保持一致?
复用说话人 ID、声线描述、语速规则、发音备注和情绪上限。最终混音前,把新台词和已审核声音轨道逐条对照。