Introdução
Um drama curto aguenta melhor um cenário imperfeito do que vozes confusas. Três personagens compartilham uma cena, mas as vozes nunca foram definidas nos character assets, então dois papéis acabam soando parecidos, o rosto e a idade da heroína mudam entre os cortes porque ela nunca foi criada como um asset persistente, e ninguém sabe qual take foi aprovado. A edição começa a parecer colada mesmo que as imagens estejam boas.
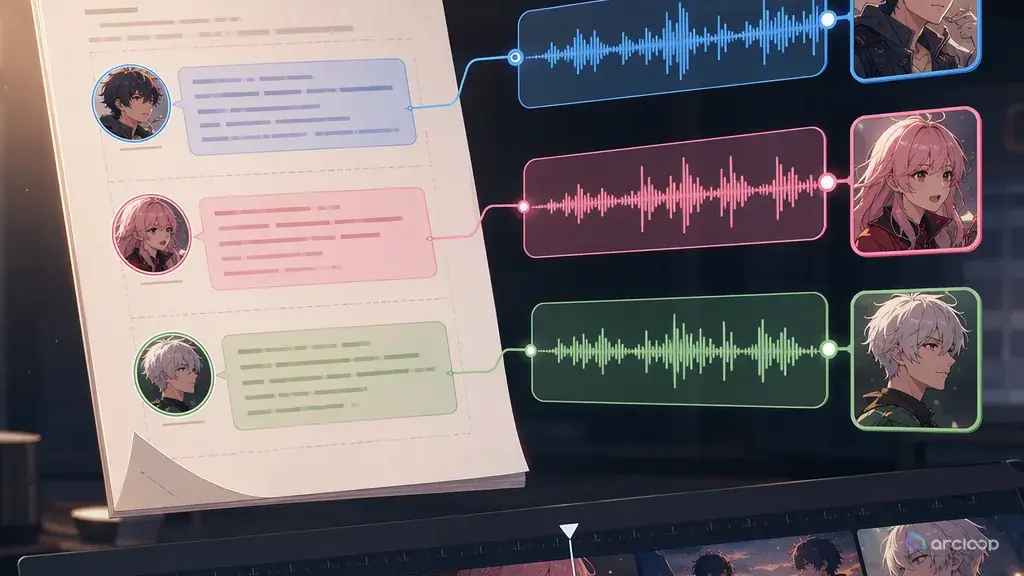
O text to speech multi-personagem precisa de um plano baseado no roteiro antes do vídeo final. Abra um mundo criativo, use os guias de AI Short Drama para manter os diálogos vinculados aos shot cards, e conecte papéis recorrentes com Character Sheet References para que o mesmo rosto carregue a mesma lógica de voz.
Cada papel recebe uma voice lane: ID de falante, impressão de idade, textura, ritmo, alcance emocional, notas de pronúncia e avisos de continuidade. Depois, a lista de Shots pode decidir quais linhas precisam de lábios, quais ficam sobre reações e onde o silêncio deve sustentar o momento.
Por que a voz precisa de sua própria lane
A voz não é só decoração de áudio. Ela diz ao público quem tem poder, quem está mentindo, quem esconde a dor e quem muda. No drama curto, onde as cenas avançam rápido, a voz pode carregar mais contexto do que a exposição narrativa.
Uma voice lane mantém a performance estável. Ela define como um personagem soa quando está neutro, com raiva, com medo, brincando, sussurrando ou se quebrando. Também define o que não deve mudar: impressão de idade, escolha de sotaque, velocidade de fala, respiração, alcance de pitch e teto emocional.
As voice lanes também evitam confusão entre falantes. Se o roteiro tem três mulheres numa mesma sala, o gerador precisa de IDs de falante e notas de performance distintas. "Voz feminina 1" e "voz feminina 2" não bastam. Cada voz deve combinar com o papel, o status e a função emocional do personagem.
O posicionamento do diálogo também importa. Algumas linhas devem estar em câmera. Outras são mais fortes sobre um shot de reação. Algumas devem começar fora de cena antes de o personagem entrar. Se o TTS for criado depois do vídeo, a edição pode não ter silêncio ou tempo de rosto suficiente para sustentar a performance.
Fluxo de trabalho TTS baseado no roteiro
Comece extraindo todos os diálogos do roteiro. Mantenha os nomes dos falantes, parentéticos, pausas, interrupções e contexto emocional. Não planifique as linhas como narração.
Crie voice lanes para personagens recorrentes. Para cada lane, escreva o ID de falante, voz base, ritmo, alcance emocional, comportamento de ênfase, notas de pronúncia e deriva proibida. Vincule a voice lane ao mesmo ID de personagem usado pela biblioteca de Visual reference.
Marque o posicionamento das linhas. Decida se cada linha está em câmera, fora de câmera, como voice-over, áudio de telefone, áudio de memória ou sobre um shot de reação. Isso afeta a duração do Shot e a câmera.
Gere vozes de rascunho antes do vídeo final. Um passe de voz preliminar pode revelar que a cena precisa de pausas mais longas, menos linhas ou uma ordem de Shots diferente. É mais barato corrigir o timing antes de um render polido.
Revise as vozes entre as cenas. Ouça a continuidade. A protagonista ainda soa como a mesma pessoa na cena três? A voz pública do vilão difere da voz privada de forma intencional? Os picos emocionais acontecem nos momentos certos?
Aprove a voz antes do corte final. O vídeo final deve apoiar a performance aprovada em vez de forçar a voz a se encaixar no timing aleatório dos clipes.
Combinando voz e cobertura do Shot
A mesma linha pode precisar de cobertura de vídeo diferente dependendo de sua função. Uma confissão pode pertencer ao rosto do falante porque a boca, os olhos e a respiração importam. Uma mentira pode funcionar melhor sobre a reação de quem ouve, porque o público precisa ver a dúvida se formar. Uma linha ameaçadora pode começar fora de cena para que a entrada pareça mais pesada.
Planeje isso antes de finalizar o TTS. Se uma linha está em câmera, o Shot precisa de tempo de rosto estável e enquadramento adequado para a boca. Se a linha está fora de cena, o Shot pode focar nas mãos, adereços ou reação. Se uma linha vem pelo telefone, a voice lane deve incluir notas de compressão ou distância sem alterar a identidade do falante. O planejamento de voz é, portanto, também planejamento de câmera.
É por isso que o TTS multi-personagem pertence ao fluxo de produção, e não depois dele. A voz diz à edição onde respirar.
Exemplo 1: especificação de voice lane
Create multi-character TTS voice lanes for this short drama episode.

Characters:
MAYA, 27, courier, controlled under pressure, hiding grief.
LEO, 30, husband, warm when defensive, avoids direct answers.
AVA, 26, sister, bright public tone, sharp private anger.

For each character, output:
- Speaker ID
- Base voice description
- Pace and pause rules
- Emotional range
- Line delivery risks
- Pronunciation notes
- Forbidden drift
- Example delivery for one neutral line and one emotional line

Rule:
Keep each voice lane stable across scenes unless the script explicitly calls for disguise, phone distortion, or memory audio.
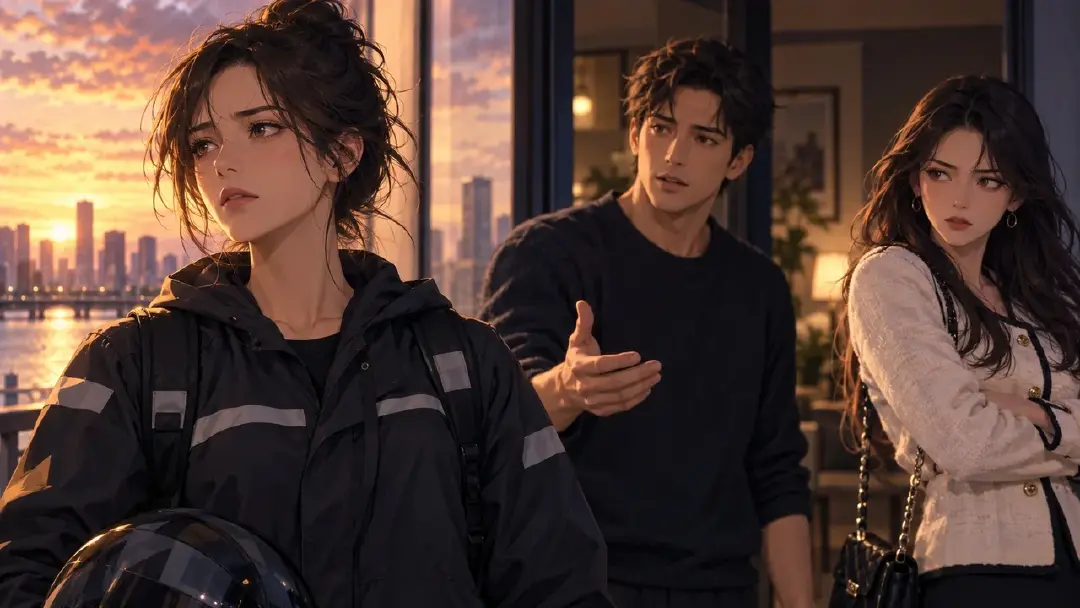
Essa abordagem cria continuidade de voz antes de o episódio ser editado.
Exemplo 2: plano de timing de diálogo
Scene: elevator confrontation

Line plan:
LEO, off camera, low defensive pace:
"You were not supposed to see that."
Placement: start over close-up of Maya's hand holding the contract. Do not show Leo yet.

MAYA, on camera, quiet controlled voice:
"That is the first honest thing you said tonight."
Placement: tight close-up, 0.4 second pause before "honest."

AVA, phone speaker, bright tone turning cold:
"Maya, are you with him right now?"
Placement: phone audio under Maya reaction shot. Slight compression to signal phone source.

Cut rule:
Hold silence for 0.7 seconds after Ava's line before the elevator doors open.
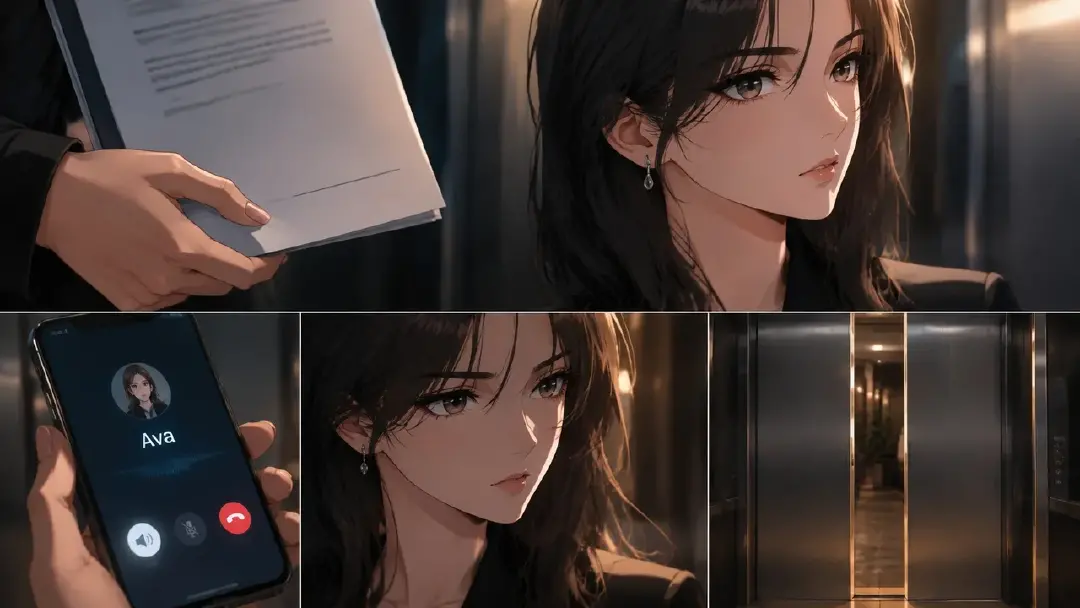
Este plano conecta voz, câmera e timing de edição.
Exemplo 3: revisão de continuidade de voz
Review the draft TTS pass for multi-character continuity.

Scenes:
S01 apartment discovery
S02 elevator confrontation
S03 rooftop decision

Check:
1. MAYA keeps the same low, controlled voice across all scenes.
2. MAYA's emotional break appears only in S03, not in S01.
3. LEO's defensive pace speeds up in S02 but does not change age or pitch identity.
4. AVA's phone voice remains recognizable after compression.
5. No speaker lane swaps between reaction shots.
6. Pauses leave enough room for the planned close-ups.
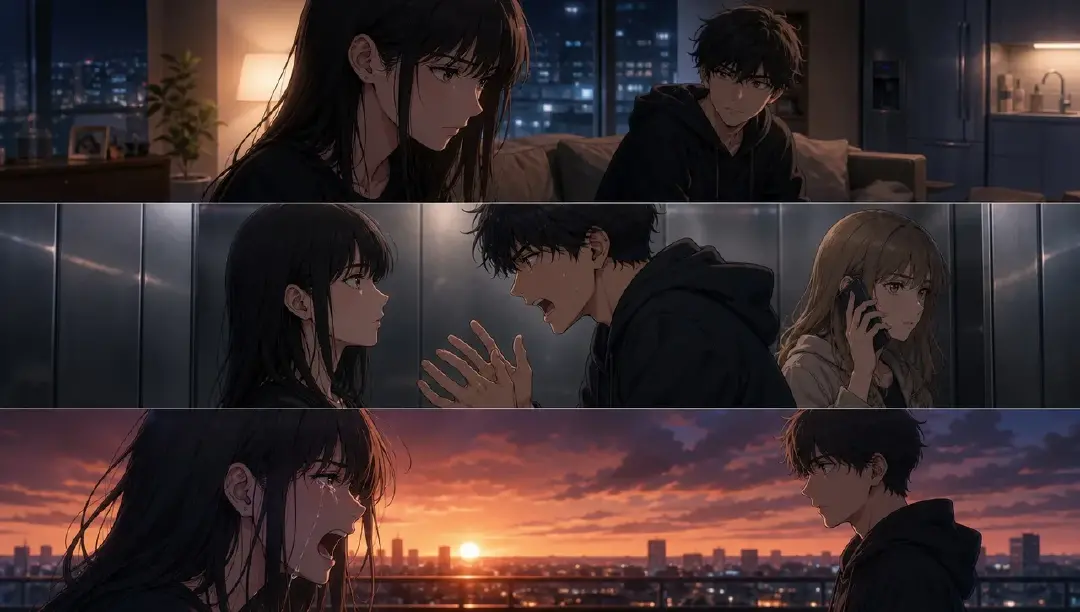
Esta revisão detecta deriva de voz antes da montagem final.
Erros comuns
O maior erro é gerar vozes depois que a edição está bloqueada. O timing do diálogo deve moldar a edição, não brigar com ela.
Outro erro é usar vozes semelhantes para personagens semelhantes. Um elenco precisa de contraste em ritmo, textura, cadência e comportamento emocional.
Os criadores também esquecem as linhas fora de cena. A voz fora de cena pode criar tensão, mas ainda deve estar vinculada a um ID de falante.
Por fim, não exagere em todas as linhas. O drama curto precisa de picos e contenção. Se cada linha soa como um clímax, o clímax real não tem para onde ir.
Perguntas frequentes
Quantas voice lanes um drama curto precisa?
Crie uma lane para cada papel falante recorrente, mais lanes separadas para narrador, áudio de telefone, áudio de memória ou voz disfarçada, se o roteiro precisar.
Devo gerar a voz antes ou depois do vídeo?
Gere um passe de voz preliminar antes do vídeo final. Isso ajuda a definir a duração dos Shots, o timing das reações, as pausas e os pontos de corte.
Como manter vozes consistentes entre os episódios?
Reutilize IDs de falante, descrições de voz, regras de ritmo, notas de pronúncia e limites emocionais. Revise novas linhas em relação à voice lane aprovada antes do mix final.