介紹
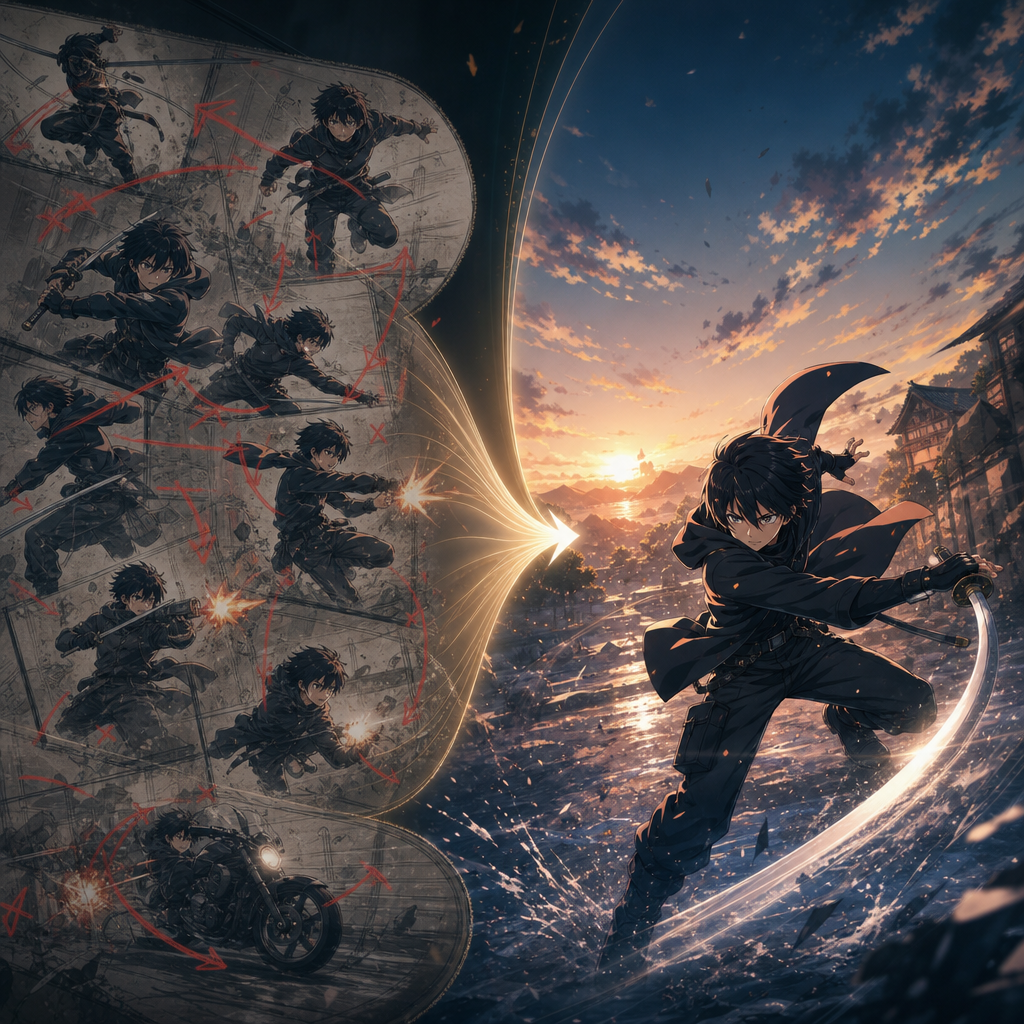
One-shot AI video prompt 失敗的原因很簡單:一個鏡頭有太多任務。你要求角色在詳細城市裡奔跑、跳躍、旋轉、閃避、變身、微笑、抓道具、說話並落到 hero pose,同時鏡頭還在環繞。模型會努力滿足請求的能量,但結果會漂。肢體模糊、臉變化、服裝突變、鏡頭遮住關鍵姿勢,最終 clip 看起來忙,而不是精彩。
這不只是模型限制,也是導演問題。短動漫 clip 需要層級。一個主動作告訴觀眾這個鏡頭在講什麼。兩個輔助動作增加生命力。鏡頭負責框住動作,而不是和動作競爭。所有東西都是主角時,就沒有東西讀得清。
這篇指南講如何把過載的 AI anime video prompt 重寫成受控 shot brief。內容包括原則、逐步重寫法、三組可直接複製 prompt、常見錯誤和 FAQ。需要嚴格單動作參考時,用 單動作舞蹈片段。
核心原則
第一條是短鏡頭只有一個主動作。主動作可以是向前一步、拔劍、旋轉、回頭、伸手或一次衝擊交鋒。
第二條是最多兩個輔助動作。頭髮、衣服、雨、光、塵土、火花、反光或小道具可以圍繞主動作運動。它們不應該變成第二場戲。
第三條是鏡頭克制。移動鏡頭可以增強鏡頭,但應該讓動作更清楚。如果主體在旋轉,鏡頭最好不要也跟著旋。
第四條是穩定結尾幀。以可讀姿勢結束的鏡頭,更容易剪輯、複用和判斷。明確要求結尾。
第五條是動作順序。動詞需要順序。「她轉身、舉起護身符、抬頭看」比「dynamic magical action」更好。
逐步重寫方法
先給 prompt 裡的每個動詞劃線。如果 5 到 8 秒 clip 裡有超過三個主要動詞,它大概率過載了。
選出觀眾必須理解的那個動作。舞蹈 clip 可能是旋轉到結束姿勢。戀愛鏡頭可能是放低雨傘。動作鏡頭可能是一次武器交鋒。
把額外動作移到後續鏡頭。角色可以在鏡頭一注意敵人,鏡頭二拔劍,鏡頭三交鋒。這比把三件事都塞進一個 clip 更便宜、更清楚。
選擇兩個輔助動作。挑能加強主動作的部分。如果主動作是拔劍,輔助動作可以是袖子擺動和地面塵土揚起。
選擇一種鏡頭行為。固定鏡頭、慢推近、側向跟拍、低角度 tilt、俯拍拉遠或手持感漂移都可以,但選一個。
最後寫一致性限制。保留臉、服裝、配飾、道具和身體比例。需要有衝擊但不混亂的動作場景,可以和 機甲衝擊對決 對照。
糟糕與優秀 Prompt 重寫
糟糕 prompt 往往聽起來很燃:「做一個史詩動漫戰鬥,女主跑過城市、跳過汽車、變身、打五個敵人、召喚龍、哭、笑、飛上天空。」它有能量,但沒有層級。模型必須自己發明時長並決定忽略什麼。
好的 prompt 承諾更小:「創建一段 6 秒動漫鏡頭,女主拔劍並擋下一次迎面攻擊。」聽起來沒那麼宏大,卻能產出可用 clip。完整動作戲來自多個可用 clips,而不是一個不可能完成的 clip。
這就是 storyboard 思維的重要性。多動作野心屬於序列層,單動作清晰屬於鏡頭層。
範例 Prompt 1:重寫過載舞蹈 Clip
創建一段 7 秒 2D anime 舞蹈 clip,地點是夜晚街頭表演。原創舞者:短粉髮、黑色短夾克、青綠色裙子、白色球鞋和銀色星星項鏈。主動作:她完成一個乾淨半轉 spin,並面向鏡頭落到銳利最終姿勢,一隻手抬起。輔助動作 1:夾克下擺和裙擺跟隨旋轉形成清楚圓弧。輔助動作 2:霓虹地面反光在她球鞋下脈衝一次。鏡頭:固定全身正面鏡頭,不要環繞,保持從頭到腳可見。乾淨 cel shading,清楚關鍵姿勢,MV 燈光。保留髮型、夾克、裙子、球鞋和項鏈。不要額外舞者,不要跳躍,不要換裝,不要裁腳,不要文字,不要 logo。
clip 仍然有活力,但它只圍繞一個 spin。這就是它能工作的原因。
範例 Prompt 2:重寫過載打鬥鏡頭
生成一段 6 秒 2D anime 動作鏡頭,地點是日出時的廢棄車站。原創女劍士:黑色長馬尾、紅圍巾、藏藍外套、白手套和簡單 katana。主動作:她從刀鞘中拔出 katana,擋下一道迎面而來的影刃,位置在臉前。輔助動作 1:紅圍巾被衝擊風向側面甩出。輔助動作 2:腳邊破裂地磚揚起塵土。鏡頭:低角度三分之四中景,只在拔刀時輕微推近,格擋時有 impact frame,然後停在穩定最終姿勢。保持她的臉、圍巾、外套、手套和 katana 一致。不要多個敵人,不要跳躍,不要變身,不要鏡頭旋轉,不要血腥,不要文字。
這條 prompt 把戰鬥變成一個可讀衝擊 beat。
範例 Prompt 3:重寫情緒場景
創建一段 8 秒 2D anime 情緒鏡頭,地點是安靜雨夜公車站。原創學生:栗色 bob 頭、圓框眼鏡、米色開衫、藏藍書包。主動作:她稍微放低雨傘,向畫面外的聽者靠近一步。輔助動作 1:雨水從傘沿滴進水窪。輔助動作 2:她的手指在書包帶上收緊一次。鏡頭:正面中近景,慢慢推近,無切鏡,無戲劇 zoom。柔和路燈,濕瀝青反光,克制表演。保留眼鏡、開衫、書包和髮型。不要字幕,不要突然大哭,不要擁抱,不要額外角色,不要文字,不要 logo。
這個鏡頭有效,是因為情緒由一個可見動作承載,而不是整段演說。
常見錯誤
最大的錯誤是把動作詞當免費。每個動作都會消耗時長、身體控制和注意力。短片的運動預算很小。
另一個錯誤是用鏡頭運動遮蓋弱動作。如果姿勢不清楚,鏡頭抖動通常只會更糟。
創作者也會組合互相打架的情緒 beat。一個角色無法在六秒內可信地震驚、大笑、哭泣、攻擊又放鬆。
第四個錯誤是過早加入額外角色。多個身體會成倍增加漂移風險。除非鏡頭必須互動,否則從一個角色開始。
最後,不要用 negative prompt 修所有失敗。先減少動作負載,再加限制。
FAQ
短 AI video prompt 可以包含幾個動作?
5 到 8 秒內,使用一個主動作和最多兩個輔助動作。更長序列應該拆成獨立鏡頭。
AI 動漫影片不能有鏡頭運動嗎?
不是。鏡頭運動在澄清動作時很有用。問題從鏡頭也有自己的戲劇弧線、同時主體又在大量運動時開始。
不加更多動作,怎樣讓動作顯得更大?
使用更強的預備動作、更清楚的最終姿勢、光線變化、布料動態、impact frames、塵土、火花或聲音設計說明。規模可以來自強調,而不是額外事件。