为什么这个模式一定失败
One-shot AI video prompt 失败的原因很简单:一个镜头有太多任务。你要求角色在详细城市里奔跑、跳跃、旋转、闪避、变身、微笑、抓道具、说话并落到 hero pose,同时镜头还在环绕。模型会努力满足请求的能量,但结果会漂。肢体模糊、脸变化、服装突变、镜头遮住关键姿势,最终 clip 看起来忙,而不是精彩。
这不只是模型限制,也是导演问题。短动漫 clip 需要层级。一个主动作告诉观众这个镜头在讲什么。两个辅助动作增加生命力。镜头负责框住动作,而不是和动作竞争。所有东西都是主角时,就没有东西读得清。
这篇指南讲如何把过载的 AI anime video prompt 重写成受控 shot brief。内容包括原则、逐步重写法、三组可直接复制 prompt、常见错误和 FAQ。需要严格单动作参考时,用 单动作舞蹈片段。
一个主动作,辅助动作
第一条是短镜头只有一个主动作。主动作可以是向前一步、拔剑、旋转、回头、伸手或一次冲击交锋。
第二条是最多两个辅助动作。头发、衣服、雨、光、尘土、火花、反光或小道具可以围绕主动作运动。它们不应该变成第二场戏。
第三条是镜头克制。移动镜头可以增强镜头,但应该让动作更清楚。如果主体在旋转,镜头最好不要也跟着旋。
第四条是稳定结尾帧。以可读姿势结束的镜头,更容易剪辑、复用和判断。明确要求结尾。
第五条是动作顺序。动词需要顺序。「她转身、举起护身符、抬头看」比「dynamic magical action」更好。
怎么重写过载提示词
先给 prompt 里的每个动词划线。如果 5 到 8 秒 clip 里有超过三个主要动词,它大概率过载了。
选出观众必须理解的那个动作。舞蹈 clip 可能是旋转到结束姿势。恋爱镜头可能是放低雨伞。动作镜头可能是一次武器交锋。
把额外动作移到后续镜头。角色可以在镜头一注意敌人,镜头二拔剑,镜头三交锋。这比把三件事都塞进一个 clip 更便宜、更清楚。
选择两个辅助动作。挑能加强主动作的部分。如果主动作是拔剑,辅助动作可以是袖子摆动和地面尘土扬起。
选择一种镜头行为。固定镜头、慢推近、侧向跟拍、低角度 tilt、俯拍拉远或手持感漂移都可以,但选一个。
最后写一致性限制。保留脸、服装、配饰、道具和身体比例。需要有冲击但不混乱的动作场景,可以和 机甲冲击对决 对照。
对比:改写前后的差异
糟糕 prompt 往往听起来很燃:「做一个史诗动漫战斗,女主跑过城市、跳过汽车、变身、打五个敌人、召唤龙、哭、笑、飞上天空。」它有能量,但没有层级。模型必须自己发明时长并决定忽略什么。
好的 prompt 承诺更小:「创建一段 6 秒动漫镜头,女主拔剑并挡下一次迎面攻击。」听起来没那么宏大,却能产出可用 clip。完整动作戏来自多个可用 clips,而不是一个不可能完成的 clip。
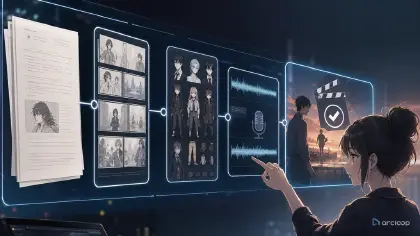
这就是 storyboard 思维的重要性。多动作野心属于序列层,单动作清晰属于镜头层。
示例 1:重写过载舞蹈片段
创建一段 7 秒 2D anime 舞蹈 clip,地点是夜晚街头表演。原创舞者:短粉发、黑色短夹克、青绿色裙子、白色球鞋和银色星星项链。主动作:她完成一个干净半转 spin,并面向镜头落到锐利最终姿势,一只手抬起。辅助动作 1:夹克下摆和裙摆跟随旋转形成清楚圆弧。辅助动作 2:霓虹地面反光在她球鞋下脉冲一次。镜头:固定全身正面镜头,不要环绕,保持从头到脚可见。干净 cel shading,清楚关键姿势,MV 灯光。保留发型、夹克、裙子、球鞋和项链。不要额外舞者,不要跳跃,不要换装,不要裁脚,不要文字,不要 logo。
clip 仍然有活力,但它只围绕一个 spin。这就是它能工作的原因。
示例 2:重写过载打斗镜头
生成一段 6 秒 2D anime 动作镜头,地点是日出时的废弃车站。原创女剑士:黑色长马尾、红围巾、藏蓝外套、白手套和简单 katana。主动作:她从刀鞘中拔出 katana,挡下一道迎面而来的影刃,位置在脸前。辅助动作 1:红围巾被冲击风向侧面甩出。辅助动作 2:脚边破裂地砖扬起尘土。镜头:低角度三分之四中景,只在拔刀时轻微推近,格挡时有 impact frame,然后停在稳定最终姿势。保持她的脸、围巾、外套、手套和 katana 一致。不要多个敌人,不要跳跃,不要变身,不要镜头旋转,不要血腥,不要文字。
这条 prompt 把战斗变成一个可读冲击 beat。
示例 3:重写情绪场景
创建一段 8 秒 2D anime 情绪镜头,地点是安静雨夜公交站。原创学生:栗色 bob 头、圆框眼镜、米色开衫、藏蓝书包。主动作:她稍微放低雨伞,向画面外的听者靠近一步。辅助动作 1:雨水从伞沿滴进水洼。辅助动作 2:她的手指在书包带上收紧一次。镜头:正面中近景,慢慢推近,无切镜,无戏剧 zoom。柔和路灯,湿沥青反光,克制表演。保留眼镜、开衫、书包和发型。不要字幕,不要突然大哭,不要拥抱,不要额外角色,不要文字,不要 logo。
这个镜头有效,是因为情绪由一个可见动作承载,而不是整段演说。
过载提示词还会以方式潜入
最大的错误是把动作词当免费。每个动作都会消耗时长、身体控制和注意力。短片的运动预算很小。
另一个错误是用镜头运动遮盖弱动作。如果姿势不清楚,镜头抖动通常只会更糟。
创作者也会组合互相打架的情绪 beat。一个角色无法在六秒内可信地震惊、大笑、哭泣、攻击又放松。
第四个错误是过早加入额外角色。多个身体会成倍增加漂移风险。除非镜头必须互动,否则从一个角色开始。
最后,不要用 negative prompt 修所有失败。先减少动作负载,再加限制。
常见问题
短 AI video prompt 可以包含几个动作?
5 到 8 秒内,使用一个主动作和最多两个辅助动作。更长序列应该拆成独立镜头。
AI 动漫视频不能有镜头运动吗?
不是。镜头运动在澄清动作时很有用。问题从镜头也有自己的戏剧弧线、同时主体又在大量运动时开始。
不加更多动作,怎样让动作显得更大?
使用更强的预备动作、更清楚的最终姿势、光线变化、布料动态、impact frames、尘土、火花或声音设计说明。规模可以来自强调,而不是额外事件。