Alexander
압도적인 · 매력적인 · 중후한
텍스트를 50개 이상의 언어와 억양으로 자연스럽고 표현력 있는 캐릭터 대사로 바꿔보세요.
숏드라마와 애니메이션을 위해 제작된 인기 음성 프리셋을 들어보세요.
압도적인 · 매력적인 · 중후한

극적인 · 냉정한 · 관능적인

활기찬 · 거친 · 역동적인

장난스러운 · 달콤한 · 엉뚱한
여러 언어로 전체 캐릭터의 자연스러운 대화를 만들어 보세요. 각 캐릭터에 개성 있는 목소리를 주고, 대사의 연기를 조절하며 이야기 전체에서 일관성을 유지할 수 있습니다.
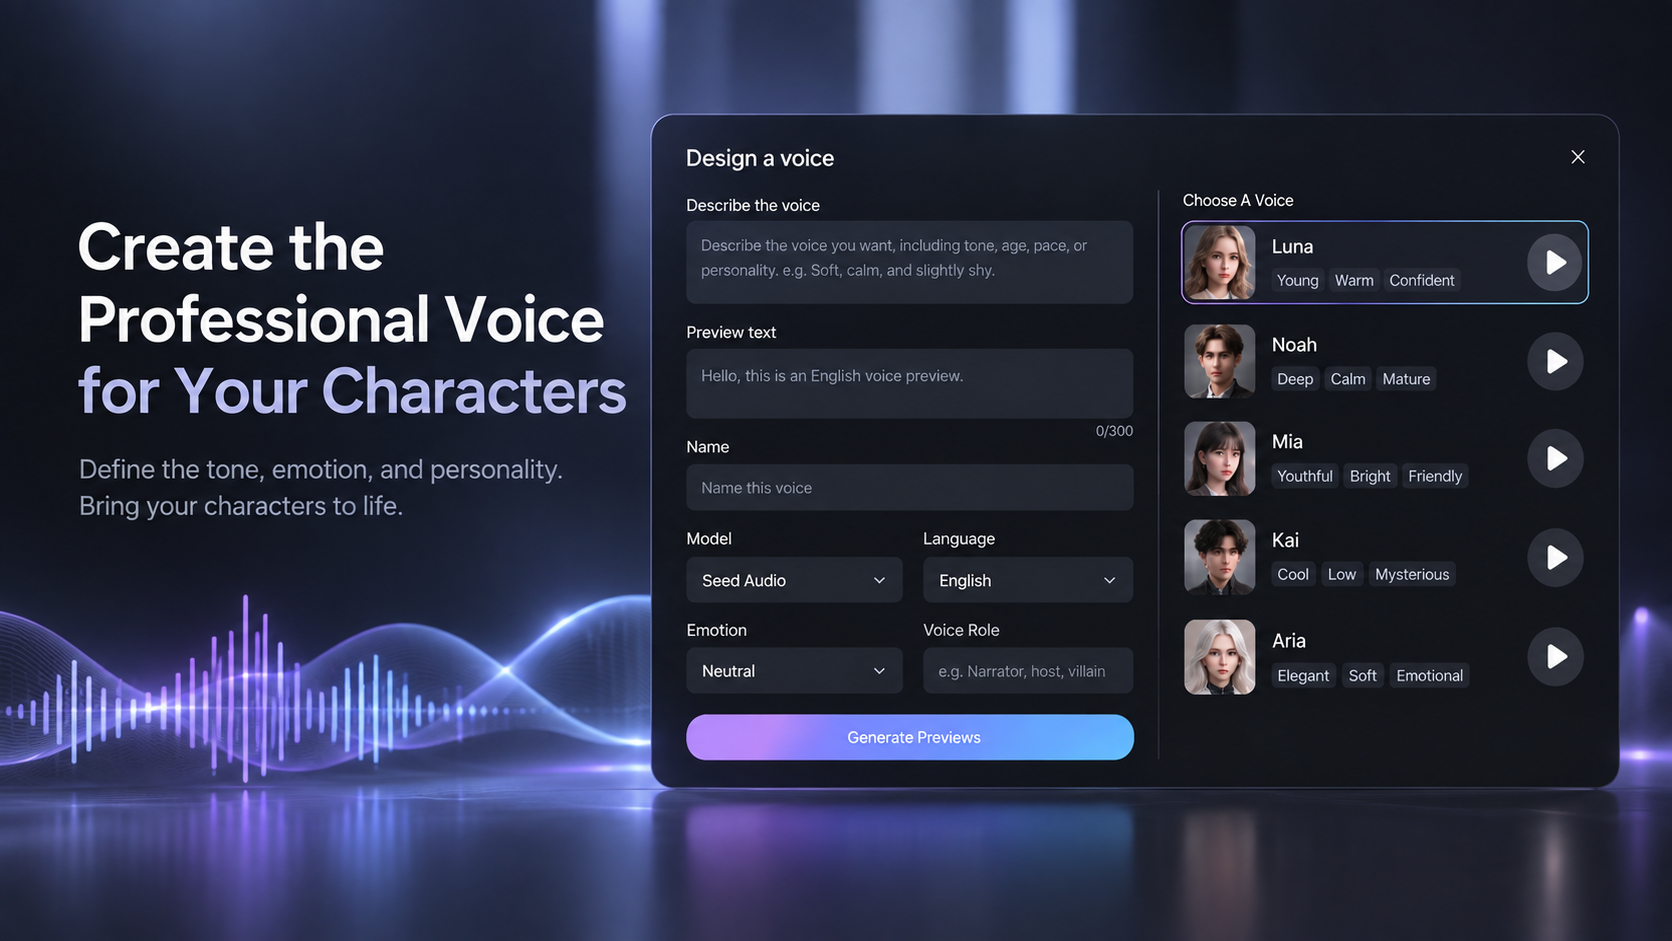
독특하고 자연스러우며 표현력이 풍부한 AI 캐릭터 목소리를 만드세요. 영상 전반에서 캐릭터의 자연스럽고 일관된 목소리를 유지하세요.
자연어로 음색, 나이, 말하기 속도, 개성을 조절해 각 캐릭터의 설정에 맞는 고유한 목소리를 디자인하세요.
캐릭터 목소리를 재사용 가능한 음성 에셋으로 저장하고 다양한 장면, 영상, 에피소드에서 계속 사용해 목소리의 일관성을 유지하세요.
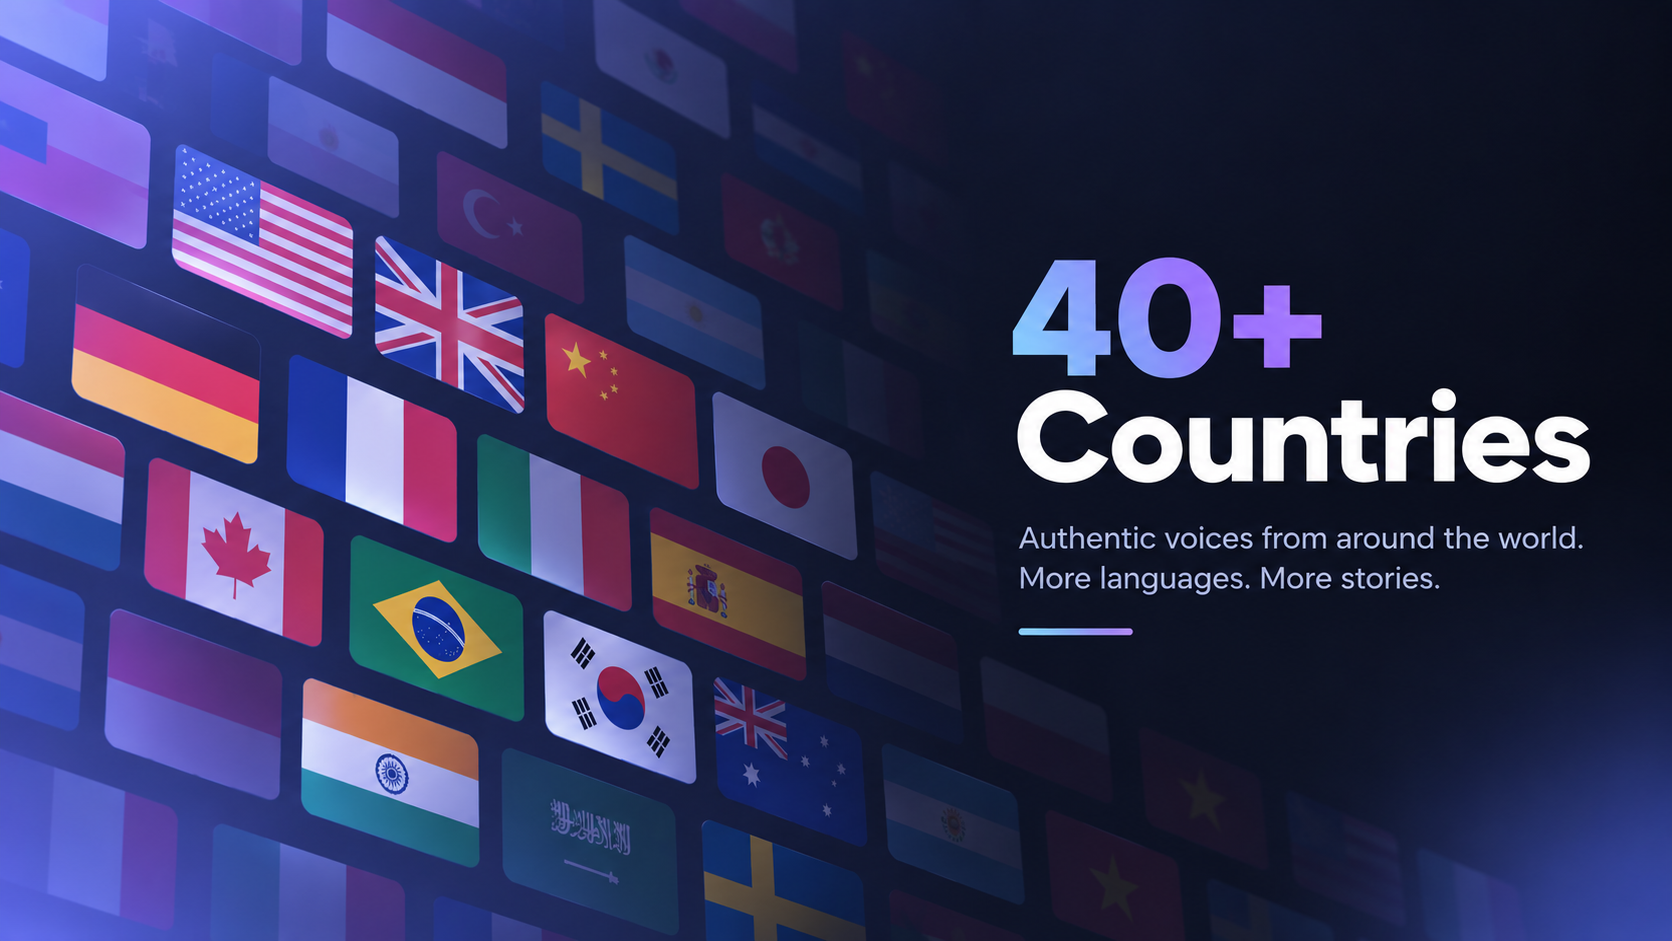
원어민의 말하기 방식에 가까운 발음과 표현으로 캐릭터 목소리를 더욱 자연스럽고 사실적으로 만드세요.
40개 이상 국가 및 지역의 언어와 다양한 억양 중에서 캐릭터의 배경과 지역 설정에 맞는 음성 표현을 선택하세요.
동일한 음성 에셋으로 다국어 영상을 제작해 영상, 숏드라마, 이야기를 전 세계 다양한 지역의 시청자에게 더 쉽게 전달하세요.
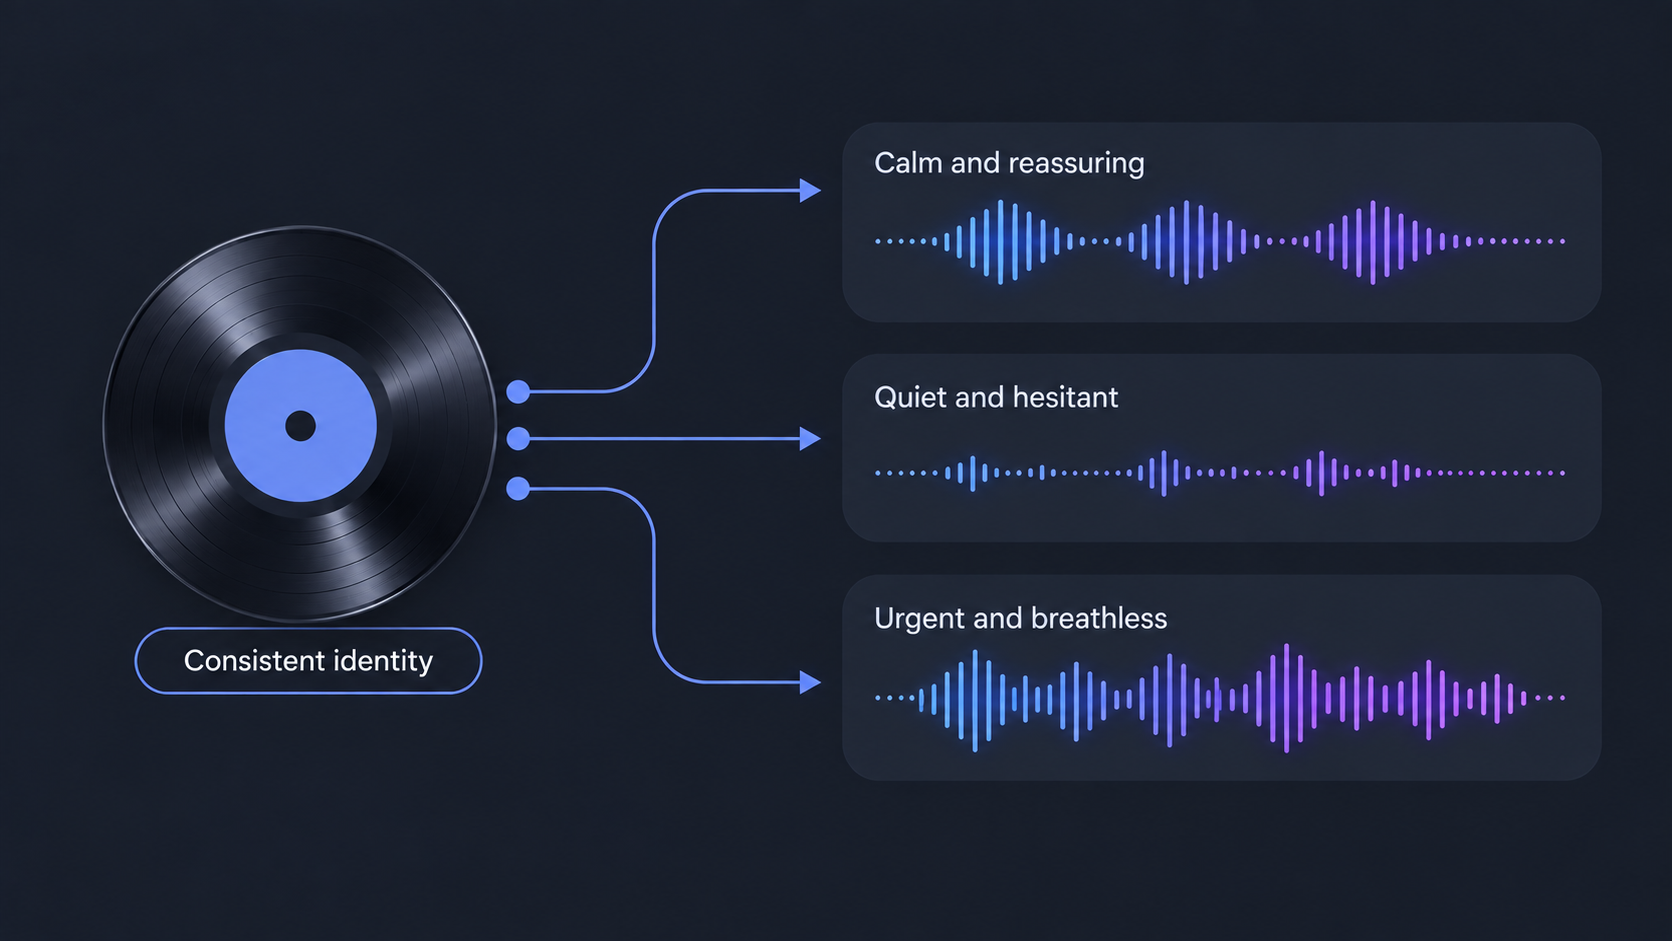
다양한 감정과 표현 강도를 지원하는 자연스럽고 풍부한 감정 표현으로, 대사와 이야기에 따라 캐릭터 목소리가 자연스럽게 변화합니다.
프롬프트로 말투, 리듬, 쉼, 전달 방식을 조절해 단순한 낭독을 넘어 사실적이고 자연스러운 캐릭터 연기를 만드세요.
장면과 캐릭터 상태에 맞는 음성 연기를 구현하고 환경음을 더해 대사의 전달력과 몰입감을 높이세요.
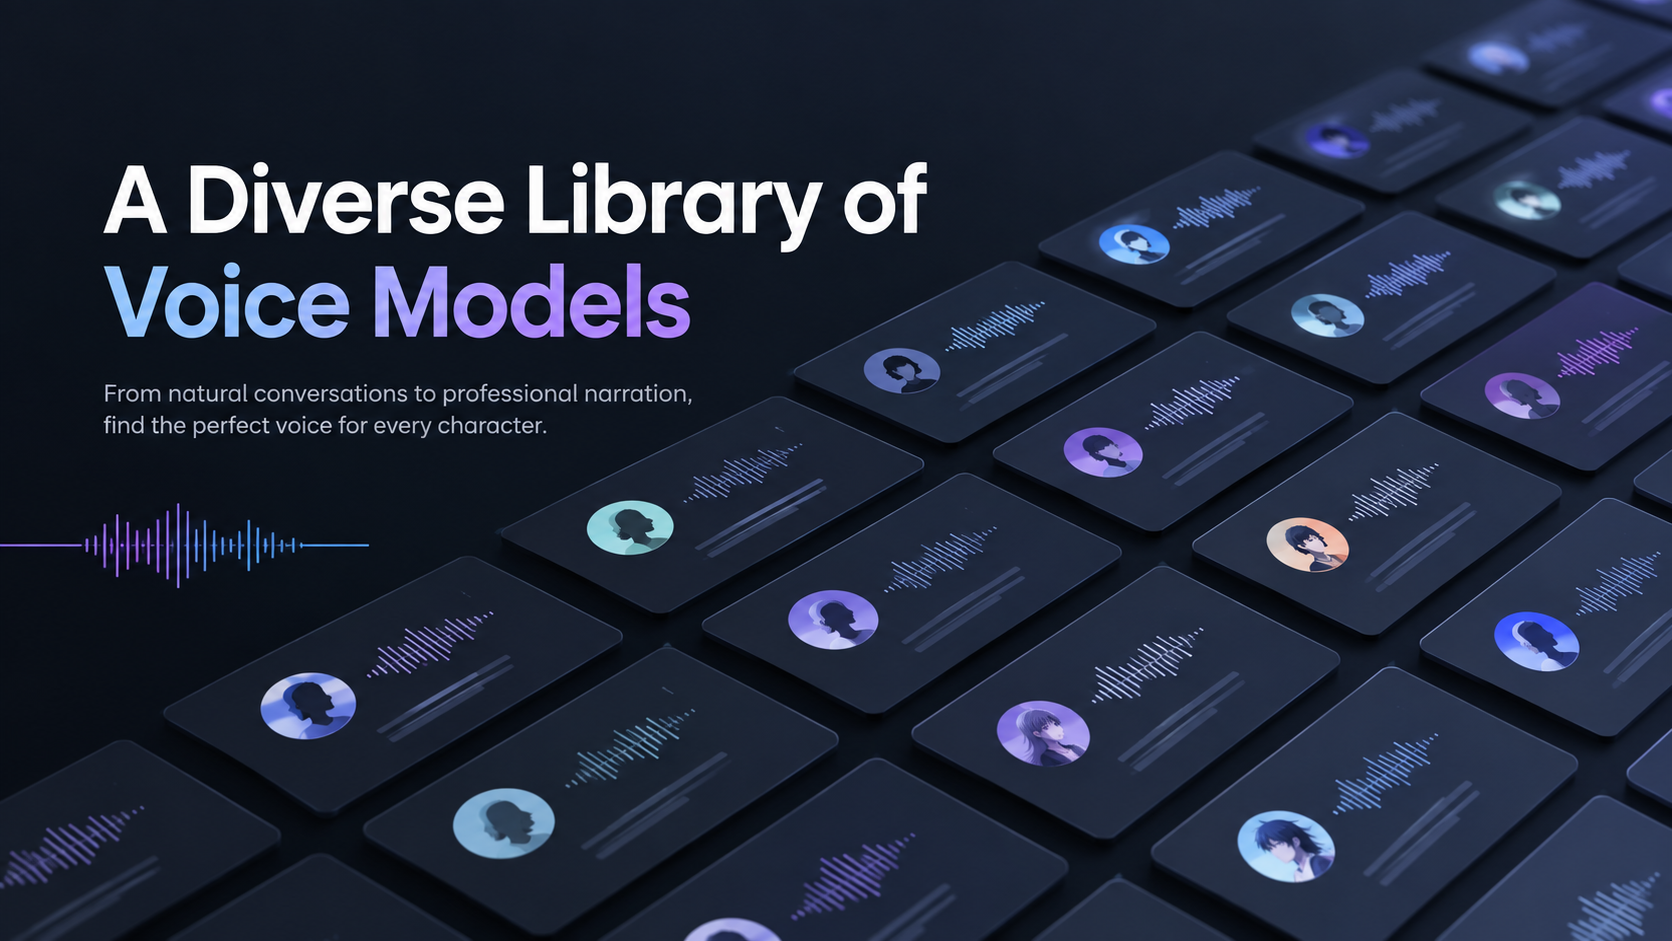
다양한 고품질 AI 음성 모델 중에서 콘텐츠 스타일, 캐릭터 설정, 창작 요구에 맞는 모델을 유연하게 선택하세요.
다양한 나이, 음색, 언어, 캐릭터 유형을 아우르는 라이브러리에서 각 인물 설정에 맞는 목소리를 빠르게 찾으세요.
캐릭터에 가장 적합한 음성 모델을 선택하고 업계에서 경쟁력 있는 모델 가격을 누리세요.
작성한 대사를 스토리에 바로 쓸 수 있는 오디오로 만드는 네 가지 간단한 단계입니다.
언어, 억양, 연령, 스타일과 분위기로 목소리를 찾아보세요. 몇 가지를 미리 듣고 캐릭터에 맞는 목소리를 선택하세요.
한 줄의 대사, 대화 또는 스크립트 일부를 붙여넣으세요. 긴 장면은 짧게 나누면 각 연기를 더 세밀하게 조정할 수 있습니다.
사용 가능한 감정, 속도, 톤과 발음을 조정하세요. 같은 목소리의 개성을 유지하면서 속삭임, 망설임, 다툼, 웃음도 표현할 수 있습니다.
음성을 생성하고 결과를 들어본 뒤 필요하면 다른 테이크를 만드세요. 오디오를 다운로드하거나 ArcLoop 프로젝트에서 계속 작업할 수 있습니다.
반복 등장하는 드라마 캐릭터부터 인터랙티브 캐릭터까지, 이야기를 전달하는 방식에 맞는 목소리를 만들어 보세요.
음성 모델을 선택하고 사용할 수 있는 목소리를 미리 들어보세요. 캐릭터의 목소리를 선택하고 대사를 입력한 다음 사용 가능한 연기 설정을 조정해 오디오를 생성합니다. 녹음 장비나 편집 경험은 필요하지 않습니다.
숏드라마, 애니메이션, 게임, 롤플레이, 팟캐스트, 영상 등 캐릭터 중심 프로젝트의 대화와 내레이션을 만들 수 있습니다. 캐릭터마다 다른 목소리를 지정하거나 하나의 목소리로 내레이션을 만들 수 있습니다.
네. 각 캐릭터에 서로 다른 목소리를 지정하고 대사를 따로 생성하세요. 대화, 장면과 에피소드 전체에서 누가 말하는지 쉽게 알아볼 수 있습니다.
캐릭터에 지정한 목소리를 저장하고 등장할 때마다 같은 선택을 사용하세요. 기본 목소리는 유지하면서 장면마다 감정과 전달 방식만 조절할 수 있습니다.
완전한 문장과 자연스러운 구두점을 사용해 속도와 강조를 안내하세요. 쉼표는 짧은 멈춤을, 마침표는 생각의 구분을 만듭니다. 긴 대화는 캐릭터, 장면 또는 감정 변화에 따라 나누세요.
현재 텍스트 제한은 생성기 안에 표시됩니다. 스크립트가 제한을 넘으면 짧은 장면으로 나누거나 캐릭터별 대사를 따로 생성하세요. 짧은 구간은 속도와 감정을 조절하기도 쉽습니다.
크레딧 사용량은 선택한 음성 모델과 생성하는 텍스트 양에 따라 달라집니다. 필요한 크레딧은 생성 전에 표시됩니다. 다른 테이크나 수정한 대사를 생성하면 추가 크레딧이 사용됩니다.