电话对话在剧本上看起来很简单:两个角色在不同地方说话。但在生成的画面里,相似的背景和模糊的视线很容易让两个地方看起来像同一个房间。光靠台词也会错过最关键的时刻——观众能看见、而另一方完全看不见的那个无声反应。
给每个打电话的人设定一个有辨识度的物理空间、清晰的持机姿势,以及在听电话时有所注视的具体事物。然后决定:在下一句台词开口之前,观众需要先看到哪一方的反应。这篇指南告诉你如何在两个场景之间呈现这种信息差,同时保持通话的空间逻辑。
每个人知道什么——以及只有观众才能看到什么
在建立任何 Shot 之前,先为每位通话者写下三件事:
- 接起电话时他们知道什么。 他们掌握的信息,以及这些信息带给他们的情绪状态。
- 对方能听到什么。 说出口的台词,以及任何他们有意分享——或无意泄露——的声音。
- 只有观众能看到什么。 一只颤抖的手、一个瞥向门口的眼神、一张被翻扣在桌上的照片。
第三层正是电话戏张力的来源。如果 A 得知了某个改变一切的消息,观众会看着 A 在沉默中消化它,然后才开口。B 看不见这一切,观众却看得一清二楚。这个信息差就是这场戏的核心。
用这三个问题的答案来决定下一个镜头该给谁。
为每个场景分别建立资产
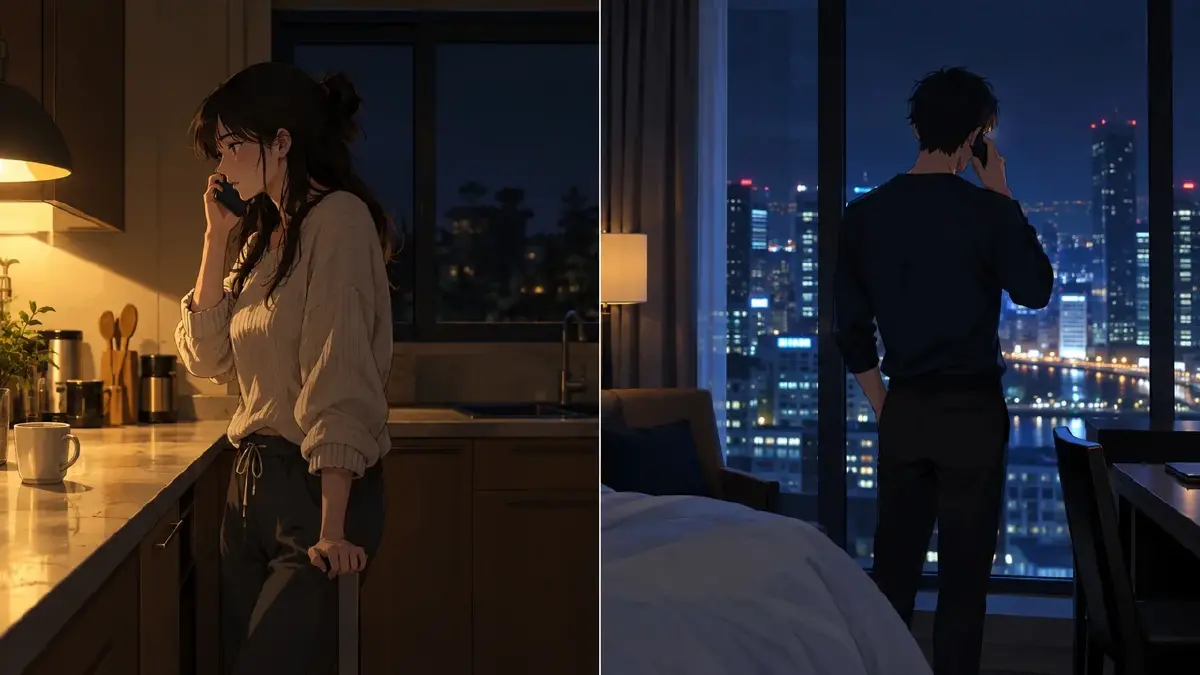
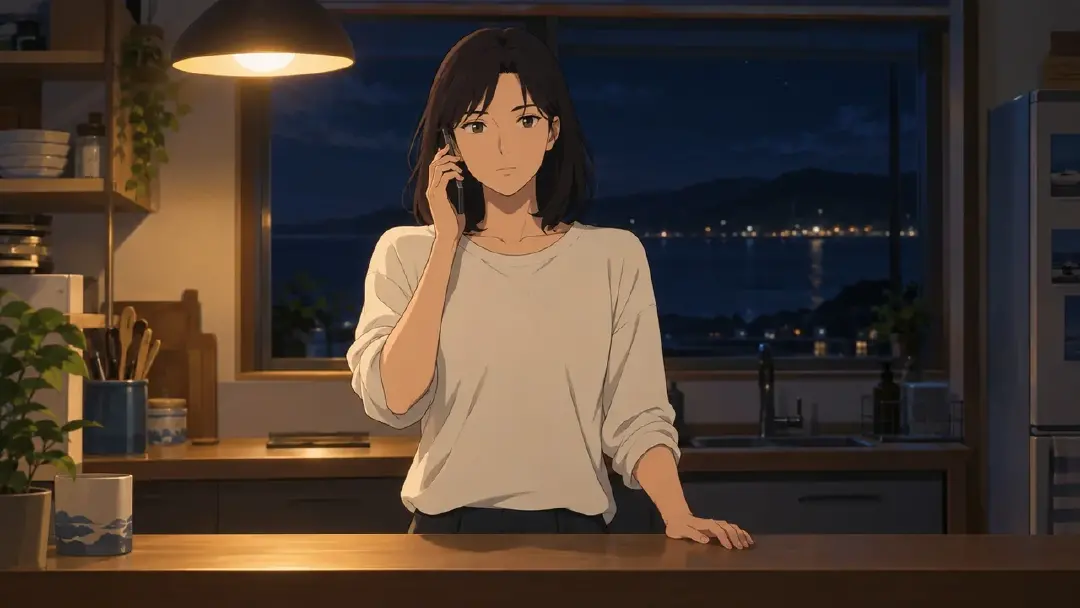
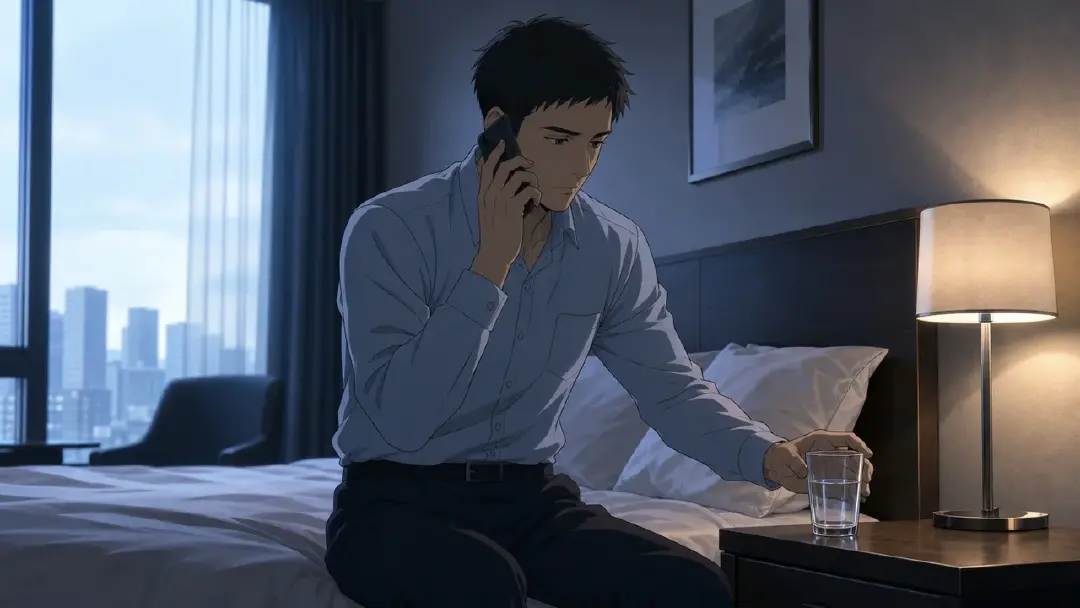
给两个场景设置不同的视觉锚点:一边是厨房操作台和暖色台灯,另一边是酒店床铺和冷调窗户。把两个背景放在一起对比,确保观众不用等人开口就能认出是哪个地方。
在我的资产里创建两个独立的 scene asset,各自对应一位通话者的场景。每个 scene asset 都要绑定一张能呈现真实环境的 Reference image,而不只是配色参考。逼仄的公寓厨房和酒店房间书桌是两个完全不同的 scene asset。把这些参考图设为 Main image,再对照已有的空间逐一检查每个生成画面。
为每位通话者确认其 character asset 并绑定有用的 Reference image。如果有持机参考图能说明姿态,可以和主外形参考图一起绑上。在每个 Shot 描述里,当画面连续性依赖持机手时,明确写出是哪只手拿着电话——asset 参考图代替不了清晰的动作说明。
在我的资产里创建虚构角色的 character asset Nadia 和 Ryo,scene asset NadiaKitchen 和 RyoHotelRoom,以及 prop asset NadiaPhone、RyoPhone 和 WaterGlass,绑定各自的参考图,再通过
@调用。以下案例是原创设计练习,图片展示的是构图方案,并非实际视频输出结果。
把台词、无声反应和回应拆成三个节拍
对于一段潜台词分量很重的对话,可以拆成三个戏剧单元分别拍摄。不必把通话里的每一句话都套进同样的三镜头模式:
节拍一——对方说出的台词。 说话的一方说出这句话,镜头给说话者的脸或身体,台词、构图和表演提示都在这里。
节拍二——无声反应。 在听者开口之前切到他。这是短剧电话戏最容易被忽略的节拍。听者正在消化——观众从他脸上读出刚才那句话的分量。没有台词,只有一个动作,一种情绪。
节拍三——开口回应。 听者变成说话者。继续留在他身上,或换一个同一场景的构图。因为观众已经亲眼看着这句回应在他心里成形,落地时的感觉完全不同。
在沉默节拍能改变后续回应理解方式的时候使用它,不必每句话后面都加。
如何逐个 Shot 地调度电话对话场景
资产建好、节拍规划完成后,打开你的 Episode,用 Generate Shots 生成初始镜头组。AI 会根据你的 Story Outline 生成一套序列。之后逐一检查每张 shot card,对照节拍计划修改或补充镜头。
每次切换到新场景,确认 shot card 里包含了对应的 scene asset 引用。用 @ 明确引用角色和场景——不要在每张 shot card 里从头重新描述房间。已建立的空间用固定的场景引用,再描述新的角度、动作和相关道具接触。先生成图片,对比两个房间没问题后再进行视频生成。
无声反应段落,克制添加台词的冲动。只写动作和取景构图。一段写着「@Nadia 一动不动地站着,盯着水槽上方的墙。通话还在进行,但她没有开口。脸部近景。」的 shot 描述,比塞满叙述性文字强多了。
为每位通话者选定一个角色音色,在准备台词时保持一致。在 Edit 里,对需要的台词使用 Generate Voiceover,然后对照相关 shot 逐一试听。说话人的身份和表达方式需要自己把关——选定音色并不保证每句生成的台词都有预期的情绪和节奏。
在原创案例 Coastal Signal 中,海洋研究员 Nadia 打电话给疏远已久的合作者 Ryo,告知他们的联合研究项目即将被叫停。她在自己家的厨房里,他在全国另一头的酒店。前面有一场戏交代了他在等另一个电话。Nadia 不知道那个电话是关于什么的。
示例 1 — Nadia 说出台词,镜头位于她的厨房:
Medium locked view of @Nadia at the counter in @NadiaKitchen. @Nadia speaks the line, “The department approved the shutdown this morning. I thought you should hear it from me.” @NadiaPhone stays at her right ear and her left hand remains resting on the counter edge. Keep her delivery level, with no added head turn or hand gesture. A warm overhead lamp separates her face from the dark window. One spoken line, no camera movement or cut.
示例 2 — 无声反应段落,Ryo 的位置:
Medium-close locked view of @Ryo seated on the bed in @RyoHotelRoom. @Ryo slowly sets @WaterGlass on the nightstand while @RyoPhone stays at his left ear. Keep the glass, supporting hand and tabletop fully visible, with his face above the action. He remains silent and his posture otherwise still. Cool window light outlines the glass without obscuring its contact with the table. One placement only, with no jaw clench, second gesture, camera movement, or reply.
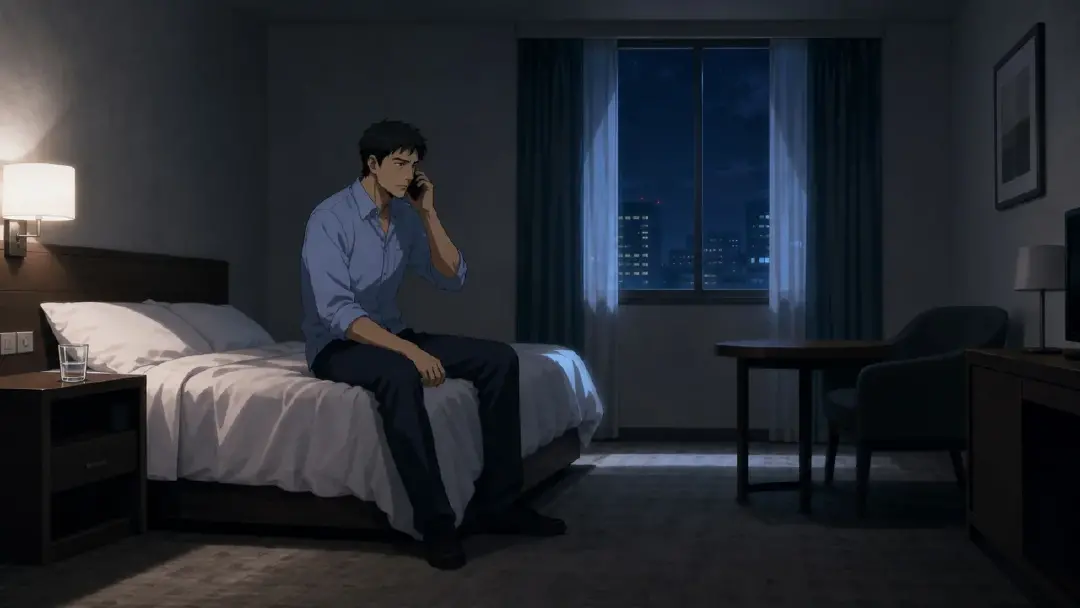
示例 3 — 开口回应,镜头留在倾听者身上:
Wide locked view across @RyoHotelRoom, with @Ryo still seated on the bed and @WaterGlass resting on the same nightstand. @Ryo speaks, “How long have you known?” in a controlled, slower delivery. @RyoPhone remains at his left ear, and his free hand rests on his thigh. Keep the bed, nightstand and cold window visible to establish the unchanged location. One spoken question only; no standing, walking, new gesture, camera movement, or other caller’s reply.
常见问题及如何排查
第一类问题是场景地理不清:观众误以为两个通话者在同一个房间。把所有 shot 连续播放,不开台词,检查背景、电话持握位置和视线方向。修改让人困惑的构图或引用,然后再次检查。相近的视线方向本身不代表出错;关键是所有线索加在一起,能不能让观众看清楚每个位置。
第二类问题是切换镜头后音色不一致。把台词单独播放,不看画面。下一句时,每个通话者听起来还是同一个人吗?重新核对选定的角色音色,修改或替换破坏连贯性的那句台词。情绪变化要和对话内容挂钩,替换后要放在上下文里试听。
第三类问题是遮蔽了必要的反应。如果一句回应本意是掩藏惊讶,但观众根本没机会看到这份惊讶,就需要在这句台词之前补一个反应镜头。在 Edit 里对比时长;停顿应该传递出某种信息,而不是机械地遵守两秒定律。
在 Edit 里组装交替切换的镜头素材
在 Edit 里,根据谁提供了下一个有价值的信息来排列镜头素材。示例中用 A 代表 Nadia 的台词,B 代表 Ryo 的静默动作,再接 B 代表他的回应。严格 A/B 交替在这里会打断叙事节奏,没有必要。
组装好的序列需要检查三件事:
- 说话人辨识。 每次切换时,观众能不能立刻判断自己在哪个位置?如果两个场景看起来相似,每个 shot 的第一帧需要更强的视觉锚点。
- 反应因果。 每句回应是否真的建立在对方实际传达的信息之上?当无声反应能改变观众对下一句回应的理解时,就让观众看到这段反应;直接的口头回应同样可以做到清晰。
- 各位置内部的连贯性。 保持持机手、家具和道具状态一致。如果有人在剪辑省略的时间里移动了位置,要清楚地交代新位置;不是每次合理的移动都需要一个走路镜头。
对选定的台词使用 Generate Voiceover,配合剪辑检查音频。静默的倾听者可能仍然能听到对方的声音,所以要区分「这个角色没有开口说话」和「整个声轨是静音的」。不要依赖未经验证的电话滤波效果来识别说话人。
同一空间内的对话场景,参见对话场景指南。跨多角色的配音规划,参见多角色配音指南。打开你的 ArcLoop 项目,准备好两个场景,然后把台词、反应和回应放在一起测试。
常见问题
两个位置需要分成两个独立的 Episode 吗? 不需要。两个位置都在同一个 Episode 和 Storyboard 里。区分是通过 scene asset 和 shot card 描述来实现的,和 Episode 结构无关。
同一个角色的说话镜头和倾听镜头可以用同一个 character asset 吗? 可以。一个 character asset 覆盖该角色的所有镜头。在 shot 描述里写清楚姿势和情绪状态——asset 负责身份,描述负责每个 shot 里的新内容。
如果无声反应段落生成出来嘴是张开的怎么办? 修改 shot 描述,明确说明角色没有说话——「沉默」、「没有回应」或「手持电话,不出声」。一个 shot 描述只写一个动作,可以有效减少画面歧义。
画外音需要加电话滤镜效果吗? 远距离或压缩感的音效是可选的。先通过画面、台词顺序和反应镜头把说话人和所在位置交代清楚。在 Edit 里听一下实际生成的音频,别让故事依赖一个生成结果还没做出来的效果。