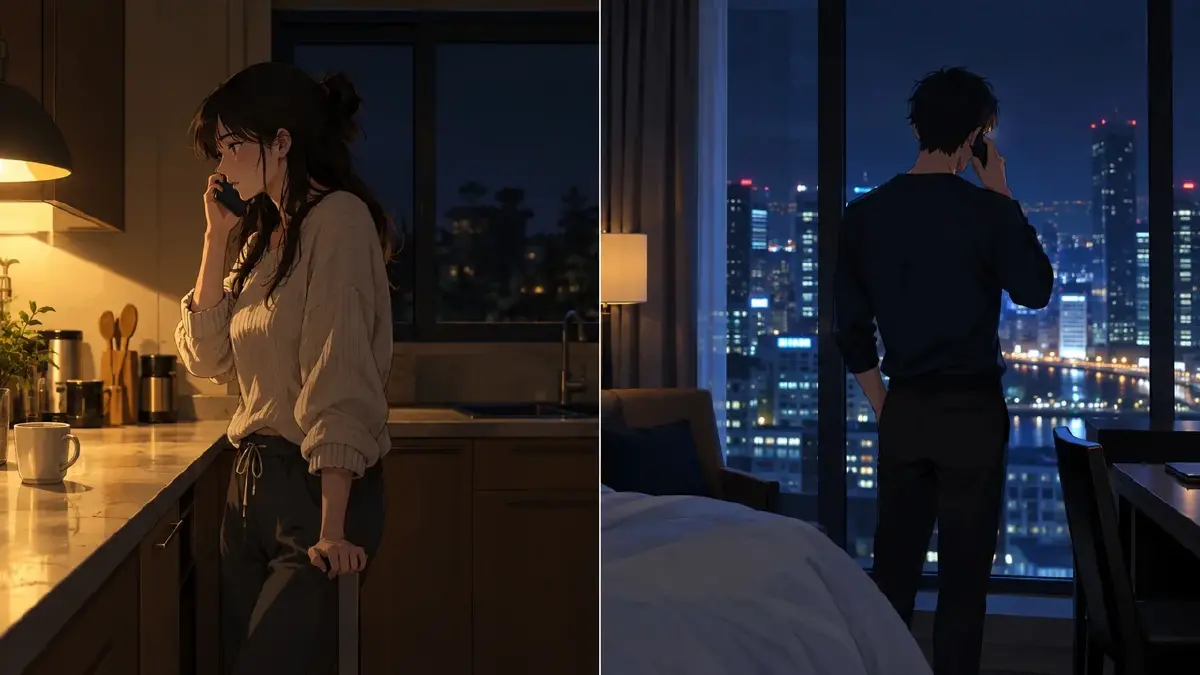
電話對話在劇本上看起來很簡單:兩個角色在不同地方說話。但在生成的畫面裡,相似的背景和模糊的視線很容易讓兩個地方看起來像同一個房間。光靠台詞也會錯過最關鍵的時刻——觀眾能看見、而另一方完全看不見的那個無聲反應。
給每個打電話的人設定一個有辨識度的物理空間、清晰的持機姿勢,以及在聽電話時有所注視的具體事物。然後決定:在下一句台詞開口之前,觀眾需要先看到哪一方的反應。這篇指南告訴你如何在兩個場景之間呈現這種資訊差,同時保持通話的空間邏輯。
每個人知道什麼——以及只有觀眾才能看到什麼
在建立任何 Shot 之前,先為每位通話者寫下三件事:
- 接起電話時他們知道什麼。 他們掌握的資訊,以及這些資訊帶給他們的情緒狀態。
- 對方能聽到什麼。 說出口的台詞,以及任何他們有意分享——或無意洩露——的聲音。
- 只有觀眾能看到什麼。 一隻顫抖的手、一個瞥向門口的眼神、一張被翻扣在桌上的照片。
第三層正是電話戲張力的來源。如果 A 得知了某個改變一切的訊息,觀眾會看著 A 在沉默中消化它,然後才開口。B 看不見這一切,觀眾卻看得一清二楚。這個資訊差就是這場戲的核心。
用這三個問題的答案來決定下一個鏡頭該給誰。
為每個場景分別建立資產
給兩個場景設定不同的視覺錨點:一邊是廚房操作檯和暖色檯燈,另一邊是飯店床鋪和冷調窗戶。把兩個背景放在一起對比,確保觀眾不用等人開口就能認出是哪個地方。
在我的資產裡建立兩個獨立的 scene asset,各自對應一位通話者的場景。每個 scene asset 都要綁定一張能呈現真實環境的 Reference image,而不只是配色參考。逼仄的公寓廚房和飯店房間書桌是兩個完全不同的 scene asset。把這些參考圖設為 Main image,再對照已有的空間逐一檢查每個生成畫面。
為每位通話者確認其 character asset 並綁定有用的 Reference image。如果有持機參考圖能說明姿態,可以和主外形參考圖一起綁上。在每個 Shot 描述裡,當畫面連續性依賴持機手時,明確寫出是哪隻手拿著電話——asset 參考圖代替不了清晰的動作說明。
在我的資產裡建立虛構角色的 character asset Nadia 和 Ryo,scene asset NadiaKitchen 和 RyoHotelRoom,以及 prop asset NadiaPhone、RyoPhone 和 WaterGlass,綁定各自的參考圖,再透過
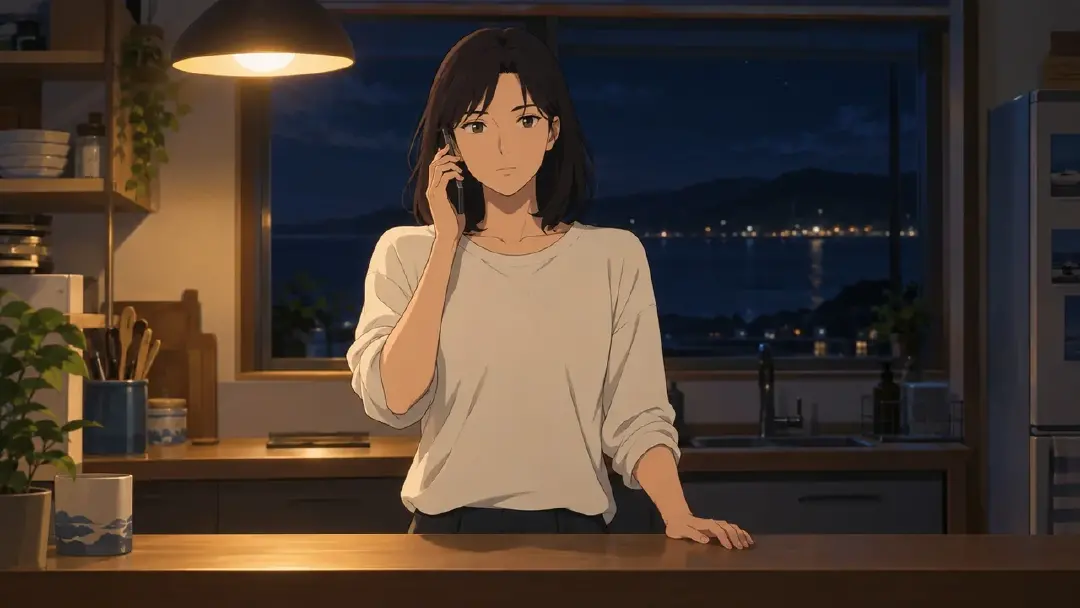
@選用。以下案例是原創設計練習,圖片展示的是構圖方案,並非實際影片輸出結果。
把台詞、無聲反應和回應拆成三個節拍
對於一段潛台詞分量很重的對話,可以拆成三個戲劇單元分別拍攝。不必把通話裡的每一句話都套進同樣的三鏡頭模式:
節拍一——對方說出的台詞。 說話的一方說出這句話,鏡頭給說話者的臉或身體,台詞、構圖和表演提示都在這裡。
節拍二——無聲反應。 在聽者開口之前切到他。這是短劇電話戲最容易被忽略的節拍。聽者正在消化——觀眾從他臉上讀出剛才那句話的分量。沒有台詞,只有一個動作,一種情緒。
節拍三——開口回應。 聽者變成說話者。繼續留在他身上,或換一個同一場景的構圖。因為觀眾已經親眼看著這句回應在他心裡成形,落地時的感覺完全不同。
在沉默節拍能改變後續回應理解方式的時候使用它,不必每句話後面都加。
如何逐個 Shot 安排電話對話場景
資產建好、節拍規劃完成後,開啟你的 Episode,用 Generate Shots 生成初始鏡頭組。AI 會根據你的 Story Outline 生成一套序列。之後逐一檢查每張 shot card,對照節拍計劃修改或補充鏡頭。
每次切換到新場景,確認 shot card 裡包含了對應的 scene asset 引用。用 @ 明確引用角色和場景——不要在每張 shot card 裡從頭重新描述房間。已建立的空間用固定的場景引用,再描述新的角度、動作和相關道具接觸。先生成圖片,對比兩個房間沒問題後再進行影片生成。
無聲反應段落,克制新增台詞的衝動。只寫動作和取景構圖。一段寫著「@Nadia 一動不動地站著,盯著水槽上方的牆。通話還在進行,但她沒有開口。臉部近景。」的 shot 描述,比塞滿敘述性文字強多了。
為每位通話者選定一個角色音色,在準備台詞時保持一致。在 Edit 裡,對需要的台詞使用 Generate Voiceover,然後對照相關 shot 逐一試聽。說話人的身分和表達方式需要自己把關——選定音色並不保證每句生成的台詞都有預期的情緒和節奏。
在原創案例 Coastal Signal 中,海洋研究員 Nadia 打電話給疏遠已久的合作者 Ryo,告知他們的聯合研究專案即將被叫停。她在自己家的廚房裡,他在全國另一頭的飯店。前面有一場戲交代了他在等另一個電話。Nadia 不知道那個電話是關於什麼的。
示例 1 — Nadia 說出台詞,鏡頭位於她的廚房:
Medium locked view of @Nadia at the counter in @NadiaKitchen. @Nadia speaks the line, “The department approved the shutdown this morning. I thought you should hear it from me.” @NadiaPhone stays at her right ear and her left hand remains resting on the counter edge. Keep her delivery level, with no added head turn or hand gesture. A warm overhead lamp separates her face from the dark window. One spoken line, no camera movement or cut.
示例 2 — 無聲反應段落,Ryo 的位置:
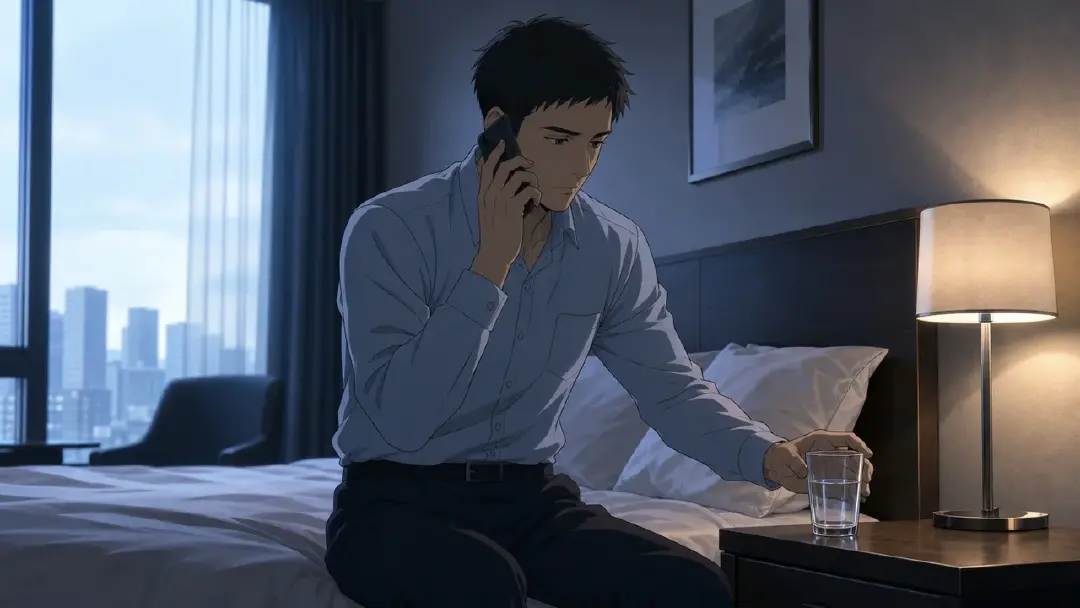
Medium-close locked view of @Ryo seated on the bed in @RyoHotelRoom. @Ryo slowly sets @WaterGlass on the nightstand while @RyoPhone stays at his left ear. Keep the glass, supporting hand and tabletop fully visible, with his face above the action. He remains silent and his posture otherwise still. Cool window light outlines the glass without obscuring its contact with the table. One placement only, with no jaw clench, second gesture, camera movement, or reply.
示例 3 — 開口回應,鏡頭留在傾聽者身上:
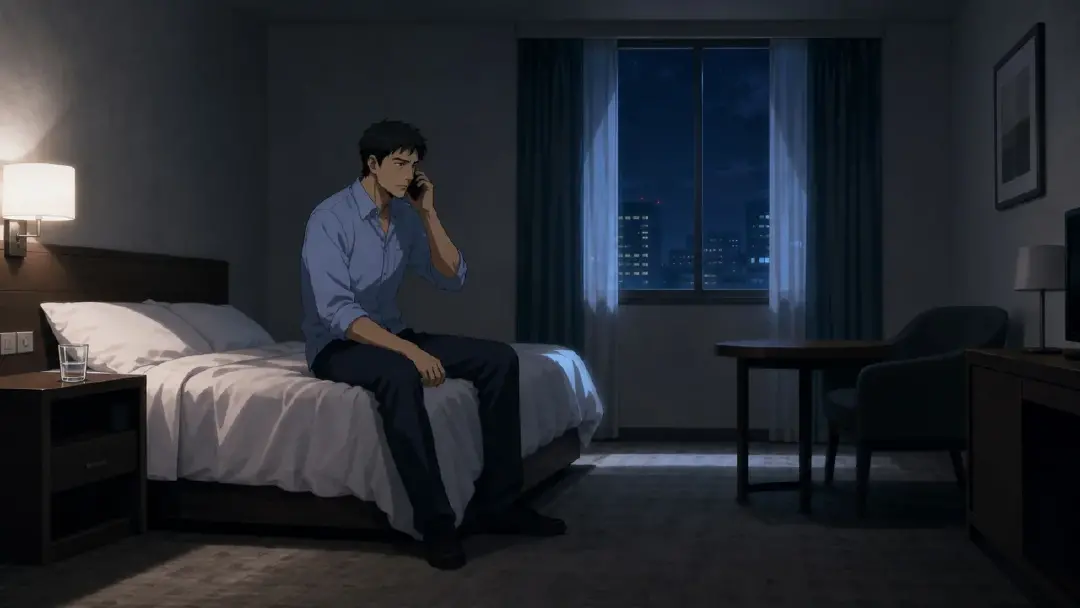
Wide locked view across @RyoHotelRoom, with @Ryo still seated on the bed and @WaterGlass resting on the same nightstand. @Ryo speaks, “How long have you known?” in a controlled, slower delivery. @RyoPhone remains at his left ear, and his free hand rests on his thigh. Keep the bed, nightstand and cold window visible to establish the unchanged location. One spoken question only; no standing, walking, new gesture, camera movement, or other caller’s reply.
常見問題及如何排查
第一類問題是場景地理不清:觀眾誤以為兩個通話者在同一個房間。把所有 shot 連續播放,不開台詞,檢查背景、電話持握位置和視線方向。修改讓人困惑的構圖或引用,然後再次檢查。相近的視線方向本身不代表出錯;關鍵是所有線索加在一起,能不能讓觀眾看清楚每個位置。
第二類問題是切換鏡頭後音色不一致。把台詞單獨播放,不看畫面。下一句時,每個通話者聽起來還是同一個人嗎?重新核對選定的角色音色,修改或替換破壞連貫性的那句台詞。情緒變化要和對話內容掛鉤,替換後要放在上下文裡試聽。
第三類問題是遮蔽了必要的反應。如果一句回應本意是掩藏驚訝,但觀眾根本沒機會看到這份驚訝,就需要在這句台詞之前補一個反應鏡頭。在 Edit 裡對比時長;停頓應該傳遞出某種資訊,而不是機械地遵守兩秒定律。
在 Edit 裡組裝交替切換的鏡頭素材
在 Edit 裡,根據誰提供了下一個有價值的資訊來排列鏡頭素材。示例中用 A 代表 Nadia 的台詞,B 代表 Ryo 的靜默動作,再接 B 代表他的回應。嚴格 A/B 交替在這裡會打斷敘事節奏,沒有必要。
組裝好的序列需要檢查三件事:
- 說話人辨識。 每次切換時,觀眾能不能立刻判斷自己在哪個位置?如果兩個場景看起來相似,每個 shot 的第一幀需要更強的視覺錨點。
- 反應因果。 每句回應是否真的建立在對方實際傳達的資訊之上?當無聲反應能改變觀眾對下一句回應的理解時,就讓觀眾看到這段反應;直接的口頭回應同樣可以做到清晰。
- 各位置內部的連貫性。 保持持機手、家具和道具狀態一致。如果有人在剪輯省略的時間裡移動了位置,要清楚地交代新位置;不是每次合理的移動都需要一個走路鏡頭。
對選定的台詞使用 Generate Voiceover,配合剪輯檢查音訊。靜默的傾聽者可能仍然能聽到對方的聲音,所以要區分「這個角色沒有開口說話」和「整個聲軌是靜音的」。不要依賴未經驗證的電話濾波效果來識別說話人。
同一空間內的對話場景,參見對話場景指南。跨多角色的配音規劃,參見多角色配音指南。開啟你的 ArcLoop 專案,準備好兩個場景,然後把台詞、反應和回應放在一起測試。
常見問題
兩個位置需要分成兩個獨立的 Episode 嗎? 不需要。兩個位置都在同一個 Episode 和 Storyboard 裡。區分是透過 scene asset 和 shot card 描述來實現的,和 Episode 結構無關。
同一個角色的說話鏡頭和傾聽鏡頭可以用同一個 character asset 嗎? 可以。一個 character asset 覆蓋該角色的所有鏡頭。在 shot 描述裡寫清楚姿勢和情緒狀態——asset 負責身分,描述負責每個 shot 裡的新內容。
如果無聲反應段落生成出來嘴是張開的怎麼辦? 修改 shot 描述,明確說明角色沒有說話——「沉默」、「沒有回應」或「手持電話,不出聲」。一個 shot 描述只寫一個動作,可以有效減少畫面歧義。
畫外音需要加電話濾鏡效果嗎? 遠距離或壓縮感的音效是可選的。先透過畫面、台詞順序和反應鏡頭把說話人和所在位置交代清楚。在 Edit 裡聽一下實際生成的音訊,別讓故事依賴一個生成結果還沒做出來的效果。