Qué modelo es Seedance 2.5 Flash
Seedance 2.5 Flash es el modelo de vídeo de la serie Seedance 2.5 de ByteDance orientado a la velocidad de generación. En esta ronda hemos probado por separado el rendimiento dinámico, la interpretación de personajes, la interacción detallada, la comprensión espacial y la consistencia entre planos con múltiples imágenes de referencia, para comprobar hasta dónde llega en tareas creativas habituales. A juzgar por estas muestras de prueba, Seedance 2.5 Flash equilibra la eficiencia de producción y el coste de uso, por lo que resulta adecuado como modelo principal para avanzar en propuestas diarias y descartar o seleccionar planos.
En las dos comparativas de esta ronda, Seedance 2.5 Flash obtuvo resultados más rápido que la versión estándar, con una calidad visual aprovechable. Sin embargo, en planos con gran amplitud de movimiento —como la inclinación de una motocicleta en curva, impactos recibidos por los personajes, barridos o caídas al suelo—, su rendimiento sigue estando ligeramente por debajo de la versión estándar de Seedance 2.5 en cuanto a integridad del movimiento, sensación de fuerza y ejecución de instrucciones de acción complejas.
Diferencias de parámetros entre Flash y los otros dos modelos
La siguiente tabla se ha elaborado a partir de la documentación oficial verificada el 16 de noviembre de 2026 y recoge los límites máximos de capacidad de cada modelo. En esta ronda, las cinco primeras pruebas de Flash y los dos vídeos comparativos de la versión estándar duran 8 segundos, mientras que el caso con múltiples imágenes de referencia dura 10 segundos; la resolución se fijó de forma uniforme en 720p. Estos son únicamente los ajustes utilizados en esta prueba y no significan que los modelos solo puedan generar con estas especificaciones.
| Parámetro | Seedance 2.5 Flash | Seedance 2.5 | Seedance 2.0 |
|---|---|---|---|
| Resolución de salida | 480p, 720p | 480p, 720p, 1080p | 480p, 720p, 1080p, 4K |
| Duración por generación | 4–30 s | 4–30 s | 4–15 s |
| Límite de imágenes de referencia multimodal | 10 imágenes | 30 imágenes | 9 imágenes |
| Límite de vídeos de referencia multimodal | 5 clips | 10 clips | 3 clips |
| Límite de audios de referencia multimodal | 5 clips | 10 clips | 3 clips |
| Modo borrador (Draft) | No compatible | Compatible | No compatible |
Flash admite una salida máxima de 720p, con la opción de bajar a 480p. En comparación con Seedance 2.5, su límite de imágenes de referencia se reduce de 30 a 10, y los vídeos y audios de referencia pasan de 10 a 5 clips respectivamente. Si un proyecto requiere introducir una gran cantidad de material de referencia o exige entregar directamente metraje original en 1080p, estas diferencias técnicas influirán directamente en la elección del modelo.
Los límites de referencias indicados en la tabla corresponden a tareas de referencia multimodal, no a la cantidad de archivos subidos en la generación de vídeo a partir del primer fotograma. Las tareas de primer fotograma solo admiten una imagen de entrada, mientras que las de fotograma inicial y final reciben respectivamente el primer y el último fotograma. Todos los límites anteriores provienen de las especificaciones oficiales; en esta ronda, el caso de múltiples referencias utilizó siete imágenes, sin llegar a probar el límite máximo de diez imágenes ni otros niveles de resolución.
Comparativa de precios oficiales para la generación de vídeo
Los siguientes precios toman como referencia la tarifa de inferencia en línea de la lista oficial de precios en chino de Volcano Engine Ark, verificada el 16 de noviembre de 2026, bajo el supuesto de facturación a 720p, formato 16:9 y sin vídeo de entrada. Las pruebas de esta ronda —texto a vídeo, imagen de primer fotograma a vídeo y múltiples imágenes de referencia a vídeo— no incluyeron vídeos de referencia como entrada.
| Modelo | Precio unitario oficial | Precio por segundo estimado según ejemplo oficial | Presupuesto orientativo (vídeo de 8 s) | Presupuesto orientativo (vídeo de 10 s) |
|---|---|---|---|---|
| Seedance 2.5 Flash | 46 CNY / millón de tokens | Aprox. 0,99 CNY | Aprox. 7,9 CNY | Aprox. 9,9 CNY |
| Seedance 2.5 | 70 CNY / millón de tokens | Aprox. 1,51 CNY | Aprox. 12,1 CNY | Aprox. 15,1 CNY |
| Seedance 2.0 | 46 CNY / millón de tokens | Aprox. 0,99 CNY | Aprox. 7,9 CNY | Aprox. 9,9 CNY |
En igualdad de condiciones, el precio unitario oficial por token de Flash es aproximadamente un 34 % inferior al de Seedance 2.5 y se mantiene al mismo nivel que el de Seedance 2.0. Seedance 2.0 se incluye aquí únicamente como referencia de parámetros y precios; en esta ronda no se generaron muestras de prueba con dicho modelo. Los presupuestos para 8 y 10 segundos de la tabla son conversiones aproximadas basadas en el precio por segundo de los ejemplos de la web oficial para facilitar la comparación. El cobro real depende del precio unitario por token y del consumo efectivo reflejado en la factura oficial, por lo que las cifras mostradas no representan el gasto real de este lote de muestras.
Rendimiento práctico por categorías de capacidad
En esta prueba se analizaron cinco categorías de capacidad generativa a través de seis escenarios, sumando un total de seis muestras de Flash y dos muestras comparativas de la versión estándar de Seedance 2.5. La inclinación de la motocicleta en curva y el combate continuo se agrupan dentro del rendimiento dinámico para realizar una comparativa entre ambas versiones; en las cuatro categorías restantes solo se evaluó el desempeño de Flash. Los primeros siete vídeos duran 8 segundos, mientras que el caso de múltiples imágenes de referencia dura 10 segundos y consta de tres planos.
| Categoría de capacidad | Escenario de prueba | Duración | Desempeño principal de Flash | Comparativa con Seedance 2.5 |
|---|---|---|---|---|
| Rendimiento dinámico y control de cámara | Inclinación de moto en curva y seguimiento | 8 s | Transmite sensación de velocidad; el encuadre cerrado impide ver la maniobra completa en la curva | Proceso más completo desde la inclinación y el paso por el vértice hasta el enderezamiento |
| Rendimiento dinámico y control de cámara | Combate continuo | 8 s | Genera ataques y defensas continuos, pero algunas transiciones y la sensación de fuerza son algo débiles | Giros de torso, reacciones físicas y desplazamientos en profundidad más naturales |
| Interpretación y diálogo | Lectura de carta, mirada arriba y frase en inglés | 8 s | Muestra la transición de leer la carta a sonreír; el diálogo y la sincronía labial aún no se han verificado por separado | No probado |
| Interacción detallada | Entrega de una llave entre dos personas | 8 s | La transferencia de la llave es clara; hay desviaciones en el diseño de personajes y el contacto de los dedos requiere revisión detallada | No probado |
| Comprensión espacial | Giro de una taza sobre el escritorio | 8 s | La disposición general se mantiene; falta confirmar el ángulo de giro de la taza y hay un ligero avance de la cámara | No probado |
| Múltiples referencias y consistencia entre planos | Siete imágenes de referencia para generar un relevo en tres planos | 10 s | A lo largo de los tres planos, los personajes, los vehículos y la pertenencia de los cascos se mantienen consistentes en general | No probado |
A continuación se muestran los vídeos originales y los prompts organizados por categoría de capacidad; los tiempos de espera concretos de cada vídeo se recogen al final del artículo, en la tabla de velocidad de generación.
Rendimiento dinámico y control de cámara
En esta sección se utilizan dos escenarios —la inclinación de una motocicleta en curva y un combate entre dos personas— para observar la fluidez entre movimientos, los cambios en el centro de gravedad, la trayectoria de desplazamiento y si la cámara logra mostrar con claridad el desarrollo de la acción. Ambos modelos utilizaron exactamente los mismos prompts en inglés y los mismos ajustes de generación.
Inclinación de moto en curva y seguimiento
Los requisitos del prompt son idénticos para ambas versiones: un piloto conduce una motocicleta roja a través de una curva larga mientras la cámara realiza un seguimiento desde un ángulo frontal bajo; tras pasar el vértice de la curva, la moto se endereza gradualmente, y tanto el vehículo completo como ambas ruedas deben permanecer dentro del encuadre en todo momento.
Seedance 2.5 Flash
8 s · 720p · Audio nativo · Desde el envío hasta observar la finalización: 82,7 s
Seedance 2.5
8 s · 720p · Audio nativo · Desde el envío hasta observar la finalización: 200,8 s
Flash parece más bien un primer plano de carreras
En el vídeo generado por Flash, el frontal rojo de la moto, el asfalto mojado, los reflejos de las luces y el aerosol de agua que levanta la rueda trasera se aprecian con bastante nitidez; el fondo retrocede rápidamente y el seguimiento pegado al frontal transmite sensación de velocidad. Sin embargo, el encuadre es demasiado cerrado: la cabeza del piloto, la parte superior de su torso y parte del carenado quedan recortados fuera de plano, y tampoco se conservan completas las ruedas delantera y trasera como exigía el prompt. Aunque se percibe la inclinación del chasis, al ser una composición tan cerrada resulta difícil apreciar cómo se coordinan el piloto y la motocicleta para trazar la curva.
Si el montaje final necesita precisamente intercalar un plano detalle cerrado de la moto en carrera, este clip es utilizable; pero si el guion gráfico exige mostrar de forma íntegra el proceso de inclinación en curva, o si debe enlazar con un plano previo que marque la trazada en la pista, un encuadre que recorta parte del piloto y del vehículo no resulta adecuado.
La versión estándar capta el paso por curva de forma más completa
La versión estándar mantiene dentro del encuadre la silueta completa del piloto y de la motocicleta. Siguiendo la línea temporal, el vehículo se inclina al entrar en la curva, se aproxima al vértice y luego reduce gradualmente el ángulo de inclinación hasta enderezarse; además, la relación espacial entre el piano interior de la pista y la carrocería deja muy clara la trayectoria de avance.
Esta sensación de fluidez proviene de la coordinación entre la postura del chasis, el centro de gravedad del piloto, la trazada de la curva y la distancia de la cámara. En comparación con el plano cerrado de Flash, la versión estándar muestra con mayor claridad la transición desde la inclinación hasta el enderezamiento progresivo, logrando un mejor rendimiento de movimiento en este escenario.
No obstante, el ángulo de seguimiento frontal y la escala del plano en la versión estándar también varían durante el recorrido. A partir únicamente de fotogramas de muestra, no es posible confirmar que el contacto de los neumáticos con el asfalto y la geometría del chasis sean totalmente exactos en cada instante. Esta comparativa demuestra que la versión estándar presenta de forma más completa el desarrollo de la acción y la trayectoria, pero no permite concluir que todos los detalles físicos sean impecables.
Prompt completo en inglés utilizado en la prueba de la motocicleta
One continuous 8-second cinematic live-action shot on a closed motorcycle racing circuit just after rain, at blue hour. A single adult professional racer in black protective leathers and a full-face helmet rides one unbranded red sport motorcycle through a sweeping right-hand bend. A low front three-quarter tracking camera follows alongside at matching speed, keeping the whole motorcycle and both wheels visible. The racer leans naturally into the corner, reaches the apex, then gradually brings the bike upright toward the exit. Both tires remain on the wet asphalt. Track barriers and floodlights move past in the background, with a fine spray of water trailing the rear tire. Physically plausible rider anatomy and motorcycle geometry, consistent red bodywork, realistic film texture. Sound: one motorcycle engine rising smoothly and wet tire hiss. No dialogue, no music, no cuts, no text, no subtitles, no logos.
Combate continuo entre dos personas
En esta escena de pelea se pidió a ambos modelos que los personajes estuvieran intercambiando golpes desde el primer fotograma: una combinación continua de puñetazos, esquivas y bloqueos, seguida de una potente patada de contraataque, un avance para acortar distancias, un barrido bajo y, finalmente, una caída rodando por el suelo. Para distinguir a los personajes durante el rápido intercambio, el prompt especificó que uno llevara chaqueta gris con pantalón negro y el otro chaqueta azul marino oscuro con pantalón marrón claro.
Seedance 2.5 Flash
8 s · 720p · Audio nativo · Desde el envío hasta observar la finalización: 82,4 s
Seedance 2.5
8 s · 720p · Audio nativo · Desde el envío hasta observar la finalización: 197,7 s
Flash incluye suficientes combinaciones, pero con poca sensación de fuerza
Flash logró generar todas las acciones solicitadas: puñetazos continuos, bloqueos, patadas, barrido bajo y caída con giro en el suelo. Sin embargo, al observar con detenimiento, varios intercambios parecen más bien una ejecución secuencial de movimientos aislados; las reacciones al recibir impactos tras los puñetazos o patadas y el enlace fluido con el siguiente movimiento resultan algo flotantes. Ambos personajes se desplazan básicamente en paralelo de izquierda a derecha, sin apenas variación de distancia ni profundidad entre la cámara y los luchadores.
Además, el vídeo añadió automáticamente bandas negras arriba y abajo, y durante la primera mitad no mantuvo los pies completos dentro del encuadre. Si es necesario observar el pie de apoyo, el juego de piernas y la transmisión de fuerza durante el combate, recortar los pies dificulta la valoración.
La transmisión de fuerza y el desplazamiento son más naturales en la versión estándar
En la versión estándar, cuando los personajes lanzan puñetazos se aprecia el impulso desde los hombros y la espalda junto con la rotación de la cintura; las esquivas, las patadas de respuesta y los pasos hacia atrás también involucran a todo el cuerpo. Tras abrir distancia, ambos vuelven a acercarse para enlazar con fluidez el ataque al tren inferior y la caída rodando por el suelo. La cámara ajusta su posición acompañando el intercambio, mientras la distancia en profundidad y la orientación de los luchadores cambian continuamente, situando la pelea en un espacio tridimensional donde las posiciones relativas delante y detrás quedan mucho más claras.
Esta muestra presenta de forma más coherente todo el proceso desde el impulso inicial y la recepción del golpe hasta la persecución. En comparación con Flash, los puñetazos y patadas de la versión estándar transmiten mayor peso y las combinaciones se enlazan con más solidez, ofreciendo un mejor rendimiento dinámico en esta escena.
Tampoco la versión estándar mantuvo los pies de ambos personajes dentro del cuadro durante todo el metraje. Para comprobar si los puntos de contacto de los golpes son verosímiles, si se ejecutaron estrictamente los tres puñetazos exigidos en el prompt y si cada cambio de peso es coherente, sigue siendo necesario revisar el vídeo con atención. Que la imagen tenga un acabado más cinematográfico no equivale a que la coreografía sea totalmente precisa, ni garantiza que se haya cumplido al pie de la letra cada instrucción de movimiento del prompt.
Prompt completo en inglés utilizado en la prueba de combate
An explosive 8-second live-action martial-arts fight scene, fast real-time Hong Kong action-film choreography, one continuous shot. Two adult fighters in a gritty concrete parking garage: one in a light grey jacket and black trousers, the other in a dark navy jacket and tan trousers. They are already fighting in the opening frame. The grey fighter surges forward with a rapid three-punch combination; the navy fighter slips the first punch, blocks the next and drives back with a forceful body kick. The grey fighter staggers two steps, immediately closes the distance, ducks a swinging counterpunch and sweeps the navy fighter's leg. The navy fighter hits the floor in a controlled stunt fall and rolls away as the grey fighter pursues. Relentless attack-and-counterattack momentum throughout, short transitions, sharp acceleration, convincing physical impact reactions, forceful torso rotation, realistic weight and balance, clear changes of position across the floor. The camera tracks rapidly beside them at waist height in a medium-wide action framing, keeping both whole bodies and the floor under their feet visible, with subtle handheld vibration at impacts. Crisp readable action, restrained motion blur, hard overhead light, cinematic contrast, realistic anatomy and clothing, distinct stable identities. Audio: rapid footfalls, forceful punch and kick impacts, clothing snaps, heavy breathing and a solid floor impact. No slow motion, no standing around, no pauses to reset, no dialogue, no music, no text, no subtitles, no cuts, no blood, no gore, no weapons.
Interpretación y diálogo
Este escenario requiere que el personaje lea primero una carta con la cabeza inclinada, luego levante la vista, pronuncie en inglés la frase “You kept the letter.” (Guardaste la carta) y sonría brevemente. El prompt especifica que la línea de diálogo debe pronunciarse entre los segundos 4 y 6, manteniendo la cámara fija.
A partir de los fotogramas revisados, el personaje pasa de mirar la carta hacia abajo a levantar la vista y sonreír, manteniendo reconocibles en todo momento el rostro, la chaqueta y el papel en sus manos. Este tipo de interpretación sutil, libre de movimientos bruscos que distraigan, resulta idóneo para observar directamente la expresión facial y las transiciones emocionales.
Al evaluar planos interpretativos con diálogo, es necesario verificar por separado la imagen y el sonido. Que el vídeo incluya pista de audio no significa necesariamente que la pronunciación de la frase y el movimiento de los labios coincidan con exactitud. Al revisar el clip original, hay que comprobar si la pronunciación en inglés es clara, si se cuelan voces adicionales no deseadas, si empieza a hablar entre los segundos 4 y 6 como se pidió, y si la articulación labial se ajusta a las palabras. Basándonos únicamente en capturas estáticas, en esta ronda aún no se ha verificado de forma independiente si el diálogo es exacto palabra por palabra ni si la sincronización labial es estricta.
Prompt en inglés utilizado para la interpretación del personaje
One continuous 8-second medium close-up in a quiet train carriage, naturalistic live-action cinematography. An adult woman in a plain navy jacket holds one opened letter below her face. 0-2 seconds: she reads it silently, with a thoughtful expression. 2-4 seconds: she takes a small breath and lifts her eyes toward a person just beside the camera. 4-6 seconds: with a restrained, tender smile she says clearly in English, 'You kept the letter.' 6-8 seconds: she holds the eye contact and the quiet smile. Keep her mouth fully visible and her face, clothing and letter consistent. The camera stays still. Audio: her single spoken line over soft carriage rumble. No other voices, no music, no captions, no readable writing, no subtitles, no cuts.
Interacción detallada
Este escenario pide que una persona deposite una pequeña llave de latón en la palma de la mano de otra, abra los dedos para soltarla y retire la mano vacía. El traspaso de un objeto pequeño y rígido de este tipo es una buena prueba para evaluar la calidad de generación de las manos: cuando ambas manos se acercan y se superponen, los gestos de sujetar y soltar la llave deben mostrarse con total claridad.
En los fotogramas extraídos del momento del traspaso, la mano que entrega la llave se acerca a la palma abierta, deja la llave y se retira, tras lo cual el receptor cierra los dedos. Más abajo se incluye una ampliación de la zona de entrega para observar de cerca el contacto entre las yemas de los dedos y la llave.
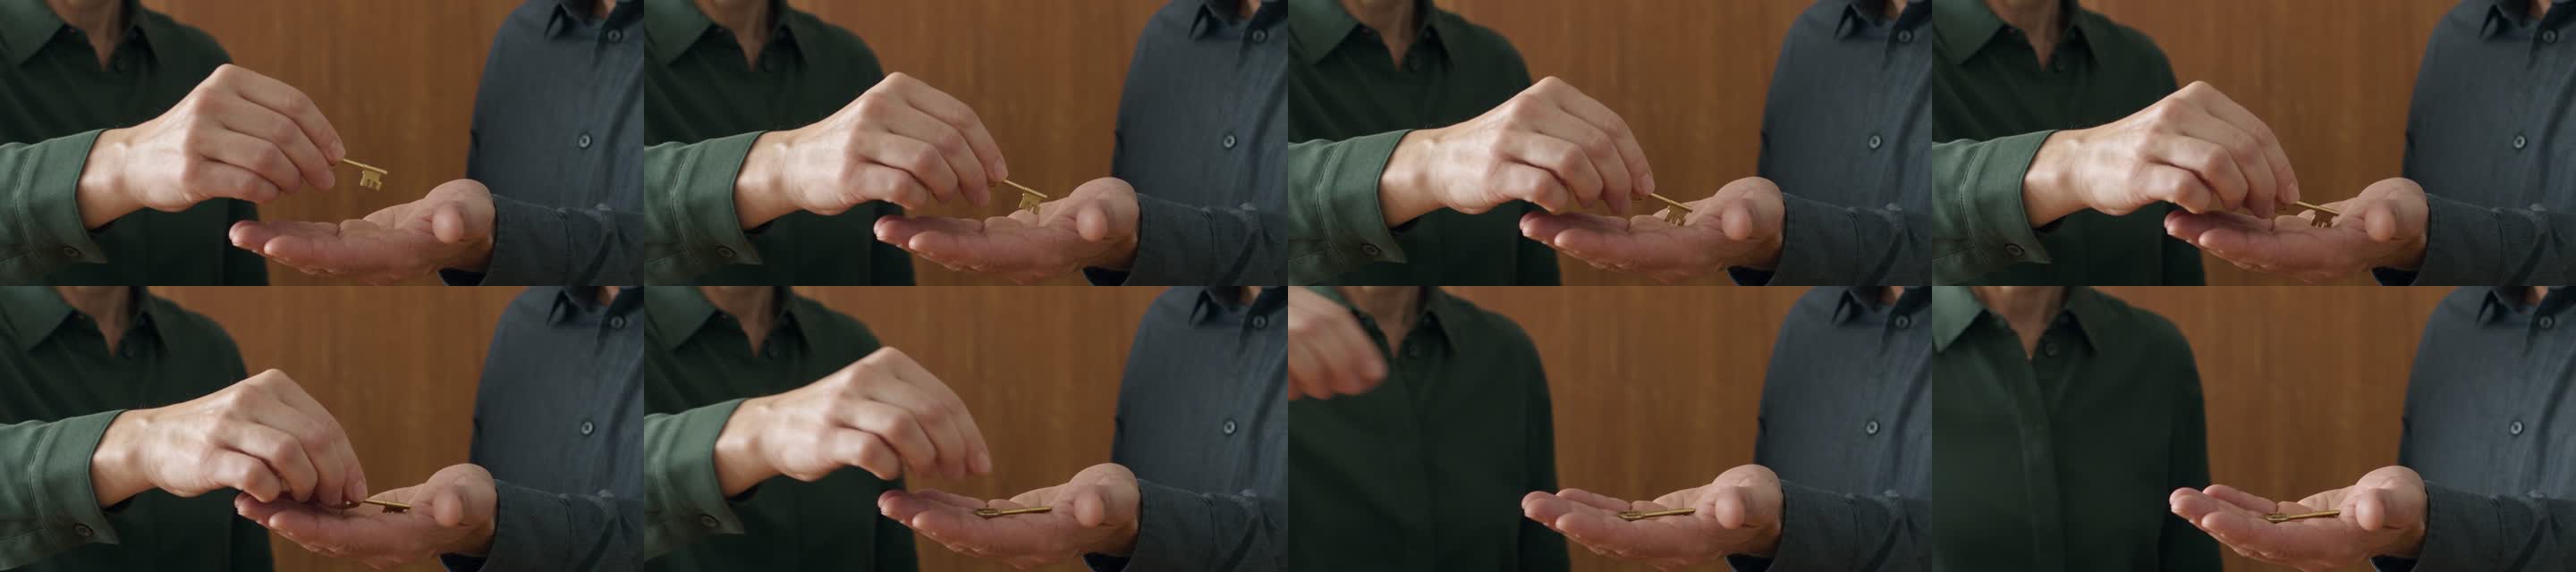
Para revisar este tipo de interacciones locales, conviene prestar especial atención a varios detalles: si los dedos que sujetan la llave se abren con naturalidad al soltarla, si hay fusiones o desenfoques extraños entre las yemas, la llave o la palma contraria, si la estructura articular del pulgar y del resto de los dedos es normal, y si la llave se mantiene como un único objeto durante todo el proceso. Es necesario examinar estos aspectos fotograma a fotograma a lo largo del vídeo; que la anatomía de la palma sea correcta en el fotograma inicial no garantiza que no aparezcan errores cuando ambas manos se superponen.
Por otra parte, esta muestra presenta una desviación evidente respecto a la configuración de los personajes. El prompt especificaba claramente que la persona de la izquierda que entrega la llave debía ser una mujer, pero el personaje generado aparece como un hombre. Por tanto, aunque el clip sirve para analizar la mecánica de entrega entre las manos, no respetó las indicaciones sobre los personajes. Que el objeto complete la transferencia no significa que se hayan cumplido todas las órdenes del prompt, ni tampoco se puede concluir que la estructura de contacto de los dedos sea impecable basándose solo en unos pocos fotogramas de muestra.
Prompt en inglés utilizado en la prueba de entrega de la llave
One continuous 8-second live-action shot, a fixed waist-up two-shot of two adults at a wooden counter, with both people's hands clearly visible throughout. The woman on the left wears a dark green shirt. The man on the right wears a charcoal shirt. 0-2 seconds: the woman holds exactly one small brass key between the fingers of her right hand; the man presents his empty open left palm. 2-5 seconds: she moves that key into his left palm and releases it. 5-8 seconds: she withdraws her visibly empty right hand, and he closes his fingers around the received key. Maintain one key, two people and continuous natural hand movements. Show the actual contact and release clearly, with realistic anatomy and steady framing. Soft side lighting, believable skin and wood textures. Audio: quiet room tone and a small metallic click during the transfer. No speech, no music, no text, no subtitles, no cuts.
Comprensión espacial
En esta prueba se introdujo como primer fotograma una imagen estática original y sin texto. El personaje, la taza azul, el cuaderno cerrado, el escritorio y el fondo de la habitación ya venían definidos en dicha imagen inicial. El movimiento solicitado en el prompt es muy reducido: la mujer baja la mirada, extiende la mano para girar la taza un cuarto de vuelta sobre el escritorio (sin despegar la base de la superficie), luego la suelta y vuelve a mirar por la ventana.
Además de comprobar si se mantiene la apariencia del personaje, este plano evalúa principalmente cómo comprende el modelo las relaciones espaciales sobre la mesa: si la mano se acerca al asa siguiendo una trayectoria lógica, si la base de la taza permanece pegada al escritorio mientras gira, si la posición relativa entre el cuaderno, la taza y la mesa se mantiene estable, y si la oclusión espacial al agarrar y soltar el asa es correcta, sin penetraciones ni solapamientos irreales.
Según se aprecia en los fotogramas revisados, la disposición general sobre el escritorio se mantuvo estable: se ve el proceso en que la mano se extiende hacia la taza y luego se retira, mientras el cuaderno permanece inmóvil en su sitio a la derecha. Sin embargo, aunque la orientación del asa cambia durante la acción, en la segunda mitad del clip vuelve a verse muy cerca de su posición original; observando únicamente esta serie de fotogramas de muestra, resulta difícil confirmar si la taza completó realmente el giro de un cuarto de vuelta y se quedó en el nuevo ángulo. Asimismo, aunque el prompt exigía una cámara totalmente fija, en el vídeo generado se percibe un ligero movimiento de avance.
Al evaluar este tipo de generación de vídeo a partir de un primer fotograma, más allá de la consistencia en los rasgos del personaje, la clave está en ver si los objetos existentes mantienen su posición y sus relaciones de oclusión cuando la mano entra en contacto con elementos rígidos del entorno. Para verificar el contacto de los dedos, las oclusiones y el desplazamiento de los objetos, se recomienda comparar en paralelo la imagen original del primer fotograma y el vídeo resultante.
Prompt en inglés utilizado en la prueba de giro de la taza
Continue the supplied first frame as one steady 8-second live-action shot. Preserve this exact adult woman's appearance, navy shirt, desk, single blue mug, closed tan notebook, background and window lighting. 0-2 seconds: she briefly glances down toward the blue mug. 2-5 seconds: she gently takes the mug handle with her right hand and rotates the mug a quarter turn on the tabletop without lifting it. 5-8 seconds: she releases the mug, rests her right hand beside it, and looks back toward the window. The mug stays on the desk and remains one rigid ceramic object, and the closed notebook remains fixed throughout. Keep the camera locked with no cut or zoom. Audio: quiet indoor ambience and a soft ceramic scrape during the turn. No speech, no music, no text, no subtitles.
Múltiples referencias y consistencia entre planos
En esta prueba se amplió la duración a 10 segundos y se utilizaron siete imágenes de referencia para generar una secuencia de tres planos. Los personajes son una piloto coreana, un piloto euroamericano y un mecánico euroamericano de mediana edad, aportando una hoja de diseño en tres vistas para cada uno; además, se proporcionaron imágenes de dos motocicletas con diseños distintos y dos cascos, uno rojo y negro y otro blanco.
Las imágenes de referencia sirven para fijar los rasgos faciales, el vestuario y el diseño de los objetos. No se introdujeron imágenes de escenarios ni bocetos de storyboard, por lo que el entorno del taller, la iluminación y los cambios de plano se controlaron exclusivamente mediante texto: una tarde nublada con luz natural suave entrando por el portón del garaje y suelo seco, buscando reducir los brillos intensos sobre la piel y los monos de cuero.
Imágenes de referencia utilizadas en esta prueba
| Contenido de referencia | Imagen | Correspondencia |
|---|---|---|
| 1 · Tres vistas de la piloto | 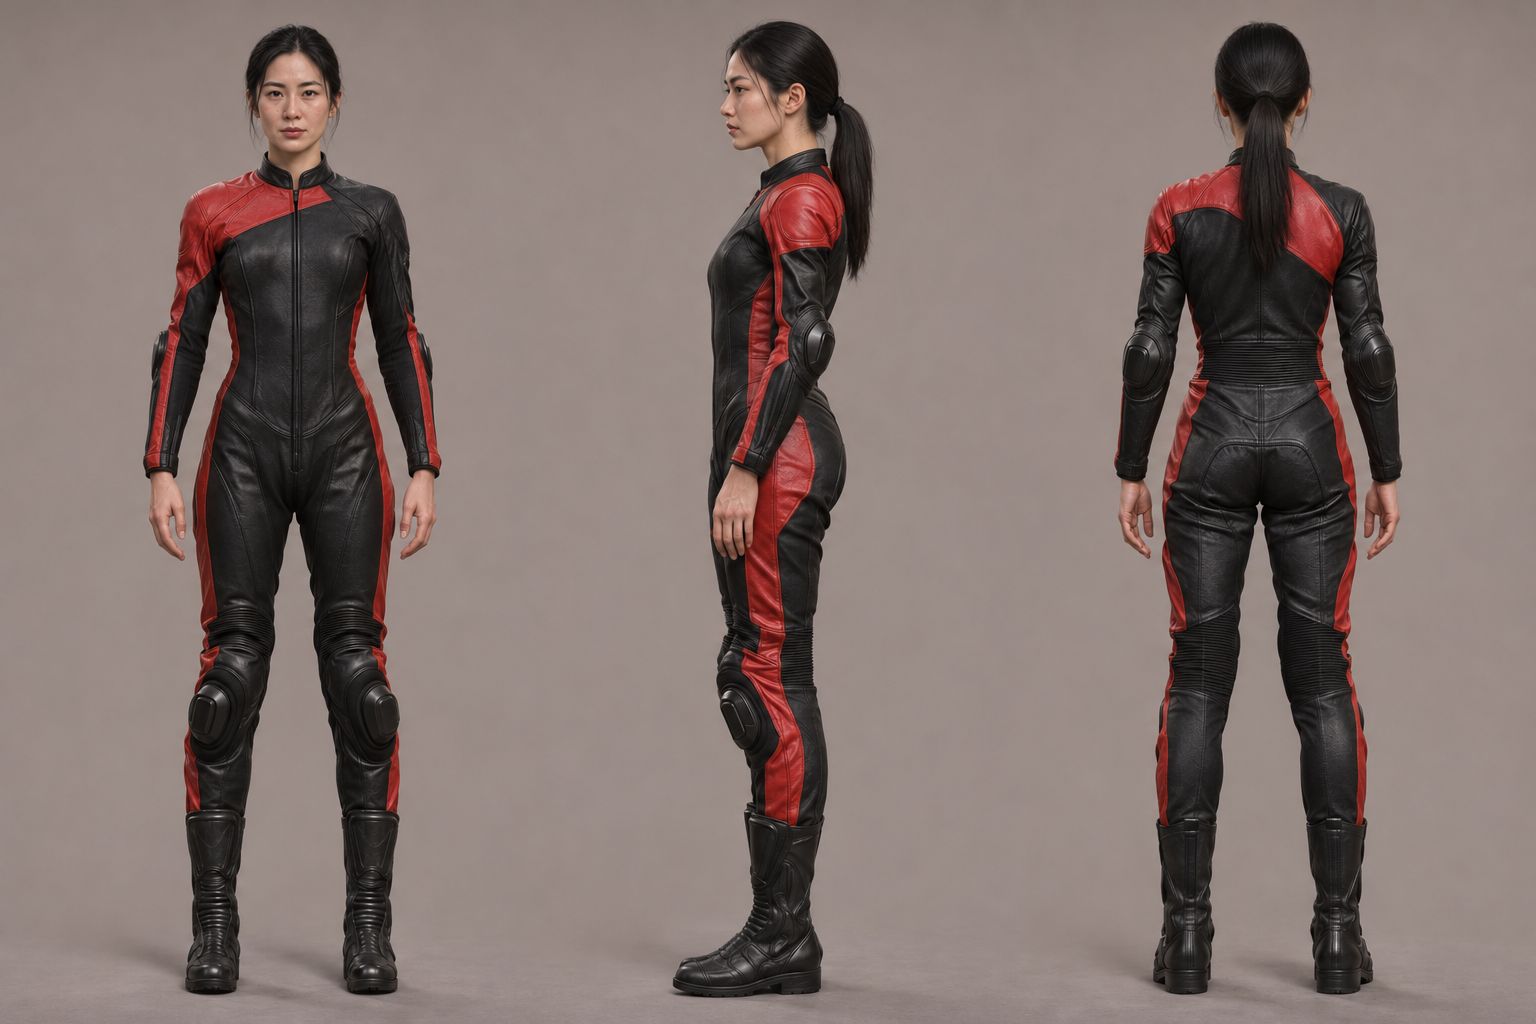 | Mono de competición rojo y negro; recibe el casco rojo y negro |
| 2 · Tres vistas del piloto | 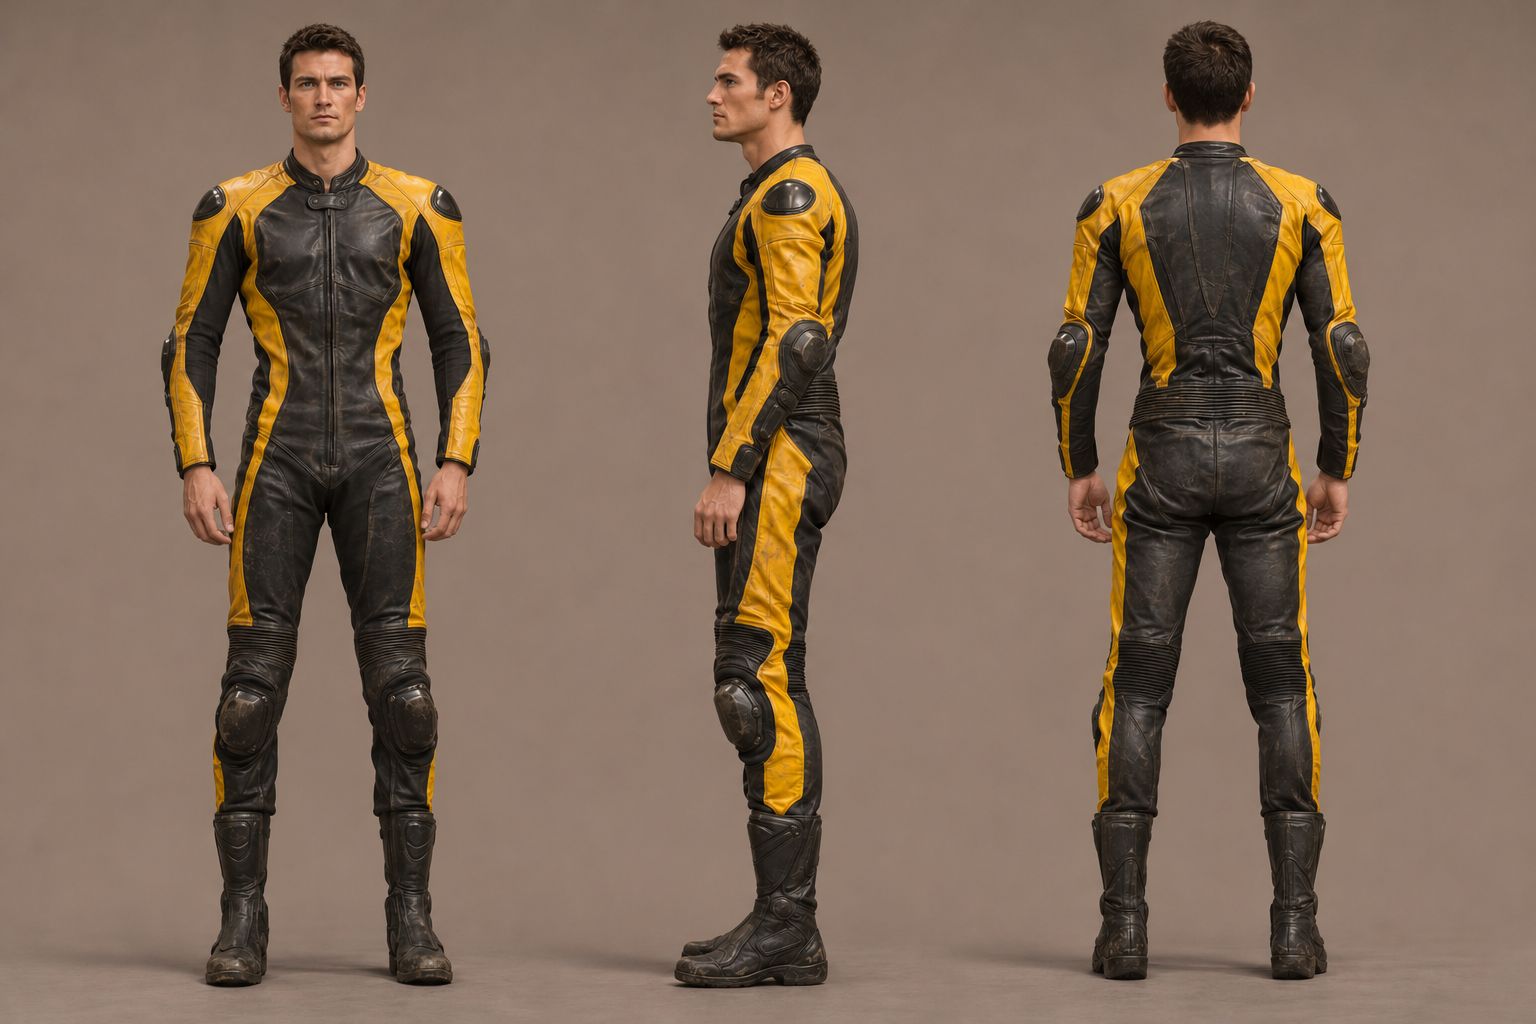 | Mono de competición amarillo y negro; sostiene el casco blanco en todo momento |
| 3 · Tres vistas del mecánico | 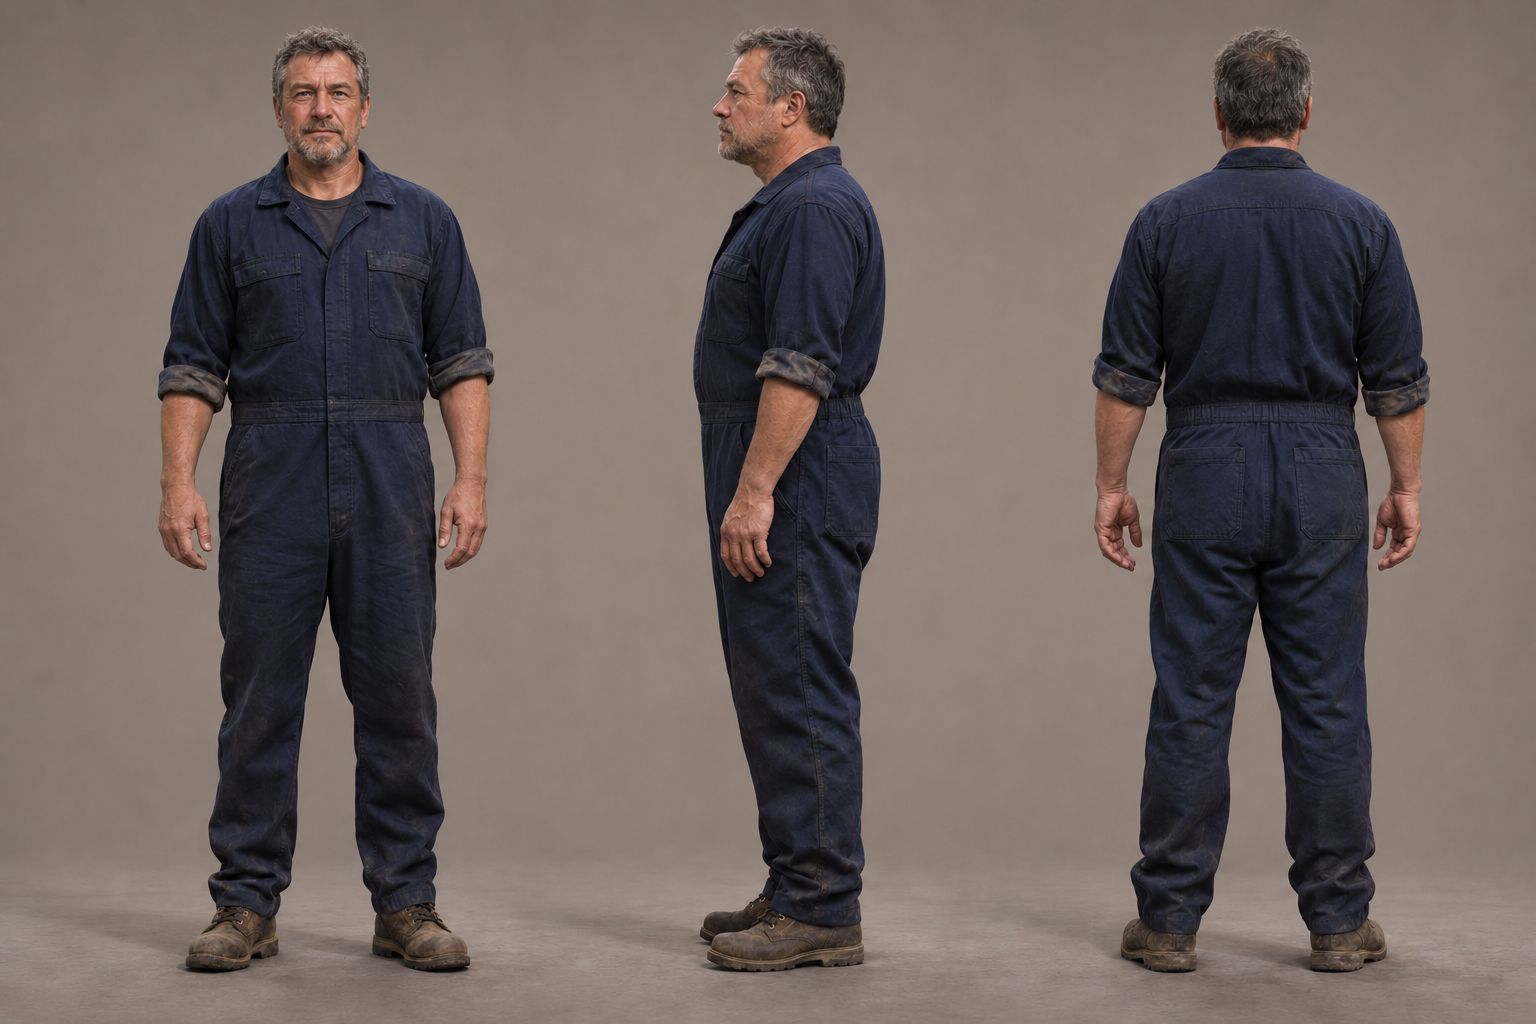 | Mono de trabajo azul marino; entrega el casco y retira las manos vacías |
| 4 · Motocicleta roja | 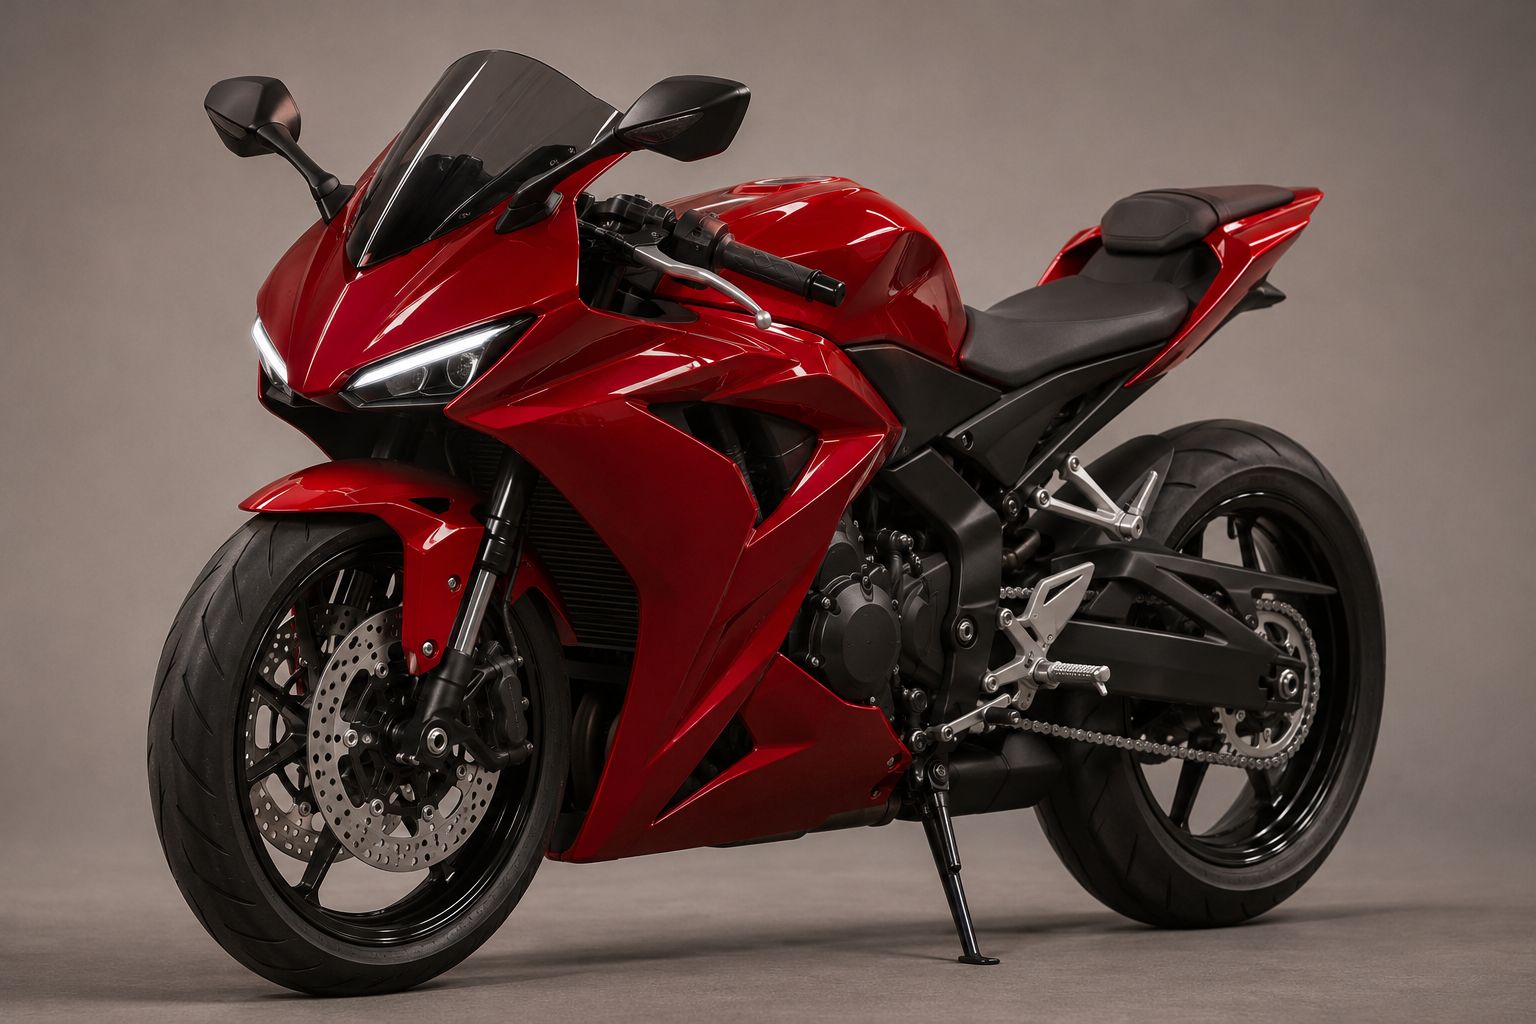 | Conserva el carenado integral y los faros divididos |
| 5 · Motocicleta azul | 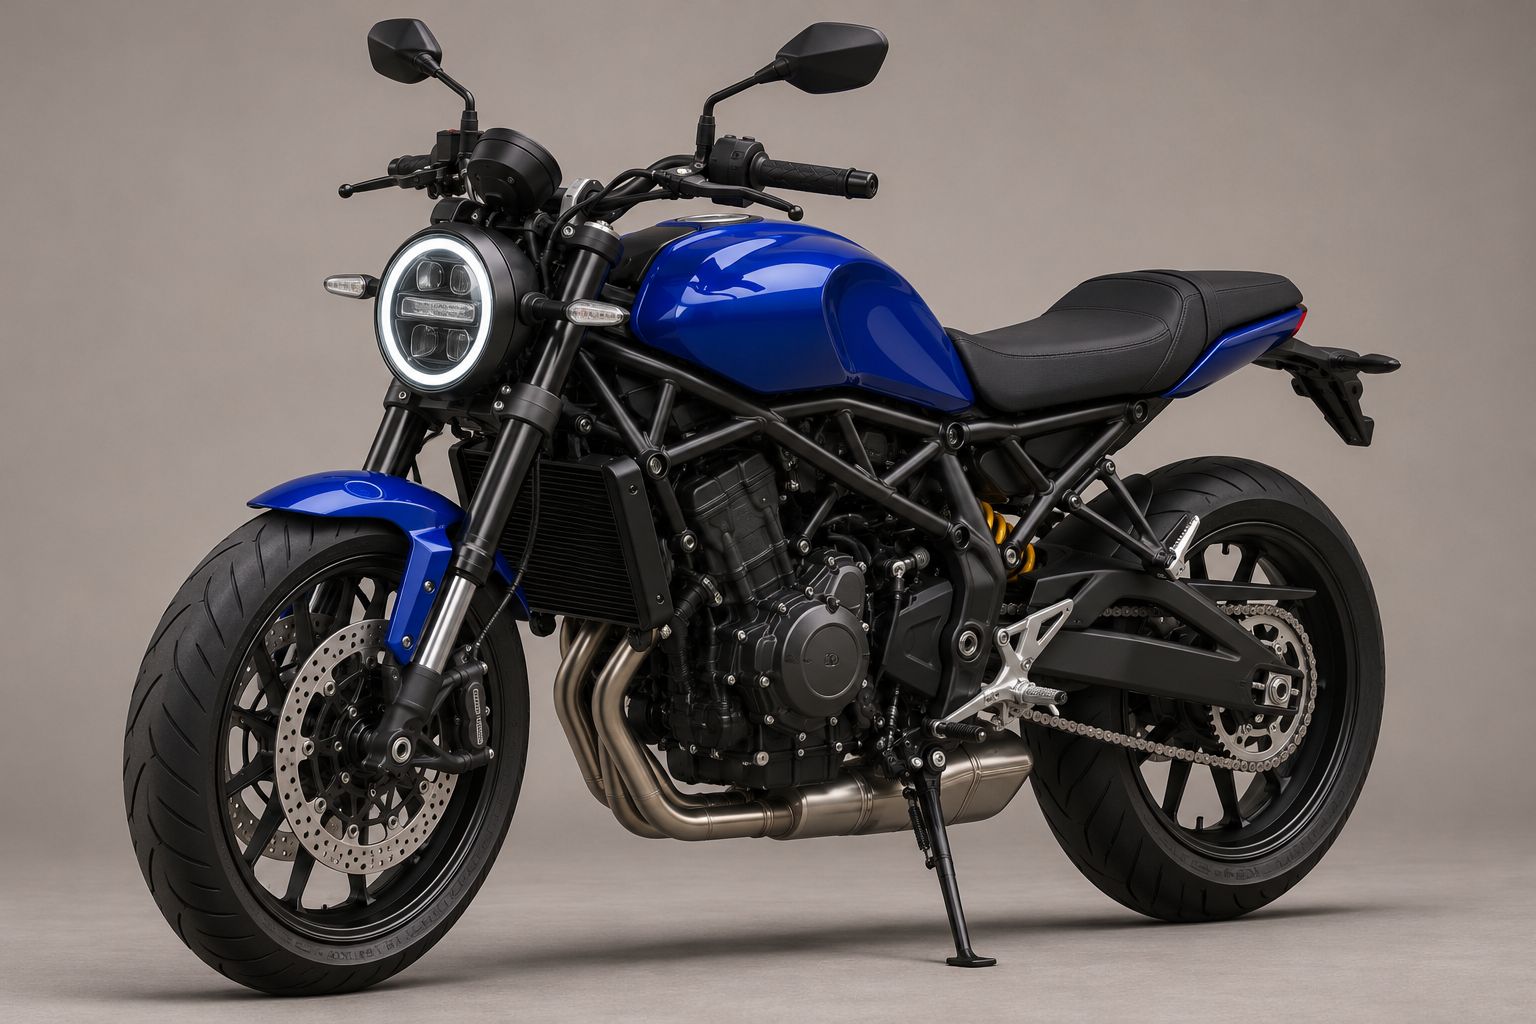 | Conserva el faro redondo y el motor al descubierto |
| 6 · Casco rojo y negro | 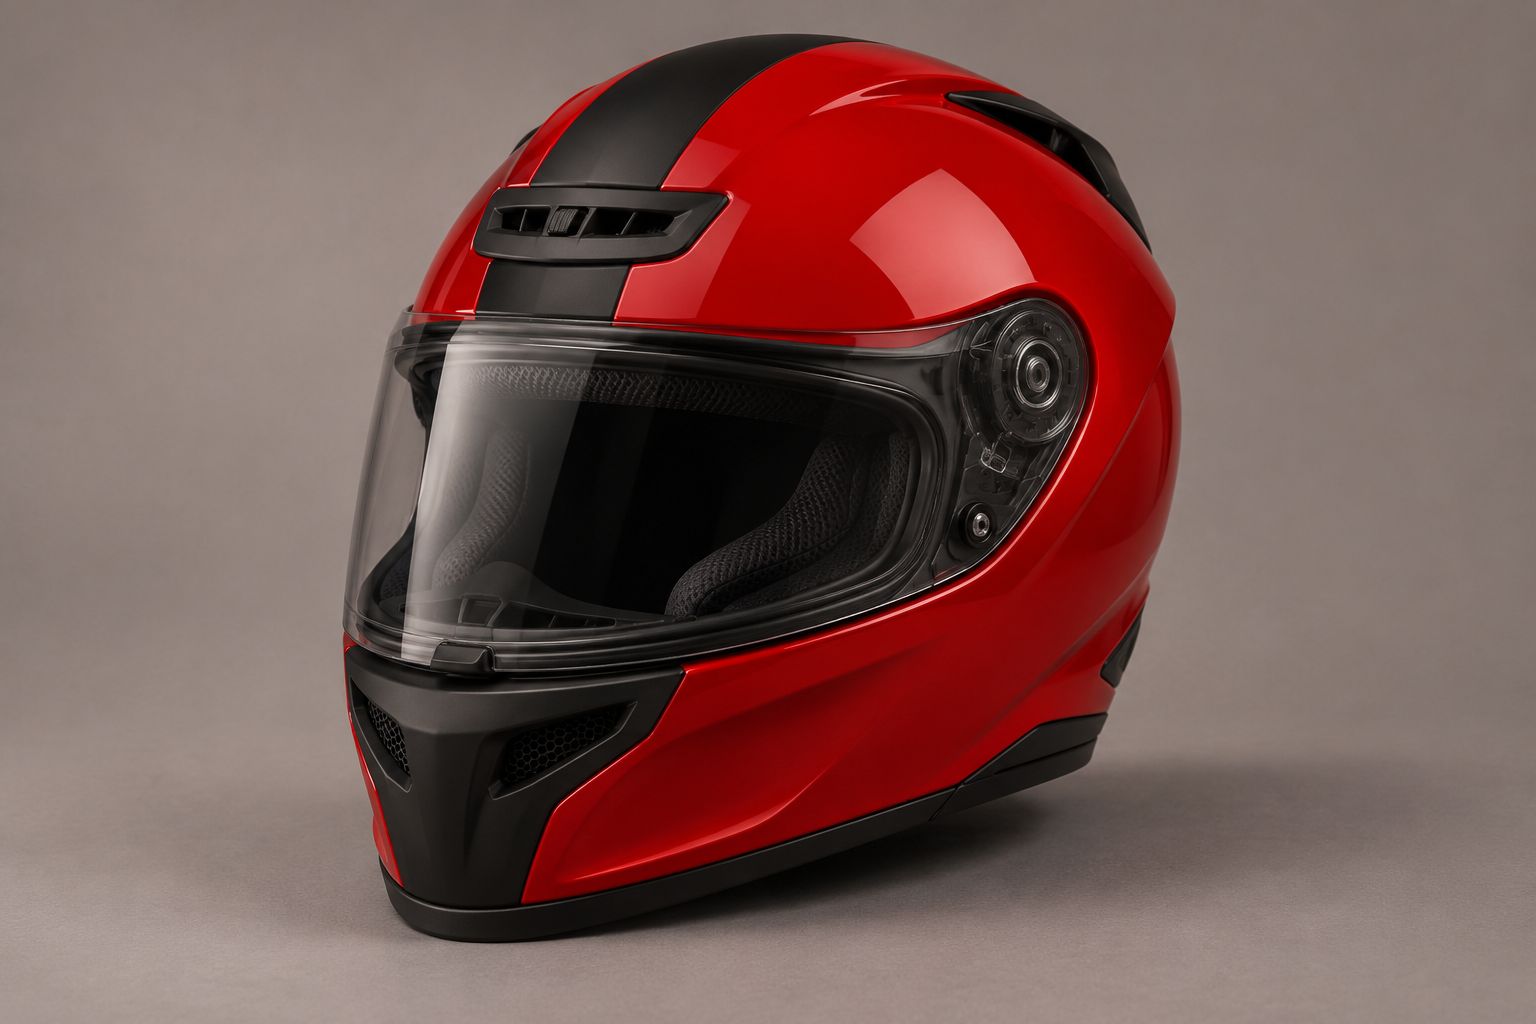 | Pasa de las manos del mecánico a la piloto |
| 7 · Casco blanco | 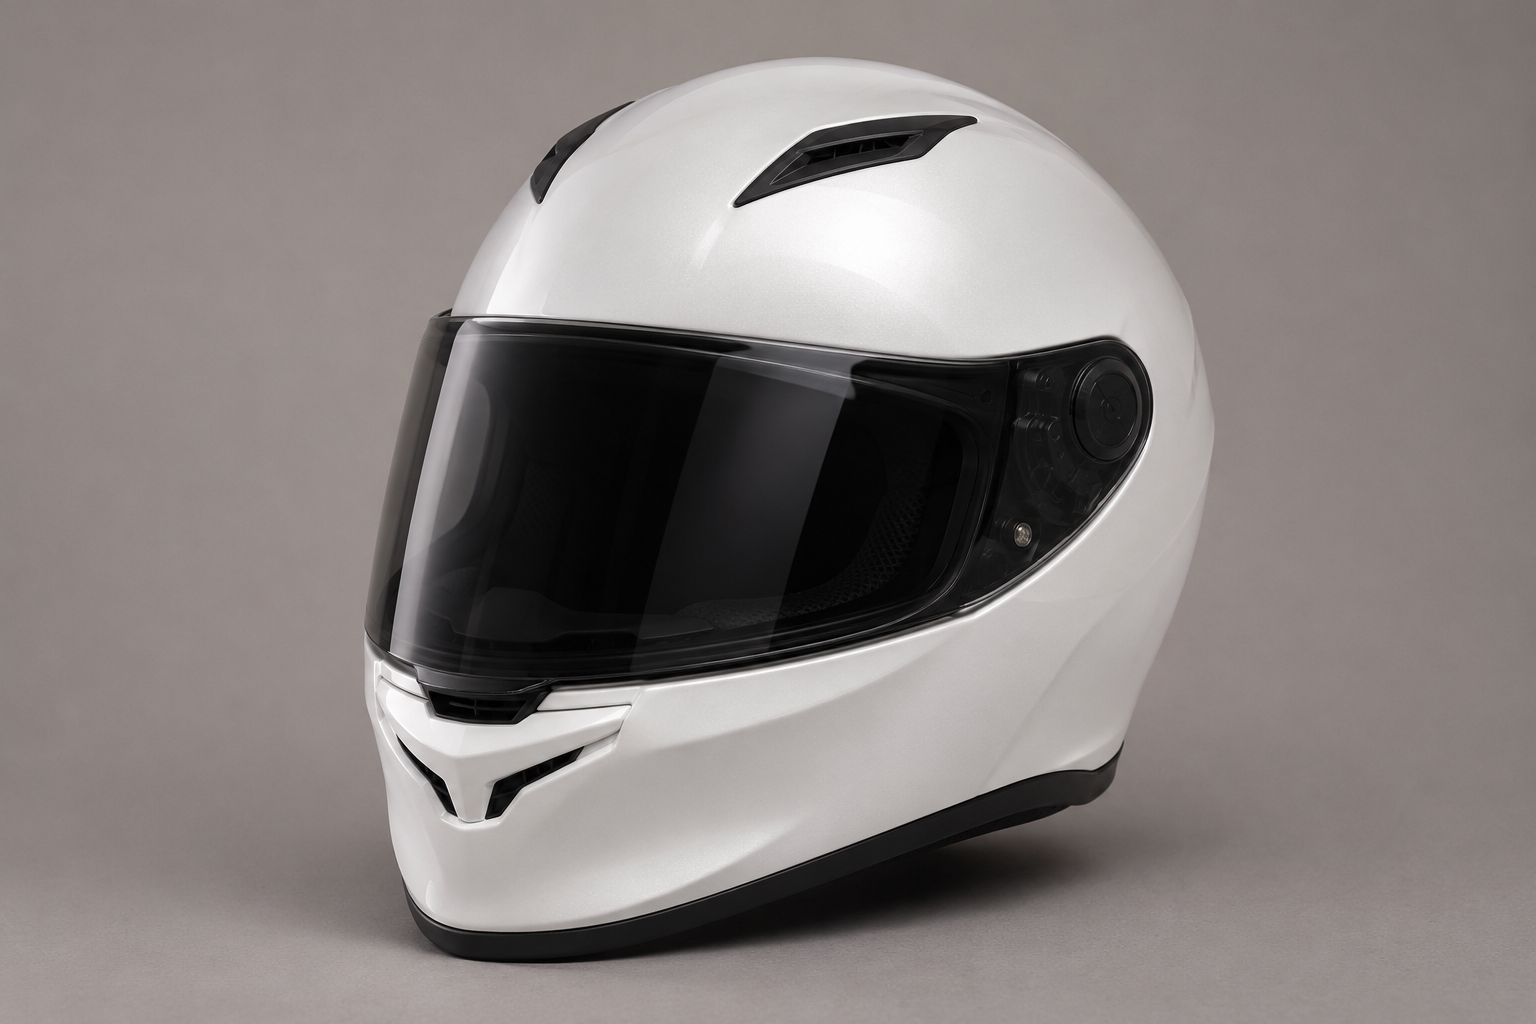 | Sostenido por el piloto |
Planificación de planos
| Tiempo | Plano |
|---|---|
| 0–3 s | Plano general que sitúa a las tres personas y las dos motos |
| 3–7 s | Plano medio que muestra con claridad la entrega del casco |
| 7–10 s | Regreso al plano general; ambos pilotos caminan hacia sus respectivas motos |
10 s · 720p · Audio nativo · Desde el envío hasta observar la finalización: aprox. 124 s
Tras los cambios de plano, los personajes y objetos se mantienen consistentes en su conjunto
Esta muestra mantuvo en líneas generales la coherencia de los elementos establecidos a lo largo de varios cortes de cámara. Al pasar del plano general al plano medio y volver de nuevo al plano general, los rasgos faciales, los monos de competición y la ropa de trabajo de los tres personajes se corresponden con sus referencias; asimismo, tanto la moto deportiva roja carenada como la moto naked azul de faro redondo conservan sus diseños originales. Las tres hojas de diseño en tres vistas se asignaron correctamente a tres personajes individuales, sin cometer el error de interpretar las tres vistas de una misma lámina como tres personas distintas.
La pertenencia y el traspaso de los cascos también mantuvieron la continuidad: al principio el mecánico sostiene el casco rojo y negro; tras el corte al plano medio, la piloto lo recibe mientras el mecánico abre las manos y las retira; al volver al plano general, el casco rojo y negro sigue en manos de la piloto, mientras que el piloto varón sostiene su casco blanco durante toda la secuencia. En tareas con múltiples referencias, poder distinguir con claridad la identidad de cada personaje y qué objeto lleva cada uno después de varios cortes de cámara resulta muy útil para el montaje posterior.
El vídeo final realiza los cortes aproximadamente en el segundo 3 y en el segundo 6,8, cumpliendo en lo esencial la estructura prevista de plano general, plano medio y vuelta a plano general. La iluminación se ajusta a la luz natural suave descrita en el texto, con reflejos contenidos tanto en el suelo como en los trajes de cuero. No obstante, la actuación de los personajes sigue siendo algo rígida y el detalle de los dedos durante la entrega del casco requiere una revisión más minuciosa. Según lo observado hasta ahora, esta muestra logró conservar la correspondencia general de personajes y objetos a través de los tres planos. En este apartado solo se probó Flash, sin realizar una comparativa de consistencia con la versión estándar.
Prompt en inglés para la prueba de múltiples referencias (versión condensada)
A continuación se conservan las correspondencias de las imágenes de referencia, la estructura en tres planos y las restricciones principales de la prueba original, omitiendo las descripciones repetitivas.
Create a 10-second photorealistic live-action scene in three shots, with hard cuts at 3s and 7s. Exactly three adults, two parked motorcycles and two helmets.

References define appearance only; replace their studio lighting and backgrounds:
@Image 1: one Korean woman, black ponytail, red-and-black racing suit.
@Image 2: one European-American man, short brown hair, yellow-and-black racing suit.
@Image 3: one middle-aged European-American mechanic, salt-and-pepper hair and stubble, navy coveralls.
Each character reference is a three-view sheet of ONE person.
@Image 4: red faired sportbike, angular split headlights.
@Image 5: blue naked roadster, round headlight, exposed engine.
@Image 6: red-and-black helmet, passed from mechanic to woman.
@Image 7: white helmet, held by the male racer throughout.
Preserve faces, outfits, object designs and colors across cuts.

Setting: a working pit garage on an overcast afternoon. Soft neutral daylight enters from camera-right; worn concrete walls, rear workbench and cabinets, dry matte floor. Natural skin, subdued leather reflections, no glossy skin or amber wash. Keep lighting and environment consistent.

0-3s, steady eye-level wide: woman left beside the red bike, mechanic center holding the red-and-black helmet, male racer right beside the blue bike holding the white helmet. Show full bodies and both bikes. Mechanic begins offering his helmet to the woman.

3-7s, steady medium two-shot from the same side of the action axis: woman left, mechanic right, faces and hands visible. She takes the red-and-black helmet with both hands; he releases it and withdraws empty hands. Show clear contact and release without fused fingers or duplicated objects.

7-10s, return to the wide: woman holds her received helmet and steps toward the red bike; male racer keeps his white helmet and steps toward the blue bike. Mechanic stays between them, hands empty. Bikes remain on stands; nobody mounts or puts on a helmet.

Maintain identities, screen direction, object ownership, grounded movement and natural occlusion. Audio: continuous quiet garage ambience, footsteps and helmet handling. No dialogue, music, extra cuts, slow motion, duplicated people or objects, text, logos or watermarks.
Velocidad de generación
| Escenario | Modelo | Duración | Desde el envío hasta observar la finalización |
|---|---|---|---|
| Inclinación de moto en curva y seguimiento | Flash | 8 s | 82,658 s |
| Inclinación de moto en curva y seguimiento | Seedance 2.5 | 8 s | 200,842 s |
| Combate continuo | Flash | 8 s | 82,400 s |
| Combate continuo | Seedance 2.5 | 8 s | 197,657 s |
| Interpretación y frase en inglés | Flash | 8 s | 87,419 s |
| Entrega de una llave entre dos personas | Flash | 8 s | 89,368 s |
| Pequeño movimiento a partir del primer fotograma | Flash | 8 s | 83,066 s |
| Siete imágenes de referencia y relevo en tres planos | Flash | 10 s | 124,013 s |
En los primeros cinco vídeos de 8 segundos generados con Flash, el tiempo transcurrido desde el envío de la tarea hasta observar su finalización osciló entre unos 82 y 89 segundos; por su parte, los dos vídeos de 8 segundos de la versión estándar tardaron aproximadamente 201 y 198 segundos respectivamente. El vídeo de 10 segundos con múltiples imágenes de referencia tardó unos 124 segundos; al contar con materiales de entrada y una duración distintos, se registra por separado sin calcular una diferencia directa de velocidad respecto a las muestras anteriores de 8 segundos. Si el flujo de trabajo diario exige ajustar prompts repetidamente, generar múltiples tandas de muestras y comparar el resultado de los planos, ahorrar más de un minuto en cada generación acelera notablemente el ritmo de prueba y selección en las fases iniciales.
Cabe aclarar que, aunque todas las tareas se enviaron desde la misma cuenta, las pruebas de ambas versiones se realizaron en franjas horarias distintas y no se repitió la generación varias veces por escenario para obtener un promedio. Los tiempos registrados incluyen fluctuaciones de red, colas en el servidor y el retardo de observación derivado de que el script consulte el estado cada cinco segundos. Por consiguiente, estos datos reflejan únicamente que el tiempo de espera real con Flash fue menor durante esta ronda de pruebas, y no pueden extrapolarse directamente como una ventaja de velocidad fija del modelo.
Cuándo usar Flash y cuándo elegir la versión estándar
Si el trabajo creativo se centra principalmente en el dinamismo y las escenas de acción, a la vista de los resultados de esta ronda, la versión estándar de Seedance 2.5 sigue siendo la opción más segura. En las dos comparativas dinámicas, la forma en que la versión estándar resuelve el desarrollo completo del movimiento, las reacciones físicas ante los impactos y el desplazamiento espacial se ajusta mejor a las exigencias visuales de este tipo de planos.
Por el contrario, si en la fase actual el objetivo principal es hacer pruebas rápidas de actuación, definir encuadres, tantear la redacción de los prompts o avanzar en la producción diaria de planos por lotes con un presupuesto ajustado, la reducción en el tiempo de espera y el menor precio unitario de Flash aportan un valor práctico evidente. También es capaz de generar clips con una buena textura visual, aunque a la hora de seleccionar las tomas sigue siendo necesario contrastarlas con los requisitos del guion gráfico y revisar con lupa los recortes de encuadre, el enlace entre movimientos y los detalles de interacción local.
En resumen, en las dos pruebas dinámicas de esta ronda, el rendimiento de movimiento de Flash aún no iguala por completo al de la versión estándar de Seedance 2.5, la cual mantiene la ventaja en integridad de la acción y sensación de fuerza; el posicionamiento de Flash consiste en acortar los tiempos de espera y reducir el coste por llamada manteniendo una calidad funcional, lo que facilita a los creadores iterar y producir muestras con alta frecuencia en las etapas previas. En cuanto a la interpretación con diálogo, la interacción detallada, la comprensión espacial y la consistencia entre planos con múltiples referencias, en esta ronda solo se generaron muestras con Flash con el fin de mostrar su desempeño real y los puntos clave a observar en dichas tareas, sin establecer una comparación directa sobre cuál de las dos versiones es superior en esos apartados.