O que é o modelo Seedance 2.5 Flash
O Seedance 2.5 Flash é o modelo de vídeo focado em velocidade de geração dentro da linha Seedance 2.5 da ByteDance. Nesta bateria de testes, avaliamos o desempenho dinâmico, atuação de personagens, interações detalhadas, compreensão espacial e consistência de storyboard com múltiplas imagens de referência, verificando até onde ele chega em tarefas comuns de criação. A partir dessas amostras, o Seedance 2.5 Flash equilibra eficiência de entrega e custo de uso, sendo adequado como modelo principal para criadores avançarem propostas no dia a dia e selecionarem planos.
Nos dois testes comparativos desta rodada, o Seedance 2.5 Flash entregou resultados mais rápido que a versão padrão, com uma qualidade de imagem utilizável. No entanto, em planos de movimento amplo — como inclinação de moto em curva, reações a golpes, rasteiras ou quedas no chão —, seu desempenho ainda ficou um pouco abaixo do Seedance 2.5 padrão em completude do movimento, sensação de força e execução de instruções complexas de ação.
Diferenças de parâmetros entre o Flash e os outros dois modelos
A tabela abaixo foi organizada com base na documentação oficial verificada em 16 de novembro de 2026 e lista os limites máximos de capacidade de cada modelo. Nesta rodada, os primeiros cinco testes do Flash e os dois vídeos comparativos da versão padrão têm 8 segundos cada, enquanto o caso com múltiplas imagens de referência tem 10 segundos, todos configurados em 720p. Esses são apenas os parâmetros usados neste teste prático e não significam que os modelos só consigam gerar vídeos nessa especificação.
| Parâmetro | Seedance 2.5 Flash | Seedance 2.5 | Seedance 2.0 |
|---|---|---|---|
| Resolução de saída | 480p, 720p | 480p, 720p, 1080p | 480p, 720p, 1080p, 4K |
| Duração por geração | 4–30 s | 4–30 s | 4–15 s |
| Limite de imagens de referência multimodal | 10 imagens | 30 imagens | 9 imagens |
| Limite de vídeos de referência multimodal | 5 clipes | 10 clipes | 3 clipes |
| Limite de áudios de referência multimodal | 5 clipes | 10 clipes | 3 clipes |
| Modo de amostra (Draft) | Não suportado | Suportado | Não suportado |
O Flash suporta saída de até 720p, com opção inferior de 480p. Em comparação com o Seedance 2.5, seu limite de imagens de referência foi reduzido de 30 para 10 imagens, e os vídeos e áudios de referência caíram de 10 para 5 clipes cada. Se um projeto exigir o envio de muitos materiais de referência ou precisar entregar arquivos originais diretamente em 1080p, essas diferenças técnicas afetarão diretamente a escolha do modelo.
Os limites de quantidade de referências na tabela referem-se a tarefas de referência multimodal, e não à quantidade de envios para imagem para vídeo a partir do primeiro quadro. Tarefas de primeiro quadro recebem apenas uma imagem, enquanto tarefas de primeiro e último quadro recebem respectivamente o quadro inicial e o final. Todos os limites acima vêm das especificações oficiais; o caso de múltiplas referências desta rodada usou sete imagens, sem testar o limite máximo de dez imagens nem outras faixas de resolução.
Comparação de preços oficiais para geração de vídeo
Os preços abaixo têm como referência a tabela oficial em chinês do Volcano Ark para inferência online, verificada em 16 de novembro de 2026, considerando vídeos em 720p, proporção 16:9 e entradas sem vídeo. Os testes desta rodada — texto para vídeo, imagem para vídeo com primeiro quadro e vídeo com múltiplas imagens de referência — não utilizaram vídeos de referência na entrada.
| Modelo | Preço unitário oficial | Preço estimado por segundo (exemplo oficial) | Orçamento de referência (vídeo de 8 s) | Orçamento de referência (vídeo de 10 s) |
|---|---|---|---|---|
| Seedance 2.5 Flash | 46 CNY / milhão de tokens | aprox. 0,99 CNY | aprox. 7,9 CNY | aprox. 9,9 CNY |
| Seedance 2.5 | 70 CNY / milhão de tokens | aprox. 1,51 CNY | aprox. 12,1 CNY | aprox. 15,1 CNY |
| Seedance 2.0 | 46 CNY / milhão de tokens | aprox. 0,99 CNY | aprox. 7,9 CNY | aprox. 9,9 CNY |
Nas mesmas condições, o preço unitário oficial por token do Flash é cerca de 34% menor que o do Seedance 2.5 e empata com o do Seedance 2.0. O Seedance 2.0 aparece aqui apenas como referência de parâmetros e preços; não geramos amostras de teste com ele nesta rodada. Os orçamentos para 8 e 10 segundos na tabela são conversões aproximadas baseadas no preço por segundo dos exemplos do site oficial, para facilitar a comparação. A cobrança real depende do preço unitário do token e do consumo efetivo na fatura oficial, portanto os valores listados aqui não representam o gasto exato com estas amostras.
Desempenho prático em cada capacidade
Este teste avalia cinco categorias de capacidade de geração por meio de seis cenários, totalizando seis amostras do Flash e duas amostras comparativas do Seedance 2.5 padrão. A curva de motocicleta e a luta contínua entram em desempenho dinâmico, com comparação entre as duas versões; os outros quatro itens testam apenas o desempenho do Flash. Os primeiros sete vídeos têm 8 segundos cada, e o caso com múltiplas imagens de referência tem 10 segundos divididos em três planos.
| Categoria de capacidade | Cenário de teste | Duração | Desempenho principal do Flash | Comparativo Seedance 2.5 |
|---|---|---|---|---|
| Desempenho dinâmico e controle de câmera | Curva de moto e acompanhamento | 8 s | Tem sensação de velocidade, mas o corte fechado prejudica a exibição completa da curva | Processo mais completo de inclinação, passagem pelo ápice e endireitamento |
| Desempenho dinâmico e controle de câmera | Luta contínua | 8 s | Gera ataque e defesa contínuos, mas algumas transições e a sensação de força são fracas | Rotação de tronco, reação corporal e deslocamento frontal/traseiro mais naturais |
| Atuação de personagem e fala | Ler carta, olhar para cima e falar em inglês | 8 s | Mostra a transição da leitura para o sorriso; fala e sincronia labial ainda não verificadas de forma independente | Não testado |
| Interação detalhada | Duas pessoas entregando uma chave | 8 s | Relação de entrega da chave clara, desvio no perfil da personagem, contato dos dedos exige análise detalhada | Não testado |
| Compreensão espacial | Girar caneca sobre a mesa | 8 s | Layout geral preservado, ângulo de rotação da caneca não confirmado, câmera avança levemente | Não testado |
| Múltiplas referências e consistência de planos | Sete imagens gerando entrega em três planos | 10 s | Entre os três planos, personagens, motos e posse dos capacetes mantêm consistência geral | Não testado |
A seguir, apresentamos os vídeos originais e os prompts por categoria de capacidade. O tempo específico de espera de cada vídeo está reunido na tabela de velocidade de geração ao final do artigo.
Desempenho dinâmico e controle de câmera
Esta seção utiliza dois cenários — uma moto inclinando na curva e uma luta entre duas pessoas — para observar a conexão dos movimentos, a mudança do centro de gravidade, a trajetória e se a câmera consegue mostrar o processo da ação com clareza. Os dois modelos usaram exatamente os mesmos prompts em inglês e as mesmas configurações de geração.
Curva de moto e acompanhamento
Os requisitos do prompt foram idênticos para as duas versões: um piloto conduz uma moto esportiva vermelha por uma curva longa, com a câmera acompanhando de um ângulo baixo frontal-lateral; após passar pelo ápice da curva, a moto se endireita gradualmente, e a moto inteira com as duas rodas deve permanecer dentro do quadro o tempo todo.
Seedance 2.5 Flash
8 s · 720p · Áudio nativo · Do envio até a conclusão observada: 82,7 s
Seedance 2.5
8 s · 720p · Áudio nativo · Do envio até a conclusão observada: 200,8 s
O Flash parece mais um close-up de corrida
Na imagem gerada pelo Flash, a carenagem frontal vermelha, o asfalto molhado, os reflexos de luz e o spray de água levantado pela roda traseira estão bem nítidos; o fundo recua rapidamente e o acompanhamento colado na frente transmite sensação de velocidade. Porém, o enquadramento é fechado demais: a cabeça e o tronco do piloto, além de parte da moto, foram cortados para fora do quadro, e as rodas dianteira e traseira não foram mantidas inteiras como pedia o prompt. Embora dê para notar a inclinação da moto, a composição muito justa impede o espectador de ver claramente como o piloto e a motocicleta trabalham juntos para fazer a curva.
Se a edição final precisar justamente de um corte rápido em close-up fechado da moto, esse material pode ser usado; mas se o storyboard exigir a demonstração completa da inclinação na curva, ou precisar conectar esse plano após uma tomada que mostre o traçado da pista, esse enquadramento que corta parte do piloto e da moto não será adequado.
A versão padrão mostra a curva de forma mais completa
A versão padrão mantém a silhueta do piloto e da motocicleta inteira dentro do quadro. Seguindo a linha do tempo, a moto inclina para entrar na curva, aproxima-se do ápice e depois reduz gradualmente o ângulo de inclinação até ficar reta; observando a relação de posição entre a zebra interna da pista e a moto, a trajetória do veículo também fica bem clara.
Essa fluidez vem da coordenação entre a postura da moto, o centro de gravidade do piloto, o traçado da curva e a distância da câmera. Em comparação com o close-up fechado do Flash, a versão padrão apresenta com mais clareza o processo desde a inclinação até o endireitamento gradual, entregando um desempenho de movimento melhor neste cenário.
Ainda assim, o ângulo frontal-lateral de acompanhamento e o enquadramento da versão padrão também sofrem variações durante o percurso. Apenas com quadros amostrados, não é possível confirmar se o contato dos pneus com o solo e a estrutura da moto estão totalmente precisos a cada instante. Essa comparação mostra que a versão padrão apresenta o processo do movimento e a trajetória de forma mais completa, mas não permite afirmar que todos os detalhes físicos estejam exatos.
Prompt completo em inglês usado no teste da motocicleta
One continuous 8-second cinematic live-action shot on a closed motorcycle racing circuit just after rain, at blue hour. A single adult professional racer in black protective leathers and a full-face helmet rides one unbranded red sport motorcycle through a sweeping right-hand bend. A low front three-quarter tracking camera follows alongside at matching speed, keeping the whole motorcycle and both wheels visible. The racer leans naturally into the corner, reaches the apex, then gradually brings the bike upright toward the exit. Both tires remain on the wet asphalt. Track barriers and floodlights move past in the background, with a fine spray of water trailing the rear tire. Physically plausible rider anatomy and motorcycle geometry, consistent red bodywork, realistic film texture. Sound: one motorcycle engine rising smoothly and wet tire hiss. No dialogue, no music, no cuts, no text, no subtitles, no logos.
Luta contínua entre duas pessoas
Este teste de luta exige que os dois modelos comecem o vídeo já em combate: uma sequência rápida de socos, esquiva e bloqueio, seguida de um chute forte de contra-ataque, avanço na perseguição, rasteira baixa e, por fim, queda com rolamento no chão. Para diferenciar os personagens durante a troca rápida de golpes, o prompt define que um veste jaqueta cinza com calça preta e o outro veste jaqueta azul-marinho escura com calça cáqui.
Seedance 2.5 Flash
8 s · 720p · Áudio nativo · Do envio até a conclusão observada: 82,4 s
Seedance 2.5
8 s · 720p · Áudio nativo · Do envio até a conclusão observada: 197,7 s
O Flash entrega vários golpes em sequência, mas com pouca sensação de força
O Flash conseguiu gerar a sequência de socos, bloqueio, chute, rasteira baixa e queda com rolamento. Porém, olhando de perto, algumas trocas parecem mais uma execução mecânica passo a passo; a reação ao impacto após socos e chutes e a transição fluida para o golpe seguinte parecem um pouco leves demais, quase flutuantes. Os dois lutadores se movem basicamente para a esquerda e para a direita no quadro, faltando variação de distância e profundidade (frente e fundo) entre a câmera e os personagens.
Além disso, barras pretas foram adicionadas automaticamente na parte superior e inferior da imagem, e a primeira metade do vídeo não manteve os pés totalmente visíveis. Se for necessário observar o pé de apoio, a movimentação de passos e a geração de força durante a luta, cortar os pés prejudica a avaliação.
A aplicação de força e o deslocamento são mais naturais na versão padrão
Na versão padrão, é possível ver o impulso dos ombros e costas e a rotação da cintura e abdômen quando o personagem soca; a esquiva, o chute de contra-ataque e o passo para trás também movimentam o corpo inteiro. Após abrirem distância, os dois voltam a se aproximar, emendando o golpe baixo e a queda com rolamento. A câmera ajusta sua posição conforme a troca de golpes avança, a distância frontal/traseira e a orientação dos personagens mudam continuamente, e a luta acontece em um espaço com sensação de profundidade, deixando a relação de posição entre frente e fundo mais clara.
Esta amostra apresenta o processo de impulso, defesa e perseguição de forma mais coesa. Em comparação com o Flash, os socos e chutes da versão padrão parecem ter mais peso e as conexões de combos são mais firmes, resultando em um desempenho de movimento superior neste cenário.
A versão padrão também não manteve os pés dos dois lutadores dentro do quadro durante todo o tempo. Quanto a saber se o contato dos socos e chutes é plausível, se a sequência cumpriu estritamente os três socos exigidos pelo prompt e se cada transferência de peso faz sentido, ainda é necessário assistir ao vídeo com atenção. Uma imagem com aspecto mais cinematográfico não significa que a coreografia esteja totalmente precisa, nem prova que cada exigência de movimento do prompt tenha sido seguida à risca.
Prompt completo em inglês usado no teste de luta
An explosive 8-second live-action martial-arts fight scene, fast real-time Hong Kong action-film choreography, one continuous shot. Two adult fighters in a gritty concrete parking garage: one in a light grey jacket and black trousers, the other in a dark navy jacket and tan trousers. They are already fighting in the opening frame. The grey fighter surges forward with a rapid three-punch combination; the navy fighter slips the first punch, blocks the next and drives back with a forceful body kick. The grey fighter staggers two steps, immediately closes the distance, ducks a swinging counterpunch and sweeps the navy fighter's leg. The navy fighter hits the floor in a controlled stunt fall and rolls away as the grey fighter pursues. Relentless attack-and-counterattack momentum throughout, short transitions, sharp acceleration, convincing physical impact reactions, forceful torso rotation, realistic weight and balance, clear changes of position across the floor. The camera tracks rapidly beside them at waist height in a medium-wide action framing, keeping both whole bodies and the floor under their feet visible, with subtle handheld vibration at impacts. Crisp readable action, restrained motion blur, hard overhead light, cinematic contrast, realistic anatomy and clothing, distinct stable identities. Audio: rapid footfalls, forceful punch and kick impacts, clothing snaps, heavy breathing and a solid floor impact. No slow motion, no standing around, no pauses to reset, no dialogue, no music, no text, no subtitles, no cuts, no blood, no gore, no weapons.
Atuação de personagem e fala
Este cenário exige que a personagem primeiro olhe para baixo lendo uma carta, depois levante a cabeça, diga em inglês “You kept the letter.” (Você guardou a carta.) e em seguida sorria por um instante. O prompt especifica que a fala deve ser dita entre os segundos 4 e 6, mantendo a câmera fixa.
Pelos quadros amostrados, a personagem passa da leitura com a cabeça baixa para o olhar erguido com um sorriso, e o rosto, a jaqueta e o papel da carta nas mãos permanecem reconhecíveis em todos os momentos. Esse tipo de atuação sutil não tem movimentos bruscos para interferir, sendo adequado para observar diretamente as expressões faciais e a transição emocional.
Ao avaliar planos de atuação com diálogo como este, imagem e som precisam ser conferidos separadamente. O fato de o vídeo conter uma faixa de áudio não garante que a pronúncia da fala e o movimento labial correspondam com precisão. Ao revisar o vídeo original, ainda é preciso confirmar se a frase em inglês foi pronunciada com clareza, se há vozes extras misturadas, se a fala começou entre os segundos 4 e 6 conforme solicitado e se o movimento da boca acompanha o áudio. Apenas com capturas estáticas, nesta rodada ainda não verificamos de forma independente se a fala está exata palavra por palavra nem se a sincronia labial está estritamente alinhada.
Prompt em inglês usado no teste de atuação
One continuous 8-second medium close-up in a quiet train carriage, naturalistic live-action cinematography. An adult woman in a plain navy jacket holds one opened letter below her face. 0-2 seconds: she reads it silently, with a thoughtful expression. 2-4 seconds: she takes a small breath and lifts her eyes toward a person just beside the camera. 4-6 seconds: with a restrained, tender smile she says clearly in English, 'You kept the letter.' 6-8 seconds: she holds the eye contact and the quiet smile. Keep her mouth fully visible and her face, clothing and letter consistent. The camera stays still. Audio: her single spoken line over soft carriage rumble. No other voices, no music, no captions, no readable writing, no subtitles, no cuts.
Interação detalhada
Este cenário exige que uma pessoa coloque uma pequena chave de latão na palma da mão de outra pessoa, solte os dedos e recolha a mão vazia. A entrega desse tipo de objeto pequeno e rígido é ideal para testar a qualidade de geração das mãos: quando as duas mãos se aproximam e se sobrepõem, o movimento de segurar e soltar a chave precisa ser mostrado com clareza.
Nos quadros amostrados da entrega, a mão que traz a chave avança até a palma aberta, deposita a chave e recua, enquanto a pessoa que recebe fecha os dedos em seguida. Abaixo, fizemos um recorte ampliado do momento da entrega para facilitar a observação do contato entre as pontas dos dedos e a chave.
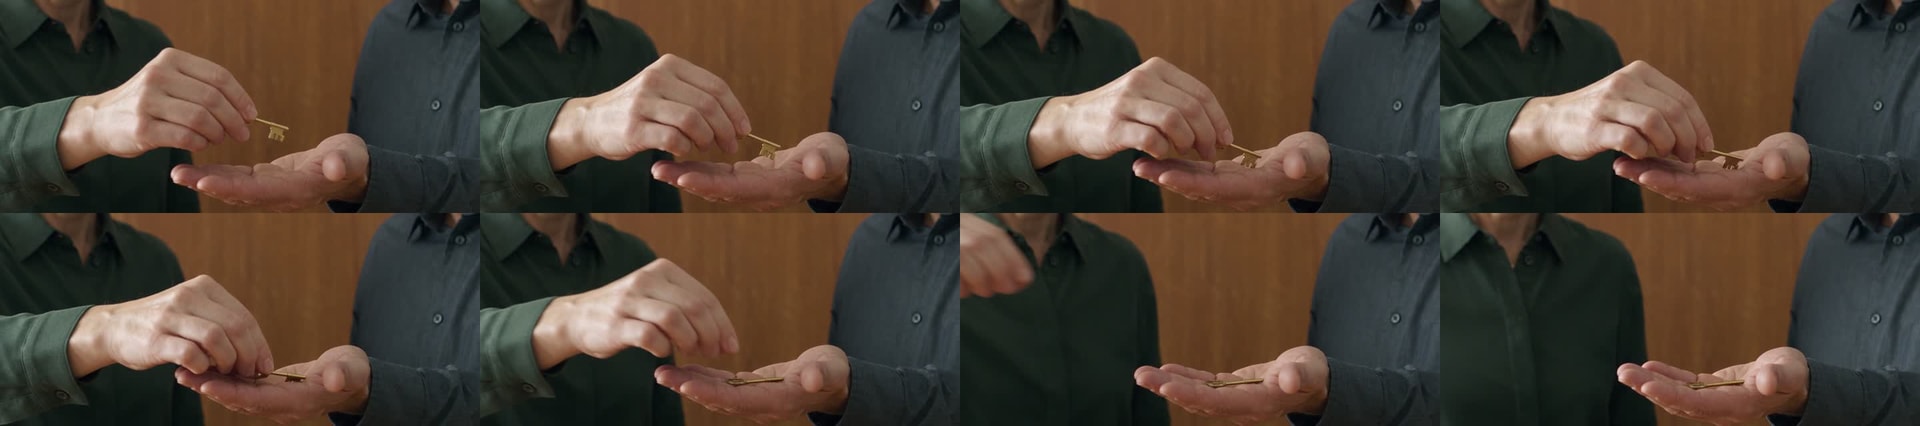
Ao inspecionar esse tipo de interação localizada, normalmente é preciso focar em alguns detalhes: se os dedos que seguram a chave se abrem naturalmente ao soltá-la, se há fusão ou borrado entre as pontas dos dedos e a chave ou a palma da outra pessoa, se a estrutura das articulações do polegar e dos outros dedos está normal e se a chave permanece sendo um único objeto durante todo o processo. Esses detalhes exigem análise quadro a quadro no vídeo; uma estrutura palmar normal no quadro inicial não garante que não haverá erros quando as duas mãos se sobrepuserem.
Além disso, esta amostra apresentou um desvio claro na configuração dos personagens. O prompt exigia explicitamente que a pessoa à esquerda entregando a chave fosse uma mulher, mas quem entrega na cena gerada aparece como um homem. Portanto, embora esta amostra sirva para observar o movimento de entrega com as mãos, ela não reproduziu o perfil dos personagens conforme solicitado. O fato de o objeto ter sido transferido não significa que todas as instruções do prompt foram cumpridas, nem permite concluir apenas por alguns quadros amostrados que a estrutura de contato dos dedos esteja totalmente correta.
Prompt em inglês usado no teste de entrega da chave
One continuous 8-second live-action shot, a fixed waist-up two-shot of two adults at a wooden counter, with both people's hands clearly visible throughout. The woman on the left wears a dark green shirt. The man on the right wears a charcoal shirt. 0-2 seconds: the woman holds exactly one small brass key between the fingers of her right hand; the man presents his empty open left palm. 2-5 seconds: she moves that key into his left palm and releases it. 5-8 seconds: she withdraws her visibly empty right hand, and he closes his fingers around the received key. Maintain one key, two people and continuous natural hand movements. Show the actual contact and release clearly, with realistic anatomy and steady framing. Soft side lighting, believable skin and wood textures. Audio: quiet room tone and a small metallic click during the transfer. No speech, no music, no text, no subtitles, no cuts.
Compreensão espacial
Este teste recebeu como entrada uma imagem estática original e sem texto como primeiro quadro. A personagem, a caneca azul, o caderno fechado, a escrivaninha e o fundo do quarto já estavam definidos nessa imagem inicial. O movimento exigido pelo prompt é bem pequeno: a personagem olha para baixo, estende a mão e gira a caneca em um quarto de volta sobre o tampo da mesa (sem tirar a base da caneca da mesa), depois solta a mão e vira o rosto para olhar pela janela.
Além de observar se a aparência da personagem se mantém consistente, este plano avalia principalmente a compreensão do modelo sobre as relações espaciais na mesa: se a mão avança até a alça da caneca por uma direção plausível, se a base permanece colada à mesa enquanto a caneca gira, se a posição relativa entre o caderno, a caneca e a mesa continua estável e se a oclusão (o que fica na frente e atrás) está correta e sem atravessamento de objetos (clipping) durante o ato de segurar e soltar a alça.
Pelos quadros amostrados, a disposição geral sobre a mesa manteve-se estável: é possível ver o processo da mão indo até a caneca e voltando, e o caderno permanece no lugar original à direita. No entanto, embora a orientação da alça da caneca mude durante o movimento, na metade final ela parece voltar a ficar próxima da posição inicial; olhando apenas para este conjunto de quadros amostrados, é difícil confirmar se a caneca realmente completou um quarto de volta e parou no novo ângulo. Além disso, o prompt pedia câmera travada, mas o vídeo gerado ainda apresenta um leve avanço de câmera.
Ao avaliar vídeos gerados a partir do primeiro quadro como este, além da manutenção dos traços da personagem, o ponto-chave é verificar se a posição original dos objetos e a relação de oclusão se mantêm quando a mão toca um objeto rígido sobre a mesa. Para conferir o contato dos dedos, as oclusões e o deslocamento dos objetos, recomenda-se comparar a imagem original do primeiro quadro lado a lado com o vídeo gerado.
Prompt em inglês usado no teste de girar a caneca
Continue the supplied first frame as one steady 8-second live-action shot. Preserve this exact adult woman's appearance, navy shirt, desk, single blue mug, closed tan notebook, background and window lighting. 0-2 seconds: she briefly glances down toward the blue mug. 2-5 seconds: she gently takes the mug handle with her right hand and rotates the mug a quarter turn on the tabletop without lifting it. 5-8 seconds: she releases the mug, rests her right hand beside it, and looks back toward the window. The mug stays on the desk and remains one rigid ceramic object, and the closed notebook remains fixed throughout. Keep the camera locked with no cut or zoom. Audio: quiet indoor ambience and a soft ceramic scrape during the turn. No speech, no music, no text, no subtitles.
Múltiplas imagens de referência e consistência de storyboard
Este teste amplia a duração para 10 segundos e usa sete imagens de referência para gerar um clipe com três planos. Os personagens foram definidos como uma pilota coreana, um piloto euro-americano e um mecânico euro-americano de meia-idade, cada um com uma folha de referência em três vistas (frente, perfil e costas); também foram fornecidas duas motocicletas com designs diferentes e dois capacetes, um vermelho e preto e outro branco.
As imagens de referência servem para definir rostos, roupas e o design dos objetos. Não foram enviadas imagens de cenário nem rascunhos de storyboard; o ambiente da oficina, a iluminação e os cortes de câmera foram controlados apenas por descrição em texto: tarde nublada, luz natural suave entrando pela porta da garagem, piso seco e redução de reflexos fortes na pele e nos macacões de couro.
Quais imagens de referência foram usadas
| Conteúdo de referência | Imagem | Relação correspondente |
|---|---|---|
| 1 · Três vistas da pilota | 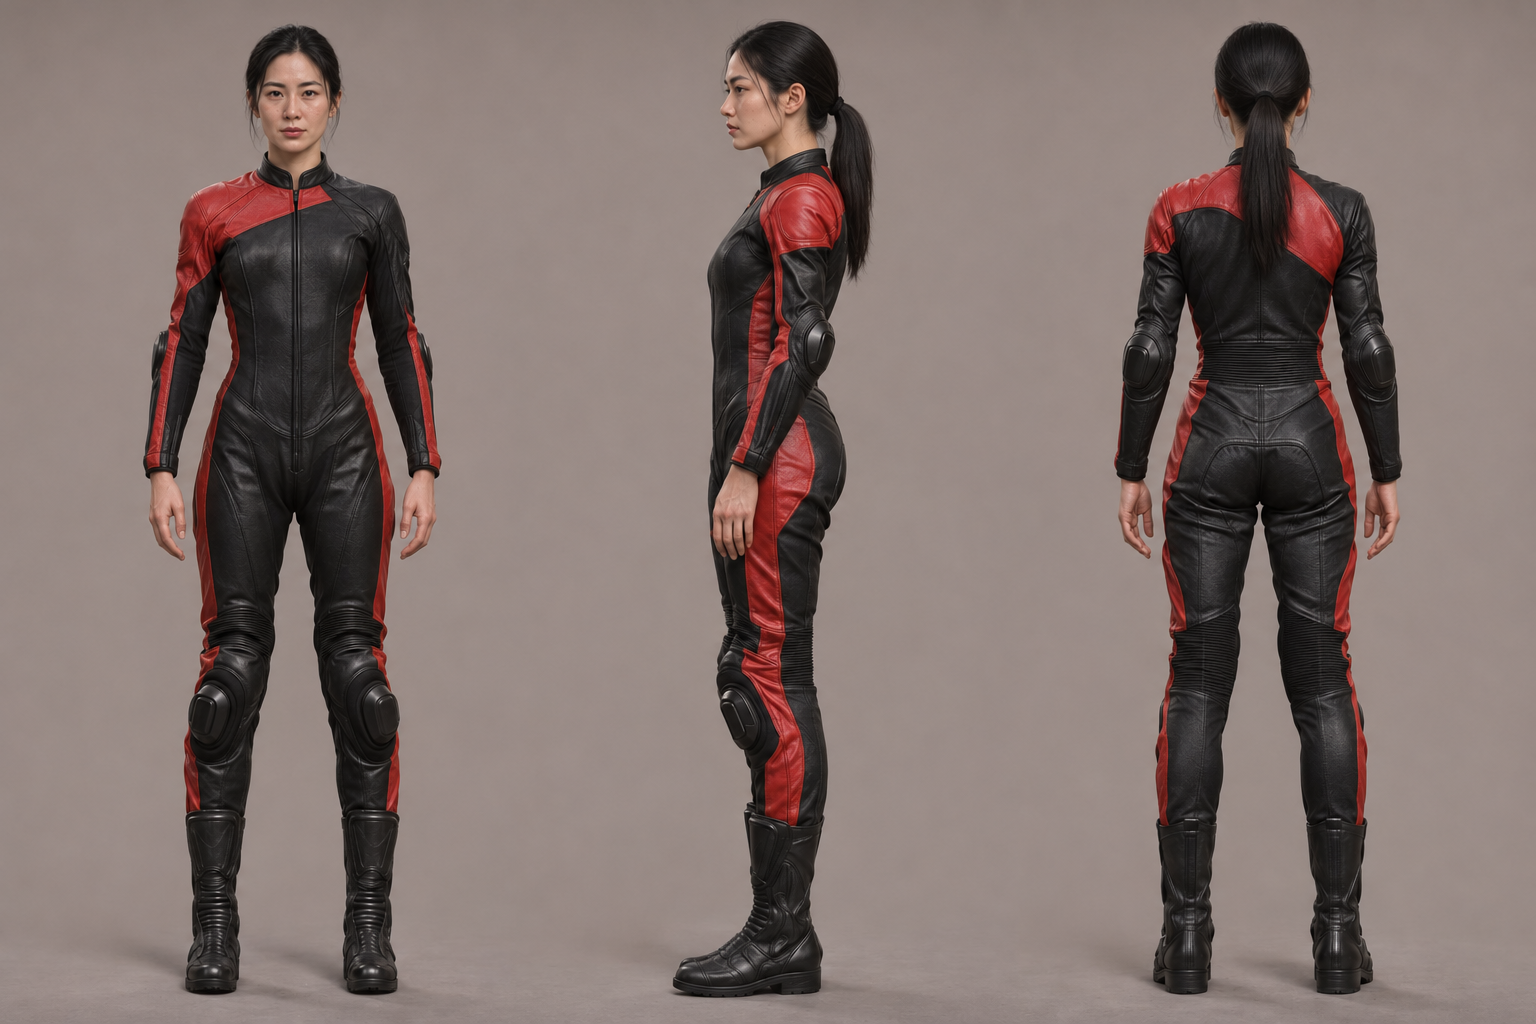 | Macacão de corrida vermelho e preto, recebe o capacete vermelho e preto |
| 2 · Três vistas do piloto | 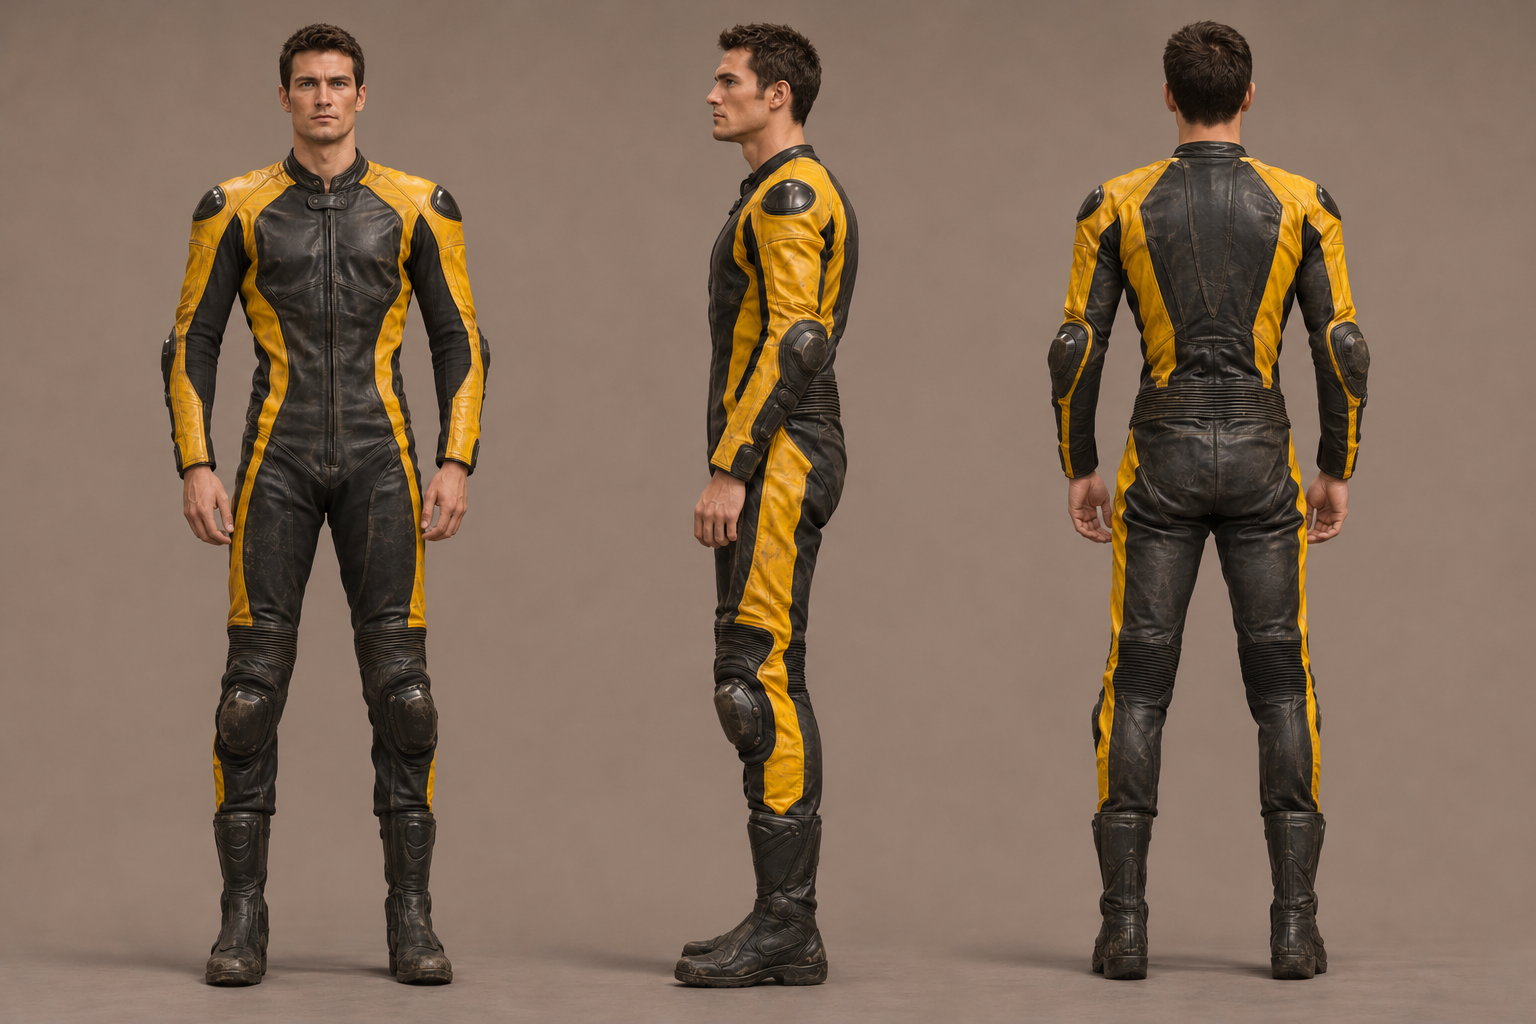 | Macacão de corrida amarelo e preto, segura o capacete branco o tempo todo |
| 3 · Três vistas do mecânico | 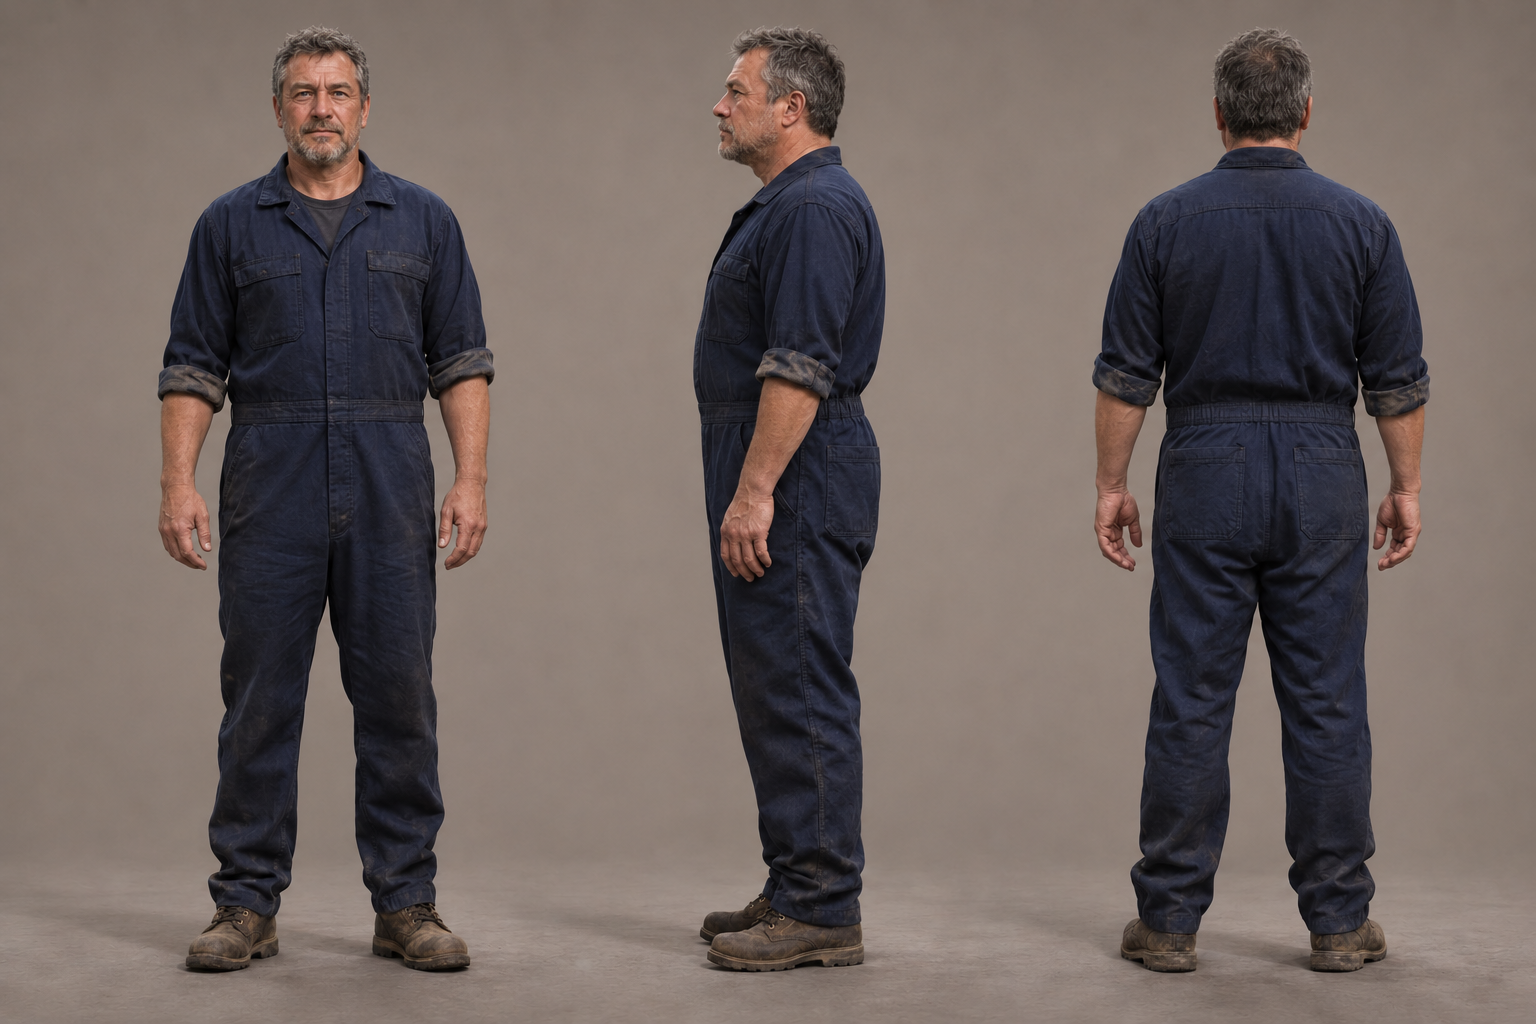 | Macacão de trabalho azul-marinho, entrega o capacete e recolhe as mãos vazias |
| 4 · Motocicleta vermelha | 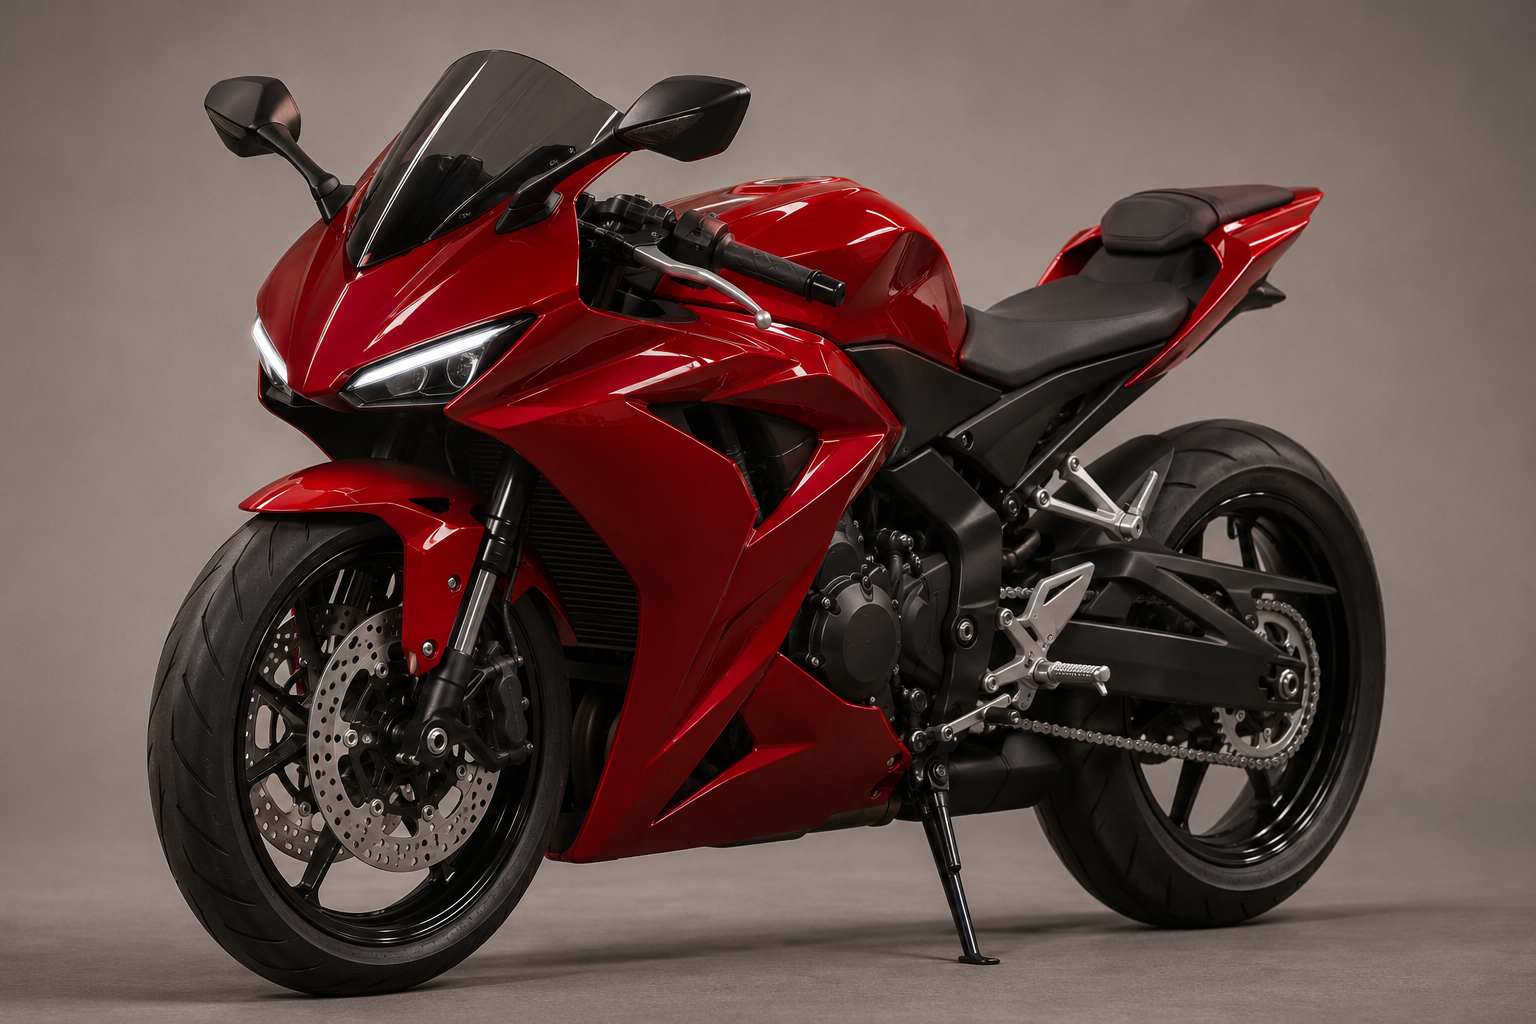 | Mantém a carenagem integral e os faróis divididos |
| 5 · Motocicleta azul | 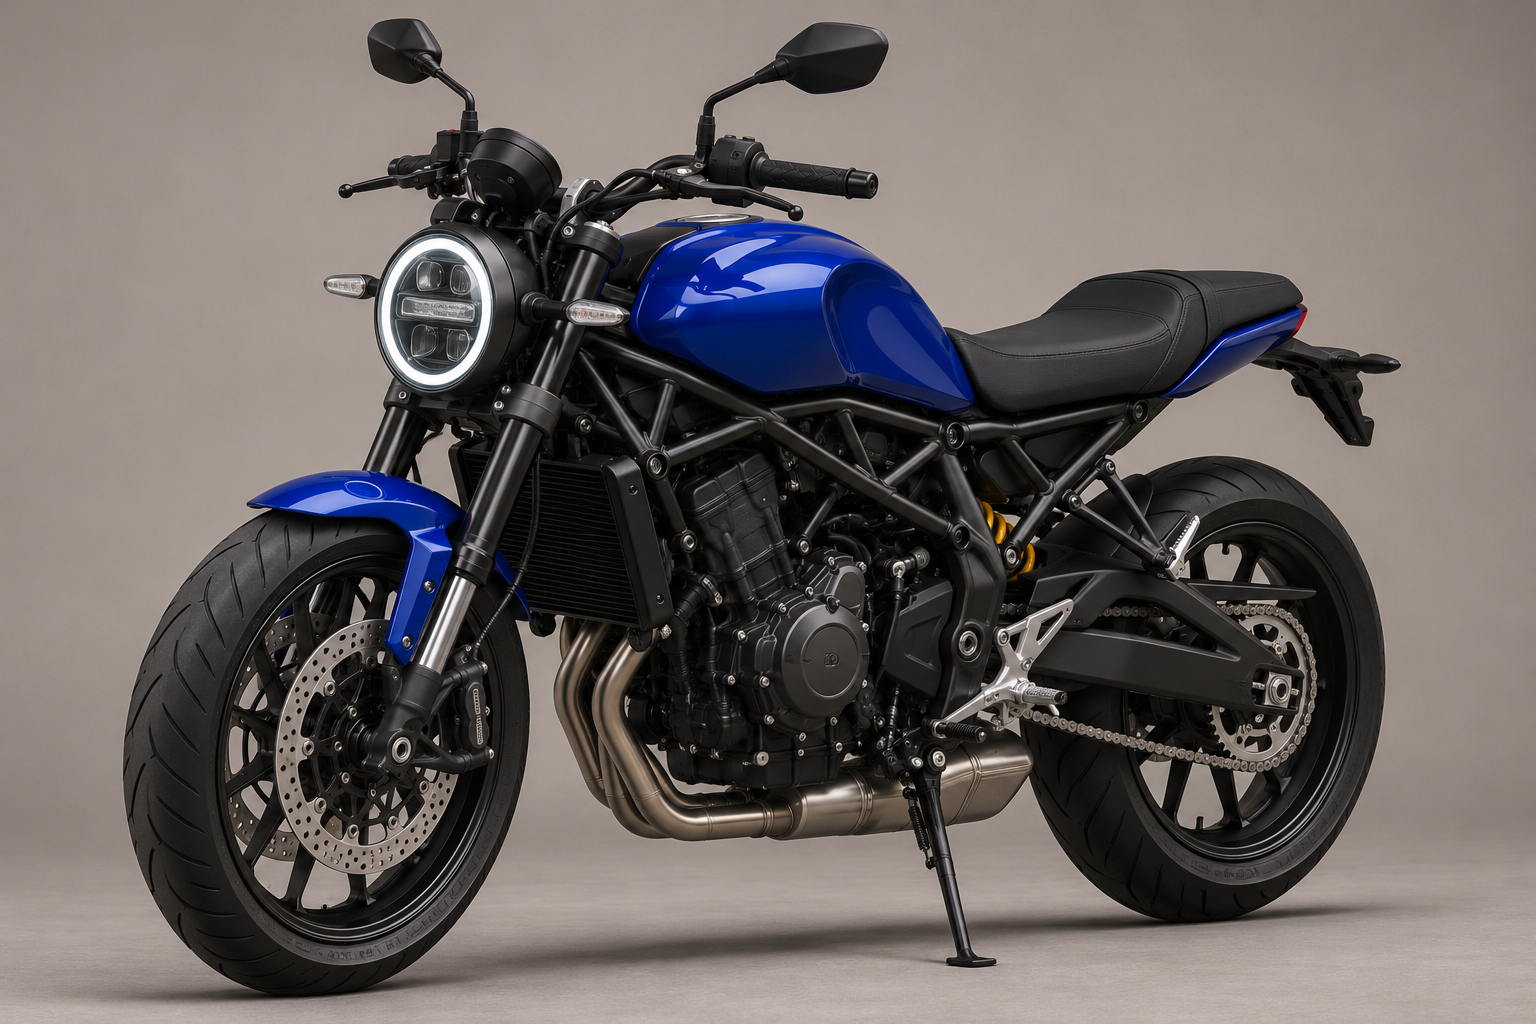 | Mantém o farol redondo e o motor exposto |
| 6 · Capacete vermelho e preto | 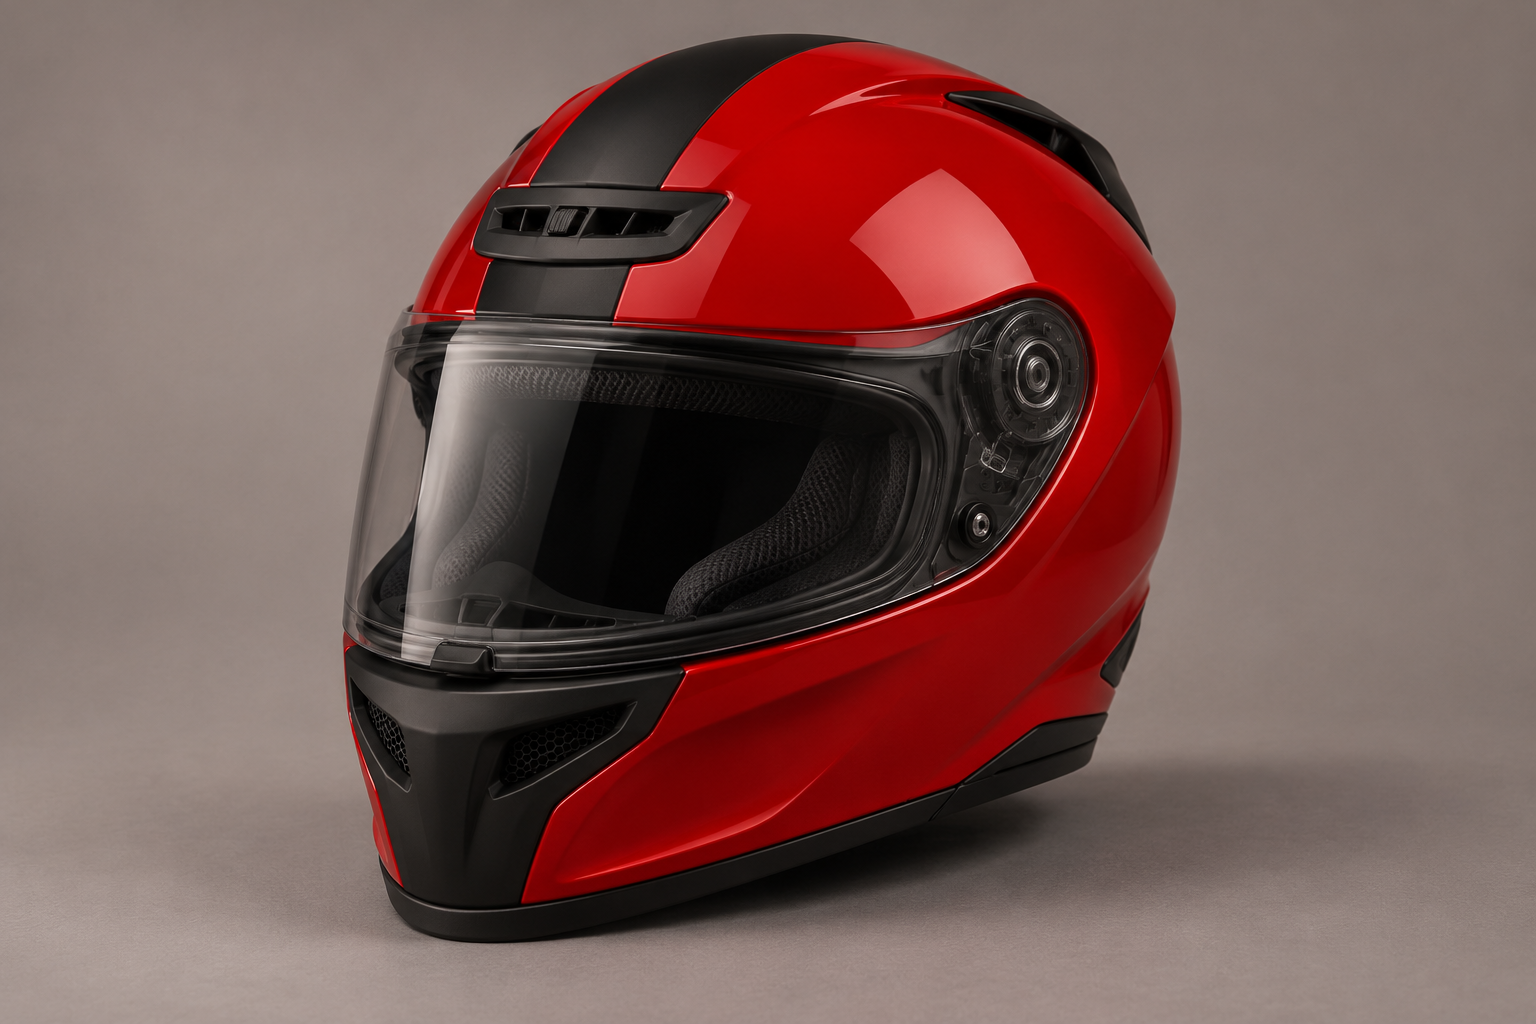 | Passado das mãos do mecânico para a pilota |
| 7 · Capacete branco | 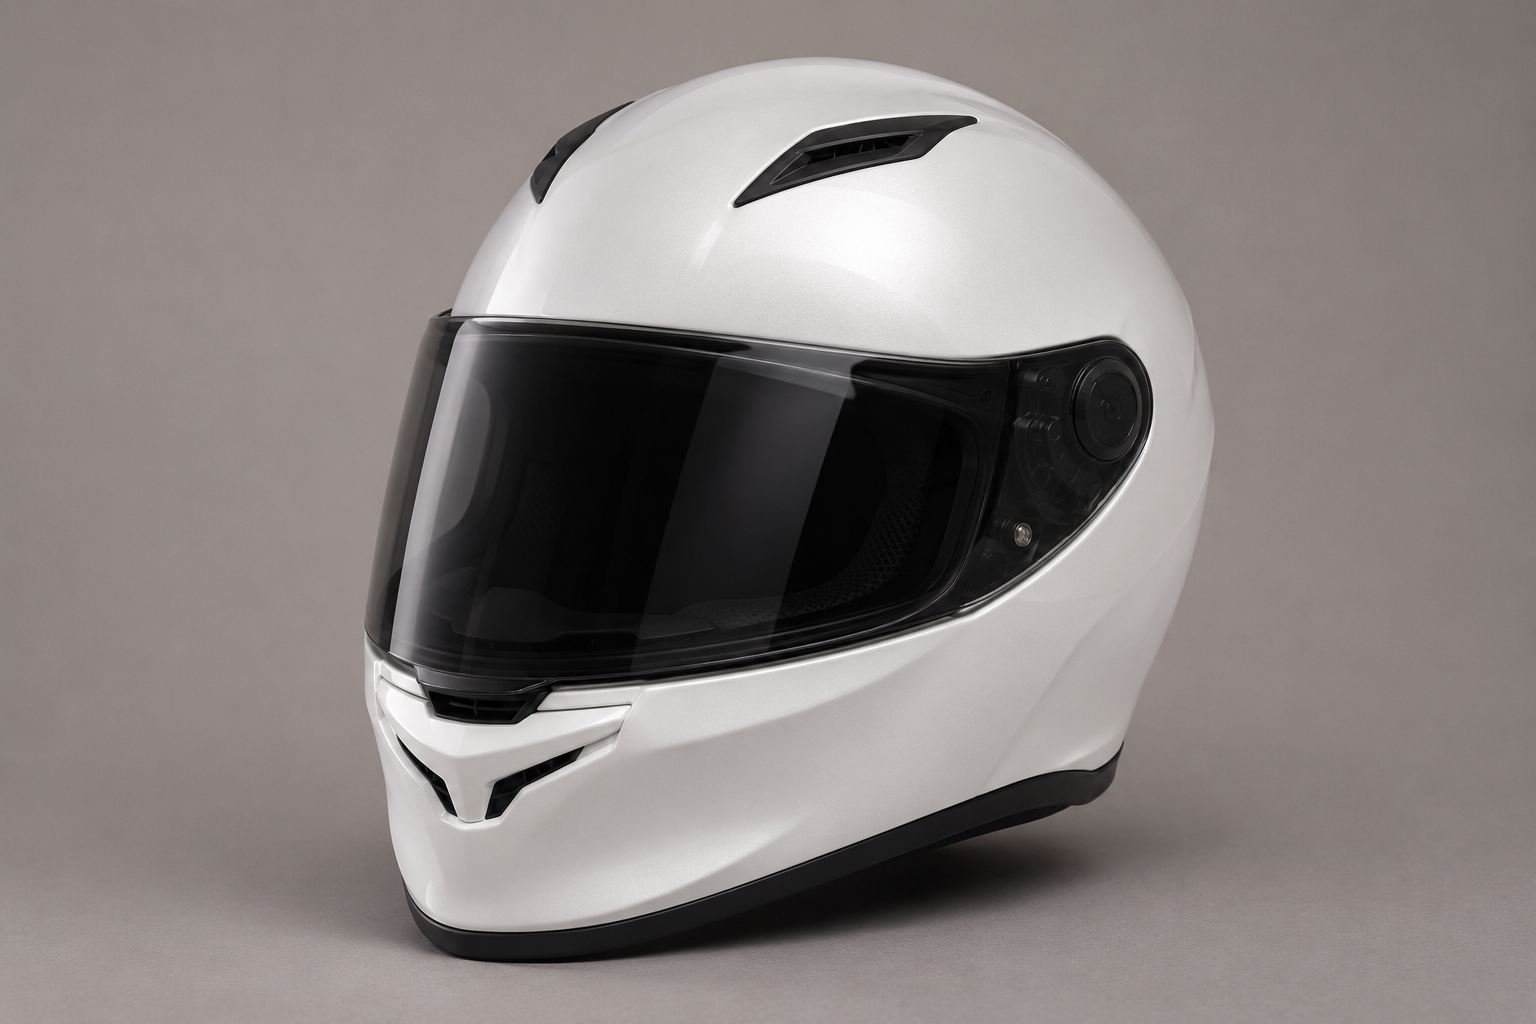 | Segurado pelo piloto |
Divisão de planos
| Tempo | Plano |
|---|---|
| 0–3 s | Plano geral mostrando a posição das três pessoas e das duas motos |
| 3–7 s | Plano médio mostrando claramente a entrega do capacete |
| 7–10 s | Volta ao plano geral, os dois pilotos caminham até suas respectivas motos |
10 s · 720p · Áudio nativo · Do envio até a conclusão observada: aprox. 124 s
Após os cortes de câmera, personagens e objetos mantêm consistência geral
Esta amostra manteve a consistência geral das referências mesmo após múltiplos cortes. A câmera corta do plano geral para o plano médio e depois volta ao plano geral, e os rostos, macacões de corrida e uniforme de trabalho dos três personagens permanecem correspondentes; a moto esportiva vermelha carenada e a naked azul de farol redondo também preservaram seus designs originais. As três folhas de personagem em três vistas corresponderam a três pessoas distintas, sem gerar as três poses de uma mesma folha como se fossem três indivíduos diferentes.
A posse e a relação de entrega dos capacetes também mantiveram a continuidade: no início, o mecânico segura o capacete vermelho e preto; após o corte para o plano médio, a pilota recebe o capacete e o mecânico solta e recolhe as mãos; ao cortar de volta para o plano geral, o capacete vermelho e preto continua nas mãos da pilota, enquanto o piloto segura o capacete branco durante todo o vídeo. Para tarefas com múltiplas imagens de referência, conseguir distinguir a identidade dos personagens e os objetos que cada um carrega após os cortes de câmera é muito útil para a edição posterior.
O vídeo final faz os cortes por volta dos segundos 3 e 6,8, cumprindo basicamente o planejamento de plano geral, plano médio e retorno ao plano geral. A iluminação da cena segue a luz natural suave descrita no texto, com reflexos contidos no piso e nos couros. Porém, a atuação dos personagens ainda parece um pouco rígida, e os detalhes dos dedos durante a entrega do capacete exigem uma observação mais atenta. Pelos resultados observados até aqui, esta amostra manteve a correspondência geral de personagens e objetos ao longo dos três planos. Este grupo testou apenas o Flash, sem comparativo de consistência com a versão padrão.
Prompt em inglês do teste com múltiplas imagens de referência (versão condensada)
O texto abaixo preserva o mapeamento das imagens de referência, os três planos e as restrições principais do teste original, omitindo descrições repetitivas.
Create a 10-second photorealistic live-action scene in three shots, with hard cuts at 3s and 7s. Exactly three adults, two parked motorcycles and two helmets.

References define appearance only; replace their studio lighting and backgrounds:
@Image 1: one Korean woman, black ponytail, red-and-black racing suit.
@Image 2: one European-American man, short brown hair, yellow-and-black racing suit.
@Image 3: one middle-aged European-American mechanic, salt-and-pepper hair and stubble, navy coveralls.
Each character reference is a three-view sheet of ONE person.
@Image 4: red faired sportbike, angular split headlights.
@Image 5: blue naked roadster, round headlight, exposed engine.
@Image 6: red-and-black helmet, passed from mechanic to woman.
@Image 7: white helmet, held by the male racer throughout.
Preserve faces, outfits, object designs and colors across cuts.

Setting: a working pit garage on an overcast afternoon. Soft neutral daylight enters from camera-right; worn concrete walls, rear workbench and cabinets, dry matte floor. Natural skin, subdued leather reflections, no glossy skin or amber wash. Keep lighting and environment consistent.

0-3s, steady eye-level wide: woman left beside the red bike, mechanic center holding the red-and-black helmet, male racer right beside the blue bike holding the white helmet. Show full bodies and both bikes. Mechanic begins offering his helmet to the woman.

3-7s, steady medium two-shot from the same side of the action axis: woman left, mechanic right, faces and hands visible. She takes the red-and-black helmet with both hands; he releases it and withdraws empty hands. Show clear contact and release without fused fingers or duplicated objects.

7-10s, return to the wide: woman holds her received helmet and steps toward the red bike; male racer keeps his white helmet and steps toward the blue bike. Mechanic stays between them, hands empty. Bikes remain on stands; nobody mounts or puts on a helmet.

Maintain identities, screen direction, object ownership, grounded movement and natural occlusion. Audio: continuous quiet garage ambience, footsteps and helmet handling. No dialogue, music, extra cuts, slow motion, duplicated people or objects, text, logos or watermarks.
Velocidade de geração
| Cenário | Modelo | Duração | Do envio até a conclusão observada |
|---|---|---|---|
| Curva de moto e acompanhamento | Flash | 8 s | 82,658 s |
| Curva de moto e acompanhamento | Seedance 2.5 | 8 s | 200,842 s |
| Luta contínua | Flash | 8 s | 82,400 s |
| Luta contínua | Seedance 2.5 | 8 s | 197,657 s |
| Atuação de personagem e fala em inglês | Flash | 8 s | 87,419 s |
| Duas pessoas entregando uma chave | Flash | 8 s | 89,368 s |
| Movimento curto a partir do primeiro quadro | Flash | 8 s | 83,066 s |
| Sete referências e entrega em três planos | Flash | 10 s | 124,013 s |
Os primeiros cinco vídeos de 8 segundos do Flash levaram cerca de 82 a 89 segundos desde o envio da tarefa até a conclusão observada; os dois vídeos de 8 segundos da versão padrão levaram cerca de 201 segundos e 198 segundos, respectivamente. O vídeo de 10 segundos com múltiplas imagens de referência levou cerca de 124 segundos; como os materiais de entrada e a duração são diferentes, ele foi registrado separadamente aqui e não deve ter sua diferença de velocidade comparada diretamente com as amostras anteriores de 8 segundos. Se a rotina de trabalho exigir ajustes repetidos de prompt, várias rodadas de geração de amostras e comparação de efeitos de storyboard, economizar mais de um minuto por geração acelera visivelmente o ritmo de testes e seleção na fase inicial.
Vale esclarecer que, embora todas essas tarefas tenham sido enviadas usando a mesma conta, os testes das duas versões ocorreram em horários diferentes e não foram feitas múltiplas gerações repetidas por cenário para calcular uma média. Os tempos registrados incluem oscilações de rede, fila no servidor e o atraso de observação causado pelo script que consulta o status a cada cinco segundos. Portanto, esses dados refletem apenas que a espera real pelo Flash foi menor nesta rodada de testes, não podendo ser convertidos diretamente em uma vantagem fixa de velocidade do modelo.
Quando usar o Flash e quando escolher a versão padrão
Se a tarefa criativa for focada em movimento intenso e cenas de ação, pelos resultados desta rodada, o Seedance 2.5 padrão continua sendo a escolha mais segura. Nos dois comparativos dinâmicos, a apresentação da versão padrão para o processo completo do movimento, reações corporais a impactos e deslocamento espacial atendeu melhor às exigências de gravação desse tipo de plano.
Se o objetivo atual for testar cenas rapidamente, definir composições, explorar a escrita de prompts ou avançar planos do dia a dia em lote com orçamento limitado, o tempo de espera reduzido e o preço unitário menor do Flash trazem um valor prático claro. Ele também consegue gerar clipes com boa textura visual, mas na hora de selecionar os takes ainda é necessário conferir com cuidado o corte de enquadramento, a conexão dos movimentos e os detalhes de interação localizada em relação ao storyboard.
De modo geral, nos dois testes dinâmicos desta rodada, o desempenho de movimento do Flash ainda não alcançou totalmente o Seedance 2.5 padrão, que segue em vantagem na completude da ação e na sensação de força; o posicionamento do Flash é encurtar o tempo de espera e reduzir o custo por chamada mantendo uma qualidade utilizável, facilitando testes frequentes e geração rápida na fase inicial. Quanto à atuação com fala, interação detalhada, compreensão espacial e consistência de planos com múltiplas referências, nesta rodada geramos apenas amostras do Flash para demonstrar seu desempenho prático e os pontos de atenção nessas tarefas, sem comparar qual das duas versões se sai melhor nelas.