Che modello è Seedance 2.5 Flash
Seedance 2.5 Flash è il modello video della serie Seedance 2.5 di ByteDance orientato alla velocità di generazione. In questa sessione abbiamo testato separatamente la resa dinamica, la recitazione dei personaggi, le interazioni di dettaglio, la comprensione spaziale e la coerenza dello storyboard con molteplici immagini di riferimento, per capire fino a dove possa arrivare nelle attività creative più comuni. Dai campioni emersi in questi test, Seedance 2.5 Flash bilancia efficienza di produzione e costi di utilizzo, risultando adatto come modello di generazione principale per portare avanti le bozze quotidiane e selezionare le inquadrature.
Nei due confronti diretti di questa sessione, Seedance 2.5 Flash ha restituito i risultati più rapidamente rispetto alla versione standard, offrendo una qualità visiva già utilizzabile. Tuttavia, nelle inquadrature ad alta dinamicità — come la piega in moto, le reazioni ai colpi, le spazzate basse o le cadute a terra — mostra ancora prestazioni leggermente inferiori rispetto a Seedance 2.5 standard per quanto riguarda la completezza del movimento, il senso di forza e l'esecuzione di istruzioni motorie complesse.
Differenze di parametri tra Flash e gli altri due modelli
La tabella seguente è stata compilata sulla base della documentazione ufficiale verificata il 16 novembre 2026 e riporta i limiti massimi delle capacità dei modelli. In questa sessione, i primi cinque test di Flash e i due video di confronto della versione standard durano tutti 8 secondi, mentre il caso con più immagini di riferimento dura 10 secondi; la risoluzione è stata impostata uniformemente a 720p. Queste sono solo le impostazioni adottate per la prova pratica e non significano che il modello possa generare unicamente in questo formato.
| Parametro | Seedance 2.5 Flash | Seedance 2.5 | Seedance 2.0 |
|---|---|---|---|
| Risoluzione di output | 480p, 720p | 480p, 720p, 1080p | 480p, 720p, 1080p, 4K |
| Durata per singola generazione | 4–30 secondi | 4–30 secondi | 4–15 secondi |
| Limite immagini di riferimento multimodali | 10 immagini | 30 immagini | 9 immagini |
| Limite video di riferimento multimodali | 5 clip | 10 clip | 3 clip |
| Limite audio di riferimento multimodali | 5 tracce | 10 tracce | 3 tracce |
| Modalità bozza (Draft) | Non supportata | Supportata | Non supportata |
Flash supporta un output massimo di 720p, con la possibilità di scendere a 480p. Rispetto a Seedance 2.5, il limite di immagini di riferimento scende da 30 a 10, mentre i video e gli audio di riferimento passano rispettivamente da 10 a 5. Se un progetto richiede l'inserimento di una grande quantità di materiale di riferimento o la consegna diretta di file nativi a 1080p, queste differenze tecniche incideranno direttamente sulla scelta del modello.
I limiti sui materiali di riferimento indicati nella tabella si riferiscono alle attività di riferimento multimodale completo e non al numero di file caricabili per la generazione da immagine a video tramite primo fotogramma. Le attività basate sul primo fotogramma accettano una sola immagine, mentre quelle basate su primo e ultimo fotogramma richiedono rispettivamente l'immagine iniziale e quella finale. Tutti i limiti sopra indicati provengono dalle specifiche ufficiali; il caso multi-riferimento di questa sessione ha utilizzato sette immagini, senza testare la soglia massima di dieci né altre impostazioni di risoluzione.
Confronto dei prezzi ufficiali per la generazione video
I prezzi seguenti fanno riferimento al listino ufficiale in cinese di Volcano Ark (火山方舟) per l'inferenza online, verificato il 16 novembre 2026, calcolati sul presupposto di un output a 720p in formato 16:9 senza video in ingresso. Le prove effettuate in questa sessione — testo-video, immagine-video da primo fotogramma e video da più immagini di riferimento — non prevedevano alcun video di riferimento in input.
| Modello | Prezzo unitario ufficiale | Prezzo al secondo convertito dall'esempio ufficiale | Budget indicativo video da 8 s | Budget indicativo video da 10 s |
|---|---|---|---|---|
| Seedance 2.5 Flash | 46 CNY / milione di token | Circa 0,99 CNY | Circa 7,9 CNY | Circa 9,9 CNY |
| Seedance 2.5 | 70 CNY / milione di token | Circa 1,51 CNY | Circa 12,1 CNY | Circa 15,1 CNY |
| Seedance 2.0 | 46 CNY / milione di token | Circa 0,99 CNY | Circa 7,9 CNY | Circa 9,9 CNY |
A parità di condizioni, il prezzo unitario ufficiale per token di Flash è inferiore di circa il 34% rispetto a Seedance 2.5 ed è allineato a quello di Seedance 2.0. Seedance 2.0 è riportato qui solo come riferimento per parametri e costi: non sono stati generati campioni di prova con questo modello durante la sessione. I budget per i video da 8 e 10 secondi presenti in tabella sono conversioni approssimative basate sul costo al secondo degli esempi ufficiali, utili per un confronto rapido. L'addebito effettivo dipende dal prezzo unitario dei token e dal consumo reale secondo la fatturazione ufficiale; le cifre indicate non rappresentano la spesa effettivamente sostenuta per questo lotto di campioni.
Prestazioni rilevate nelle singole capacità
Questo test esamina cinque categorie di capacità generative attraverso sei scenari, per un totale di sei campioni realizzati con Flash e due campioni di confronto realizzati con Seedance 2.5 standard. La piega in moto e il combattimento continuo rientrano nella resa dinamica e vengono messi a confronto nelle due versioni; per le altre quattro categorie è stato testato solo Flash. I primi sette video durano 8 secondi, mentre il caso con più immagini di riferimento dura 10 secondi e comprende tre inquadrature.
| Categoria di capacità | Scenario di test | Durata | Comportamento principale di Flash | Confronto con Seedance 2.5 |
|---|---|---|---|---|
| Resa dinamica e controllo di camera | Piega in moto e camera a seguire | 8 secondi | Buon senso di velocità, ma il taglio ravvicinato penalizza la visione completa della curva | Il passaggio da piega, punto di corda e raddrizzamento è più completo |
| Resa dinamica e controllo di camera | Combattimento continuo | 8 secondi | Genera scambi continui di attacco e difesa, ma alcune transizioni e il senso di impatto sono deboli | Rotazione del busto, reazioni fisiche e spostamenti in profondità più naturali |
| Recitazione e battute | Lettura della lettera, sguardo alzato e battuta in inglese | 8 secondi | Mostra il passaggio dalla lettura al sorriso; pronuncia e labiale non sono stati verificati separatamente | Non testato |
| Interazioni di dettaglio | Passaggio di una chiave tra due persone | 8 secondi | La dinamica dello scambio è chiara, ma c'è un errore nel personaggio e il contatto delle dita richiede un'analisi attenta | Non testato |
| Comprensione spaziale | Rotazione di una tazza sulla scrivania | 8 secondi | Disposizione generale preservata, angolo di rotazione della tazza non confermato, leggero avanzamento della camera | Non testato |
| Multi-riferimento e coerenza dello storyboard | Scambio in tre inquadrature generato da sette immagini | 10 secondi | Nelle tre inquadrature, l'associazione tra personaggi, moto e caschi rimane complessivamente coerente | Non testato |
Di seguito vengono mostrati i video originali e i prompt suddivisi per categoria di capacità; i tempi di attesa specifici per ciascun video sono riepilogati nella tabella delle velocità di generazione in fondo all'articolo.
Resa dinamica e controllo di camera
Questa sezione utilizza due scenari — la piega in moto e il combattimento a due — per osservare la fluidità delle transizioni motorie, gli spostamenti del baricentro, le traiettorie di movimento e la capacità della telecamera di mostrare chiaramente lo svolgersi dell'azione. Entrambi i modelli utilizzano esattamente gli stessi prompt in inglese e le medesime impostazioni di generazione.
Piega in moto e camera a seguire
I requisiti del prompt sono identici per entrambe le versioni: un pilota in sella a una moto rossa percorre un'ampia curva, seguito da una telecamera bassa posta di tre quarti anteriore; superato il punto di corda, la moto si raddrizza gradualmente, mantenendo sempre l'intero veicolo e entrambe le ruote all'interno dell'inquadratura.
Seedance 2.5 Flash
8 secondi · 720p · Audio nativo · Dall'invio al completamento osservato: 82,7 secondi
Seedance 2.5
8 secondi · 720p · Audio nativo · Dall'invio al completamento osservato: 200,8 secondi
Flash assomiglia più a un dettaglio ravvicinato da gara
Nel video generato da Flash, il cupolino rosso, l'asfalto bagnato, i riflessi delle luci e l'acqua nebulizzata sollevata dalla ruota posteriore sono piuttosto nitidi; lo sfondo scorre via rapidamente e la ripresa a ridosso dell'anteriore trasmette un buon senso di velocità. Tuttavia, l'inquadratura è troppo stretta: la testa del pilota, la parte superiore del busto e porzioni della carena vengono tagliate fuori campo, e le ruote anteriore e posteriore non restano interamente visibili come richiesto dal prompt. Sebbene si percepisca l'inclinazione del mezzo, la composizione così serrata impedisce allo spettatore di vedere chiaramente come pilota e moto lavorino insieme per affrontare la curva.
Se il montaggio finale richiede proprio lo stacco su un dettaglio ravvicinato e serrato della moto in corsa, questa clip può tornare utile; se invece lo storyboard prevede di mostrare per intero la dinamica della piega, o se l'inquadratura deve raccordarsi a un piano precedente che imposta la traiettoria in pista, un taglio che esclude parte del pilota e del veicolo risulta poco adatto.
La versione standard riprende la percorrenza di curva in modo più completo
La versione standard mantiene all'interno del quadro la sagoma del pilota e dell'intera motocicletta. Seguendo lo scorrere del tempo, si vede la moto inclinarsi in ingresso, stringere verso il punto di corda e poi ridurre gradualmente l'angolo di piega fino a raddrizzarsi; osservando la posizione del mezzo rispetto al cordolo interno, anche la traiettoria seguita appare molto chiara.
Questa sensazione di fluidità nasce dall'equilibrio tra l'assetto della moto, il baricentro del pilota, la linea di percorrenza e la distanza della telecamera. Rispetto al piano stretto di Flash, la versione standard illustra con maggiore chiarezza l'intero passaggio dalla piega al progressivo raddrizzamento, offrendo quindi una resa del movimento superiore in questo scenario.
Va comunque notato che anche nella versione standard l'angolazione del tracking anteriore e l'ampiezza dell'inquadratura subiscono variazioni durante la clip. Basandosi solo su fotogrammi campionati, non è possibile confermare che il contatto degli pneumatici con l'asfalto e la geometria del telaio siano perfettamente rigorosi in ogni singolo istante. Questo confronto dimostra che la versione standard restituisce in modo più completo lo sviluppo dell'azione e la traiettoria, ma non permette di concludere che tutti i dettagli fisici siano privi di imprecisioni.
Prompt completo in inglese utilizzato per il test della moto
One continuous 8-second cinematic live-action shot on a closed motorcycle racing circuit just after rain, at blue hour. A single adult professional racer in black protective leathers and a full-face helmet rides one unbranded red sport motorcycle through a sweeping right-hand bend. A low front three-quarter tracking camera follows alongside at matching speed, keeping the whole motorcycle and both wheels visible. The racer leans naturally into the corner, reaches the apex, then gradually brings the bike upright toward the exit. Both tires remain on the wet asphalt. Track barriers and floodlights move past in the background, with a fine spray of water trailing the rear tire. Physically plausible rider anatomy and motorcycle geometry, consistent red bodywork, realistic film texture. Sound: one motorcycle engine rising smoothly and wet tire hiss. No dialogue, no music, no cuts, no text, no subtitles, no logos.
Combattimento continuo tra due persone
Questo scenario di combattimento richiede che i due modelli mostrino i personaggi già impegnati nello scontro fin dal primo fotogramma: una combinazione rapida di pugni, schivate e parate, seguita da un potente calcio di rimessa, poi un avanzamento per accorciare le distanze, una spazzata bassa alle gambe e infine una caduta con capriola a terra. Per distinguere i ruoli durante gli scambi rapidi, il prompt assegna a un combattente una giacca grigia con pantaloni neri e all'altro una giacca blu scuro con pantaloni marroni.
Seedance 2.5 Flash
8 secondi · 720p · Audio nativo · Dall'invio al completamento osservato: 82,4 secondi
Seedance 2.5
8 secondi · 720p · Audio nativo · Dall'invio al completamento osservato: 197,7 secondi
Flash esegue molte mosse, ma il senso di forza è debole
Flash riesce a generare tutti gli elementi richiesti: la raffica di pugni, le parate, il calcio, la spazzata bassa e la caduta con rotolamento. Osservando da vicino, però, diversi scambi sembrano più una sequenza di movimenti scomposti eseguiti in ordine: le reazioni fisiche dopo aver incassato pugni e calci e il raccordo fluido con la tecnica successiva appaiono leggermente fluttuanti e privi di peso. I due combattenti si muovono perlopiù traslando da sinistra a destra sull'asse orizzontale, mentre manca una variazione di distanza in profondità tra la telecamera e i soggetti.
Inoltre, il video presenta bande nere aggiunte automaticamente sopra e sotto, e nella prima metà dell'azione i piedi non restano interamente visibili. Quando occorre valutare il piede d'appoggio, il gioco di gambe e la generazione della forza durante uno scontro, il taglio delle estremità inferiori penalizza il giudizio.
Nella versione standard la generazione della forza e gli spostamenti sono più naturali
Nella versione standard, quando i personaggi tirano un pugno si notano la spinta delle spalle e la torsione del busto e del bacino; anche le schivate, i calci di rimessa e i passi indietro coinvolgono l'intero corpo. Dopo essersi allontanati, i due tornano a chiudere la distanza, raccordando con naturalezza l'attacco basso e la caduta con rotolamento. La telecamera adatta la propria posizione seguendo lo sviluppo dello scontro: la distanza reciproca e l'orientamento dei corpi cambiano continuamente, facendo sì che il combattimento si svolga in uno spazio dotato di profondità, dove le posizioni relative davanti-dietro risultano molto più leggibili.
Questo campione restituisce con maggiore continuità il passaggio dal caricamento del colpo all'impatto fino all'inseguimento. Rispetto a Flash, i colpi di braccia e gambe nella versione standard trasmettono un peso maggiore e le combinazioni si legano in modo più compatto, offrendo una resa dinamica migliore in questo scenario.
Nemmeno la versione standard mantiene i piedi di entrambi i combattenti dentro l'inquadratura per tutta la durata. Per verificare se i punti di contatto dei colpi siano sempre plausibili, se vengano sferrati esattamente i tre pugni richiesti dal prompt e se ogni trasferimento di carico sia coerente, occorre comunque esaminare il video con attenzione lungo tutta la timeline. Un aspetto visivo più cinematografico non equivale automaticamente a una coreografia priva di errori, né garantisce che ogni singola istruzione del prompt sia stata eseguita alla lettera.
Prompt completo in inglese utilizzato per il test di combattimento
An explosive 8-second live-action martial-arts fight scene, fast real-time Hong Kong action-film choreography, one continuous shot. Two adult fighters in a gritty concrete parking garage: one in a light grey jacket and black trousers, the other in a dark navy jacket and tan trousers. They are already fighting in the opening frame. The grey fighter surges forward with a rapid three-punch combination; the navy fighter slips the first punch, blocks the next and drives back with a forceful body kick. The grey fighter staggers two steps, immediately closes the distance, ducks a swinging counterpunch and sweeps the navy fighter's leg. The navy fighter hits the floor in a controlled stunt fall and rolls away as the grey fighter pursues. Relentless attack-and-counterattack momentum throughout, short transitions, sharp acceleration, convincing physical impact reactions, forceful torso rotation, realistic weight and balance, clear changes of position across the floor. The camera tracks rapidly beside them at waist height in a medium-wide action framing, keeping both whole bodies and the floor under their feet visible, with subtle handheld vibration at impacts. Crisp readable action, restrained motion blur, hard overhead light, cinematic contrast, realistic anatomy and clothing, distinct stable identities. Audio: rapid footfalls, forceful punch and kick impacts, clothing snaps, heavy breathing and a solid floor impact. No slow motion, no standing around, no pauses to reset, no dialogue, no music, no text, no subtitles, no cuts, no blood, no gore, no weapons.
Recitazione e battute
Questo scenario richiede che il personaggio inizi leggendo una lettera a testa bassa, poi sollevi lo sguardo, pronunci in inglese la frase “You kept the letter.” (Hai conservato la lettera) e infine accenni un breve sorriso. Il prompt specifica che la battuta deve essere pronunciata tra il quarto e il sesto secondo, mantenendo la telecamera fissa.
Dai fotogrammi campionati si osserva il passaggio della donna dalla lettura a capo chino fino allo sguardo sollevato accompagnato da un sorriso; il volto, la giacca e il foglio tra le mani restano sempre ben riconoscibili nei diversi momenti. Questo tipo di recitazione misurata, priva del disturbo di movimenti bruschi, si presta bene per osservare direttamente le espressioni facciali e le sfumature emotive.
Quando si valuta un'inquadratura recitata con dialogo, la parte visiva e quella sonora vanno verificate separatamente. La presenza di una traccia audio nel video non implica necessariamente che la pronuncia della battuta e il movimento delle labbra corrispondano con precisione. Durante la revisione della clip originale occorre comunque controllare se la frase in inglese sia scandita chiaramente, se si siano sovrapposte voci estranee, se la battuta cada effettivamente nella finestra tra i 4 e i 6 secondi come richiesto e se l'articolazione della bocca sia coerente. Basandosi sui soli fermi immagine, in questa sessione non è stato verificato in modo indipendente che la battuta sia fedele parola per parola né che il labiale sia rigorosamente sincronizzato.
Prompt in inglese utilizzato per la recitazione del personaggio
One continuous 8-second medium close-up in a quiet train carriage, naturalistic live-action cinematography. An adult woman in a plain navy jacket holds one opened letter below her face. 0-2 seconds: she reads it silently, with a thoughtful expression. 2-4 seconds: she takes a small breath and lifts her eyes toward a person just beside the camera. 4-6 seconds: with a restrained, tender smile she says clearly in English, 'You kept the letter.' 6-8 seconds: she holds the eye contact and the quiet smile. Keep her mouth fully visible and her face, clothing and letter consistent. The camera stays still. Audio: her single spoken line over soft carriage rumble. No other voices, no music, no captions, no readable writing, no subtitles, no cuts.
Interazioni di dettaglio
Questo scenario richiede che una persona appoggi una piccola chiave di ottone nel palmo aperto di un'altra, allenti le dita e poi ritragga la mano vuota. Lo scambio di un piccolo oggetto rigido di questo tipo è indicato per mettere alla prova la qualità generativa sulle mani: quando due mani si avvicinano e si sovrappongono, il gesto di trattenere e poi rilasciare la chiave deve essere mostrato con chiarezza.
Nei fotogrammi estratti durante il passaggio, la mano che porge la chiave si allunga verso il palmo aperto, deposita l'oggetto e si ritrae, mentre chi riceve la chiave richiude le dita. Qui sotto è riportato un ingrandimento ravvicinato del momento dello scambio, utile per osservare il rapporto di contatto tra i polpastrelli e la chiave.
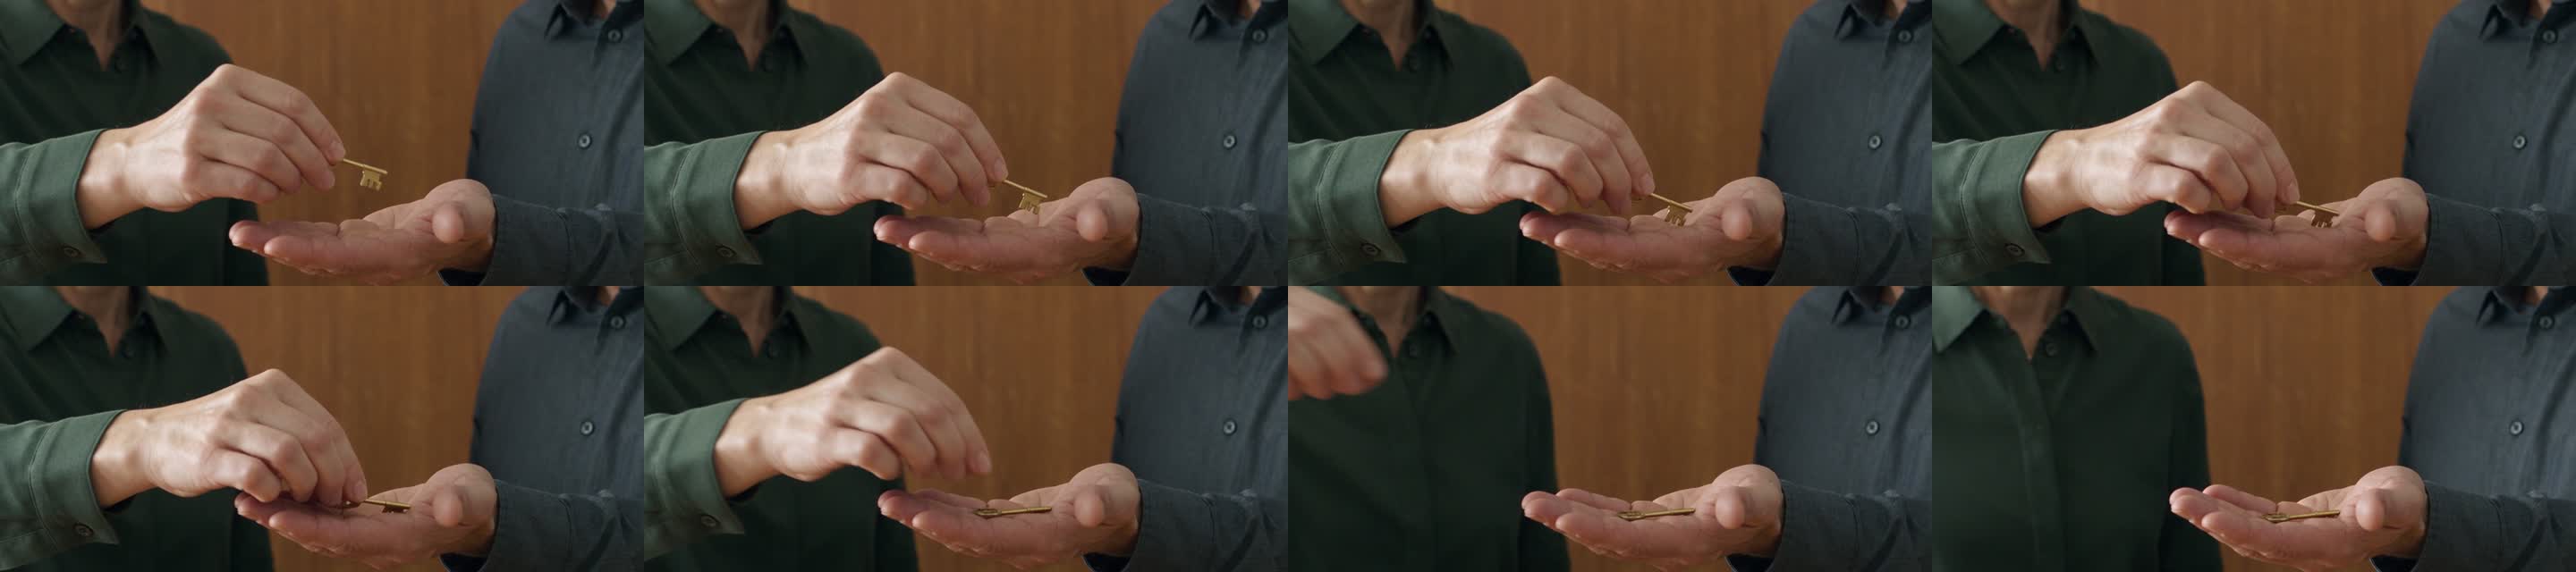
Per esaminare questo genere di interazioni ravvicinate, di solito occorre concentrarsi su alcuni dettagli specifici: verificare se le dita che tengono la chiave si aprano con naturalezza al momento del rilascio, se vi siano fusioni o sfocature anomale tra i polpastrelli, la chiave e il palmo dell'altra persona, se l'anatomia delle articolazioni del pollice e delle altre dita rimanga corretta e se la chiave resti sempre un unico oggetto dall'inizio alla fine. Questi aspetti vanno controllati scorrendo il video fotogramma per fotogramma: il fatto che la struttura del palmo sia corretta nel fotogramma iniziale non garantisce l'assenza di artefatti nel momento in cui le due mani si sovrappongono.
Inoltre, questo campione presenta una deviazione evidente nell'impostazione dei personaggi. Il prompt richiedeva esplicitamente che a porgere la chiave sulla sinistra dell'inquadratura fosse una donna, ma nella clip generata chi consegna l'oggetto appare come un uomo. Pertanto, sebbene il video possa essere utilizzato per studiare la meccanica dello scambio tra le mani, non ha rispettato le indicazioni sui personaggi. Il fatto che l'oggetto di scena sia stato passato con successo non significa che tutte le istruzioni del prompt siano state recepite, né permette di stabilire, sulla sola base di pochi fotogrammi campionati, che l'anatomia del contatto digitale sia impeccabile in ogni istante.
Prompt in inglese utilizzato per il test del passaggio della chiave
One continuous 8-second live-action shot, a fixed waist-up two-shot of two adults at a wooden counter, with both people's hands clearly visible throughout. The woman on the left wears a dark green shirt. The man on the right wears a charcoal shirt. 0-2 seconds: the woman holds exactly one small brass key between the fingers of her right hand; the man presents his empty open left palm. 2-5 seconds: she moves that key into his left palm and releases it. 5-8 seconds: she withdraws her visibly empty right hand, and he closes his fingers around the received key. Maintain one key, two people and continuous natural hand movements. Show the actual contact and release clearly, with realistic anatomy and steady framing. Soft side lighting, believable skin and wood textures. Audio: quiet room tone and a small metallic click during the transfer. No speech, no music, no text, no subtitles, no cuts.
Comprensione spaziale
Per questo test è stata fornita in input un'immagine statica originale, priva di testo, come primo fotogramma. La donna, la tazza blu, il taccuino chiuso, la scrivania e lo sfondo della stanza sono tutti elementi già definiti nell'immagine di partenza. L'azione richiesta dal prompt è minima: la donna abbassa lo sguardo, allunga la mano per ruotare la tazza di un quarto di giro sul piano della scrivania (senza mai sollevare il fondo dal tavolo), poi lascia la presa e si volta a guardare fuori dalla finestra.
Oltre a verificare la tenuta dell'aspetto del personaggio, questa inquadratura serve soprattutto a valutare come il modello comprende le relazioni spaziali sul piano del tavolo: se la mano si avvicini al manico seguendo una traiettoria plausibile, se la base della tazza resti ben aderente alla superficie durante la rotazione, se le posizioni relative di taccuino, tazza e scrivania rimangano stabili e se, nell'afferrare e rilasciare il manico, le occlusioni prospettiche siano corrette e prive di compenetrazioni.
Dai fotogrammi campionati emerge che la disposizione generale sulla scrivania si mantiene stabile: si osserva il movimento della mano che raggiunge la tazza e poi si ritrae, mentre il taccuino resta fermo nella sua posizione originale sulla destra. Tuttavia, sebbene l'orientamento del manico subisca una variazione, nella seconda metà della clip sembra tornare molto vicino alla posizione di partenza; guardando solo questa serie di fotogrammi estratti, è difficile confermare se la tazza abbia effettivamente compiuto una rotazione completa di un quarto di giro fermandosi nella nuova angolazione. Inoltre, nonostante il prompt richiedesse una telecamera bloccata, nel video generato si nota un leggero movimento di avanzamento.
Quando si valuta una generazione immagine-video basata sul primo fotogramma, al di là della coerenza fisionomica del soggetto, il punto critico è verificare se la posizione e le occlusioni degli oggetti preesistenti reggano nel momento in cui la mano entra in contatto con gli elementi rigidi sul tavolo. Per controllare con precisione il contatto delle dita, i rapporti di sovrapposizione e lo spostamento degli oggetti, è consigliabile affiancare l'immagine originale del primo fotogramma al video generato.
Prompt in inglese utilizzato per il test di rotazione della tazza
Continue the supplied first frame as one steady 8-second live-action shot. Preserve this exact adult woman's appearance, navy shirt, desk, single blue mug, closed tan notebook, background and window lighting. 0-2 seconds: she briefly glances down toward the blue mug. 2-5 seconds: she gently takes the mug handle with her right hand and rotates the mug a quarter turn on the tabletop without lifting it. 5-8 seconds: she releases the mug, rests her right hand beside it, and looks back toward the window. The mug stays on the desk and remains one rigid ceramic object, and the closed notebook remains fixed throughout. Keep the camera locked with no cut or zoom. Audio: quiet indoor ambience and a soft ceramic scrape during the turn. No speech, no music, no text, no subtitles.
Multi-riferimento e coerenza dello storyboard
Questo test estende la durata a 10 secondi e utilizza sette immagini di riferimento per generare una sequenza articolata in tre inquadrature. I personaggi sono una pilota coreana, un pilota euro-americano e un meccanico euro-americano di mezza età, ciascuno definito tramite una propria scheda personaggio a tre viste (turnaround); vengono inoltre fornite le immagini di due motociclette dal design differente e di due caschi, uno rosso-nero e uno bianco.
Le immagini di riferimento servono a fissare i tratti somatici, l'abbigliamento e il design degli oggetti. Non sono state caricate immagini dell'ambiente né bozzetti dello storyboard; l'ambientazione dell'officina, l'illuminazione e gli stacchi di montaggio sono interamente governati dal prompt testuale: un pomeriggio nuvoloso, luce naturale morbida che filtra dal portone del box, pavimento asciutto e riflessi contenuti sulla pelle e sulle tute in pelle.
Immagini di riferimento utilizzate in questo test
| Elemento di riferimento | Immagine | Corrispondenza nella scena |
|---|---|---|
| 1 · Scheda a tre viste della pilota | 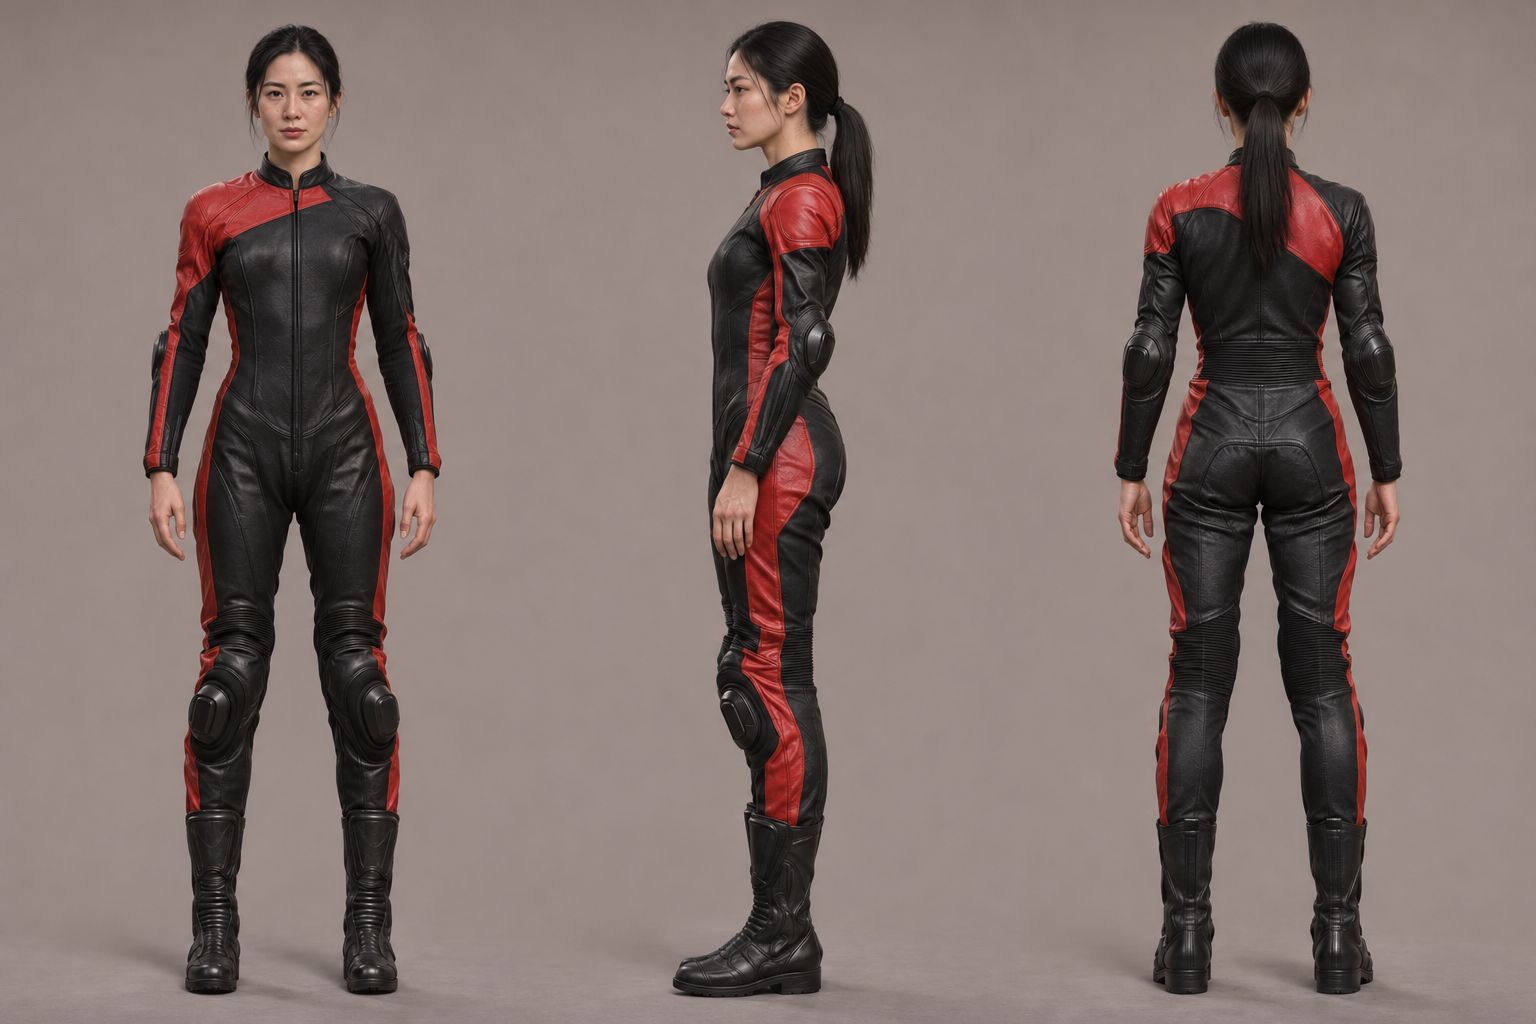 | Tuta da gara rosso-nera, riceve il casco rosso-nero |
| 2 · Scheda a tre viste del pilota | 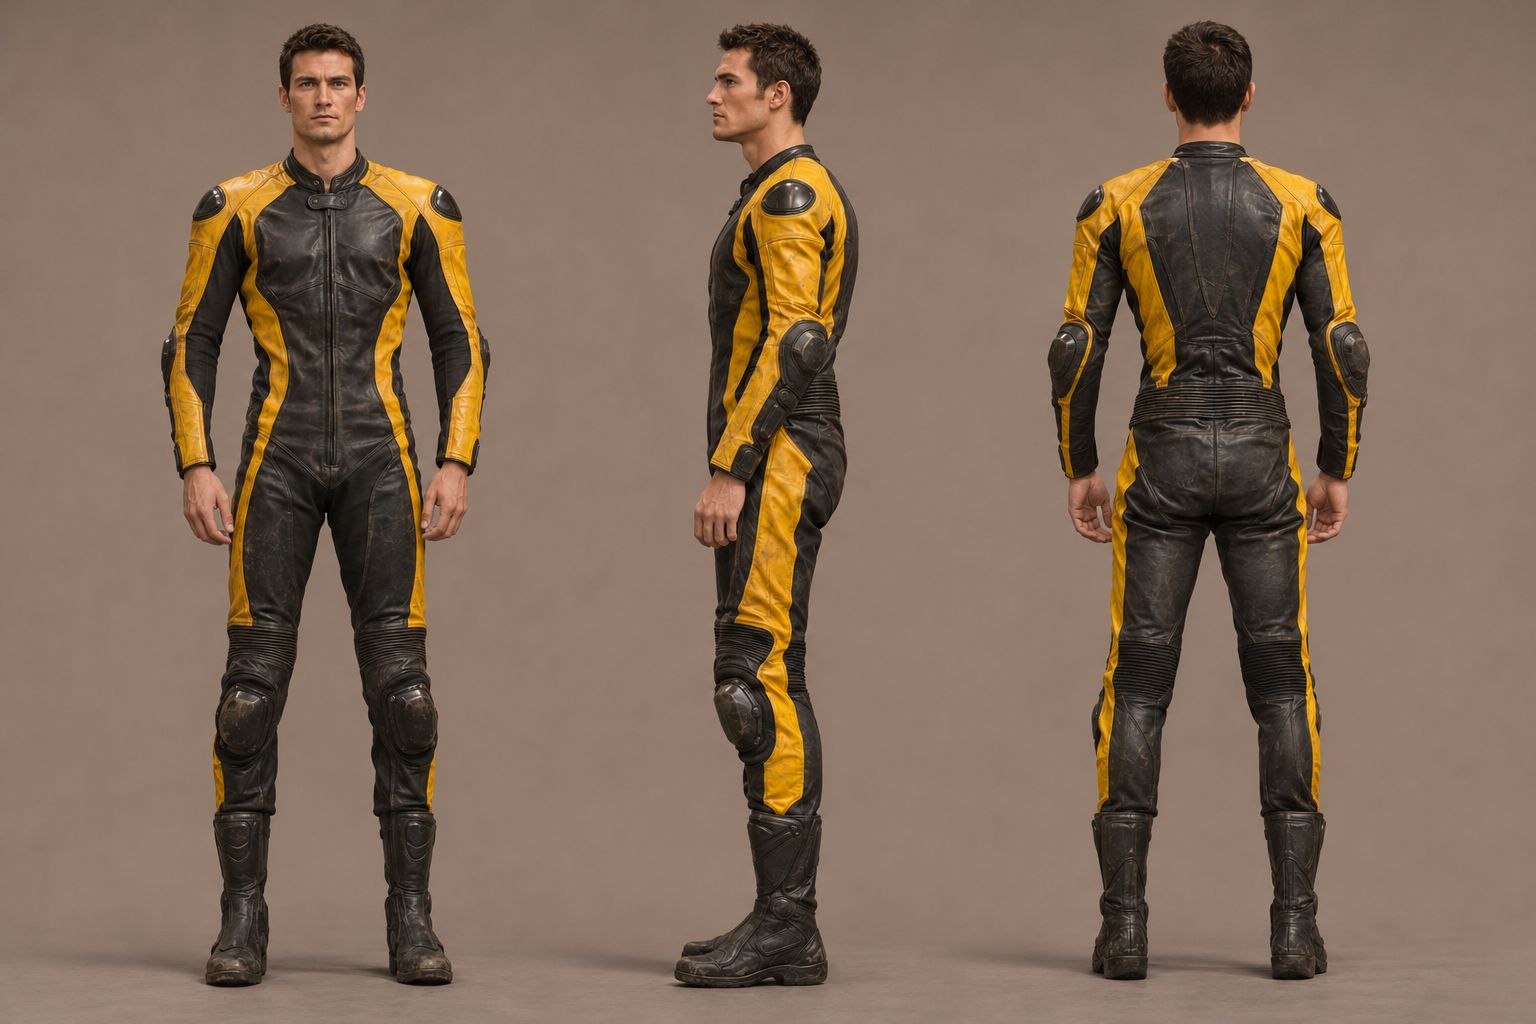 | Tuta da gara giallo-nera, tiene sempre in mano il casco bianco |
| 3 · Scheda a tre viste del meccanico | 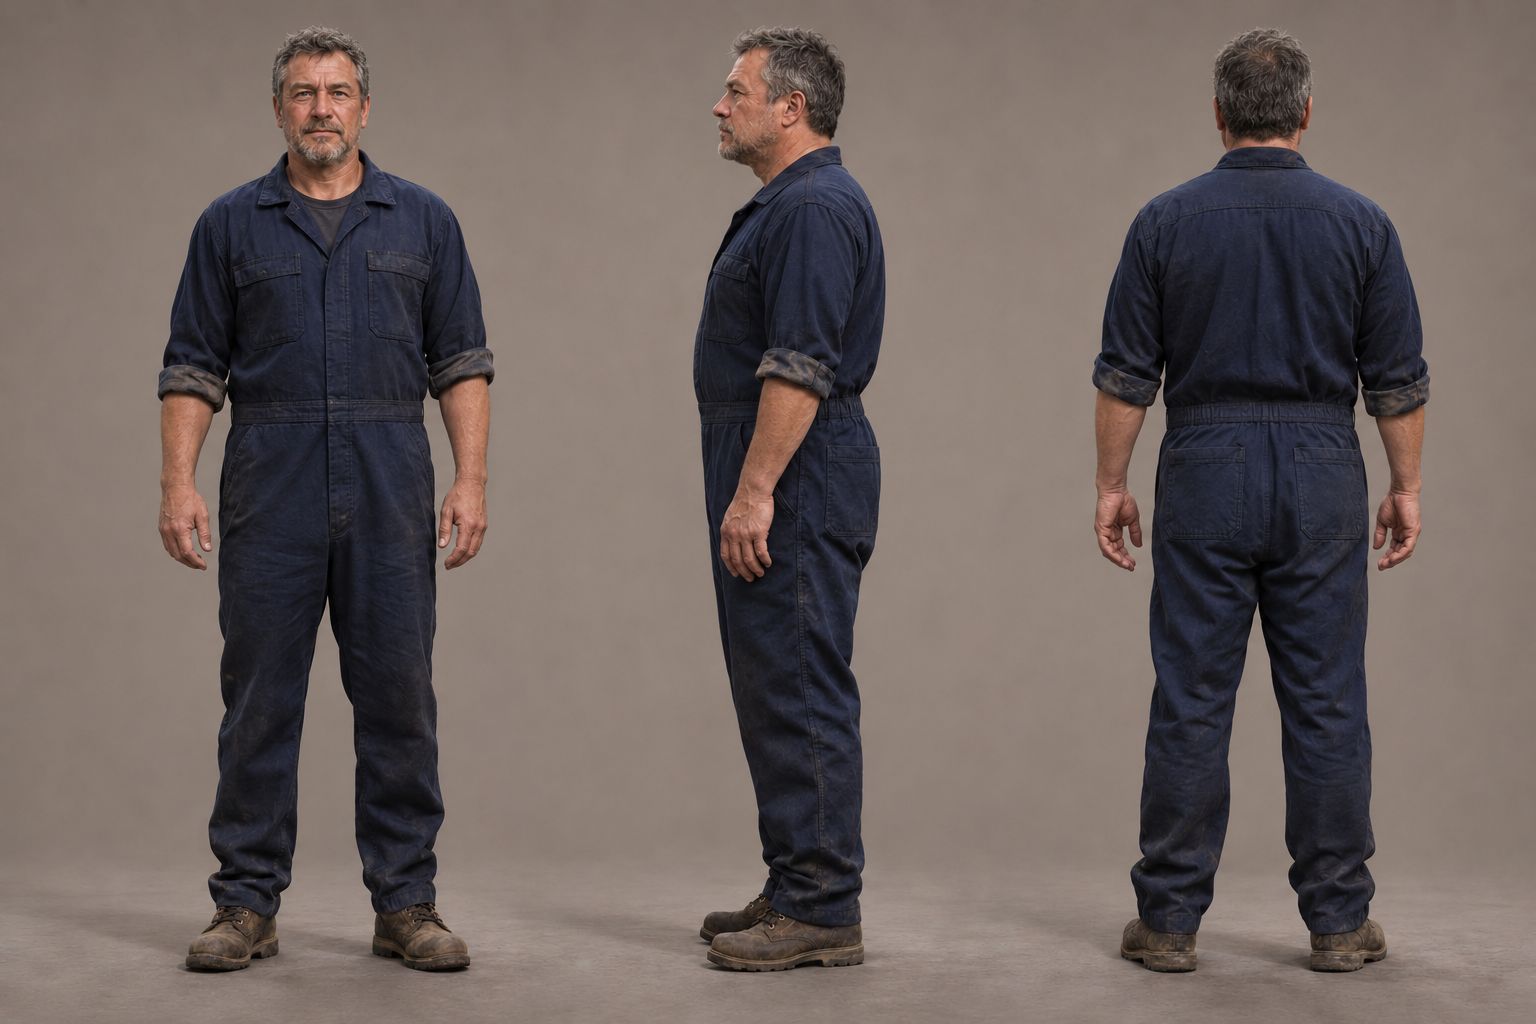 | Tuta da lavoro blu scuro, porge il casco e ritrae le mani vuote |
| 4 · Moto rossa | 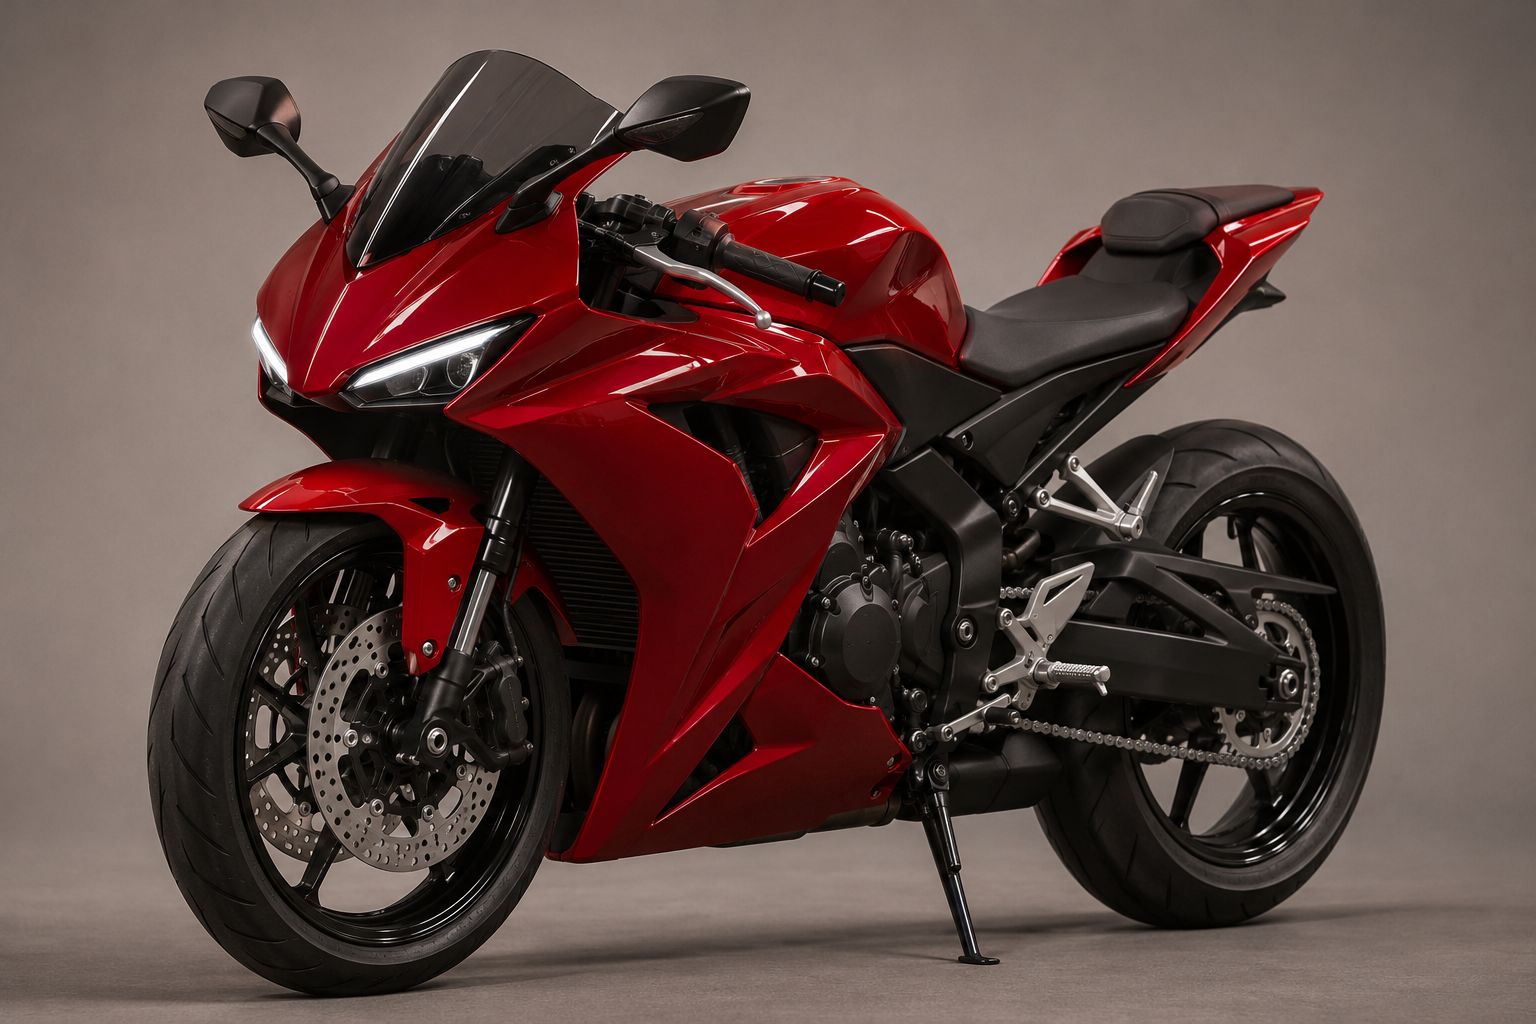 | Mantiene la carenatura integrale e i fari sdoppiati |
| 5 · Moto blu | 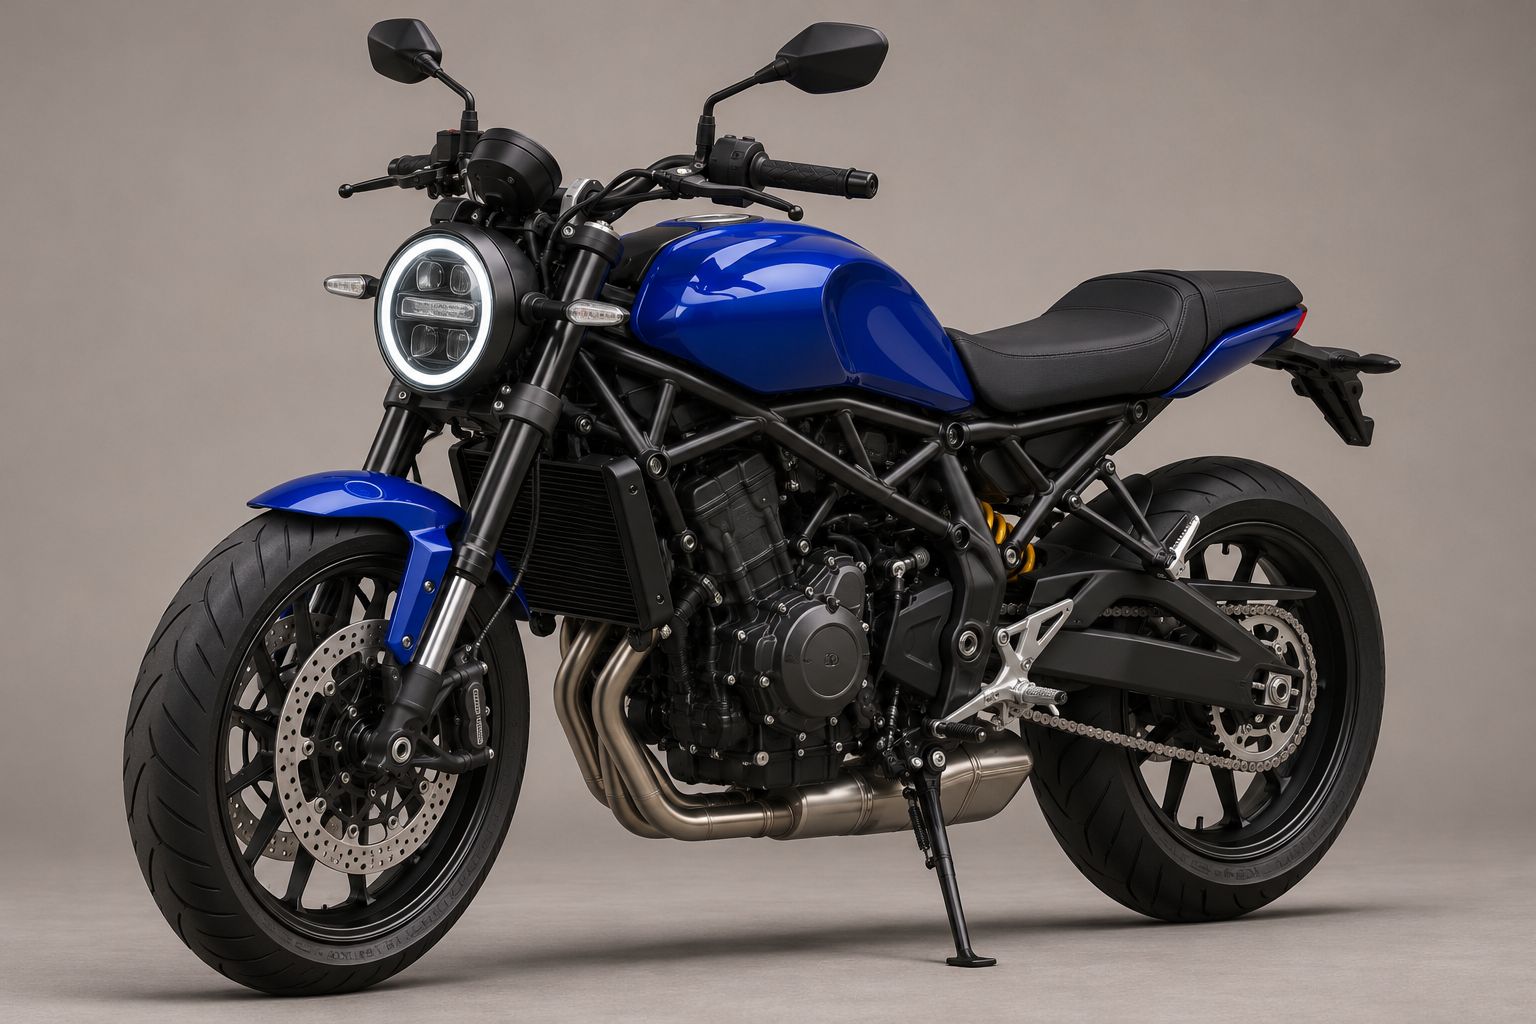 | Mantiene il faro tondo e il motore a vista |
| 6 · Casco rosso-nero | 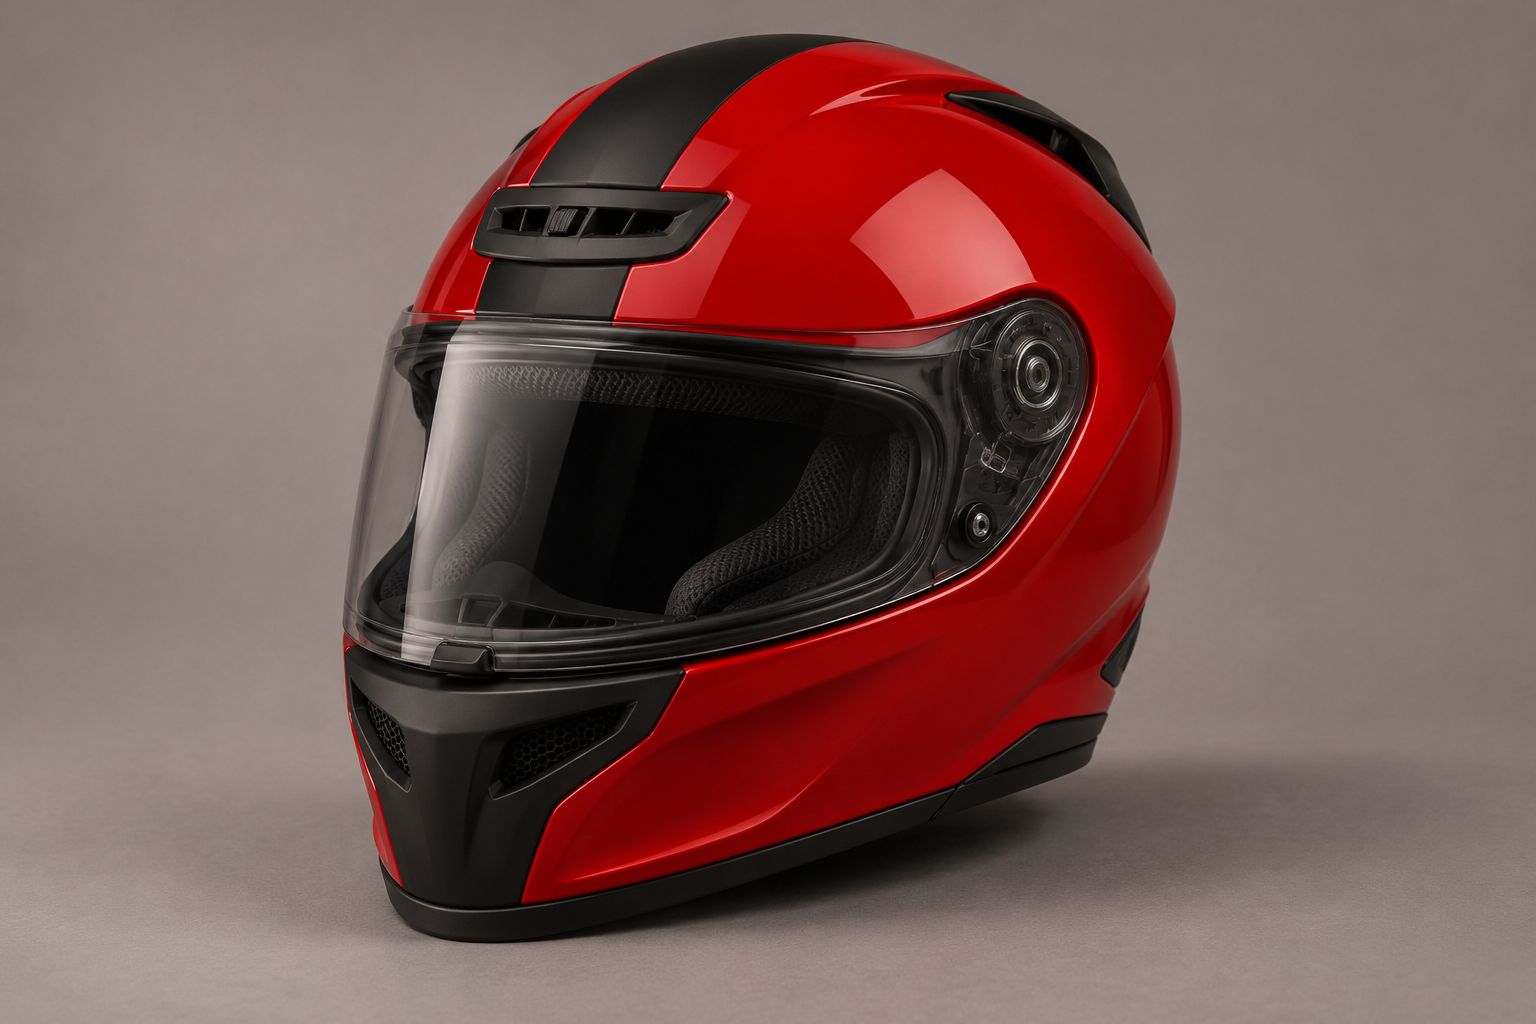 | Passa dalle mani del meccanico alla pilota |
| 7 · Casco bianco | 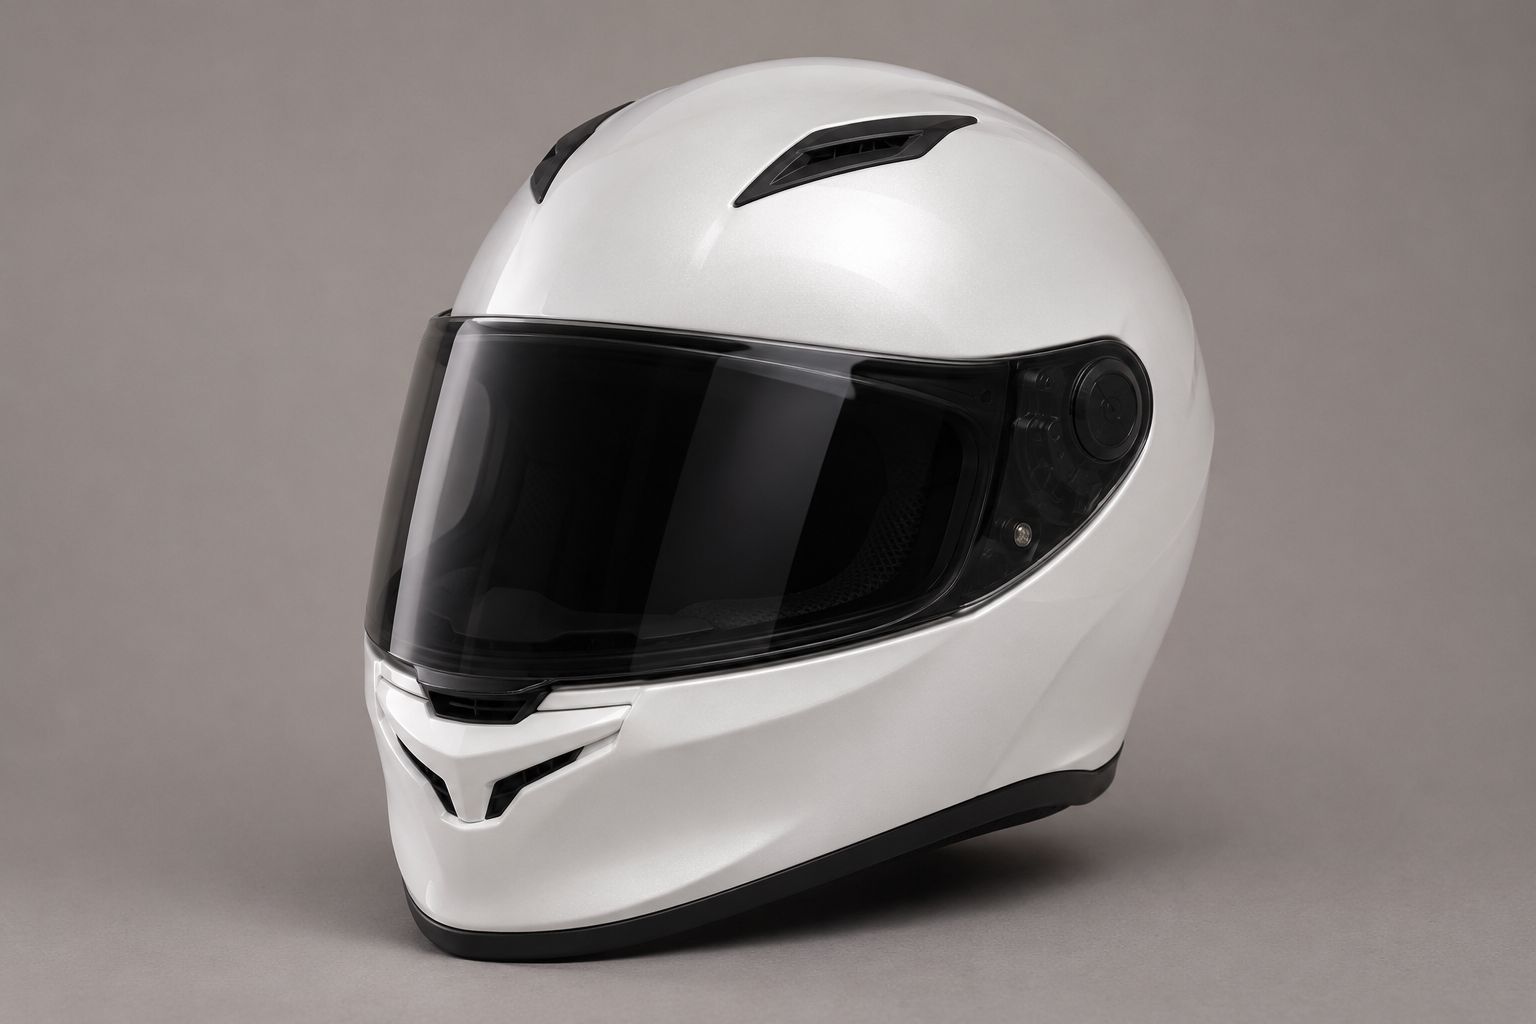 | Tenuto dal pilota |
Struttura dello storyboard
| Intervallo | Inquadratura |
|---|---|
| 0–3 secondi | Campo totale per stabilire la posizione delle tre persone e delle due moto |
| 3–7 secondi | Piano medio per mostrare chiaramente lo scambio del casco |
| 7–10 secondi | Ritorno al campo totale, i due piloti si dirigono verso le rispettive moto |
10 secondi · 720p · Audio nativo · Dall'invio al completamento osservato: circa 124 secondi
Personaggi e oggetti mantengono una buona coerenza complessiva tra gli stacchi
Questo campione mantiene una solida coerenza d'insieme attraverso i vari cambi di inquadratura. Passando dal campo totale al piano medio e tornando infine al totale, i volti, le tute da gara e la tuta da lavoro dei tre personaggi trovano tutti riscontro; anche la sportiva rossa carenata e la naked blu con faro tondo conservano il rispettivo design originale. Le tre schede personaggio a più viste sono state associate correttamente ai tre singoli individui, evitando l'errore di generare tre cloni a partire dalle tre angolazioni presenti in una singola tavola.
Anche il possesso e il passaggio dei caschi risultano continui: all'inizio è il meccanico a tenere il casco rosso-nero; dopo lo stacco sul piano medio, la pilota lo prende in consegna mentre il meccanico lascia la presa e ritrae le mani; tornando al campo totale, il casco rosso-nero è ancora in mano alla donna, mentre il pilota maschio trattiene il casco bianco dall'inizio alla fine. Nelle attività basate su molteplici immagini di riferimento, riuscire a preservare l'identità dei personaggi e l'attribuzione degli oggetti di scena dopo gli stacchi di camera è molto utile per il successivo lavoro di montaggio.
Il video finale effettua i tagli a circa 3 secondi e 6,8 secondi, rispettando sostanzialmente la scansione prevista tra totale, piano medio e ritorno al totale. L'illuminazione della scena rispecchia la luce diurna morbida descritta nel testo, con riflessi piuttosto controllati sul pavimento e sulle tute in pelle. La recitazione dei personaggi appare comunque un po' rigida e i dettagli delle dita durante la consegna del casco richiedono un'ispezione più ravvicinata. Sulla base di quanto osservato finora, questo campione ha saputo mantenere la corrispondenza generale tra soggetti e oggetti lungo tutte le tre inquadrature. Per questo scenario è stato testato solo Flash, senza un confronto diretto di coerenza con la versione standard.
Prompt in inglese utilizzato per il test multi-riferimento (versione condensata)
Il testo seguente conserva le associazioni con le immagini di riferimento, la divisione nelle tre inquadrature e i vincoli principali del test originale, omettendo le descrizioni ripetitive.
Create a 10-second photorealistic live-action scene in three shots, with hard cuts at 3s and 7s. Exactly three adults, two parked motorcycles and two helmets.

References define appearance only; replace their studio lighting and backgrounds:
@Image 1: one Korean woman, black ponytail, red-and-black racing suit.
@Image 2: one European-American man, short brown hair, yellow-and-black racing suit.
@Image 3: one middle-aged European-American mechanic, salt-and-pepper hair and stubble, navy coveralls.
Each character reference is a three-view sheet of ONE person.
@Image 4: red faired sportbike, angular split headlights.
@Image 5: blue naked roadster, round headlight, exposed engine.
@Image 6: red-and-black helmet, passed from mechanic to woman.
@Image 7: white helmet, held by the male racer throughout.
Preserve faces, outfits, object designs and colors across cuts.

Setting: a working pit garage on an overcast afternoon. Soft neutral daylight enters from camera-right; worn concrete walls, rear workbench and cabinets, dry matte floor. Natural skin, subdued leather reflections, no glossy skin or amber wash. Keep lighting and environment consistent.

0-3s, steady eye-level wide: woman left beside the red bike, mechanic center holding the red-and-black helmet, male racer right beside the blue bike holding the white helmet. Show full bodies and both bikes. Mechanic begins offering his helmet to the woman.

3-7s, steady medium two-shot from the same side of the action axis: woman left, mechanic right, faces and hands visible. She takes the red-and-black helmet with both hands; he releases it and withdraws empty hands. Show clear contact and release without fused fingers or duplicated objects.

7-10s, return to the wide: woman holds her received helmet and steps toward the red bike; male racer keeps his white helmet and steps toward the blue bike. Mechanic stays between them, hands empty. Bikes remain on stands; nobody mounts or puts on a helmet.

Maintain identities, screen direction, object ownership, grounded movement and natural occlusion. Audio: continuous quiet garage ambience, footsteps and helmet handling. No dialogue, music, extra cuts, slow motion, duplicated people or objects, text, logos or watermarks.
Velocità di generazione
| Scenario | Modello | Durata | Dall'invio al completamento osservato |
|---|---|---|---|
| Piega in moto e camera a seguire | Flash | 8 secondi | 82,658 secondi |
| Piega in moto e camera a seguire | Seedance 2.5 | 8 secondi | 200,842 secondi |
| Combattimento continuo | Flash | 8 secondi | 82,400 secondi |
| Combattimento continuo | Seedance 2.5 | 8 secondi | 197,657 secondi |
| Recitazione e battuta in inglese | Flash | 8 secondi | 87,419 secondi |
| Passaggio della chiave tra due persone | Flash | 8 secondi | 89,368 secondi |
| Piccolo movimento da primo fotogramma | Flash | 8 secondi | 83,066 secondi |
| Sette immagini di riferimento e scambio in tre inquadrature | Flash | 10 secondi | 124,013 secondi |
Per i primi cinque video di Flash da 8 secondi, il tempo trascorso dall'invio dell'attività al completamento osservato si è attestato tra circa 82 e 89 secondi; i due video da 8 secondi della versione standard hanno richiesto rispettivamente circa 201 e 198 secondi. Il video multi-riferimento da 10 secondi ha richiesto circa 124 secondi; poiché i materiali in ingresso e la durata sono diversi, questo dato viene registrato separatamente senza calcolare un rapporto diretto di velocità rispetto ai campioni precedenti da 8 secondi. Quando il flusso di lavoro quotidiano prevede di affinare ripetutamente i prompt, generare più cicli di bozze e confrontare la resa dello storyboard, risparmiare oltre un minuto a ogni singola generazione permette di velocizzare sensibilmente i tentativi e la selezione nelle fasi preliminari.
Va precisato che, sebbene tutte le attività siano state inviate utilizzando lo stesso account, i test delle due versioni sono stati distribuiti in fasce orarie differenti e non sono state effettuate generazioni multiple per calcolare una media su ciascuno scenario. I tempi registrati includono le fluttuazioni di rete, le code lato server e il ritardo di osservazione introdotto dallo script che interroga lo stato ogni cinque secondi. Pertanto, questi dati riflettono unicamente il minor tempo di attesa effettivo riscontrato con Flash durante questa sessione di prova e non possono essere convertiti direttamente in un vantaggio di velocità fisso e assoluto del modello.
Quando usare Flash e quando scegliere la versione standard
Se il lavoro creativo è incentrato principalmente su scene dinamiche e sequenze d'azione, i risultati di questa sessione indicano che Seedance 2.5 standard rimane la scelta più solida. Nei due confronti sulla resa del movimento, il modo in cui la versione standard restituisce lo sviluppo completo dell'azione, le reazioni fisiche ai colpi e gli spostamenti nello spazio risponde meglio alle esigenze di ripresa di questo tipo di inquadrature.
Se invece in una determinata fase l'obiettivo principale è fare prove rapide di recitazione, definire l'inquadratura, mettere a punto la stesura dei prompt o portare avanti in blocco le clip quotidiane con un budget contenuto, i tempi di attesa ridotti e il minor costo unitario di Flash offrono un vantaggio concreto. Anche questo modello è in grado di produrre clip dalla buona resa visiva, ma in fase di selezione del materiale occorre comunque confrontare il risultato con i requisiti dello storyboard, verificando con attenzione i tagli compositivi, la fluidità delle transizioni motorie e i dettagli delle interazioni ravvicinate.
Nel complesso, nei due test dinamici di questa sessione, la resa del movimento di Flash non ha ancora eguagliato del tutto quella di Seedance 2.5 standard, che mantiene un vantaggio in termini di completezza del gesto e senso di forza; il posizionamento di Flash punta invece a ridurre i tempi di attesa e abbassare i costi di chiamata mantenendo una qualità utilizzabile, così da agevolare i creator nelle fasi preliminari ad alta frequenza di tentativi e produzione. Per quanto riguarda la recitazione con battute, le interazioni di dettaglio, la comprensione spaziale e la coerenza dello storyboard con più immagini di riferimento, in questa sessione sono stati generati solo campioni con Flash per illustrarne il comportamento concreto e gli aspetti da tenere d'occhio in queste categorie, senza stabilire un confronto di merito tra le due versioni su tali compiti.