Was ist Seedance 2.5 Flash für ein Modell?
Seedance 2.5 Flash ist das auf Generierungsgeschwindigkeit ausgelegte Videomodell innerhalb der Seedance 2.5-Reihe von ByteDance. In dieser Testrunde prüfen wir nacheinander Bewegungsdarstellung, Schauspiel, Detailinteraktion, räumliches Verständnis sowie die Einstellungs-Konsistenz bei mehreren Referenzbildern, um zu sehen, wie weit das Modell bei typischen kreativen Aufgaben kommt. Nach den vorliegenden Testbeispielen bietet Seedance 2.5 Flash ein gutes Gleichgewicht zwischen Ausgabeeffizienz und Nutzungskosten und eignet sich als primäres Generierungsmodell für Kreative, um im Alltag Konzepte voranzutreiben und Einstellungen vorauszuwählen.
In den beiden direkten Vergleichen dieser Runde lieferte Seedance 2.5 Flash schneller Ergebnisse als die Standardversion, bei durchaus brauchbarer Bildqualität. Bei dynamischen Aufnahmen mit großen Bewegungen – wie dem Hineinlegen eines Motorrads in die Kurve, Trefferreaktionen, Fußfegern oder Stürzen zu Boden – bleibt es in puncto Bewegungsvollständigkeit, Wucht und Umsetzung komplexer Bewegungsanweisungen jedoch noch leicht hinter der Standardversion von Seedance 2.5 zurück.
Parameterunterschiede zwischen Flash und den beiden anderen Modellen
Die folgende Tabelle basiert auf der am 16. November 2026 geprüften offiziellen Dokumentation und führt die Obergrenzen der Modellfähigkeiten auf. In dieser Testrunde sind die ersten fünf Flash-Tests sowie die beiden Vergleichsvideos der Standardversion jeweils 8 Sekunden lang; das Beispiel mit mehreren Referenzbildern dauert 10 Sekunden, und die Auflösung wurde einheitlich auf 720p eingestellt. Dies sind lediglich die Parametereinstellungen dieses Praxistests und bedeutet nicht, dass die Modelle nur diese Spezifikationen ausgeben können.
| Parameter | Seedance 2.5 Flash | Seedance 2.5 | Seedance 2.0 |
|---|---|---|---|
| Ausgabeauflösung | 480p, 720p | 480p, 720p, 1080p | 480p, 720p, 1080p, 4K |
| Dauer pro Einzelgenerierung | 4–30 Sek. | 4–30 Sek. | 4–15 Sek. |
| Limit für multimodale Referenzbilder | 10 Bilder | 30 Bilder | 9 Bilder |
| Limit für multimodale Referenzvideos | 5 Clips | 10 Clips | 3 Clips |
| Limit für multimodale Referenzaudios | 5 Clips | 10 Clips | 3 Clips |
| Entwurfsmodus (Draft) | Nicht unterstützt | Unterstützt | Nicht unterstützt |
Flash unterstützt maximal 720p-Ausgaben, nach unten hin ist 480p wählbar. Im Vergleich zu Seedance 2.5 ist das Limit für Referenzbilder von 30 auf 10 reduziert, und Referenzvideos sowie -audios wurden jeweils von 10 auf 5 Clips gesenkt. Wenn ein Projekt die Eingabe umfangreicher Referenzmaterialien erfordert oder zwingend 1080p-Rohmaterial geliefert werden muss, wirken sich diese Spezifikationsunterschiede direkt auf die Modellwahl aus.
Die in der Tabelle genannten Obergrenzen für Referenzen beziehen sich auf multimodale Referenzaufgaben, nicht auf die Upload-Anzahl bei der Bild-zu-Video-Generierung über ein Startbild. Aufgaben mit Startbild nutzen nur ein einziges Bild als Eingabe, während Aufgaben mit Start- und Endbild jeweils ein Bild für den ersten und den letzten Frame verwenden. Alle genannten Obergrenzen stammen aus den offiziellen Angaben; im vorliegenden Testfall mit mehreren Referenzbildern wurden sieben Referenzbilder genutzt – weder das Eingabelimit von zehn Bildern noch andere Auflösungsstufen wurden getestet.
Offizieller Preisvergleich für die Videogenerierung
Die folgenden Preise beziehen sich auf die Online-Inferenzpreise der offiziellen chinesischen Preisliste von Volcano Ark (überprüft am 16. November 2026) unter der Abrechnungsvoraussetzung von 720p, 16:9 und einer Eingabe ohne Video. Die in dieser Runde getesteten Verfahren – Text-zu-Video, Bild-zu-Video über Startbild sowie Video aus mehreren Referenzbildern – nutzten allesamt keine Referenzvideos als Eingabe.
| Modell | Offizieller Stückpreis | Umgerechneter Preis pro Sekunde laut offiziellem Beispiel | Richtbudget für 8-Sek.-Video | Richtbudget für 10-Sek.-Video |
|---|---|---|---|---|
| Seedance 2.5 Flash | 46 CNY / 1 Mio. Token | ca. 0,99 CNY | ca. 7,9 CNY | ca. 9,9 CNY |
| Seedance 2.5 | 70 CNY / 1 Mio. Token | ca. 1,51 CNY | ca. 12,1 CNY | ca. 15,1 CNY |
| Seedance 2.0 | 46 CNY / 1 Mio. Token | ca. 0,99 CNY | ca. 7,9 CNY | ca. 9,9 CNY |
Unter gleichen Bedingungen liegt der offizielle Token-Stückpreis von Flash rund 34 % unter dem von Seedance 2.5 und auf dem gleichen Niveau wie Seedance 2.0. Seedance 2.0 dient hier lediglich als Parameter- und Preisreferenz; in dieser Runde wurden damit keine Testvideos generiert. Die Budgets für 8 und 10 Sekunden in der Tabelle sind zur leichteren Vergleichbarkeit grob anhand des Sekundenpreises aus dem offiziellen Beispiel umgerechnet. Die tatsächliche Abrechnung richtet sich nach dem Token-Stückpreis und dem realen Verbrauch gemäß der offiziellen Rechnung; die hier aufgeführten Werte stellen nicht die tatsächlichen Ausgaben für diese Testbeispiele dar.
Praxisergebnisse in den einzelnen Fähigkeitsbereichen
Dieser Test untersucht fünf Generierungsfähigkeiten anhand von sechs Szenarien und umfasst insgesamt sechs Flash-Beispielvideos sowie zwei Vergleichsvideos der Seedance 2.5-Standardversion. Motorrad-Kurvenlage und durchgehender Kampf fallen unter Bewegungsdarstellung und werden im Versionsvergleich geprüft; die übrigen vier Bereiche testen ausschließlich die Leistung von Flash. Die ersten sieben Videos sind jeweils 8 Sekunden lang, das Beispiel mit mehreren Referenzbildern dauert 10 Sekunden und besteht aus drei Einstellungen.
| Fähigkeitskategorie | Testszenario | Dauer | Wichtigste Ergebnisse bei Flash | Seedance 2.5 im Vergleich |
|---|---|---|---|---|
| Bewegungsdarstellung & Kamerasteuerung | Motorrad-Kurvenlage & Verfolgungsfahrt | 8 Sek. | Vermittelt Geschwindigkeitsgefühl, enger Beschnitt beeinträchtigt die Darstellung der vollständigen Kurvenfahrt | Ablauf vom Hineinlegen über den Scheitelpunkt bis zum Aufrichten ist vollständiger |
| Bewegungsdarstellung & Kamerasteuerung | Durchgehender Kampf | 8 Sek. | Kann fortlaufende Angriffs- und Abwehraktionen generieren, Übergänge und Wucht teils etwas schwach | Körperdrehung, Trefferreaktionen und Vor-/Rückwärtsbewegung im Raum wirken natürlicher |
| Schauspiel & Dialog | Brief lesen, Aufblicken & englischer Satz | 8 Sek. | Zeigt den Übergang vom Lesen zum Lächeln, Satz und Lippenbewegungen noch nicht unabhängig verifiziert | Nicht getestet |
| Detailinteraktion | Schlüsselübergabe zwischen zwei Personen | 8 Sek. | Übergabebeziehung des Schlüssels ist klar, Abweichung bei der Figuren-Vorgabe, Fingerkontakt erfordert genaue Prüfung | Nicht getestet |
| Räumliches Verständnis | Tasse auf dem Tisch drehen | 8 Sek. | Layout bleibt im Großen und Ganzen erhalten, Drehwinkel der Tasse noch unbestätigt, Kamera fährt leicht nach vorn | Nicht getestet |
| Mehrere Referenzbilder & Einstellungs-Konsistenz | Drei Einstellungen mit Übergabe aus sieben Referenzbildern | 10 Sek. | Über drei Einstellungen hinweg bleiben Figuren, Fahrzeuge und Helmzuordnung insgesamt konsistent | Nicht getestet |
Im Folgenden werden die Originalvideos und Prompts nach Fähigkeitskategorien geordnet vorgestellt; die konkreten Wartezeiten der einzelnen Videos sind am Ende des Artikels in der Tabelle zur Generierungsgeschwindigkeit zusammengefasst.
Bewegungsdarstellung und Kamerasteuerung
Dieser Abschnitt untersucht anhand der beiden Szenarien „Motorrad-Kurvenlage“ und „Zweikampf“ die Bewegungsübergänge, Schwerpunktverlagerungen, Bewegungsbahnen sowie die Frage, ob die Kamera den Bewegungsablauf klar vermitteln kann. Beide Modelle verwenden exakt dieselben englischen Prompts und Generierungseinstellungen.
Motorrad-Kurvenlage und Verfolgungsfahrt
Die Prompt-Anforderungen sind für beide Versionen identisch: Ein Fahrer fährt auf einem roten Motorrad durch eine langgezogene Kurve, begleitet von einer tief positionierten Kamera schräg von vorn; nach dem Scheitelpunkt richtet sich die Maschine allmählich wieder auf, wobei das gesamte Motorrad samt Vorder- und Hinterrad durchgehend im Bild bleiben muss.
Seedance 2.5 Flash
8 Sek. · 720p · Natives Audio · Vom Absenden bis zum beobachteten Abschluss: 82,7 Sek.
Seedance 2.5
8 Sek. · 720p · Natives Audio · Vom Absenden bis zum beobachteten Abschluss: 200,8 Sek.
Flash wirkt eher wie eine Rennsport-Detailaufnahme
In dem von Flash generierten Bild sind die rote Frontpartie, der nasse Asphalt, die Lichtreflexionen und die vom Hinterrad aufgewirbelte Gischt recht klar zu erkennen; der Hintergrund zieht schnell vorbei, und die dicht an der Front klebende Verfolgungskamera sorgt für ein gutes Geschwindigkeitsgefühl. Allerdings ist der Bildausschnitt zu eng gewählt: Kopf und Oberkörper des Fahrers sowie Teile der Maschine sind abgeschnitten, und auch Vorder- und Hinterrad bleiben nicht wie im Prompt gefordert vollständig im Bild. Zwar erkennt man die Schräglage der Maschine, doch durch die enge Bildkomposition ist für den Zuschauer kaum nachvollziehbar, wie Fahrer und Motorrad in der Kurve zusammenarbeiten.
Wenn im fertigen Schnitt zufällig eine knappe Detailaufnahme eines Rennmotorrads benötigt wird, ist dieses Material brauchbar; verlangt das Storyboard jedoch die vollständige Darstellung des Kurvenablaufs oder soll der Clip an eine Einstellung anschließen, die die Ideallinie auf der Strecke zeigt, ist dieser Beschnitt von Fahrer und Maschine ungeeignet.
Die Standardversion fängt die Kurvenfahrt vollständiger ein
Die Standardversion behält die Konturen des Fahrers und des gesamten Motorrads im Bild. Entlang der Zeitachse sieht man, wie sich die Maschine in die Kurve legt, sich dem Scheitelpunkt nähert und anschließend den Neigungswinkel schrittweise verringert, um sich wieder aufzurichten; im Zusammenspiel mit den Curbs am Kurveninnenrand wird auch die Fahrlinie des Motorrads sehr deutlich.
Dieser flüssige Eindruck entsteht durch das Zusammenspiel von Fahrzeuglage, Körperschwerpunkt des Fahrers, Kurvenlinie und Kameradistanz. Verglichen mit der engen Detailaufnahme von Flash stellt die Standardversion den Ablauf vom Hineinlegen bis zum allmählichen Aufrichten wesentlich klarer dar und liefert in diesem Szenario daher die bessere Bewegungsdarstellung.
Allerdings verändern sich auch bei der Standardversion im Verlauf der Aufnahme der schräge Frontwinkel und die Einstellungsgröße. Allein anhand einzelner Stichproben-Frames lässt sich noch nicht bestätigen, dass Bodenkontakt der Reifen und Fahrzeuggeometrie in jedem Moment vollkommen präzise sind. Dieser Vergleich zeigt zwar, dass die Standardversion Bewegungsablauf und Fahrlinie vollständiger wiedergibt, lässt aber nicht den Schluss zu, dass sämtliche physikalischen Details fehlerfrei sind.
Vollständiger englischer Prompt für den Motorrad-Test
One continuous 8-second cinematic live-action shot on a closed motorcycle racing circuit just after rain, at blue hour. A single adult professional racer in black protective leathers and a full-face helmet rides one unbranded red sport motorcycle through a sweeping right-hand bend. A low front three-quarter tracking camera follows alongside at matching speed, keeping the whole motorcycle and both wheels visible. The racer leans naturally into the corner, reaches the apex, then gradually brings the bike upright toward the exit. Both tires remain on the wet asphalt. Track barriers and floodlights move past in the background, with a fine spray of water trailing the rear tire. Physically plausible rider anatomy and motorcycle geometry, consistent red bodywork, realistic film texture. Sound: one motorcycle engine rising smoothly and wet tire hiss. No dialogue, no music, no cuts, no text, no subtitles, no logos.
Durchgehender Zweikampf
In dieser Kampfszene sollten beide Modelle direkt ab dem ersten Frame mit dem Schlagabtausch beginnen: eine schnelle Schlagkombination, Ausweichen und Blocken, gefolgt von einem wuchtigen Kontertritt, anschließendem Nachsetzen, einem tiefen Fußfeger und schließlich einem Sturz samt Abrollen am Boden. Um die Figuren im schnellen Gefecht auseinanderzuhalten, gibt der Prompt für eine Person eine graue Jacke mit schwarzer Hose und für die andere eine dunkelblaue Jacke mit brauner Hose vor.
Seedance 2.5 Flash
8 Sek. · 720p · Natives Audio · Vom Absenden bis zum beobachteten Abschluss: 82,4 Sek.
Seedance 2.5
8 Sek. · 720p · Natives Audio · Vom Absenden bis zum beobachteten Abschluss: 197,7 Sek.
Flash liefert viele Kombinationen, aber wenig Wucht
Flash hat sämtliche geforderten Aktionen – Schlagkombination, Block, Tritt, tiefer Fußfeger und Abrollen am Boden – generiert. Bei genauerem Hinsehen wirken einige Passagen jedoch eher wie nacheinander abgearbeitete Einzelbewegungen; die Trefferreaktionen nach Schlägen und Tritten sowie die fließenden Übergänge zur nächsten Technik wirken etwas schwebend und kraftlos. Die beiden Kämpfer bewegen sich im Bild im Wesentlichen nur seitlich nach links und rechts, während zwischen Kamera und Figuren kaum Distanzveränderungen in die Raumtiefe stattfinden.
Zudem wurden oben und unten automatisch schwarze Balken eingefügt, und in der ersten Hälfte sind die Füße nicht vollständig im Bild. Wenn es darum geht, Standbein, Schrittarbeit und Kraftübertragung während des Kampfes zu beurteilen, erschwert das Abschneiden der Füße die Einschätzung.
Krafteinsatz und Raumbewegung wirken in der Standardversion natürlicher
In der Standardversion erkennt man bei den Schlägen den Krafteinsatz aus Schultern und Rücken sowie die Rumpfrotation; auch Ausweichbewegungen, Kontertritte und Rückwärtsschritte erfassen den gesamten Körper. Nachdem Distanz aufgebaut wurde, gehen beide wieder in den Nahkampf über und schließen nahtlos mit Beinarbeit und dem Abrollen am Boden an. Die Kamera passt ihre Position dem Kampfverlauf an, Abstand und Ausrichtung der Figuren ändern sich fortlaufend, sodass der Kampf in einem Raum mit spürbarer Tiefe stattfindet und die räumlichen Positionsverhältnisse deutlich klarer sind.
Dieses Beispielvideo vermittelt den Ablauf von Kraftaufbau über das Abwehren bis zum Nachsetzen wesentlich zusammenhängender. Im Vergleich zu Flash wirken Schläge und Tritte in der Standardversion gewichtiger, die Kombinationen greifen enger ineinander, was in diesem Szenario zu einer besseren Bewegungsleistung führt.
Allerdings behält auch die Standardversion die Füße beider Kämpfer nicht durchgehend im Bild. Ob der Kontakt bei Schlägen und Tritten im Detail plausibel ist, ob exakt die im Prompt geforderten drei Schläge ausgeführt werden und ob jede Schwerpunktverlagerung stimmig ist, muss dennoch anhand des laufenden Videos genau geprüft werden. Ein filmischerer Bildeindruck bedeutet nicht automatisch, dass die Kampfchoreografie vollkommen präzise ist oder jede einzelne Bewegungsanweisung des Prompts strikt umgesetzt wurde.
Vollständiger englischer Prompt für den Kampftest
An explosive 8-second live-action martial-arts fight scene, fast real-time Hong Kong action-film choreography, one continuous shot. Two adult fighters in a gritty concrete parking garage: one in a light grey jacket and black trousers, the other in a dark navy jacket and tan trousers. They are already fighting in the opening frame. The grey fighter surges forward with a rapid three-punch combination; the navy fighter slips the first punch, blocks the next and drives back with a forceful body kick. The grey fighter staggers two steps, immediately closes the distance, ducks a swinging counterpunch and sweeps the navy fighter's leg. The navy fighter hits the floor in a controlled stunt fall and rolls away as the grey fighter pursues. Relentless attack-and-counterattack momentum throughout, short transitions, sharp acceleration, convincing physical impact reactions, forceful torso rotation, realistic weight and balance, clear changes of position across the floor. The camera tracks rapidly beside them at waist height in a medium-wide action framing, keeping both whole bodies and the floor under their feet visible, with subtle handheld vibration at impacts. Crisp readable action, restrained motion blur, hard overhead light, cinematic contrast, realistic anatomy and clothing, distinct stable identities. Audio: rapid footfalls, forceful punch and kick impacts, clothing snaps, heavy breathing and a solid floor impact. No slow motion, no standing around, no pauses to reset, no dialogue, no music, no text, no subtitles, no cuts, no blood, no gore, no weapons.
Schauspiel und Dialog
Dieses Szenario verlangt, dass eine Figur zunächst mit gesenktem Kopf einen Brief liest, dann aufblickt, auf Englisch den Satz „You kept the letter.“ (Du hast den Brief aufbewahrt.) sagt und anschließend kurz lächelt. Der Prompt gibt vor, dass der Satz zwischen Sekunde 4 und 6 gesprochen werden und die Kameraeinstellung statisch bleiben soll.
Anhand der geprüften Einzelbilder vollzieht die Figur den Übergang vom gesenkten Blick auf den Brief hin zum Aufblicken und Lächeln; Gesicht, Jacke und das Briefpapier in der Hand sind zu jedem Zeitpunkt klar erkennbar. Solche zurückhaltenden Schauspielszenen ohne heftige Bewegungen eignen sich gut, um Mimik und emotionale Übergänge direkt zu beobachten.
Bei der Bewertung solcher Schauspieleinstellungen mit Dialog müssen Bild und Ton getrennt geprüft werden. Dass ein Video über eine Tonspur verfügt, heißt noch nicht, dass Aussprache und Lippenbewegungen exakt übereinstimmen. Beim Sichten des Originalclips muss weiterhin geprüft werden, ob der englische Satz klar ausgesprochen wird, ob zusätzliche Stimmgeräusche eingemischt sind, ob das Sprechen wie gefordert zwischen Sekunde 4 und 6 einsetzt und ob die Mundbewegungen dazu passen. Allein auf Basis statischer Screenshots wurde in dieser Runde noch nicht unabhängig verifiziert, ob der Satz Wort für Wort korrekt ist und die Lippenbewegungen exakt synchron laufen.
Englischer Prompt für den Schauspiel-Test
One continuous 8-second medium close-up in a quiet train carriage, naturalistic live-action cinematography. An adult woman in a plain navy jacket holds one opened letter below her face. 0-2 seconds: she reads it silently, with a thoughtful expression. 2-4 seconds: she takes a small breath and lifts her eyes toward a person just beside the camera. 4-6 seconds: with a restrained, tender smile she says clearly in English, 'You kept the letter.' 6-8 seconds: she holds the eye contact and the quiet smile. Keep her mouth fully visible and her face, clothing and letter consistent. The camera stays still. Audio: her single spoken line over soft carriage rumble. No other voices, no music, no captions, no readable writing, no subtitles, no cuts.
Detailinteraktion
In diesem Szenario soll eine Person einen kleinen Messingschlüssel in die Handfläche einer anderen Person legen, die Finger öffnen und anschließend die leere Hand zurückziehen. Die Übergabe einer solchen kleinen, festen Requisite eignet sich gut, um die Qualität der Handgenerierung zu prüfen: Wenn sich zwei Hände annähern und überlappen, müssen das Halten und Loslassen des Schlüssels klar erkennbar dargestellt werden.
In den geprüften Bildern der Übergabe bewegt sich die übergebende Hand zur geöffneten Handfläche, legt den Schlüssel ab und zieht sich zurück, woraufhin die empfangende Person die Finger schließt. Unten ist der Moment der Übergabe als vergrößerter Ausschnitt dargestellt, um den Kontakt zwischen Fingerspitzen und Schlüssel besser beobachten zu können.
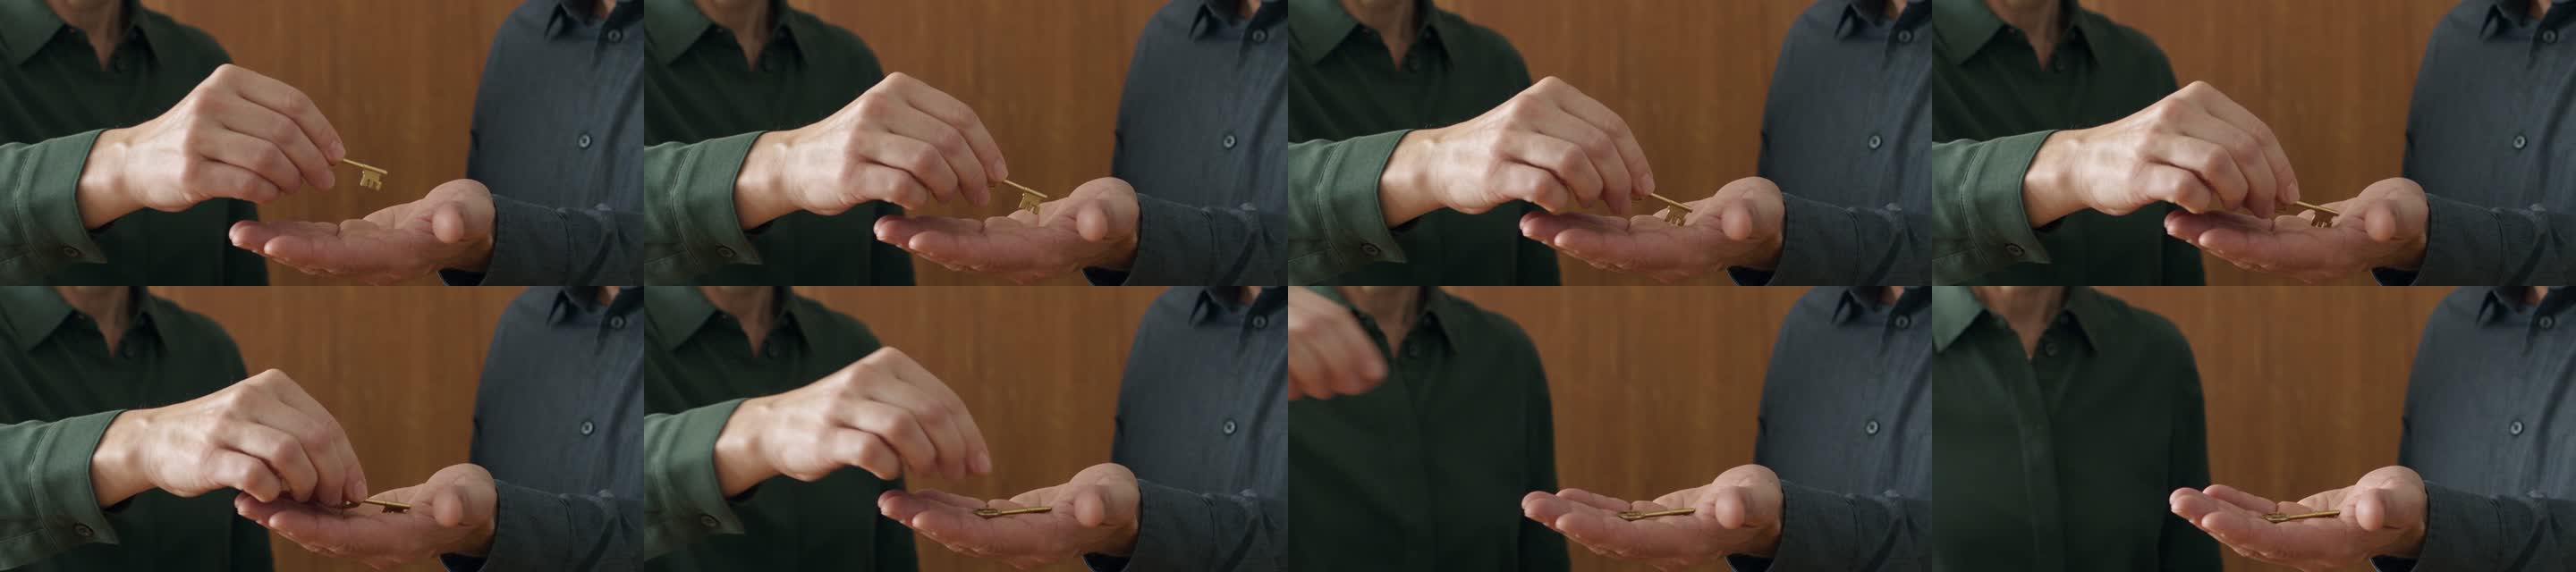
Bei der Prüfung solcher Detailinteraktionen kommt es meist auf mehrere Punkte an: Öffnen sich die Finger, die den Schlüssel halten, beim Loslassen auf natürliche Weise? Verschmelzen oder verwischen die Fingerspitzen mit dem Schlüssel oder der anderen Handfläche? Ist die Gelenkstruktur von Daumen und übrigen Fingern anatomisch stimmig, und bleibt der Schlüssel über den gesamten Verlauf hinweg ein einzelnes Objekt? Diese Details müssen im Video Frame für Frame geprüft werden; eine korrekte Handstruktur im Startframe garantiert nicht, dass es beim Überlappen beider Hände nicht doch zu Fehlern kommt.
Darüber hinaus zeigt dieses Beispielvideo eine deutliche Abweichung bei der Figuren-Vorgabe. Der Prompt verlangt ausdrücklich, dass links im Bild eine Frau den Schlüssel übergibt, doch die generierte übergebende Person ist männlich. Obwohl sich der Clip also zur Beobachtung der Handübergabe nutzen lässt, wurde die Figuren-Vorgabe nicht wie gefordert umgesetzt. Dass die Requisite erfolgreich den Besitzer wechselt, bedeutet nicht, dass alle Prompt-Anweisungen erfüllt wurden, und anhand weniger Stichproben-Frames lässt sich auch nicht abschließend bestätigen, dass die Kontaktstruktur der Finger durchgehend fehlerfrei ist.
Englischer Prompt für den Schlüsselübergabe-Test
One continuous 8-second live-action shot, a fixed waist-up two-shot of two adults at a wooden counter, with both people's hands clearly visible throughout. The woman on the left wears a dark green shirt. The man on the right wears a charcoal shirt. 0-2 seconds: the woman holds exactly one small brass key between the fingers of her right hand; the man presents his empty open left palm. 2-5 seconds: she moves that key into his left palm and releases it. 5-8 seconds: she withdraws her visibly empty right hand, and he closes his fingers around the received key. Maintain one key, two people and continuous natural hand movements. Show the actual contact and release clearly, with realistic anatomy and steady framing. Soft side lighting, believable skin and wood textures. Audio: quiet room tone and a small metallic click during the transfer. No speech, no music, no text, no subtitles, no cuts.
Räumliches Verständnis
Für diesen Test wurde ein eigens erstelltes, textfreies statisches Startbild eingegeben. Figur, blauer Becher, geschlossenes Notizbuch, Schreibtisch und Raumhintergrund sind bereits durch das Startbild festgelegt. Der Prompt verlangt nur eine sehr kleine Bewegung: Die Person senkt kurz den Blick, greift nach dem Becher, dreht ihn auf der Tischplatte um eine Vierteldrehung (ohne dass der Becherboden den Tisch verlässt), lässt los und blickt wieder zum Fenster.
Neben der Frage, ob das Erscheinungsbild der Figur konsistent bleibt, prüft diese Einstellung vor allem das Verständnis des Modells für räumliche Beziehungen auf dem Tisch: Bewegt sich die Hand in einer plausiblen Richtung zum Henkel, bleibt der Becherboden beim Drehen durchgehend auf der Tischplatte, bleiben die relativen Positionen von Notizbuch, Becher und Tisch stabil, und stimmen beim Greifen und Loslassen des Henkels die Verdeckungsverhältnisse ohne Durchdringungsfehler (Clipping)?
Nach den geprüften Einzelbildern bleibt die Anordnung auf dem Tisch insgesamt stabil; man sieht, wie die Hand zum Becher greift und sich wieder zurückzieht, während das Notizbuch rechts an seinem Platz bleibt. Zwar verändert sich zwischendurch die Ausrichtung des Henkels, doch in der zweiten Hälfte wirkt sie wieder fast wie in der Ausgangsposition; allein anhand dieser Stichproben-Frames lässt sich kaum sicher bestätigen, ob der Becher tatsächlich um eine volle Vierteldrehung gedreht wurde und im neuen Winkel stehen bleibt. Zudem verlangt der Prompt eine feststehende Kamera, doch das generierte Bild zeigt eine leichte Vorwärtsbewegung.
Bei der Bewertung solcher Bild-zu-Video-Generierungen aus einem Startbild kommt es neben der Figurenkonsistenz vor allem darauf an, ob Position und Verdeckungsverhältnisse bestehender Objekte erhalten bleiben, sobald eine Hand feste Gegenstände auf dem Tisch berührt. Um Fingerkontakt, Verdeckungen und Objektverschiebungen genau zu prüfen, empfiehlt es sich, das ursprüngliche Startbild und das generierte Video direkt nebeneinander zu vergleichen.
Englischer Prompt für den Tassendreh-Test
Continue the supplied first frame as one steady 8-second live-action shot. Preserve this exact adult woman's appearance, navy shirt, desk, single blue mug, closed tan notebook, background and window lighting. 0-2 seconds: she briefly glances down toward the blue mug. 2-5 seconds: she gently takes the mug handle with her right hand and rotates the mug a quarter turn on the tabletop without lifting it. 5-8 seconds: she releases the mug, rests her right hand beside it, and looks back toward the window. The mug stays on the desk and remains one rigid ceramic object, and the closed notebook remains fixed throughout. Keep the camera locked with no cut or zoom. Audio: quiet indoor ambience and a soft ceramic scrape during the turn. No speech, no music, no text, no subtitles.
Mehrere Referenzbilder und Einstellungs-Konsistenz
Dieser Test erweitert die Dauer auf 10 Sekunden und nutzt sieben Referenzbilder, um eine Sequenz aus drei Einstellungen zu generieren. Als Figuren sind eine koreanische Rennfahrerin, ein westlicher Rennfahrer und ein westlicher Mechaniker mittleren Alters vorgegeben, für die jeweils ein Dreiseitenansicht-Charakterbogen eingegeben wurde; hinzu kommen zwei unterschiedlich gestaltete Motorräder sowie zwei Helme (rot-schwarz und weiß).
Die Referenzbilder legen das Aussehen der Personen, die Kleidung und das Design der Objekte fest. Es wurden weder Szenenbilder noch Storyboard-Skizzen eingegeben; Werkstatthintergrund, Lichtstimmung und Schnittfolge werden ausschließlich über die Textbeschreibung gesteuert: ein bewölkter Nachmittag, weiches natürliches Tageslicht durch das Werkstatttor, trockener Boden sowie reduzierte Glanzlichter auf Haut und Lederkombis.
Verwendete Referenzbilder in diesem Test
| Referenzinhalt | Bild | Zuordnung |
|---|---|---|
| 1 · Dreiseitenansicht Rennfahrerin | 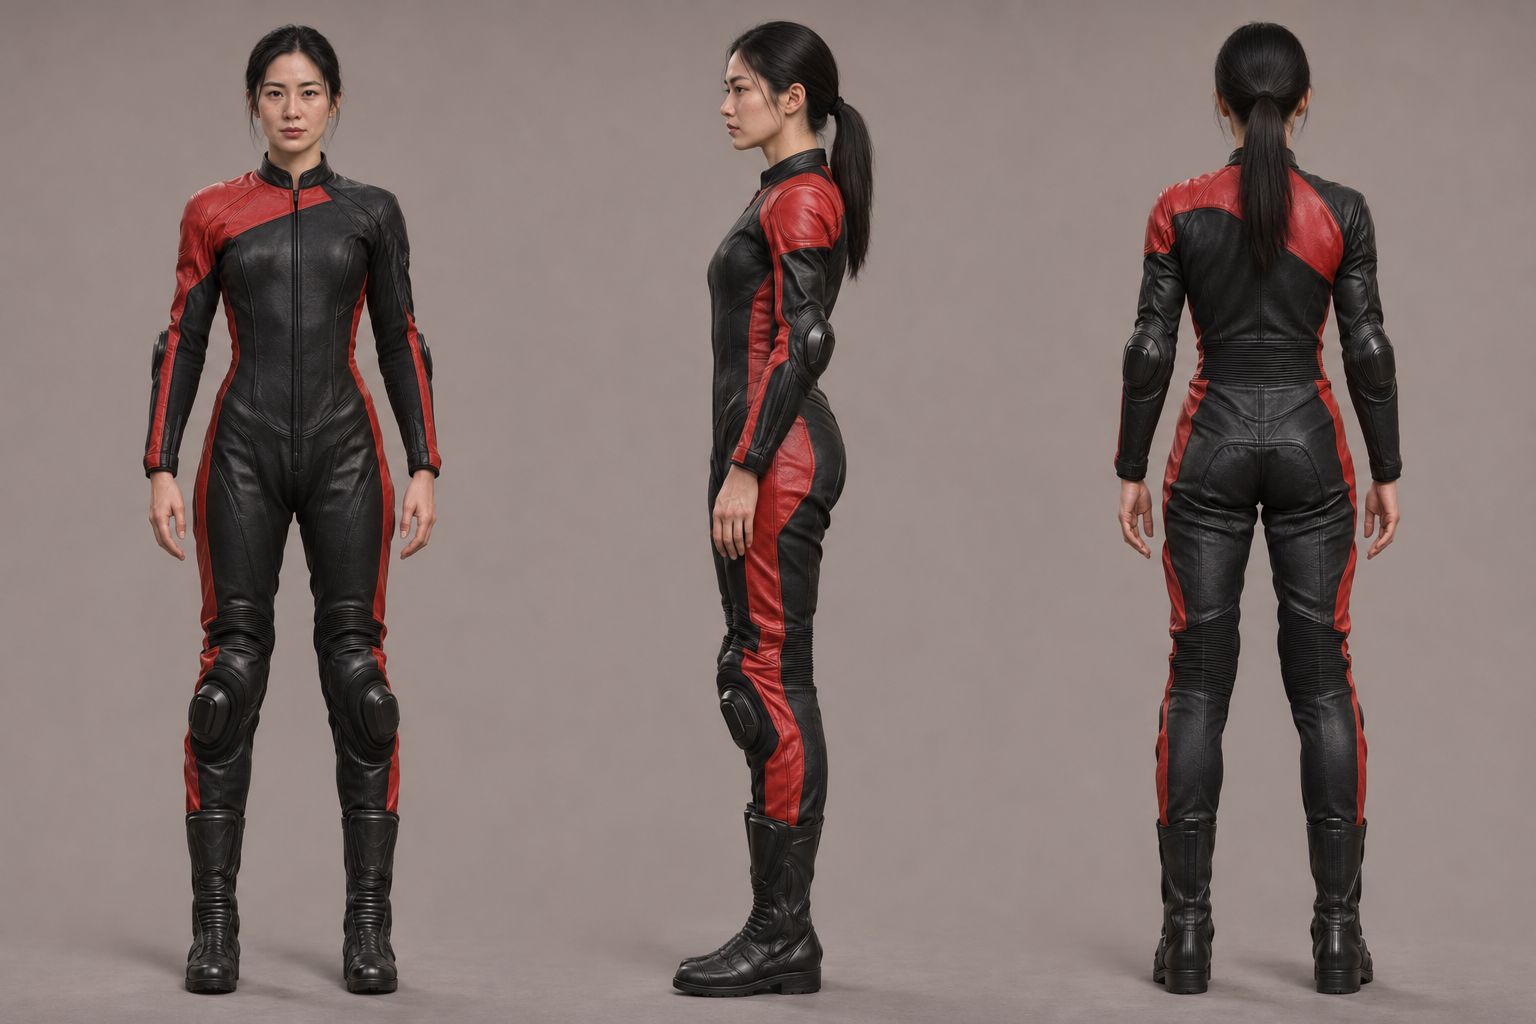 | Rot-schwarzer Rennanzug, nimmt den rot-schwarzen Helm entgegen |
| 2 · Dreiseitenansicht Rennfahrer | 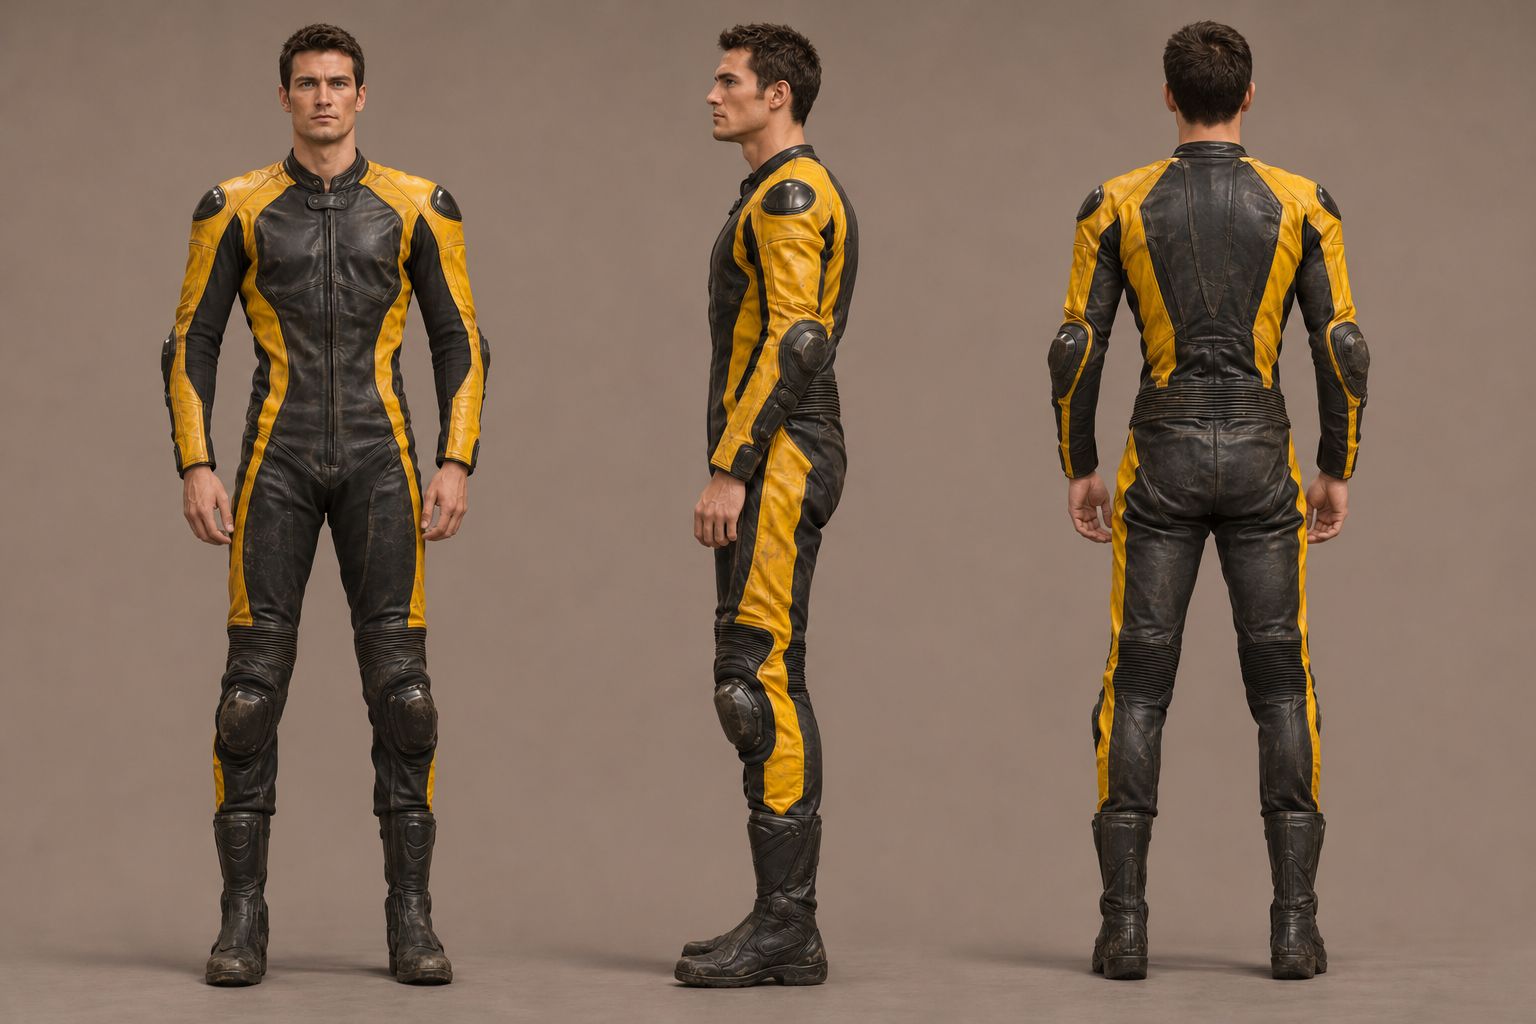 | Gelb-schwarzer Rennanzug, hält durchgehend den weißen Helm |
| 3 · Dreiseitenansicht Mechaniker | 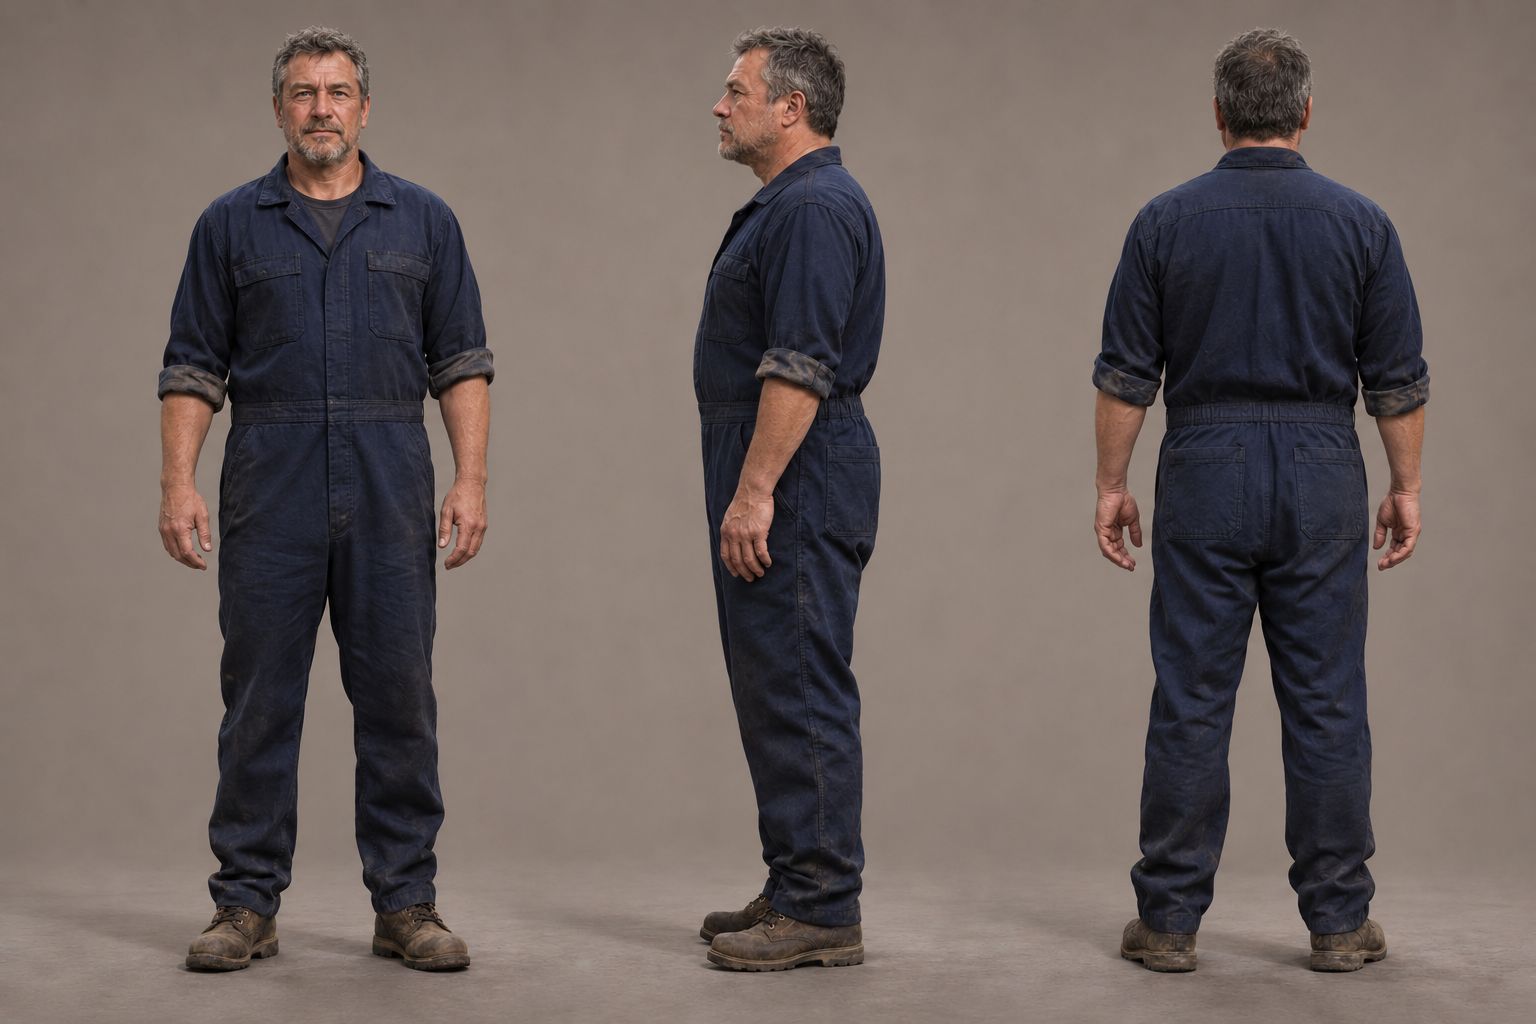 | Dunkelblauer Overall, zieht nach der Helmübergabe die leeren Hände zurück |
| 4 · Rotes Motorrad | 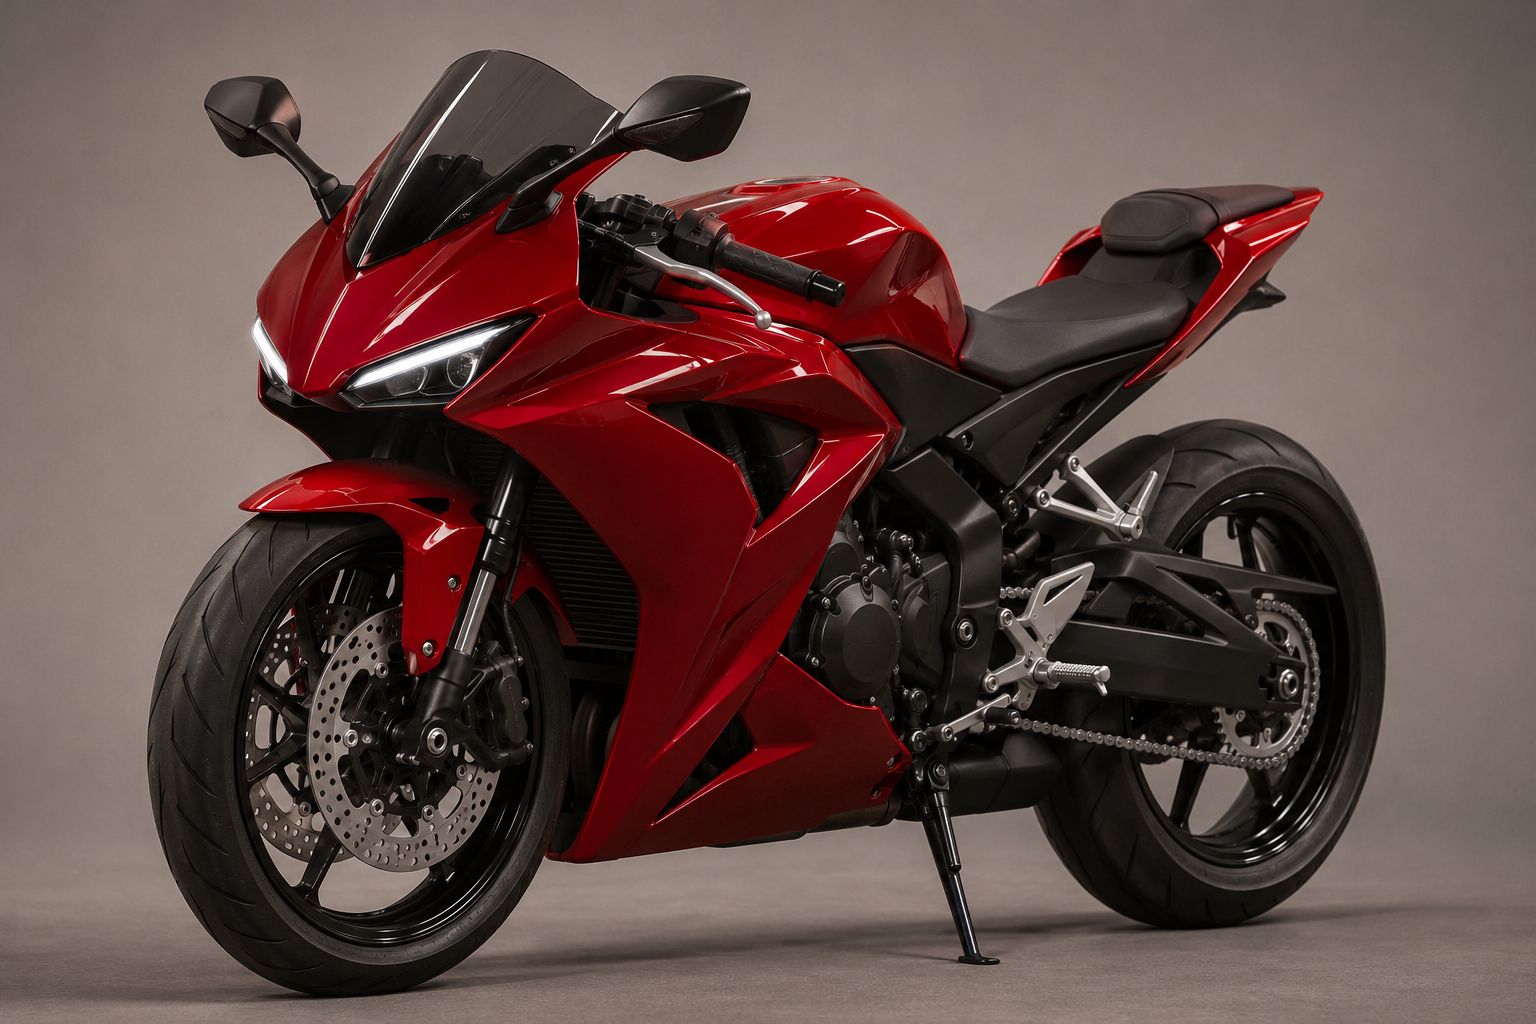 | Behält Vollverkleidung und geteilte Frontscheinwerfer bei |
| 5 · Blaues Motorrad | 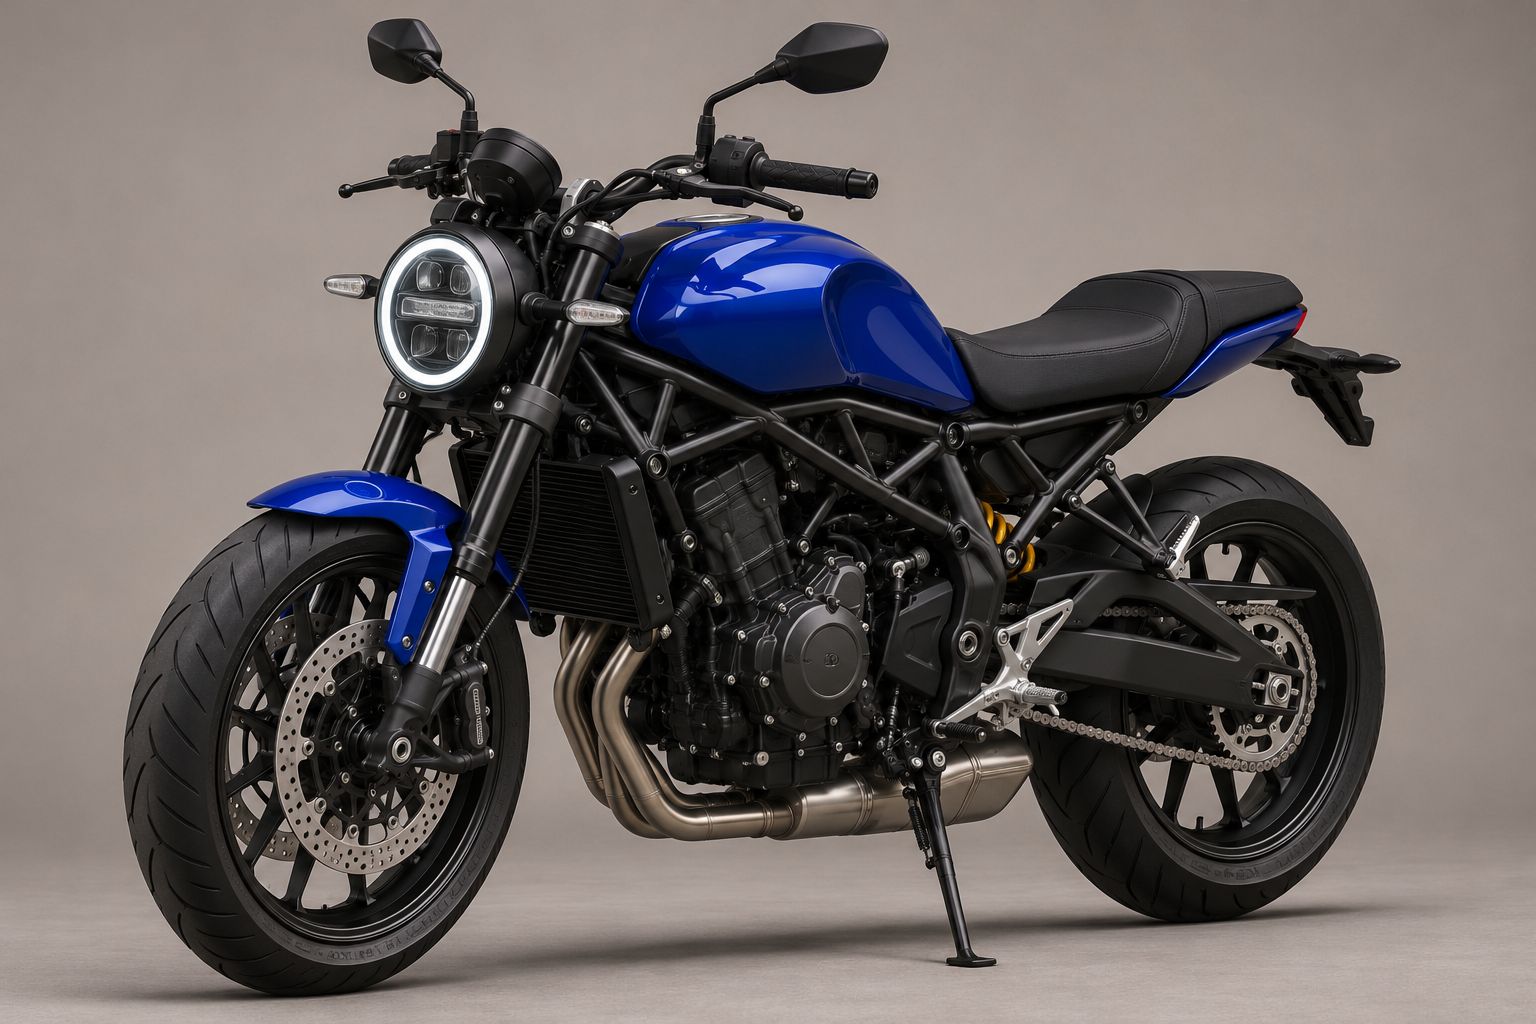 | Behält Rundscheinwerfer und freiliegenden Motor bei |
| 6 · Rot-schwarzer Helm | 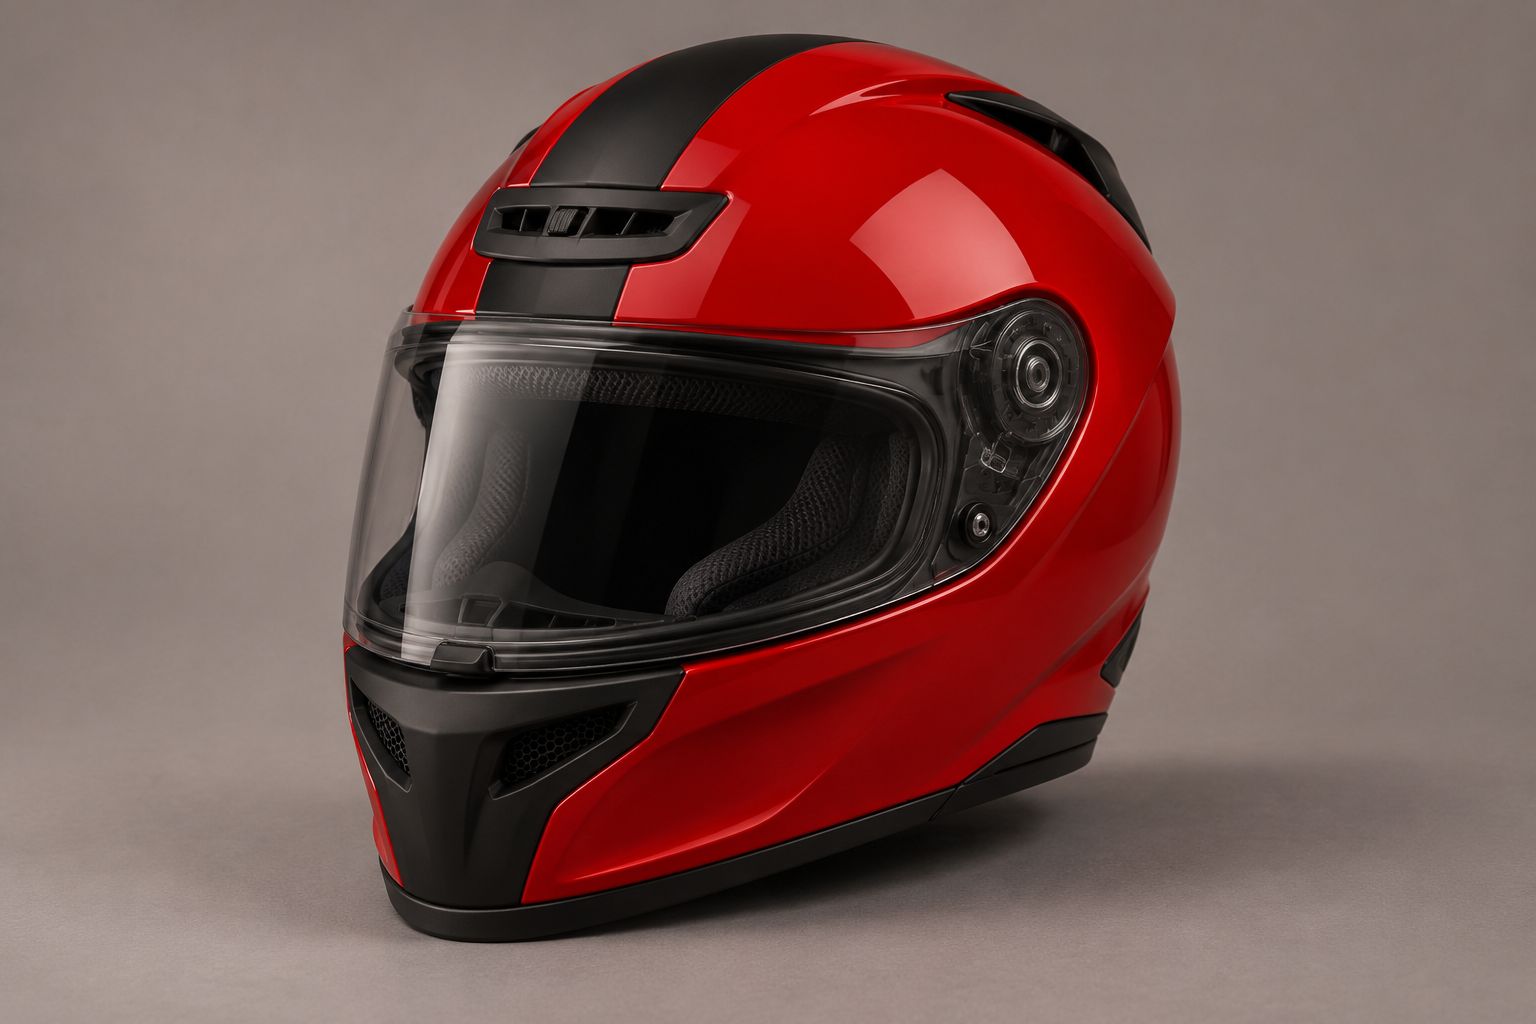 | Wird vom Mechaniker an die Rennfahrerin übergeben |
| 7 · Weißer Helm | 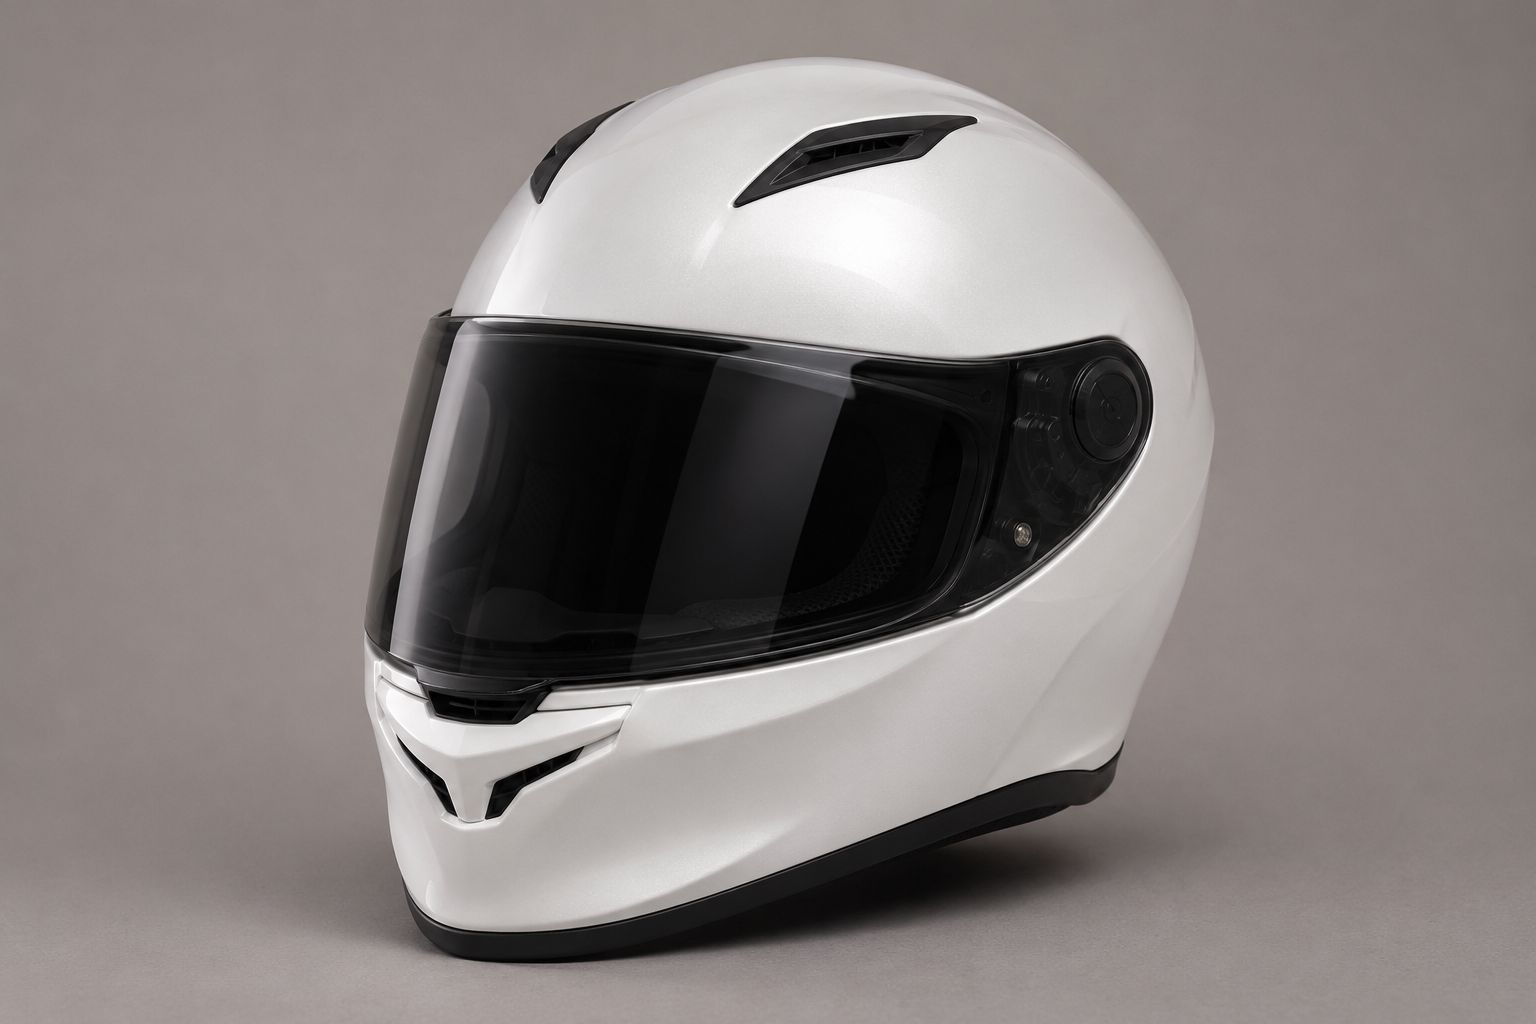 | Wird vom Rennfahrer gehalten |
Einstellungsplan
| Zeit | Einstellung |
|---|---|
| 0–3 Sek. | Totale zeigt die Positionen der drei Personen und zwei Motorräder |
| 3–7 Sek. | Halbtotale zeigt klar die Übergabe des Helms |
| 7–10 Sek. | Zurück zur Totalen, beide Fahrer gehen zu ihren jeweiligen Maschinen |
10 Sek. · 720p · Natives Audio · Vom Absenden bis zum beobachteten Abschluss ca. 124 Sek.
Figuren und Objekte bleiben über die Schnitte hinweg insgesamt konsistent
Dieses Beispielvideo wahrt die Konsistenz der Vorgaben über mehrere Schnitte hinweg. Während die Kamera von der Totalen in die Halbtotale und wieder zurück in die Totale schneidet, lassen sich Gesichtszüge, Rennanzüge und Overall der drei Figuren durchgehend zuordnen; auch das rote vollverkleidete Sportmotorrad und das blaue Naked Bike mit Rundscheinwerfer behalten jeweils ihr ursprüngliches Design. Die drei Charakterbögen mit Dreiseitenansichten wurden korrekt jeweils einer einzelnen Figur zugeordnet, ohne dass die drei Ansichten eines Bogens fälschlicherweise als drei verschiedene Personen generiert wurden.
Auch die Zuordnung und Übergabe der Helme bleibt schlüssig: Anfangs hält der Mechaniker den rot-schwarzen Helm, nach dem Schnitt in die Halbtotale nimmt die Rennfahrerin den Helm entgegen, während der Mechaniker loslässt und die Hände zurückzieht; nach dem Rückschnitt in die Totale befindet sich der rot-schwarze Helm weiterhin in den Händen der Fahrerin, während der Fahrer durchgehend den weißen Helm hält. Für Aufgaben mit mehreren Referenzbildern ist es für den späteren Schnitt äußerst hilfreich, dass Rollenidentitäten und die jeweiligen Requisiten auch nach Einstellungswechseln klar unterscheidbar bleiben.
Das fertige Video setzt die Schnitte bei etwa Sekunde 3 und Sekunde 6.8 und folgt damit im Wesentlichen dem Einstellungsplan von Totale zu Halbtotale und zurück zur Totalen. Die Lichtstimmung entspricht dem im Text beschriebenen weichen Tageslicht, und Reflexionen auf Boden und Lederkombis bleiben angenehm zurückhaltend. Allerdings wirkt das Schauspiel der Figuren noch etwas steif, und auch die Fingerdetails bei der Helmübergabe erfordern eine genauere Prüfung. Nach den bisherigen Beobachtungen hält dieses Beispielvideo die Zuordnung von Figuren und Objekten über alle drei Einstellungen hinweg insgesamt stabil aufrecht. In dieser Kategorie wurde ausschließlich Flash getestet; einen Konsistenzvergleich mit der Standardversion gibt es nicht.
Englischer Prompt für den Test mit mehreren Referenzbildern (gekürzte Fassung)
Der folgende Text enthält die Zuordnungen der Referenzbilder, die drei Einstellungen sowie die wichtigsten Einschränkungen des Originaltests, verzichtet jedoch auf wiederholte Beschreibungen.
Create a 10-second photorealistic live-action scene in three shots, with hard cuts at 3s and 7s. Exactly three adults, two parked motorcycles and two helmets.

References define appearance only; replace their studio lighting and backgrounds:
@Image 1: one Korean woman, black ponytail, red-and-black racing suit.
@Image 2: one European-American man, short brown hair, yellow-and-black racing suit.
@Image 3: one middle-aged European-American mechanic, salt-and-pepper hair and stubble, navy coveralls.
Each character reference is a three-view sheet of ONE person.
@Image 4: red faired sportbike, angular split headlights.
@Image 5: blue naked roadster, round headlight, exposed engine.
@Image 6: red-and-black helmet, passed from mechanic to woman.
@Image 7: white helmet, held by the male racer throughout.
Preserve faces, outfits, object designs and colors across cuts.

Setting: a working pit garage on an overcast afternoon. Soft neutral daylight enters from camera-right; worn concrete walls, rear workbench and cabinets, dry matte floor. Natural skin, subdued leather reflections, no glossy skin or amber wash. Keep lighting and environment consistent.

0-3s, steady eye-level wide: woman left beside the red bike, mechanic center holding the red-and-black helmet, male racer right beside the blue bike holding the white helmet. Show full bodies and both bikes. Mechanic begins offering his helmet to the woman.

3-7s, steady medium two-shot from the same side of the action axis: woman left, mechanic right, faces and hands visible. She takes the red-and-black helmet with both hands; he releases it and withdraws empty hands. Show clear contact and release without fused fingers or duplicated objects.

7-10s, return to the wide: woman holds her received helmet and steps toward the red bike; male racer keeps his white helmet and steps toward the blue bike. Mechanic stays between them, hands empty. Bikes remain on stands; nobody mounts or puts on a helmet.

Maintain identities, screen direction, object ownership, grounded movement and natural occlusion. Audio: continuous quiet garage ambience, footsteps and helmet handling. No dialogue, music, extra cuts, slow motion, duplicated people or objects, text, logos or watermarks.
Generierungsgeschwindigkeit
| Szenario | Modell | Dauer | Vom Absenden bis zum beobachteten Abschluss |
|---|---|---|---|
| Motorrad-Kurvenlage & Verfolgungsfahrt | Flash | 8 Sek. | 82,658 Sek. |
| Motorrad-Kurvenlage & Verfolgungsfahrt | Seedance 2.5 | 8 Sek. | 200,842 Sek. |
| Durchgehender Kampf | Flash | 8 Sek. | 82,400 Sek. |
| Durchgehender Kampf | Seedance 2.5 | 8 Sek. | 197,657 Sek. |
| Schauspiel & englischer Satz | Flash | 8 Sek. | 87,419 Sek. |
| Schlüsselübergabe zwischen zwei Personen | Flash | 8 Sek. | 89,368 Sek. |
| Kleine Bewegung auf Basis eines Startbilds | Flash | 8 Sek. | 83,066 Sek. |
| Sieben Referenzbilder & Übergabe in drei Einstellungen | Flash | 10 Sek. | 124,013 Sek. |
Bei den ersten fünf 8-sekündigen Flash-Videos dauerte es vom Absenden des Auftrags bis zum beobachteten Abschluss rund 82 bis 89 Sekunden; die beiden 8-sekündigen Videos der Standardversion benötigten rund 201 bzw. 198 Sekunden. Das 10-sekündige Video mit mehreren Referenzbildern benötigte rund 124 Sekunden; da sich Eingabematerial und Dauer unterscheiden, wird es hier separat aufgeführt und nicht direkt mit den vorangegangenen 8-Sekunden-Clips verrechnet. Wenn im Arbeitsalltag Prompts wiederholt angepasst, Musterclips in mehreren Durchläufen generiert und Storyboard-Varianten verglichen werden müssen, beschleunigt eine Zeitersparnis von über einer Minute pro Generierung das Ausprobieren und Vorauswählen in der Frühphase spürbar.
Dabei ist zu beachten, dass diese Aufträge zwar über dasselbe Konto eingereicht wurden, die Tests der beiden Versionen jedoch zu unterschiedlichen Zeiten stattfanden und pro Szenario keine Mehrfachgenerierungen zur Ermittlung eines Durchschnittswerts durchgeführt wurden. Die erfassten Zeiten enthalten Netzwerkschwankungen, serverseitige Warteschlangen sowie die Beobachtungsverzögerung durch das Abfrageskript, das den Status alle fünf Sekunden prüfte. Daher spiegeln diese Daten lediglich wider, dass die tatsächliche Wartezeit bei Flash in dieser Testrunde kürzer war, lassen sich aber nicht direkt in einen festen Geschwindigkeitsvorteil des Modells umrechnen.
Wann sich Flash lohnt und wann die Standardversion die bessere Wahl ist
Stehen dynamische Szenen und Action im Mittelpunkt der kreativen Arbeit, bleibt die Standardversion von Seedance 2.5 nach den Ergebnissen dieser Testrunde die sicherere Wahl. In den beiden Bewegungsvergleichen entsprach die Darstellung der Standardversion in Bezug auf vollständige Bewegungsabläufe, Trefferreaktionen des Körpers und räumliche Positionswechsel deutlicher den Anforderungen solcher Einstellungen.
Geht es in der aktuellen Projektphase hingegen vor allem darum, Szenen schnell anzutesten, Bildkompositionen festzulegen, Prompt-Formulierungen auszuloten oder bei begrenztem Budget alltägliche Einstellungen in größerer Zahl voranzutreiben, bieten die kürzere Wartezeit und der niedrigere Stückpreis von Flash einen hohen praktischen Nutzen. Das Modell liefert ebenfalls Clips mit ansprechender Bildwirkung, allerdings muss man bei der Auswahl anhand der Storyboard-Vorgaben genau auf Bildbeschnitt, Bewegungsübergänge und feine Interaktionsdetails achten.
Insgesamt zeigt sich, dass Flash in den beiden dynamischen Tests dieser Runde bei der Bewegungsdarstellung noch nicht ganz zur Standardversion von Seedance 2.5 aufschließt, die bei Bewegungsvollständigkeit und Wucht weiterhin vorn liegt. Die Rolle von Flash besteht vielmehr darin, bei brauchbarer Qualität die Wartezeit zu verkürzen und die Abrufkosten zu senken, um Kreativen in der Frühphase häufiges Ausprobieren und schnelles Produzieren zu erleichtern. Für die Bereiche Schauspiel und Dialog, Detailinteraktion, räumliches Verständnis sowie Einstellungs-Konsistenz mit mehreren Referenzbildern wurden in dieser Runde ausschließlich Flash-Testbeispiele generiert; sie zeigen die praktische Leistung und die Prüfpunkte des Modells bei diesen Aufgaben, ohne die beiden Versionen in diesen Disziplinen gegeneinander zu werten.