Qu'est-ce que le modèle Seedance 2.5 Flash ?
Seedance 2.5 Flash est la déclinaison orientée rapidité de génération de la gamme de modèles vidéo Seedance 2.5 de ByteDance. Cette série de tests évalue séparément le rendu du mouvement, le jeu d'acteur, les interactions de précision, la compréhension spatiale ainsi que la cohérence entre les plans à partir d'images de référence multiples, afin de mesurer ses capacités sur des tâches de création courantes. Au vu de cet échantillon de vidéos, Seedance 2.5 Flash offre un bon compromis entre efficacité de production et coût d'utilisation, ce qui en fait un modèle principal adapté aux créateurs pour faire avancer leurs projets au quotidien et présélectionner leurs plans.
Dans les deux comparaisons directes réalisées lors de cette session, Seedance 2.5 Flash livre ses résultats plus vite que la version standard tout en offrant une qualité d'image exploitable. Toutefois, sur des plans à forte amplitude de mouvement — prise d'angle à moto, réactions aux impacts, balayages ou chutes au sol —, il reste légèrement en retrait par rapport à la version standard de Seedance 2.5 en matière de complétude du geste, de sensation d'impact et d'exécution de consignes d'action complexes.
Différences de caractéristiques entre Flash et les deux autres modèles
Le tableau ci-dessous a été établi d'après la documentation officielle vérifiée le 16 novembre 2026 et présente les limites maximales de chaque modèle. Lors de nos essais, les cinq premiers tests sur Flash ainsi que les deux vidéos comparatives sur la version standard durent tous 8 secondes, tandis que le cas à références multiples dure 10 secondes, le tout configuré en 720p. Il s'agit uniquement des paramètres retenus pour ce test pratique, et non des seules spécifications que les modèles peuvent produire.
| Paramètre | Seedance 2.5 Flash | Seedance 2.5 | Seedance 2.0 |
|---|---|---|---|
| Résolution de sortie | 480p, 720p | 480p, 720p, 1080p | 480p, 720p, 1080p, 4K |
| Durée par génération | 4–30 s | 4–30 s | 4–15 s |
| Limite d'images de référence multimodales | 10 images | 30 images | 9 images |
| Limite de vidéos de référence multimodales | 5 extraits | 10 extraits | 3 extraits |
| Limite d'audios de référence multimodaux | 5 extraits | 10 extraits | 3 extraits |
| Mode brouillon (Draft) | Non pris en charge | Pris en charge | Non pris en charge |
Flash prend en charge une sortie allant jusqu'à 720p, avec une option inférieure en 480p. Par rapport à Seedance 2.5, son plafond d'images de référence passe de 30 à 10 images, et ses limites de vidéos et d'audios de référence diminuent chacune de 10 à 5 extraits. Si un projet nécessite d'importer un grand volume de ressources de référence ou exige une livraison directe en 1080p natif, ces écarts de caractéristiques pèseront directement sur le choix du modèle.
Les plafonds de références indiqués dans le tableau concernent les tâches de référence multimodale, et non le nombre de fichiers envoyés pour la génération vidéo à partir d'une première image. Une tâche basée sur la première image n'accepte qu'une seule image en entrée, tandis qu'une tâche à première et dernière images reçoit respectivement l'image de début et l'image de fin. Ces plafonds proviennent tous des spécifications officielles ; notre test à références multiples utilise sept images de référence, sans tester la limite maximale de dix images ni les autres paliers de résolution.
Comparaison des tarifs officiels de génération vidéo
Les tarifs ci-dessous se basent sur la grille tarifaire officielle en chinois de Volcano Engine Ark pour l'inférence en ligne, vérifiée le 16 novembre 2026, sur la base d'une facturation en 720p au format 16:9 et sans vidéo fournie en entrée. Les tests réalisés ici — texte vers vidéo, première image vers vidéo et images de référence multiples vers vidéo — n'utilisent aucune vidéo de référence en entrée.
| Modèle | Tarif unitaire officiel | Prix par seconde converti selon l'exemple officiel | Budget indicatif pour 8 s | Budget indicatif pour 10 s |
|---|---|---|---|---|
| Seedance 2.5 Flash | 46 CNY / million de tokens | env. 0,99 CNY | env. 7,9 CNY | env. 9,9 CNY |
| Seedance 2.5 | 70 CNY / million de tokens | env. 1,51 CNY | env. 12,1 CNY | env. 15,1 CNY |
| Seedance 2.0 | 46 CNY / million de tokens | env. 0,99 CNY | env. 7,9 CNY | env. 9,9 CNY |
À conditions identiques, le prix officiel par token de Flash est inférieur d'environ 34 % à celui de Seedance 2.5, et se situe au même niveau que Seedance 2.0. Seedance 2.0 figure uniquement ici à titre de repère technique et tarifaire ; aucun extrait de test n'a été généré avec ce modèle lors de cette session. Les budgets pour 8 et 10 secondes indiqués dans le tableau sont des estimations calculées à partir du prix par seconde donné en exemple sur le site officiel, afin de faciliter la comparaison. Le montant réellement débité dépend du tarif unitaire par token et de la consommation effective figurant sur la facture officielle ; les chiffres présentés ici ne correspondent pas aux dépenses réelles engagées pour cette série d'extraits.
Résultats pratiques par catégorie de capacité
Ce protocole évalue cinq grandes capacités de génération à travers six scénarios, réunissant six extraits produits avec Flash et deux extraits comparatifs produits avec la version standard de Seedance 2.5. La prise d'angle à moto et le combat continu relèvent du rendu du mouvement et font l'objet d'une comparaison entre les deux versions ; les quatre autres exercices testent uniquement le comportement de Flash. Les sept premières vidéos durent 8 secondes, tandis que le cas à références multiples dure 10 secondes et s'articule en trois plans.
| Catégorie de capacité | Scénario testé | Durée | Comportement principal de Flash | Comparaison Seedance 2.5 |
|---|---|---|---|---|
| Dynamique et maîtrise de la caméra | Prise d'angle à moto et suivi | 8 s | Bonne sensation de vitesse, mais le cadrage trop serré tronque l'action complète du virage | Le passage de la mise sur l'angle au point de corde puis au redressement est plus complet |
| Dynamique et maîtrise de la caméra | Combat continu | 8 s | Génère des échanges continus d'attaques et de défenses, mais certaines transitions et la sensation d'impact manquent de vigueur | Les rotations du buste, les réactions physiques et les déplacements en profondeur sont plus naturels |
| Jeu d'acteur et dialogue | Lecture d'une lettre, regard levé et réplique en anglais | 8 s | Restitue la transition de la lecture au sourire ; la réplique et la synchronisation labiale n'ont pas été vérifiées séparément | Non testé |
| Interaction de précision | Remise d'une clé entre deux personnes | 8 s | Le passage de la clé est lisible, mais le profil d'un personnage dévie de la consigne et le contact des doigts demande un examen attentif | Non testé |
| Compréhension spatiale | Rotation d'une tasse sur un bureau | 8 s | La disposition générale est préservée, l'angle de rotation exact de la tasse reste à confirmer et la caméra avance légèrement | Non testé |
| Références multiples et cohérence des plans | Sept images de référence pour une remise de casque en trois plans | 10 s | D'un plan à l'autre, l'attribution des personnages, des motos et des casques reste globalement cohérente | Non testé |
La suite de l'article présente les vidéos brutes et leurs prompts par catégorie de capacité. Les temps d'attente précis de chaque génération sont regroupés dans le tableau de vitesse en fin d'article.
Dynamique et maîtrise de la caméra
Cette section s'appuie sur deux scènes — une prise de virage à moto et un combat à mains nues entre deux personnes — pour observer l'enchaînement des gestes, les transferts de poids, les trajectoires ainsi que la capacité de la caméra à rendre l'action lisible. Les deux modèles utilisent strictement les mêmes prompts en anglais et les mêmes paramètres de génération.
Prise d'angle à moto et suivi
Les exigences du prompt sont identiques pour les deux versions : un pilote au guidon d'une moto rouge négocie une longue courbe, suivi par une caméra basse placée de trois-quarts avant ; après le point de corde, la moto se redresse progressivement, et l'intégralité de la machine ainsi que ses deux roues doivent rester visibles à l'image d'un bout à l'autre.
Seedance 2.5 Flash
8 s · 720p · Audio natif · De l'envoi au constat de fin : 82,7 s
Seedance 2.5
8 s · 720p · Audio natif · De l'envoi au constat de fin : 200,8 s
Flash ressemble davantage à un gros plan de course
Dans l'image générée par Flash, le carénage avant rouge, le bitume mouillé, les reflets des projecteurs et le brouillard d'eau soulevé par le pneu arrière sont bien nets. L'arrière-plan défile rapidement et le suivi au plus près de l'avant de la moto procure une vraie sensation de vitesse. En revanche, le cadrage est trop serré : la tête du pilote, le haut de son buste et une partie du carénage sortent du champ, et les roues avant et arrière ne restent pas intégralement visibles comme le demandait le prompt. Même si l'inclinaison de la machine est perceptible, la composition trop étroite empêche de bien voir comment le pilote et sa moto travaillent ensemble dans la courbe.
Si le montage final a justement besoin d'insérer un plan serré dynamique sur une partie de la moto, ce rush peut convenir ; mais si le découpage exige de montrer clairement toute la phase de prise d'angle, ou d'enchaîner après un plan exposant la trajectoire sur la piste, ce cadrage qui coupe une partie du pilote et de la machine n'est pas adapté.
La version standard restitue le virage de façon plus complète
La version standard conserve la silhouette du pilote et l'ensemble de la moto à l'intérieur du cadre. En suivant la chronologie du plan, la moto s'incline dans le virage, se rapproche du point de corde, puis réduit progressivement son angle avant de se redresser ; grâce au repère du vibreur intérieur par rapport à la machine, la trajectoire suivie sur la piste se lit très clairement.
Cette fluidité tient à la cohérence entre l'assiette de la moto, le placement du centre de gravité du pilote, la trajectoire en courbe et la distance de caméra. Par rapport au cadrage très serré de Flash, la version standard montre bien mieux la transition entre l'inscription en courbe et le redressement progressif, offrant ainsi une meilleure prestation dynamique sur cette scène.
Cela dit, l'angle de suivi de trois-quarts avant et la valeur de plan évoluent aussi en cours de route sur la version standard. Sur la seule base d'images échantillonnées, il n'est pas possible de confirmer qu'à chaque instant le contact des pneus avec le sol et la géométrie de la moto sont parfaitement exacts. Ce comparatif montre que la version standard restitue plus complètement le déroulé du mouvement et la trajectoire, sans pour autant garantir l'exactitude absolue de tous les détails physiques.
Prompt complet en anglais utilisé pour le test de la moto
One continuous 8-second cinematic live-action shot on a closed motorcycle racing circuit just after rain, at blue hour. A single adult professional racer in black protective leathers and a full-face helmet rides one unbranded red sport motorcycle through a sweeping right-hand bend. A low front three-quarter tracking camera follows alongside at matching speed, keeping the whole motorcycle and both wheels visible. The racer leans naturally into the corner, reaches the apex, then gradually brings the bike upright toward the exit. Both tires remain on the wet asphalt. Track barriers and floodlights move past in the background, with a fine spray of water trailing the rear tire. Physically plausible rider anatomy and motorcycle geometry, consistent red bodywork, realistic film texture. Sound: one motorcycle engine rising smoothly and wet tire hiss. No dialogue, no music, no cuts, no text, no subtitles, no logos.
Combat continu à deux personnages
Ce scénario de combat demande aux deux modèles de lancer l'affrontement dès la première image : enchaînement de coups de poing, esquive et blocage, riposte par un puissant coup de pied au corps, puis réduction de la distance pour poursuivre, balayage bas et chute contrôlée suivie d'une roulade au sol. Pour distinguer clairement les protagonistes dans la vitesse de l'échange, le prompt attribue à l'un une veste grise et un pantalon noir, et à l'autre une veste bleu marine foncé et un pantalon beige.
Seedance 2.5 Flash
8 s · 720p · Audio natif · De l'envoi au constat de fin : 82,4 s
Seedance 2.5
8 s · 720p · Audio natif · De l'envoi au constat de fin : 197,7 s
Flash multiplie les enchaînements mais manque d'impact
Flash parvient bien à générer la série de coups de poing, les blocages, le coup de pied, le balayage bas ainsi que la chute avec roulade. Mais en observant de plus près, certains échanges donnent l'impression de réciter les mouvements les uns après les autres : la réaction à l'impact après un coup de poing ou de pied et la transition vers l'action suivante manquent légèrement d'ancrage. Les deux combattants se déplacent essentiellement sur un axe horizontal gauche-droite, sans véritable variation de profondeur entre eux et la caméra.
Par ailleurs, des bandes noires ont été ajoutées automatiquement en haut et en bas de l'image, et les pieds sont coupés durant la première moitié de la séquence. Si l'on souhaite analyser les appuis, le jeu de jambes et la prise d'élan pendant le combat, cette coupure au niveau des pieds gêne l'évaluation.
L'engagement physique et les déplacements sont plus naturels sur la version standard
Dans la version standard, les coups de poing s'accompagnent d'un engagement visible des épaules, du dos et d'une rotation de la taille ; les esquives, le coup de pied de riposte et les pas de recul mobilisent tout le corps. Après s'être écartés, les deux adversaires réduisent à nouveau la distance pour enchaîner naturellement sur l'attaque basse et la roulade au sol. La caméra ajuste sa position au fil de l'échange, faisant varier en continu l'orientation et la distance des combattants : l'affrontement s'inscrit dans un espace doté d'une vraie profondeur, où les positions relatives d'avant en arrière restent bien lisibles.
Cet extrait restitue avec davantage de continuité l'enchaînement entre la prise d'appui, la parade et la poursuite. Comparés à Flash, les coups de la version standard paraissent plus lourds et les liaisons plus serrées, ce qui lui confère un meilleur rendu dynamique sur cette scène.
La version standard ne garde pas non plus les pieds des deux combattants dans le cadre sur toute la durée. Quant à savoir si chaque point de contact est crédible, si la combinaison comporte strictement les trois coups de poing exigés par le prompt et si chaque transfert d'appui est juste, cela demande un visionnage attentif de la vidéo. Une image à l'aspect plus cinématographique ne signifie pas que la chorégraphie est irréprochable, ni que chaque consigne d'action du prompt a été exécutée à la lettre.
Prompt complet en anglais utilisé pour le test de combat
An explosive 8-second live-action martial-arts fight scene, fast real-time Hong Kong action-film choreography, one continuous shot. Two adult fighters in a gritty concrete parking garage: one in a light grey jacket and black trousers, the other in a dark navy jacket and tan trousers. They are already fighting in the opening frame. The grey fighter surges forward with a rapid three-punch combination; the navy fighter slips the first punch, blocks the next and drives back with a forceful body kick. The grey fighter staggers two steps, immediately closes the distance, ducks a swinging counterpunch and sweeps the navy fighter's leg. The navy fighter hits the floor in a controlled stunt fall and rolls away as the grey fighter pursues. Relentless attack-and-counterattack momentum throughout, short transitions, sharp acceleration, convincing physical impact reactions, forceful torso rotation, realistic weight and balance, clear changes of position across the floor. The camera tracks rapidly beside them at waist height in a medium-wide action framing, keeping both whole bodies and the floor under their feet visible, with subtle handheld vibration at impacts. Crisp readable action, restrained motion blur, hard overhead light, cinematic contrast, realistic anatomy and clothing, distinct stable identities. Audio: rapid footfalls, forceful punch and kick impacts, clothing snaps, heavy breathing and a solid floor impact. No slow motion, no standing around, no pauses to reset, no dialogue, no music, no text, no subtitles, no cuts, no blood, no gore, no weapons.
Jeu d'acteur et dialogue
Cette scène demande au personnage de lire d'abord une lettre la tête baissée, puis de lever les yeux, de prononcer en anglais la phrase « You kept the letter. » (Tu as gardé la lettre), avant d'esquisser un sourire pendant quelques instants. Le prompt précise que la réplique doit être dite entre la 4e et la 6e seconde, en plan fixe.
D'après les images extraites du clip, le personnage passe bien de la lecture tête baissée à un regard levé accompagné d'un sourire, et son visage, sa veste ainsi que la feuille de papier entre ses mains restent clairement identifiables à chaque instant. Ce type de jeu tout en retenue, sans mouvement brusque susceptible de perturber l'image, se prête bien à l'observation directe des expressions faciales et des transitions émotionnelles.
Pour évaluer un plan de jeu incluant du dialogue, l'image et le son doivent être vérifiés séparément. La présence d'une piste audio dans la vidéo ne garantit pas que la prononciation et le mouvement des lèvres correspondent exactement. Lors de l'examen de la vidéo brute, il faut encore vérifier si la phrase en anglais est articulée distinctement, si des voix parasites s'y mêlent, si la prise de parole intervient bien entre la 4e et la 6e seconde comme demandé, et si le mouvement de la bouche concorde. Sur la seule base de captures fixes, nous n'avons pas vérifié de manière indépendante lors de cette session l'exactitude mot à mot de la réplique ni la précision de la synchronisation labiale.
Prompt en anglais utilisé pour le jeu d'acteur
One continuous 8-second medium close-up in a quiet train carriage, naturalistic live-action cinematography. An adult woman in a plain navy jacket holds one opened letter below her face. 0-2 seconds: she reads it silently, with a thoughtful expression. 2-4 seconds: she takes a small breath and lifts her eyes toward a person just beside the camera. 4-6 seconds: with a restrained, tender smile she says clearly in English, 'You kept the letter.' 6-8 seconds: she holds the eye contact and the quiet smile. Keep her mouth fully visible and her face, clothing and letter consistent. The camera stays still. Audio: her single spoken line over soft carriage rumble. No other voices, no music, no captions, no readable writing, no subtitles, no cuts.
Interaction de précision
Dans cette scène, une personne doit déposer une petite clé en laiton dans la paume ouverte d'une autre personne, desserrer les doigts, puis retirer sa main vide. La remise d'un petit accessoire rigide de ce genre constitue un bon test pour la génération des mains : lorsque les deux mains se rapprochent et se superposent, les gestes consistant à tenir puis à relâcher la clé doivent rester parfaitement lisibles.
Sur les images échantillonnées au moment de l'échange, la main qui tend la clé s'avance vers la paume ouverte, dépose l'objet puis se retire, tandis que le receveur referme ensuite les doigts. La planche ci-dessous propose un recadrage serré sur l'instant du passage, à raison de deux images par seconde, afin de mieux observer le contact entre le bout des doigts et la clé.
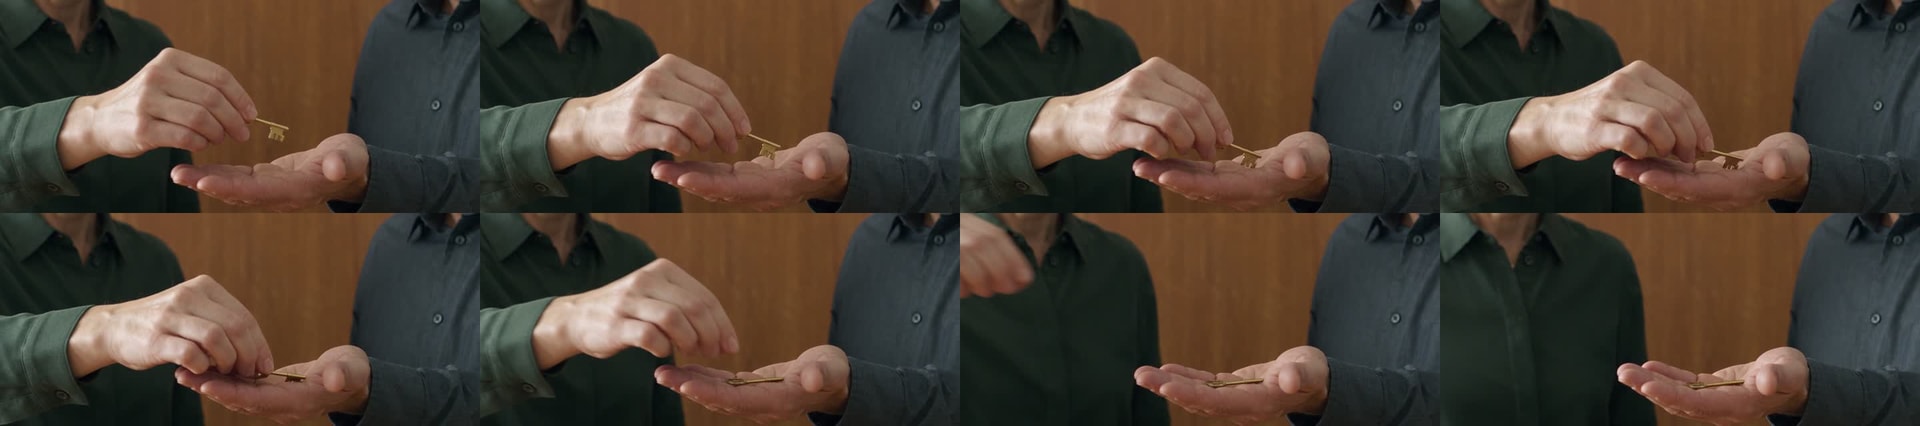
L'examen d'une telle interaction rapprochée nécessite généralement de contrôler plusieurs points précis : les doigts qui tiennent la clé s'ouvrent-ils naturellement au moment de la lâcher, le bout des doigts fusionne-t-il ou devient-il flou au contact de la clé ou de la paume adverse, la structure articulaire du pouce et des autres doigts reste-t-elle normale, et la clé demeure-t-elle un objet unique d'un bout à l'autre ? Ces détails exigent une lecture image par image de la vidéo ; une anatomie correcte de la paume sur la première image n'exclut pas l'apparition d'erreurs lorsque les deux mains se croisent.
En outre, cet extrait présente un écart manifeste concernant le profil des personnages. Le prompt demandait explicitement qu'une femme placée à gauche de l'image tende la clé, mais la personne générée qui remet l'objet apparaît sous les traits d'un homme. Ainsi, bien que cet extrait permette d'étudier le geste de passage de main à main, il ne respecte pas la distribution des rôles demandée. Le fait que l'accessoire ait bien été transmis ne signifie pas que toutes les instructions du prompt ont été suivies, et quelques images extraites ne suffisent pas non plus à affirmer que la géométrie de contact des doigts est irréprochable.
Prompt en anglais utilisé pour le test de remise de la clé
One continuous 8-second live-action shot, a fixed waist-up two-shot of two adults at a wooden counter, with both people's hands clearly visible throughout. The woman on the left wears a dark green shirt. The man on the right wears a charcoal shirt. 0-2 seconds: the woman holds exactly one small brass key between the fingers of her right hand; the man presents his empty open left palm. 2-5 seconds: she moves that key into his left palm and releases it. 5-8 seconds: she withdraws her visibly empty right hand, and he closes his fingers around the received key. Maintain one key, two people and continuous natural hand movements. Show the actual contact and release clearly, with realistic anatomy and steady framing. Soft side lighting, believable skin and wood textures. Audio: quiet room tone and a small metallic click during the transfer. No speech, no music, no text, no subtitles, no cuts.
Compréhension spatiale
Ce test utilise en entrée une première image fixe originale, dépourvue de texte. Le personnage, le mug bleu, le carnet fermé, le bureau et l'arrière-plan de la pièce sont tous déjà définis dans cette image initiale. L'action demandée par le prompt est très mesurée : la femme baisse les yeux, tend la main pour faire pivoter le mug d'un quart de tour sur le plateau du bureau (sans que le fond de la tasse ne quitte la surface), puis lâche l'anse et tourne la tête vers la fenêtre.
Au-delà du maintien de l'apparence du personnage, ce plan évalue surtout la compréhension qu'a le modèle des relations spatiales sur le bureau : la main se dirige-t-elle vers l'anse selon un axe crédible, la base du mug reste-t-elle bien plaquée contre le bureau pendant la rotation, les positions relatives du carnet, de la tasse et du plateau demeurent-elles stables, et l'occultation avant/arrière lors de la prise puis du relâchement de l'anse est-elle gérée correctement, sans interpénétration de matière ?
Au vu des images extraites, l'agencement général du bureau reste stable : on distingue bien le mouvement de la main qui s'approche de la tasse avant de se retirer, et le carnet demeure à sa place sur la droite. Toutefois, bien que l'orientation de l'anse évolue en cours de geste, elle semble revenir près de sa position initiale dans la seconde moitié du plan ; à partir de ce seul échantillon d'images, il est difficile de confirmer si la tasse a réellement effectué un quart de tour complet et conservé son nouvel angle. Par ailleurs, alors que le prompt exigeait une caméra verrouillée, l'image générée montre tout de même un léger mouvement d'approche.
Pour évaluer ce type de génération vidéo à partir d'une première image, outre la fidélité des traits du personnage, l'essentiel est de vérifier si la position des objets existants et leur hiérarchie de profondeur sont maintenues lorsque la main entre en contact avec un objet rigide posé sur une table. Pour contrôler le contact des doigts, les occultations et le déplacement de l'objet, il est conseillé de comparer côte à côte l'image initiale et la vidéo générée.
Prompt en anglais utilisé pour le test de rotation de la tasse
Continue the supplied first frame as one steady 8-second live-action shot. Preserve this exact adult woman's appearance, navy shirt, desk, single blue mug, closed tan notebook, background and window lighting. 0-2 seconds: she briefly glances down toward the blue mug. 2-5 seconds: she gently takes the mug handle with her right hand and rotates the mug a quarter turn on the tabletop without lifting it. 5-8 seconds: she releases the mug, rests her right hand beside it, and looks back toward the window. The mug stays on the desk and remains one rigid ceramic object, and the closed notebook remains fixed throughout. Keep the camera locked with no cut or zoom. Audio: quiet indoor ambience and a soft ceramic scrape during the turn. No speech, no music, no text, no subtitles.
Références multiples et cohérence des plans
Ce test porte la durée à 10 secondes et mobilise sept images de référence pour générer une séquence composée de trois plans. Les personnages sont une pilote coréenne, un pilote occidental et un mécanicien occidental d'âge mûr, chacun défini par une planche personnage à trois vues ; s'y ajoutent deux motos au design bien distinct, ainsi que deux casques, l'un rouge et noir, l'autre blanc.
Les images de référence servent uniquement à fixer les visages, les tenues et l'apparence des objets. Aucune image de décor ni esquisse de storyboard n'a été fournie : l'environnement du stand, l'éclairage et les changements de plans sont entièrement pilotés par le texte, qui décrit un après-midi couvert où une lumière naturelle douce pénètre par la porte du garage sur un sol sec, en limitant les reflets trop marqués sur la peau et les combinaisons en cuir.
Images de référence utilisées pour ce test
| Élément de référence | Image | Correspondance dans la scène |
|---|---|---|
| 1 · Planche 3 vues de la pilote | 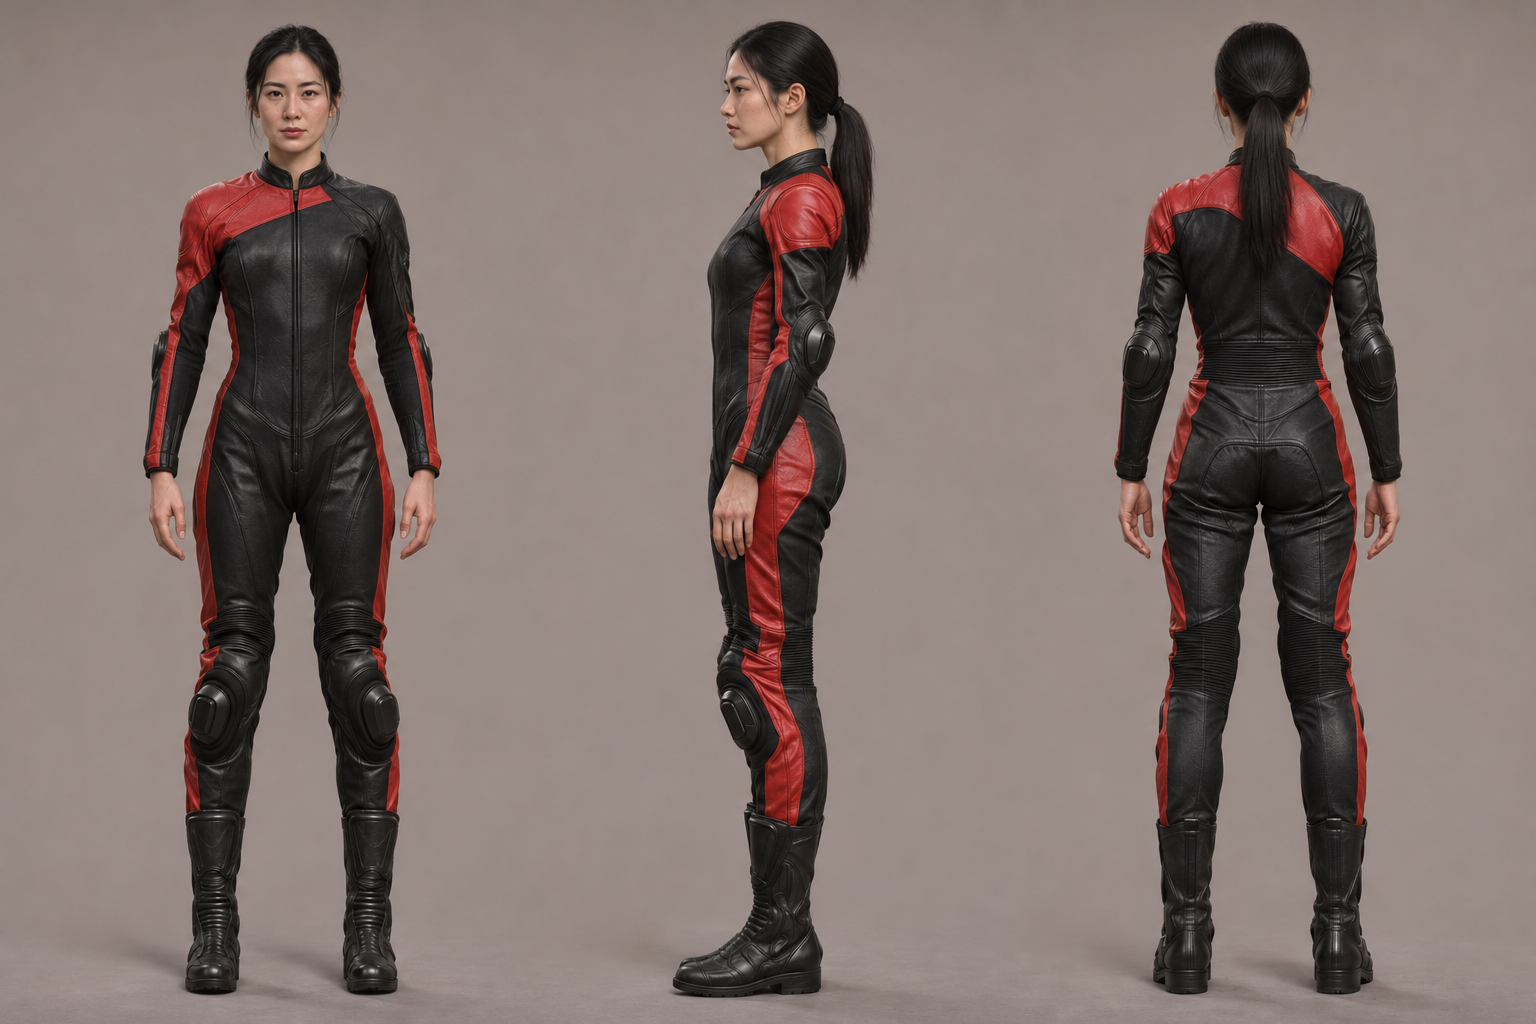 | Combinaison rouge et noire, reçoit le casque rouge et noir |
| 2 · Planche 3 vues du pilote | 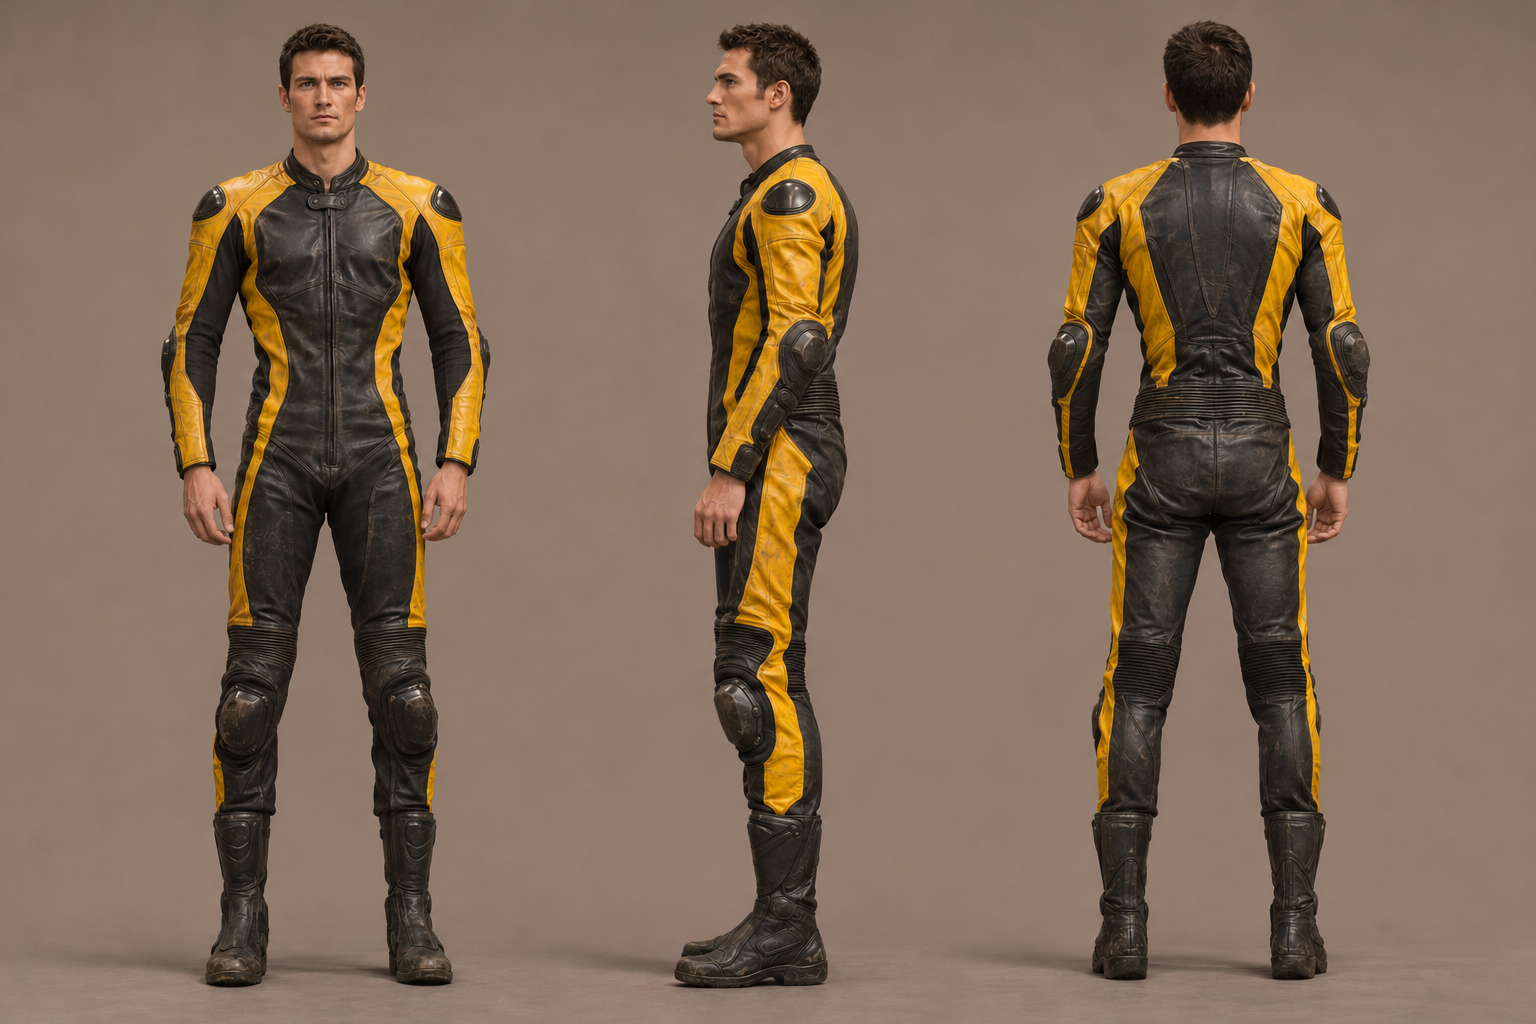 | Combinaison jaune et noire, garde le casque blanc tout du long |
| 3 · Planche 3 vues du mécanicien | 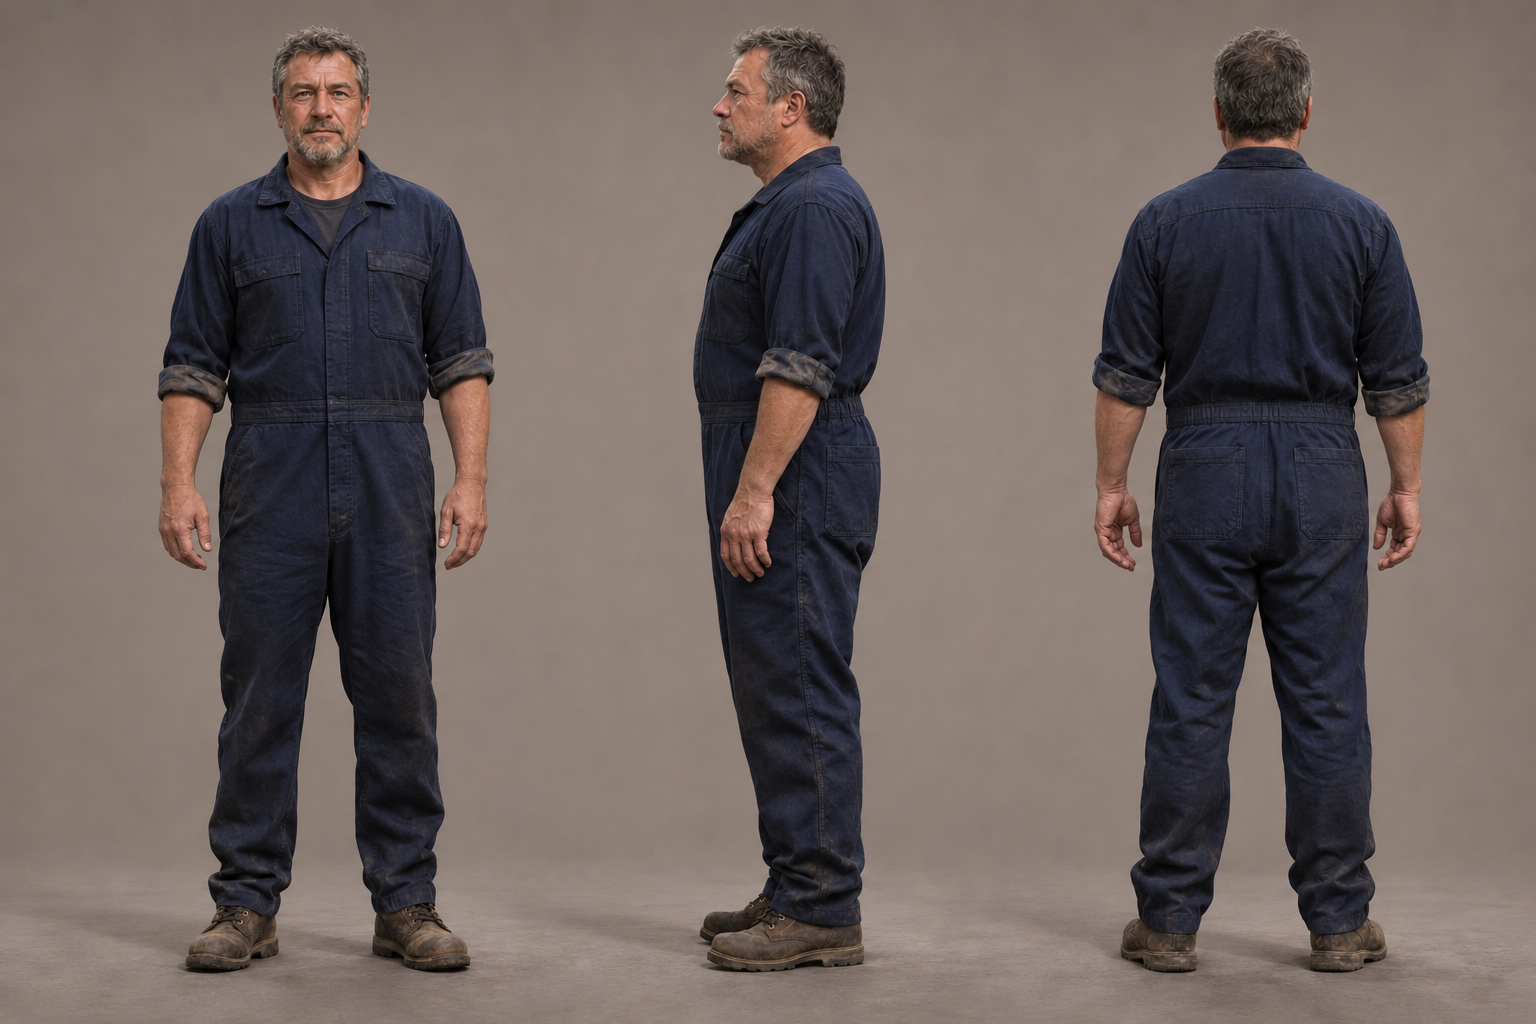 | Combinaison de travail bleu marine, tend le casque puis retire ses mains vides |
| 4 · Moto rouge |  | Conserve son carénage intégral et ses doubles optiques anguleuses |
| 5 · Moto bleue | 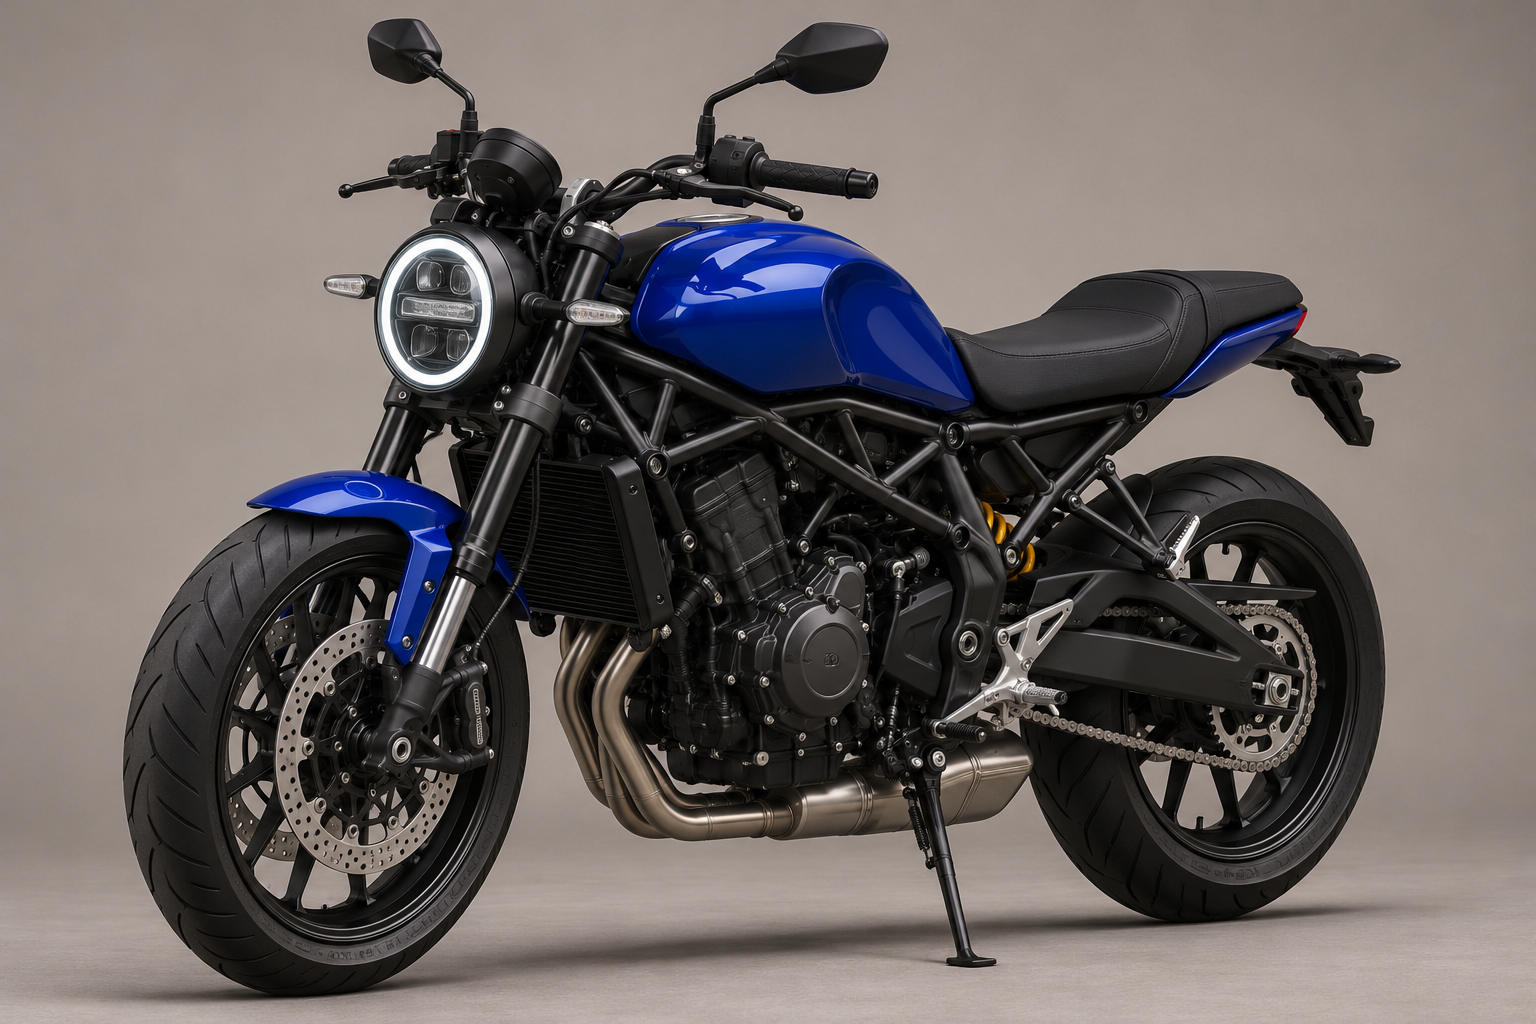 | Conserve son phare rond et son moteur apparent |
| 6 · Casque rouge et noir | 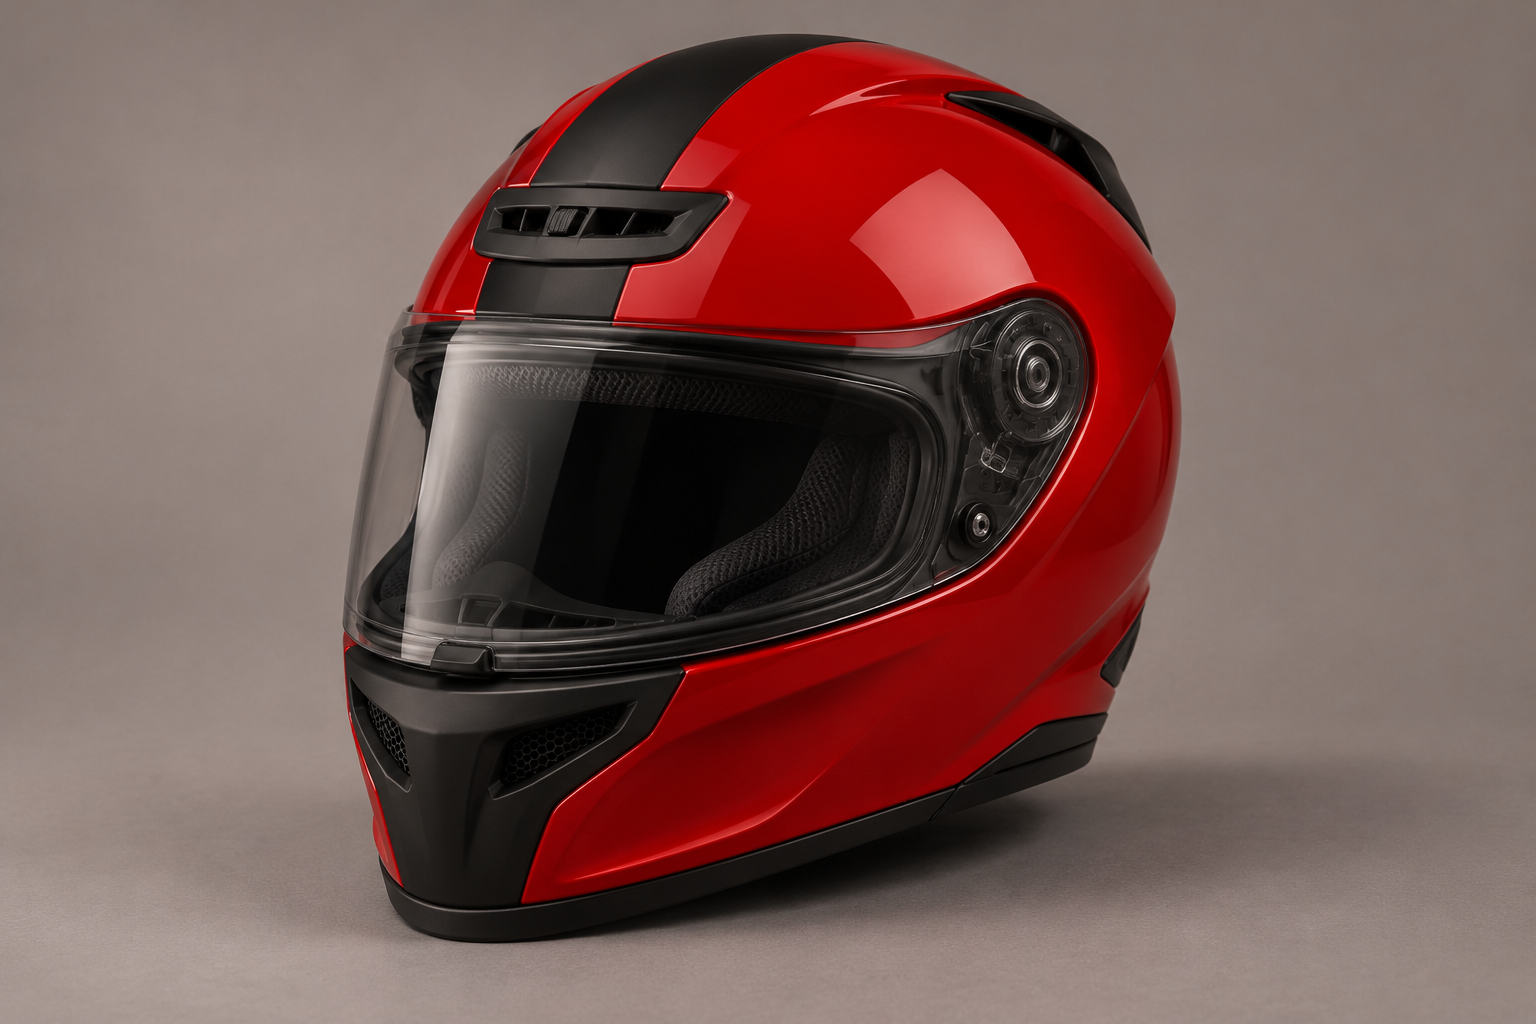 | Passe des mains du mécanicien à celles de la pilote |
| 7 · Casque blanc | 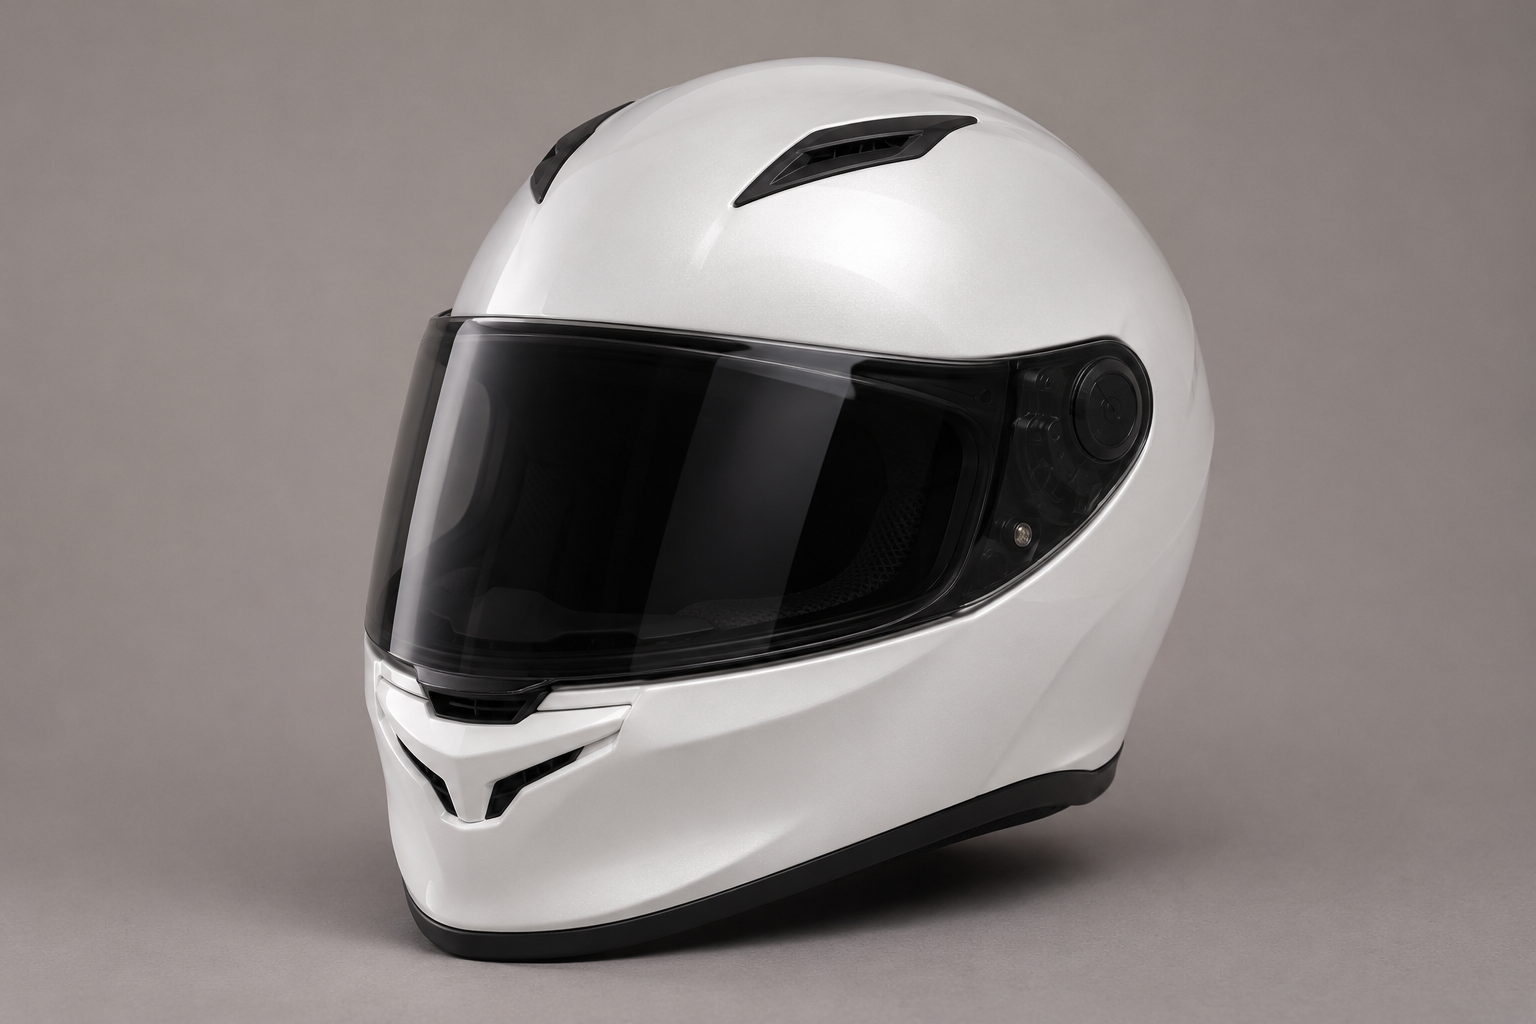 | Tenu par le pilote masculin |
Découpage des plans
| Intervalle | Plan |
|---|---|
| 0–3 s | Plan large exposant la position des trois personnages et des deux motos |
| 3–7 s | Plan moyen montrant clairement la remise du casque |
| 7–10 s | Retour au plan large, les deux pilotes se dirigent chacun vers leur moto |
10 s · 720p · Audio natif · De l'envoi au constat de fin : env. 124 s
Après les changements de plans, les personnages et les objets restent globalement cohérents
Cet extrait préserve dans l'ensemble la cohérence des éléments définis malgré plusieurs coupures franches. Lorsque la caméra passe du plan large au plan moyen, puis revient au plan large, les visages des trois protagonistes, leurs combinaisons de course et le bleu de travail correspondent bien aux références ; la sportive rouge carénée et le roadster bleu à phare rond conservent également leur design respectif. Les trois planches à trois vues ont bien été interprétées comme trois individus distincts, sans que le modèle ne génère trois personnes à partir des trois angles d'une même planche.
L'attribution et la transmission des casques restent elles aussi continues : au départ, le mécanicien tient le casque rouge et noir ; après la coupe au plan moyen, la pilote le récupère tandis que le mécanicien ouvre les mains et les retire ; au retour en plan large, le casque rouge et noir est toujours entre les mains de la pilote, et le pilote masculin conserve son casque blanc d'un bout à l'autre. Dans une tâche à références multiples, le fait de pouvoir identifier sans ambiguïté chaque personnage et son accessoire après un changement de plan est un vrai atout pour le montage.
Les coupes interviennent dans la vidéo finale aux alentours de 3 secondes et de 6,8 secondes, respectant globalement la structure prévue (plan large, plan moyen, puis retour au plan large). L'éclairage correspond bien à la lumière du jour douce décrite dans le prompt, avec des reflets contenus sur le sol et les cuirs. En revanche, l'attitude des personnages reste un peu figée et le détail des doigts lors de la prise du casque demande un examen plus poussé. D'après ce que l'on peut observer ici, cet extrait maintient bien la correspondance globale des personnages et des objets à travers les trois plans. Ce scénario n'a été testé qu'avec Flash, sans contrepartie sur la version standard.
Prompt en anglais du test à références multiples (version condensée)
Le texte ci-dessous conserve les correspondances avec les images de référence, le découpage en trois plans et les principales contraintes du test original, en omettant les descriptions répétitives.
Create a 10-second photorealistic live-action scene in three shots, with hard cuts at 3s and 7s. Exactly three adults, two parked motorcycles and two helmets.

References define appearance only; replace their studio lighting and backgrounds:
@Image 1: one Korean woman, black ponytail, red-and-black racing suit.
@Image 2: one European-American man, short brown hair, yellow-and-black racing suit.
@Image 3: one middle-aged European-American mechanic, salt-and-pepper hair and stubble, navy coveralls.
Each character reference is a three-view sheet of ONE person.
@Image 4: red faired sportbike, angular split headlights.
@Image 5: blue naked roadster, round headlight, exposed engine.
@Image 6: red-and-black helmet, passed from mechanic to woman.
@Image 7: white helmet, held by the male racer throughout.
Preserve faces, outfits, object designs and colors across cuts.

Setting: a working pit garage on an overcast afternoon. Soft neutral daylight enters from camera-right; worn concrete walls, rear workbench and cabinets, dry matte floor. Natural skin, subdued leather reflections, no glossy skin or amber wash. Keep lighting and environment consistent.

0-3s, steady eye-level wide: woman left beside the red bike, mechanic center holding the red-and-black helmet, male racer right beside the blue bike holding the white helmet. Show full bodies and both bikes. Mechanic begins offering his helmet to the woman.

3-7s, steady medium two-shot from the same side of the action axis: woman left, mechanic right, faces and hands visible. She takes the red-and-black helmet with both hands; he releases it and withdraws empty hands. Show clear contact and release without fused fingers or duplicated objects.

7-10s, return to the wide: woman holds her received helmet and steps toward the red bike; male racer keeps his white helmet and steps toward the blue bike. Mechanic stays between them, hands empty. Bikes remain on stands; nobody mounts or puts on a helmet.

Maintain identities, screen direction, object ownership, grounded movement and natural occlusion. Audio: continuous quiet garage ambience, footsteps and helmet handling. No dialogue, music, extra cuts, slow motion, duplicated people or objects, text, logos or watermarks.
Vitesse de génération
| Scénario | Modèle | Durée | De l'envoi au constat de fin |
|---|---|---|---|
| Prise d'angle à moto et suivi | Flash | 8 s | 82,658 s |
| Prise d'angle à moto et suivi | Seedance 2.5 | 8 s | 200,842 s |
| Combat continu | Flash | 8 s | 82,400 s |
| Combat continu | Seedance 2.5 | 8 s | 197,657 s |
| Jeu d'acteur et réplique en anglais | Flash | 8 s | 87,419 s |
| Remise d'une clé entre deux personnes | Flash | 8 s | 89,368 s |
| Petit mouvement à partir d'une première image | Flash | 8 s | 83,066 s |
| Sept images de référence et remise en trois plans | Flash | 10 s | 124,013 s |
Pour les cinq premières vidéos de 8 secondes générées avec Flash, le délai écoulé entre l'envoi de la tâche et le constat de sa complétion se situe entre 82 et 89 secondes environ ; les deux vidéos de 8 secondes produites avec la version standard ont pris respectivement environ 201 et 198 secondes. La vidéo de 10 secondes à références multiples a demandé environ 124 secondes ; ses fichiers d'entrée et sa durée étant différents, elle est consignée à part sans être directement comparée aux extraits de 8 secondes pour calculer un écart de vitesse. Lorsque le travail quotidien implique d'ajuster régulièrement ses prompts, de lancer plusieurs séries d'essais et de comparer le rendu des plans, gagner plus d'une minute par génération accélère nettement le rythme des tests et de la sélection en phase préparatoire.
Précisons toutefois que, même si toutes ces tâches ont été soumises depuis le même compte, les tests des deux versions ont été répartis sur des créneaux horaires différents, et chaque scénario n'a pas été relancé plusieurs fois pour établir une moyenne. Les temps relevés incluent les fluctuations réseau, la file d'attente côté serveur ainsi que la latence d'observation liée au script qui interroge l'état de la tâche toutes les cinq secondes. Par conséquent, ces chiffres montrent simplement que l'attente effective a été plus courte avec Flash lors de cette session, sans pouvoir être convertis directement en un avantage de vitesse fixe du modèle.
Quand utiliser Flash et quand privilégier la version standard ?
Si vos projets reposent principalement sur des mouvements amples et des scènes d'action, les résultats de cette session montrent que la version standard de Seedance 2.5 reste un choix plus sûr. Dans nos deux comparatifs dynamiques, la version standard restitue le déroulé complet des gestes, les réactions physiques aux impacts et les déplacements dans l'espace d'une manière plus conforme aux exigences de ce type de plans.
En revanche, s'il s'agit à ce stade de tester rapidement une mise en scène, de valider un cadrage, d'affiner la rédaction de vos prompts ou de produire en série des plans courants avec un budget maîtrisé, la réduction du temps d'attente et le coût unitaire inférieur de Flash présentent un intérêt très concret. Il est tout à fait capable de produire des séquences à la texture visuelle soignée, mais la sélection des prises demandera de vérifier attentivement, storyboard en main, les éventuels recadrages intempestifs, les liaisons de mouvements et la précision des interactions rapprochées.
En résumé, sur les deux tests dynamiques de cette session, le rendu du mouvement de Flash n'égale pas encore tout à fait celui de la version standard de Seedance 2.5, qui conserve l'avantage sur la complétude des gestes et la sensation de puissance ; le positionnement de Flash consiste quant à lui à réduire le temps d'attente et le coût d'appel tout en maintenant une qualité exploitable, afin de faciliter les itérations fréquentes et la production rapide en amont. Quant au jeu d'acteur avec dialogue, aux interactions de précision, à la compréhension spatiale et à la cohérence multi-plans par références multiples, seuls des échantillons Flash ont été générés lors de cette session afin d'illustrer son comportement concret et les points à surveiller sur ces exercices, sans établir de classement entre les deux versions sur ces tâches.