Seedance 2.5 Flash 是什么模型
Seedance 2.5 Flash 是字节跳动 Seedance 2.5 系列中偏向生成速度的视频模型。这轮分别测试动态表现、人物表演、细节交互、空间理解,以及多参考图的分镜一致性,看看它在常见创作任务中能做到什么程度。从这批测试样本来看,Seedance 2.5 Flash 兼顾了出片效率与使用成本,适合作为创作者日常推进方案、筛选镜头的主力生成模型。
在本轮两组对照中,Seedance 2.5 Flash 比标准版更快拿到结果,画面质量也有可用之处。不过在摩托车压弯、人物受击、扫腿或倒地这类大幅度动态镜头中,它在动作完整度、力量感以及复杂动作指令的执行上,表现仍稍弱于 Seedance 2.5 标准版。
Flash 与另外两款模型的参数差异
下表根据 2026 年 11 月 16 日核对的官方文档整理,列出的是模型能力上限。本轮前五组 Flash 测试和两条标准版对照视频均为 8 秒,多参考图案例为 10 秒,分辨率统一设为 720p。这只是本次实测的参数设置,不代表模型只能输出这一规格。
| 参数 | Seedance 2.5 Flash | Seedance 2.5 | Seedance 2.0 |
|---|---|---|---|
| 输出分辨率 | 480p、720p | 480p、720p、1080p | 480p、720p、1080p、4K |
| 单次生成时长 | 4–30 秒 | 4–30 秒 | 4–15 秒 |
| 全模态参考图片上限 | 10 张 | 30 张 | 9 张 |
| 全模态参考视频上限 | 5 段 | 10 段 | 3 段 |
| 全模态参考音频上限 | 5 段 | 10 段 | 3 段 |
| 样片(Draft)模式 | 不支持 | 支持 | 不支持 |
Flash 最高支持 720p 输出,向下可选 480p。和 Seedance 2.5 相比,它的参考图片上限从 30 张缩减到 10 张,参考视频和音频也分别从 10 段降到 5 段。如果项目需要输入大量参考素材,或者必须直接交付 1080p 原片,这些规格差异会直接影响模型选型。
表中的参考数量上限针对的是全模态参考任务,并非首帧图生视频的上传数量。首帧任务仅输入一张图,首尾帧任务则分别输入首帧和尾帧。上述上限均来自官方说明;本轮多参考图案例使用了七张参考图,未测试十张图片的输入上限,也未测试其他分辨率档位。
生成视频的官方价格对比
以下价格参考火山方舟官方中文价目表的在线推理定价,核对日期为 2026 年 11 月 16 日,计费前提为 720p、16:9 且输入不含视频。本轮测试涵盖的文生视频、首帧图生视频和多参考图生视频,都没有输入参考视频。
| 模型 | 官方单价 | 官网示例折算每秒价格 | 8 秒视频参考预算 | 10 秒视频参考预算 |
|---|---|---|---|---|
| Seedance 2.5 Flash | 46 元 / 百万 token | 约 0.99 元 | 约 7.9 元 | 约 9.9 元 |
| Seedance 2.5 | 70 元 / 百万 token | 约 1.51 元 | 约 12.1 元 | 约 15.1 元 |
| Seedance 2.0 | 46 元 / 百万 token | 约 0.99 元 | 约 7.9 元 | 约 9.9 元 |
在相同条件下,Flash 的官方 token 单价较 Seedance 2.5 低约 34%,与 Seedance 2.0 持平。Seedance 2.0 在此仅作参数和价格参照,本轮并未生成其测试样片。表中的 8 秒和 10 秒预算,按官网示例的每秒价格粗略换算,方便比较。实际扣费取决于 token 单价与真实用量,以官方账单为准,这里列出的不是这批样片的实际支出。
各项能力的实测表现
本次测试通过六个场景考察五类生成能力,共包含六条 Flash 样片和两条 Seedance 2.5 标准版对照样片。摩托车压弯与连续打斗归入动态表现,进行双版本对照;其余四项只测试 Flash 的表现。前七条视频均为 8 秒,多参考图案例为 10 秒并包含三个镜头。
| 能力类别 | 测试场景 | 时长 | Flash 的主要表现 | Seedance 2.5 对照 |
|---|---|---|---|---|
| 动态表现与镜头控制 | 摩托车压弯与跟拍 | 8 秒 | 有速度感,近景裁切影响完整过弯动作的展示 | 压弯、过弯心到扶正的过程更完整 |
| 动态表现与镜头控制 | 连续打斗 | 8 秒 | 能生成连续攻防,部分动作衔接和力量感偏弱 | 转体、身体反应和前后位移更自然 |
| 人物表演与台词 | 读信、抬头与英文台词 | 8 秒 | 能呈现读信到微笑的变化,台词和口型尚未独立核验 | 未测试 |
| 细节交互 | 两人递钥匙 | 8 秒 | 钥匙交接关系清楚,人物设定有偏差,手指接触仍需细看 | 未测试 |
| 空间理解 | 桌面转动杯子 | 8 秒 | 布局大体保留,杯子转角尚未确认,机位有轻微推进 | 未测试 |
| 多参考图与分镜一致性 | 七图参考生成三镜头交接 | 10 秒 | 三个镜头间,人物、车辆和头盔归属整体保持一致 | 未测试 |
下文按能力类别逐一展示原片与提示词,各条视频的具体等待时间统一汇总在文末的生成速度表中。
动态表现与镜头控制
这一部分通过摩托车压弯和双人打斗两个场景,观察动作衔接、重心变化、运动路线,以及镜头能否把动作过程交代清楚。两款模型使用完全相同的英文提示词和生成设置。
摩托车压弯与跟拍
两个版本的提示词要求一致:一名车手骑红色摩托车驶过长弯,镜头从前侧低机位跟拍;车辆过弯心后逐渐扶正,整辆车与前后车轮需始终保留在画面内。
Seedance 2.5 Flash
8 秒 · 720p · 原生音频 · 提交至观察到完成:82.7 秒
Seedance 2.5
8 秒 · 720p · 原生音频 · 提交至观察到完成:200.8 秒
Flash 更像一条赛车特写
Flash 生成的画面中,红色车头、湿滑路面、灯光反射和后轮卷起的水雾都比较清晰,背景快速后退,紧贴车头的跟拍也带出了速度感。但画面景别过近,车手的头部、上半身及部分车身被裁出画外,前后车轮也没有按提示词要求完整保留。虽然能看出车身倾斜,但由于构图太紧,观众很难看清车手与摩托车是如何配合过弯的。
如果成片恰好需要切入一个紧凑的赛车局部特写,这条素材可以使用;但如果分镜要求完整交代压弯过程,或者需要衔接在交代赛道走线的镜头之后,这种裁掉部分人物与车身的构图就不够合适。
标准版把过弯拍得更完整
标准版将车手和整辆摩托车的轮廓都保留在画面内。顺着时间线看,车身倾斜过弯、贴近弯心,随后逐渐减小倾角并扶正;结合赛道内侧路肩与车身的位置关系,车辆的行进路线也很清晰。
这种顺畅感来自车身姿态、车手重心、过弯路线与镜头距离的配合。与 Flash 的紧凑特写相比,标准版更清楚地呈现了从过弯到逐渐扶正的过程,因此在这一场景中运动表现更好。
不过,标准版的前侧跟拍角度和景别在过程中也有变化。仅凭抽样帧,尚不能确认每一刻的轮胎接地状态和车身结构都完全准确。这组对比说明标准版对动作过程与行进路线的呈现更完整,但不能据此认定所有物理细节都准确。
摩托车测试使用的完整英文提示词
One continuous 8-second cinematic live-action shot on a closed motorcycle racing circuit just after rain, at blue hour. A single adult professional racer in black protective leathers and a full-face helmet rides one unbranded red sport motorcycle through a sweeping right-hand bend. A low front three-quarter tracking camera follows alongside at matching speed, keeping the whole motorcycle and both wheels visible. The racer leans naturally into the corner, reaches the apex, then gradually brings the bike upright toward the exit. Both tires remain on the wet asphalt. Track barriers and floodlights move past in the background, with a fine spray of water trailing the rear tire. Physically plausible rider anatomy and motorcycle geometry, consistent red bodywork, realistic film texture. Sound: one motorcycle engine rising smoothly and wet tire hiss. No dialogue, no music, no cuts, no text, no subtitles, no logos.
双人连续打斗
这组打斗要求两款模型一开场就交手:连续出拳、闪避格挡,接着一记重踢反击,随后上前追击、下盘扫腿,最后倒地翻滚。为了在快速交手中区分角色,提示词设定一人穿灰外套配黑裤子,另一人穿深蓝外套配棕裤子。
Seedance 2.5 Flash
8 秒 · 720p · 原生音频 · 提交至观察到完成:82.4 秒
Seedance 2.5
8 秒 · 720p · 原生音频 · 提交至观察到完成:197.7 秒
Flash 连招够多,力量感偏弱
Flash 把连续出拳、格挡、踢腿、低位扫腿和倒地翻滚这几个动作都生成了出来。但细看可以发现,有几处过招更像在按顺序拆解动作,出拳踢腿后的受击反应以及顺势衔接下一招的过程略显发飘。两人在画面中基本呈左右平移,镜头与人物之间缺少前后纵深方向的距离变化。
此外,画面上下自动加上了黑边,前半段也没有完整保留脚部。如果需要观察打斗时的支撑脚、步法移动和发力过程,裁掉脚部会影响判断。
标准版的发力和位移更自然
标准版中,人物出拳时能看到肩背发力和腰腹转动,闪避、反踢和后撤步也带动了整个身体;拉开距离后两人再次贴近,顺势接上下盘动作与倒地翻滚。镜头会随交手过程调整位置,人物的前后距离与朝向持续变化,打斗发生在具有纵深感的空间里,前后位置关系更清楚。
这条样片把发力、接招到追击的过程交代得更连贯。与 Flash 相比,标准版的拳脚显得更有分量,连招衔接更紧凑,在这一场景中的运动表现更好。
标准版也没有全程把两人的脚部留在画面内。至于拳脚接触是否合理、是否严格打满提示词要求的三拳,以及每次重心转移是否合理,仍需沿着视频仔细看。画面更具电影感,不等于动作编排完全准确,也不能说明提示词中的每项动作要求都得到了严格执行。
打斗测试使用的完整英文提示词
An explosive 8-second live-action martial-arts fight scene, fast real-time Hong Kong action-film choreography, one continuous shot. Two adult fighters in a gritty concrete parking garage: one in a light grey jacket and black trousers, the other in a dark navy jacket and tan trousers. They are already fighting in the opening frame. The grey fighter surges forward with a rapid three-punch combination; the navy fighter slips the first punch, blocks the next and drives back with a forceful body kick. The grey fighter staggers two steps, immediately closes the distance, ducks a swinging counterpunch and sweeps the navy fighter's leg. The navy fighter hits the floor in a controlled stunt fall and rolls away as the grey fighter pursues. Relentless attack-and-counterattack momentum throughout, short transitions, sharp acceleration, convincing physical impact reactions, forceful torso rotation, realistic weight and balance, clear changes of position across the floor. The camera tracks rapidly beside them at waist height in a medium-wide action framing, keeping both whole bodies and the floor under their feet visible, with subtle handheld vibration at impacts. Crisp readable action, restrained motion blur, hard overhead light, cinematic contrast, realistic anatomy and clothing, distinct stable identities. Audio: rapid footfalls, forceful punch and kick impacts, clothing snaps, heavy breathing and a solid floor impact. No slow motion, no standing around, no pauses to reset, no dialogue, no music, no text, no subtitles, no cuts, no blood, no gore, no weapons.
人物表演与台词
这一场景要求人物先低头读信,接着抬起头,用英文说出 “You kept the letter.”(你还留着那封信),随后微笑片刻。提示词规定台词需在第 4 到 6 秒之间说出,并保持固定机位。
从抽检画面来看,人物从低头看信转为抬头微笑,脸部、外套和手中的信纸在各个时间点均能辨认。这类小幅度表演没有剧烈运动干扰,适合直接观察面部神态与情绪过渡。
评估这类带台词的表演镜头时,画面与声音需要分开核对。视频包含音轨,不代表台词发音和口型一定准确对应。审看原片时,仍需确认那句英文发音是否清晰、是否混入多余人声、是否按要求在第 4 到 6 秒之间开口,以及口型变化是否匹配。仅凭静态截图,本轮尚未独立核验台词是否逐字准确以及口型是否严格同步。
人物表演使用的英文提示词
One continuous 8-second medium close-up in a quiet train carriage, naturalistic live-action cinematography. An adult woman in a plain navy jacket holds one opened letter below her face. 0-2 seconds: she reads it silently, with a thoughtful expression. 2-4 seconds: she takes a small breath and lifts her eyes toward a person just beside the camera. 4-6 seconds: with a restrained, tender smile she says clearly in English, 'You kept the letter.' 6-8 seconds: she holds the eye contact and the quiet smile. Keep her mouth fully visible and her face, clothing and letter consistent. The camera stays still. Audio: her single spoken line over soft carriage rumble. No other voices, no music, no captions, no readable writing, no subtitles, no cuts.
细节交互
这一场景要求一人将一把小黄铜钥匙放进另一人的掌心,松开手指,再收回空手。这类小型硬质道具的交接适合检验手部生成质量:当两只手靠近、交叠时,捏住与松开钥匙的动作需要清晰交代。
在抽检的交接画面中,递钥匙的手伸向摊开的手掌,放下钥匙后撤回,接钥匙的人随后合拢手指。下方对交接瞬间做了局部放大,便于观察指尖与钥匙的接触关系。
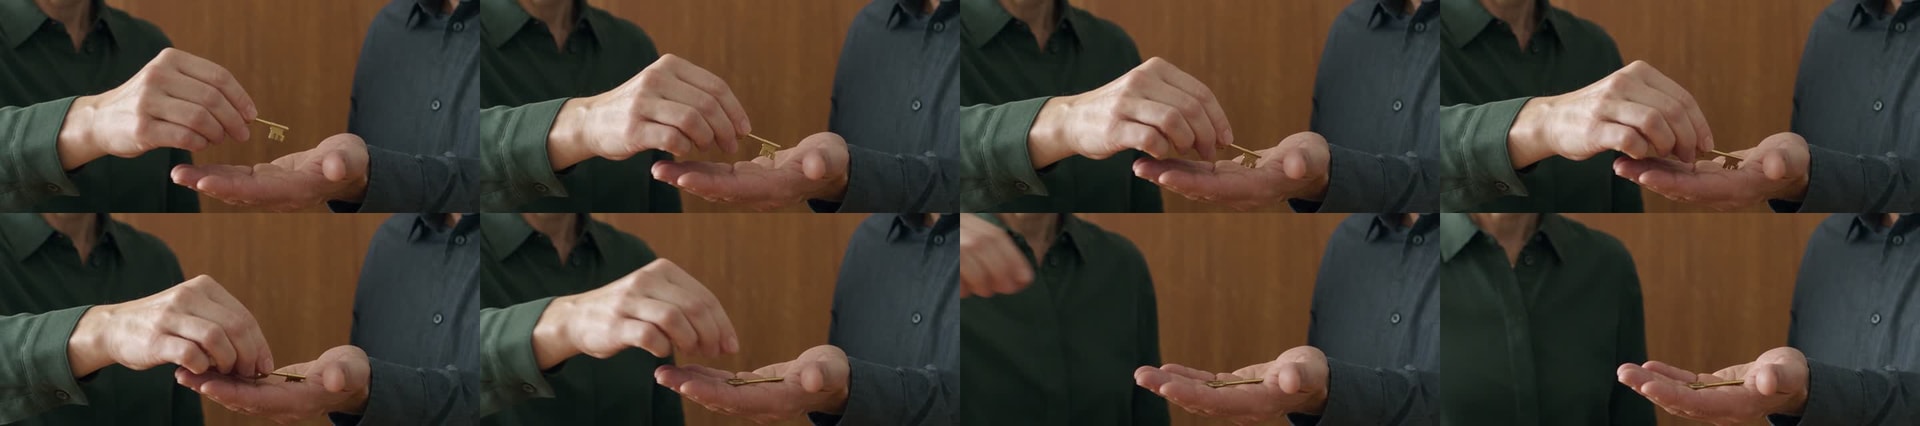
检查这类局部交互,通常需要重点核对几个细节:松手时捏钥匙的手指是否自然张开,指尖与钥匙或对方手掌有没有粘连模糊,拇指与其他手指的关节结构是否正常,以及钥匙在全过程中是否始终保持唯一。这些细节需要顺着视频逐帧细看,起始帧的手掌结构正常,不代表两只手重叠时也不会出错。
此外,这条样片在人物设定上出现了明显偏差。提示词明确要求画面左侧递钥匙的是女性,但生成的交接者却呈现为男性。因此,这条样片虽然可以用于观察手部交接动作,但并未按要求还原人物设定。道具完成了传递,不代表所有提示词指令都已落实,也不能仅凭几张抽样帧就断定手指接触结构完全准确。
递钥匙测试使用的英文提示词
One continuous 8-second live-action shot, a fixed waist-up two-shot of two adults at a wooden counter, with both people's hands clearly visible throughout. The woman on the left wears a dark green shirt. The man on the right wears a charcoal shirt. 0-2 seconds: the woman holds exactly one small brass key between the fingers of her right hand; the man presents his empty open left palm. 2-5 seconds: she moves that key into his left palm and releases it. 5-8 seconds: she withdraws her visibly empty right hand, and he closes his fingers around the received key. Maintain one key, two people and continuous natural hand movements. Show the actual contact and release clearly, with realistic anatomy and steady framing. Soft side lighting, believable skin and wood textures. Audio: quiet room tone and a small metallic click during the transfer. No speech, no music, no text, no subtitles, no cuts.
空间理解
这组测试输入了一张原创、无文字的静态首帧图。人物、蓝色马克杯、合上的笔记本、书桌与房间背景均已在首帧图中确定。提示词要求的动作幅度很小:人物低下头,伸手在桌面上将杯子旋转四分之一圈(杯底不离开桌面),然后松手,转头看向窗外。
除了观察人物形象是否保持一致,这个镜头主要考察模型对桌面空间关系的理解:手部是否顺着合理的方向伸向杯柄,杯子转动时杯底是否始终贴合桌面,笔记本、杯子与桌面的相对位置是否稳定,以及握住杯柄再松手的过程中前后遮挡是否正确、有无穿模。
从抽检画面看,桌面整体陈设保持了稳定,能看到手伸向杯子再收回的过程,笔记本也留在右侧原位。不过杯柄的朝向虽然发生了变化,但到了后半段看起来又与初始位置接近;仅看这组抽样帧,还难以确认杯子是否确实转够了四分之一圈并停留在新角度。另外,提示词要求采用固定机位,但生成画面仍有轻微向前推进的迹象。
评估这类首帧图生视频,除了看人物特征是否保持,关键在于手部触碰桌面硬物时,原有物体的位置与前后遮挡能否维持。核对手指接触、遮挡关系与物体位移时,建议将首帧原图与生成视频并排比对。
转杯子测试使用的英文提示词
Continue the supplied first frame as one steady 8-second live-action shot. Preserve this exact adult woman's appearance, navy shirt, desk, single blue mug, closed tan notebook, background and window lighting. 0-2 seconds: she briefly glances down toward the blue mug. 2-5 seconds: she gently takes the mug handle with her right hand and rotates the mug a quarter turn on the tabletop without lifting it. 5-8 seconds: she releases the mug, rests her right hand beside it, and looks back toward the window. The mug stays on the desk and remains one rigid ceramic object, and the closed notebook remains fixed throughout. Keep the camera locked with no cut or zoom. Audio: quiet indoor ambience and a soft ceramic scrape during the turn. No speech, no music, no text, no subtitles.
多参考图与分镜一致性
这组测试将时长扩展到 10 秒,使用七张参考图生成包含三个镜头的片段。角色分别设定为韩国女车手、欧美男车手和欧美中年机械师,三人各输入一张角色三视图;同时提供两辆不同造型的摩托车,以及红黑、白色两顶头盔。
参考图用于确定人物长相、服装与物件造型。测试未输入场景图或分镜草图,车库环境、光线与镜头切换均由文字描述控制:阴天下午,车库门透入柔和的自然光,地面保持干燥,减少皮肤与皮衣上的大片高光。
这次用了哪些参考图
| 参考内容 | 图片 | 对应关系 |
|---|---|---|
| 1 · 女车手三视图 | 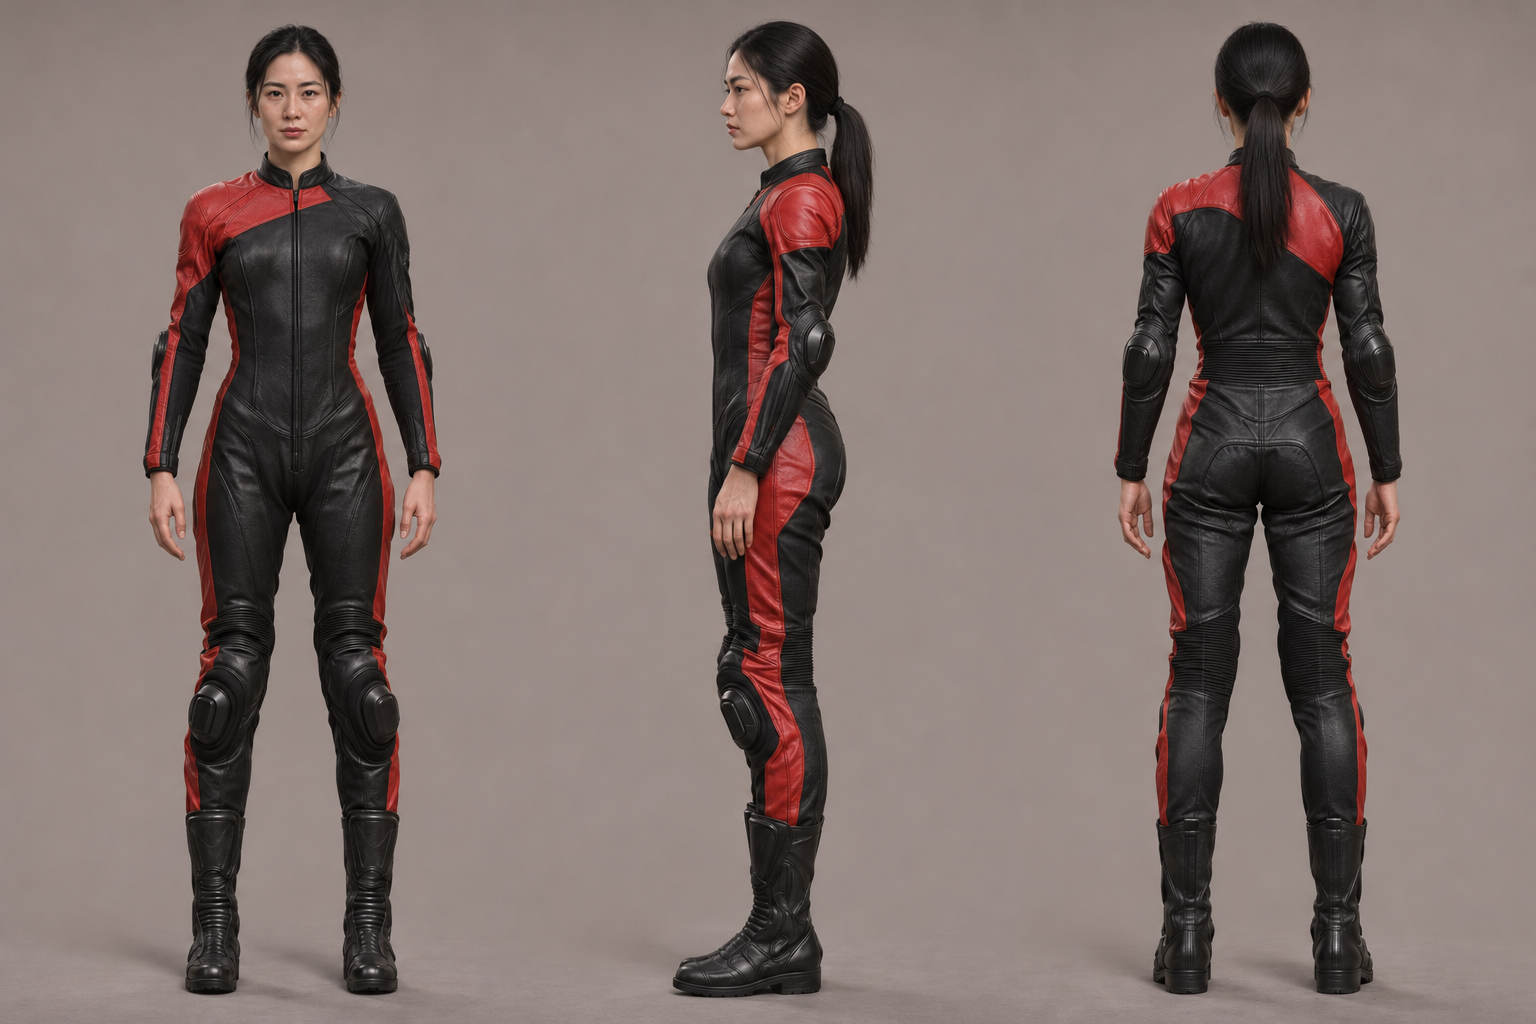 | 红黑赛车服,接过红黑头盔 |
| 2 · 男车手三视图 | 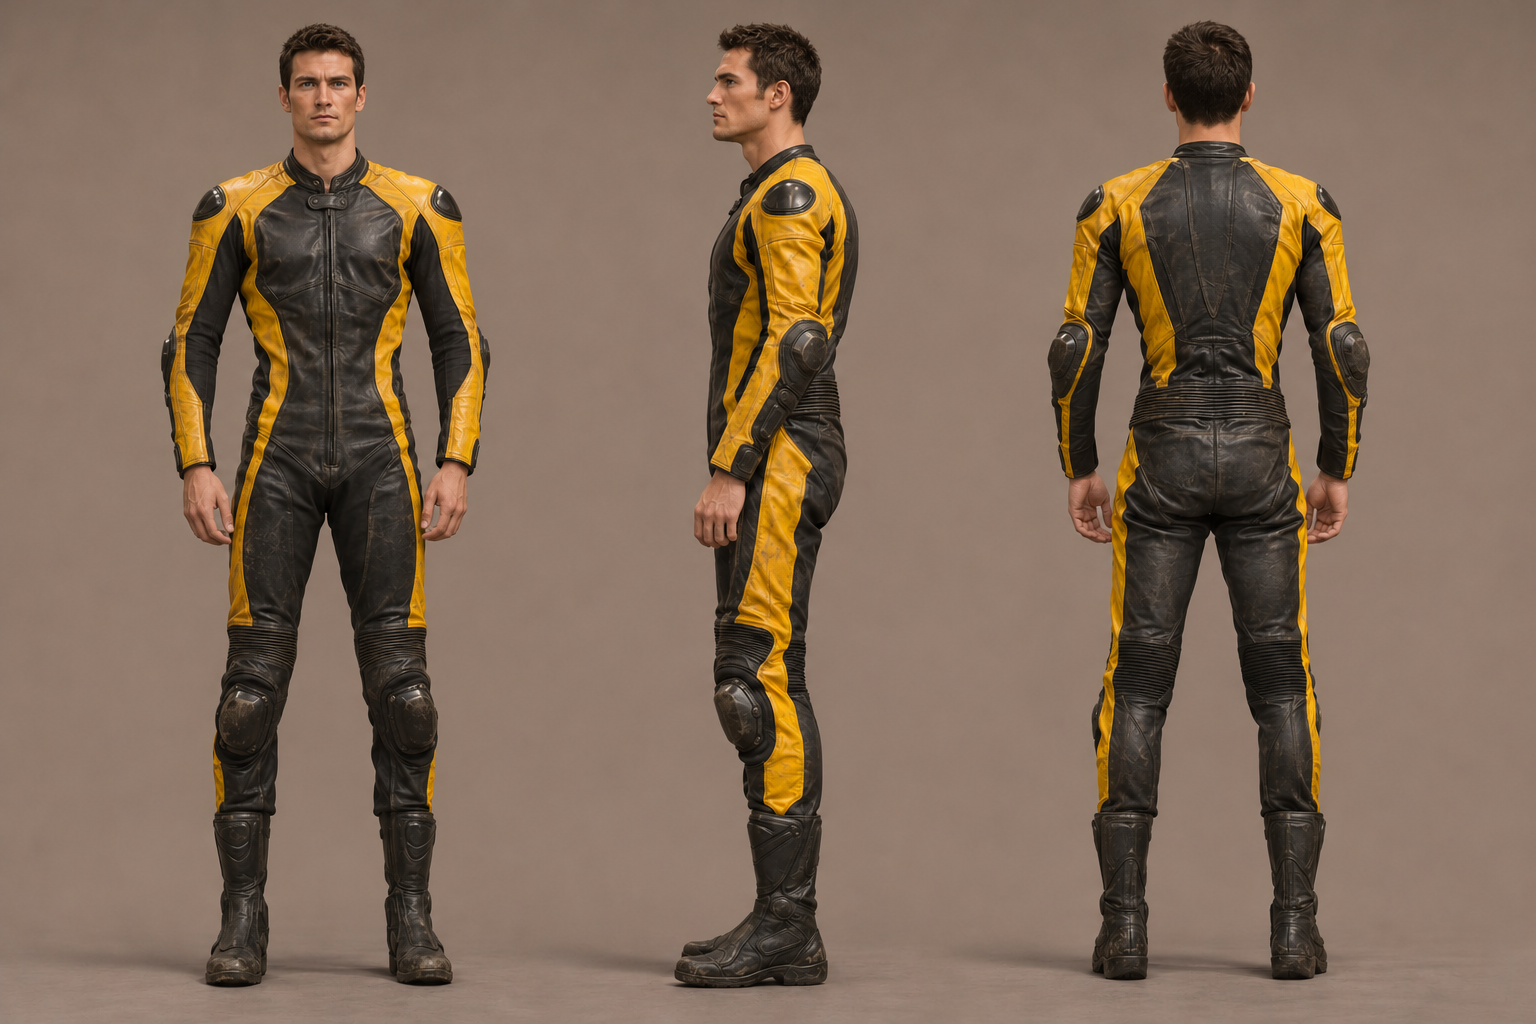 | 黄黑赛车服,始终持有白色头盔 |
| 3 · 机械师三视图 | 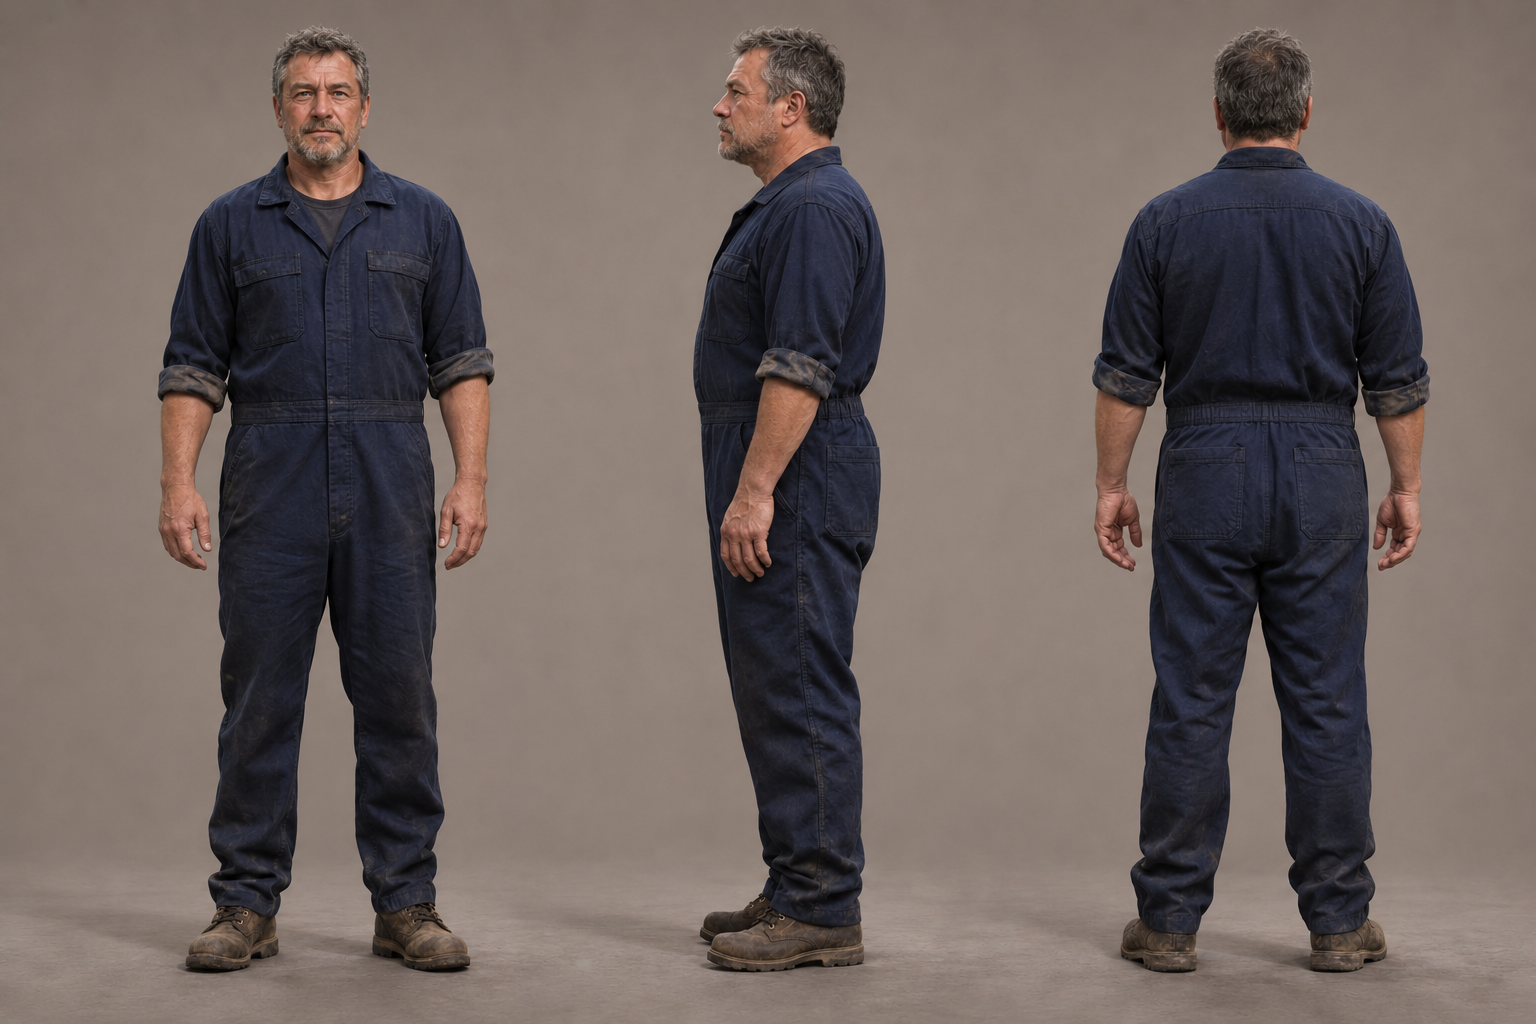 | 深蓝工作服,递出头盔后收回空手 |
| 4 · 红色摩托车 | 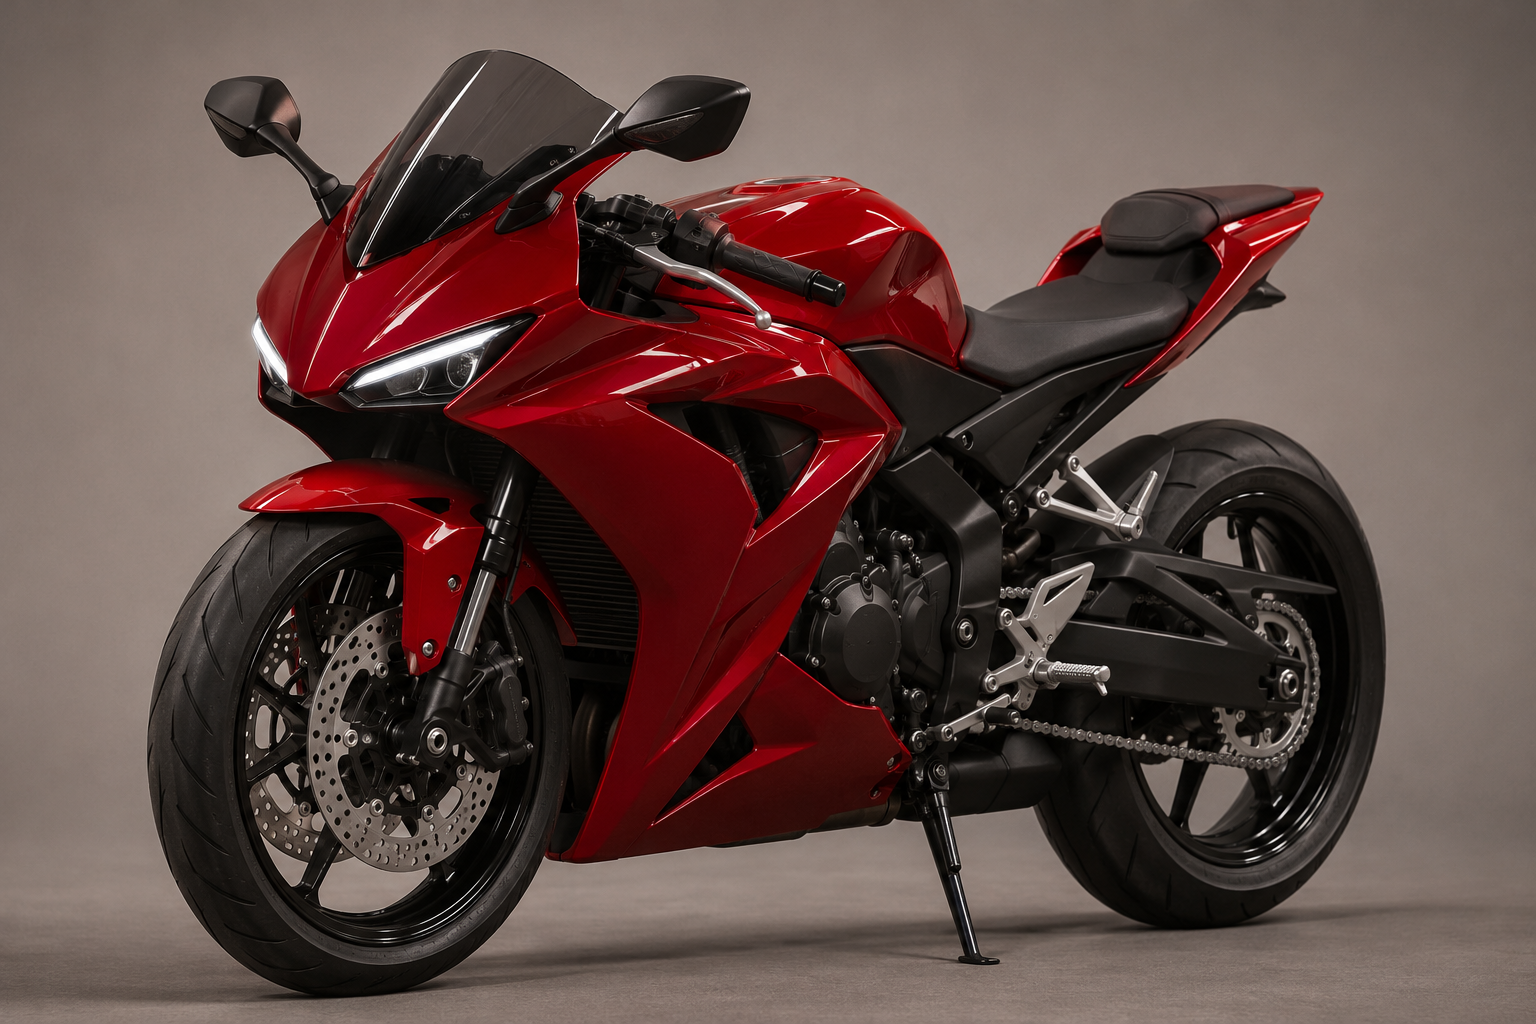 | 保留全包围车身与分体式车灯 |
| 5 · 蓝色摩托车 | 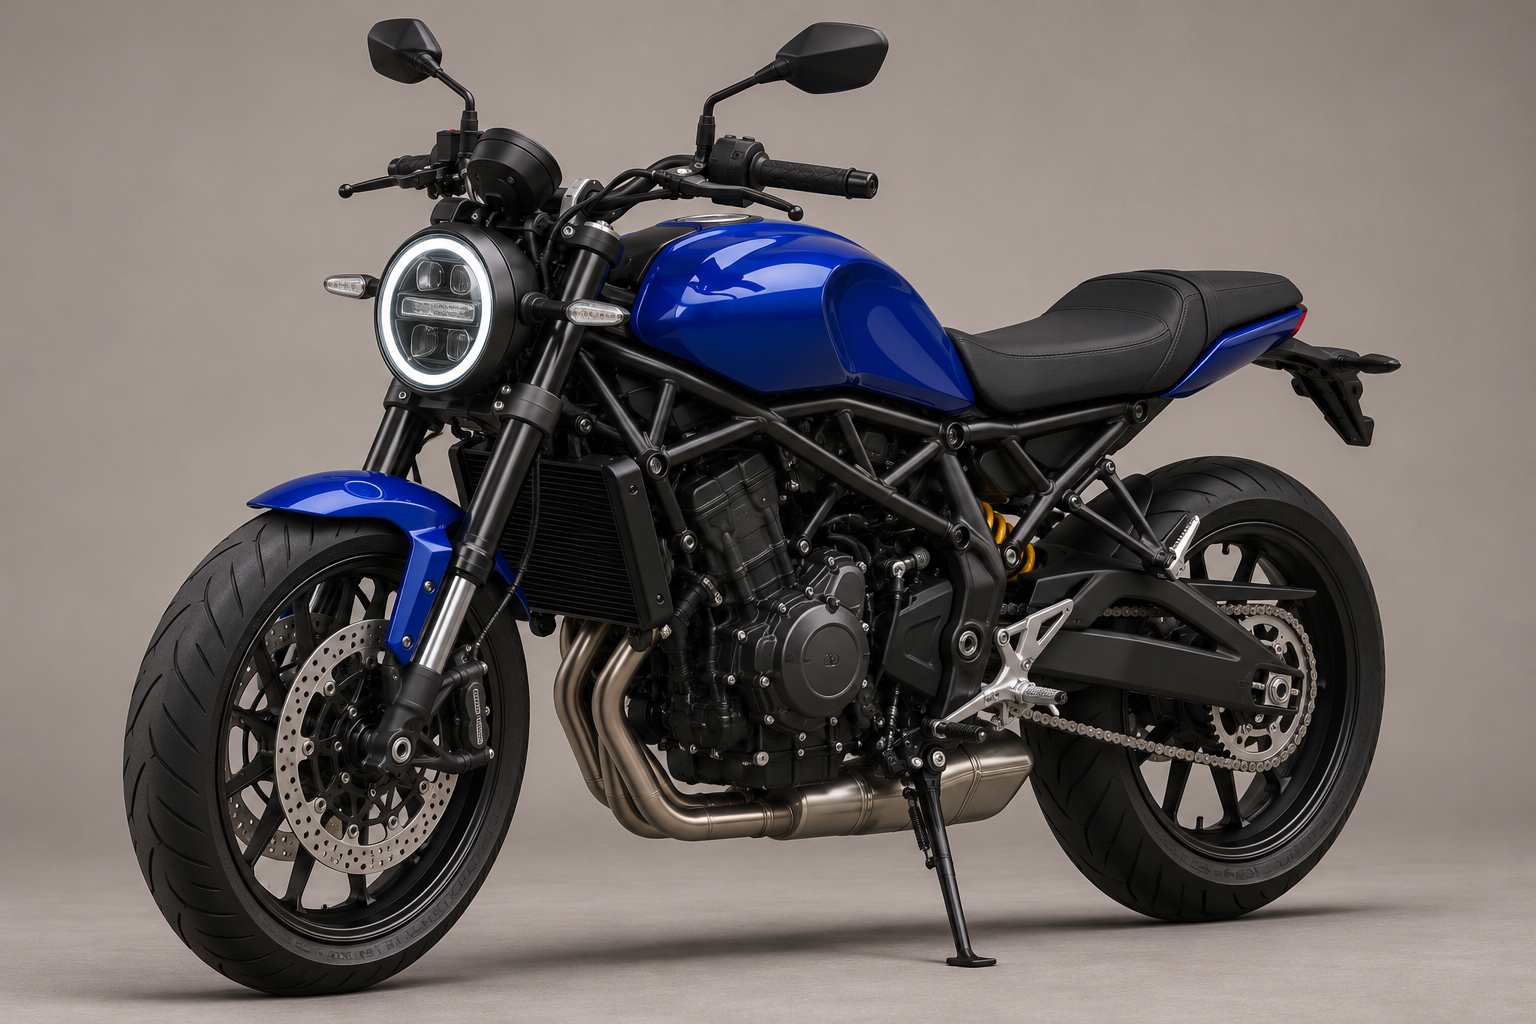 | 保留圆灯与外露发动机 |
| 6 · 红黑头盔 | 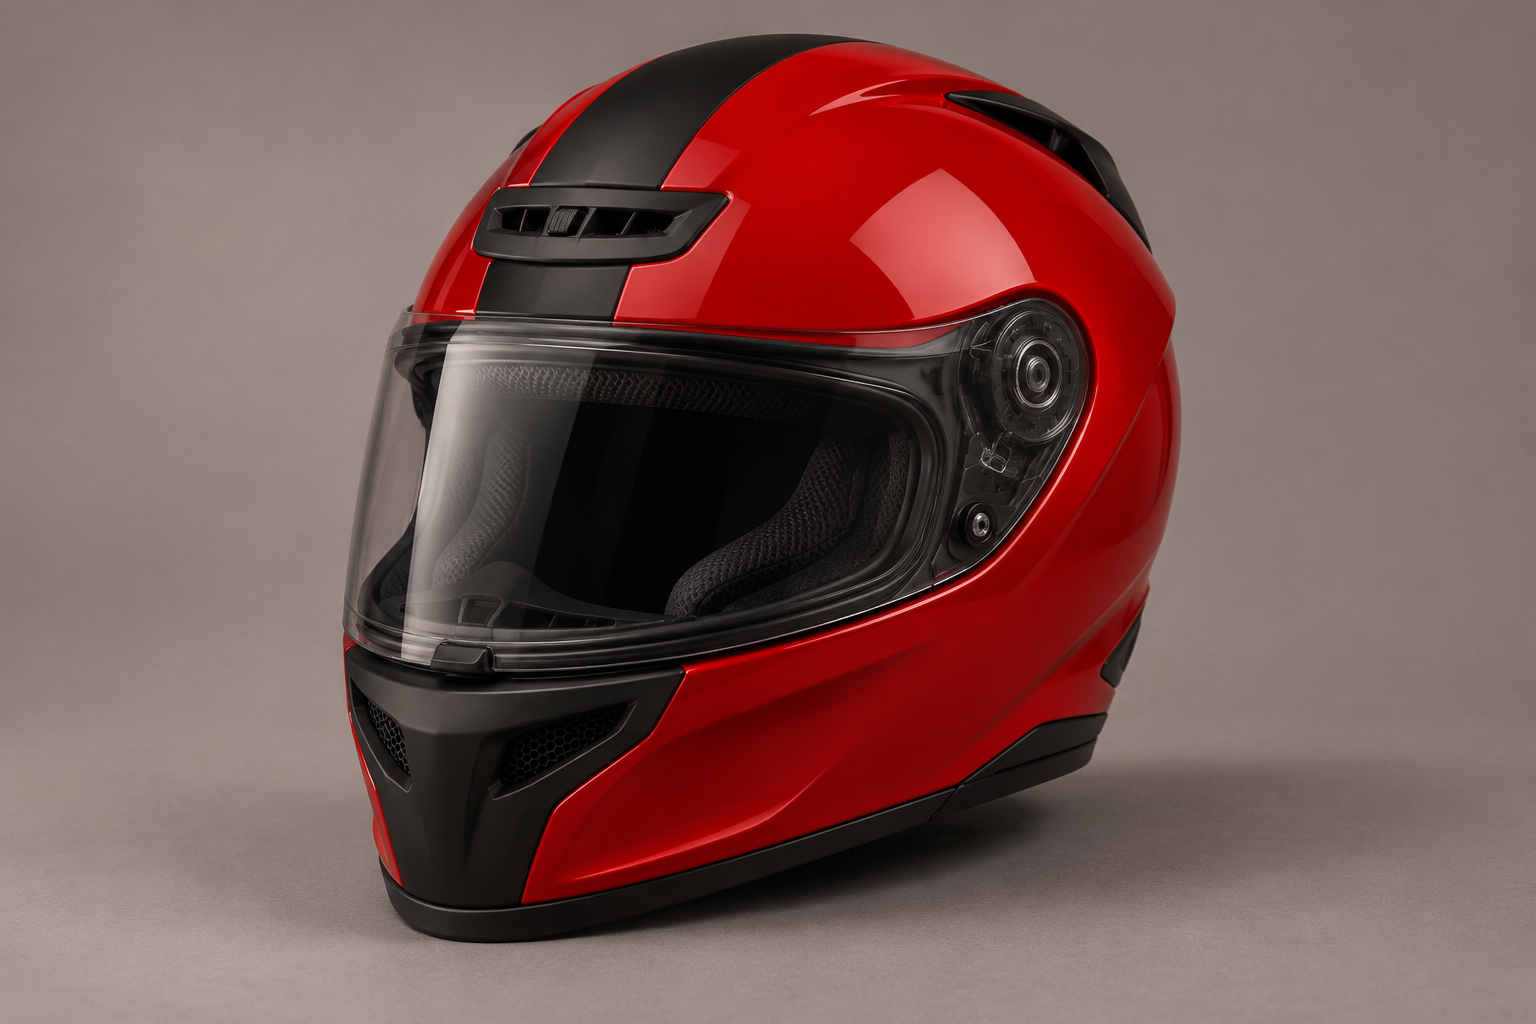 | 从机械师手中转交给女车手 |
| 7 · 白色头盔 | 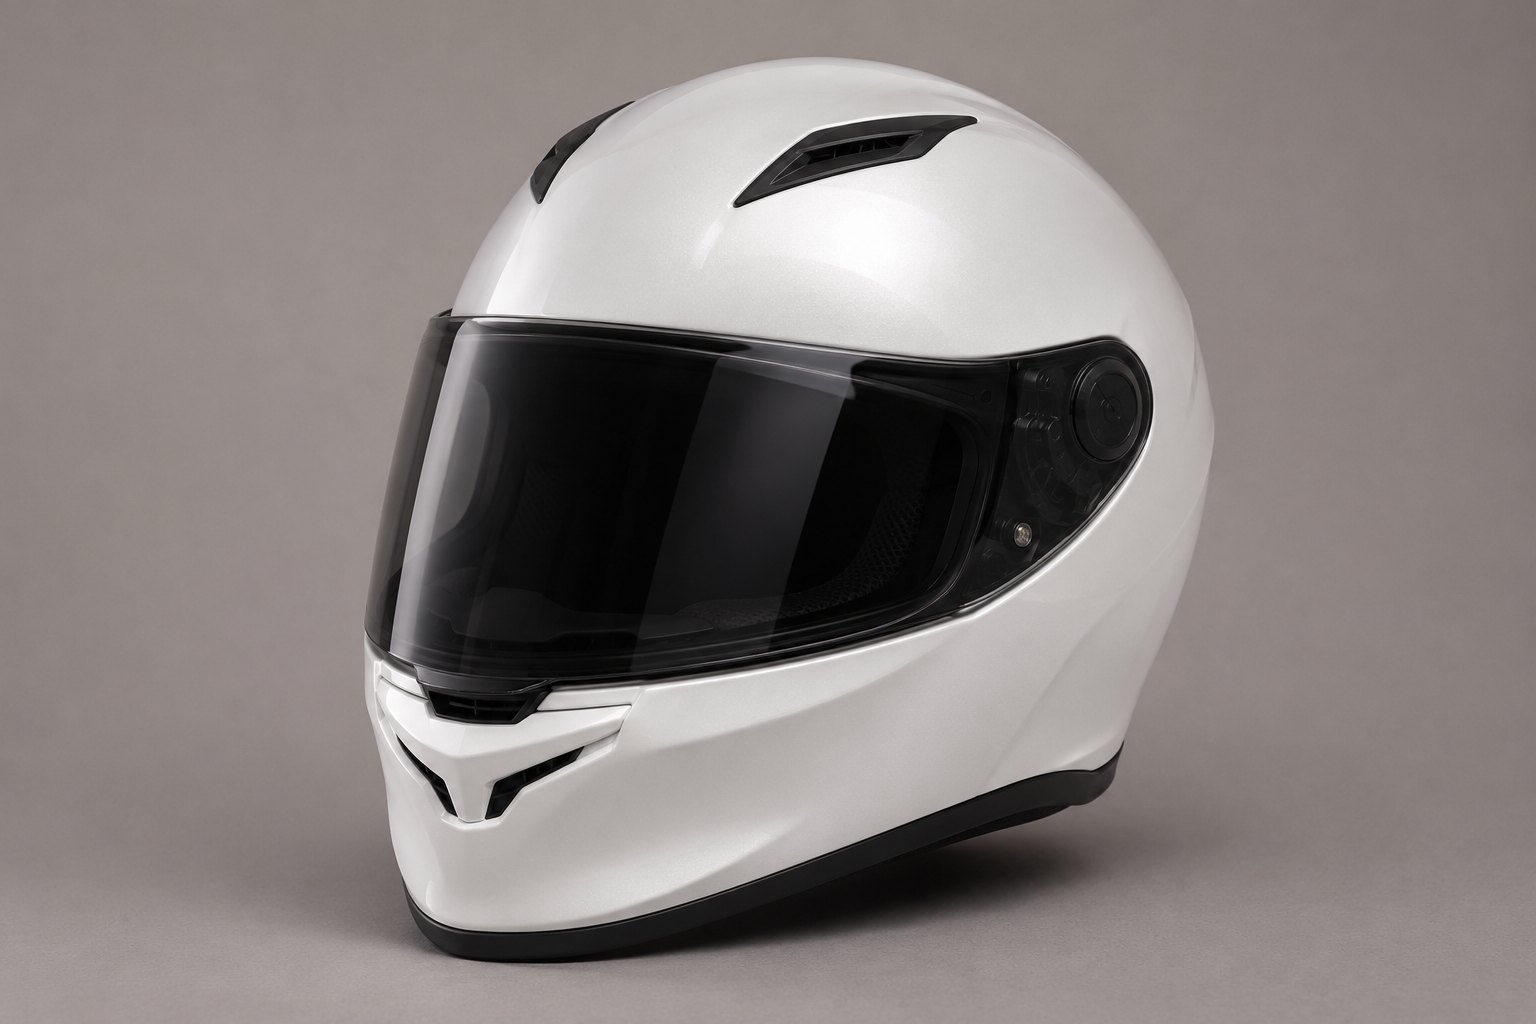 | 由男车手持有 |
分镜安排
| 时间 | 镜头 |
|---|---|
| 0–3 秒 | 全景交代三人两车的位置 |
| 3–7 秒 | 中景拍清头盔交接 |
| 7–10 秒 | 回到全景,两位车手走向各自的车 |
10 秒 · 720p · 原生音频 · 提交至观察到完成约 124 秒
切换镜头后,人物和物件整体保持一致
这条样片在多次切镜后整体维持了设定的一致性。镜头从全景切至中景、再切回全景,三名角色的长相、赛车服与工作服均能对应;红色全包围摩托与蓝色圆灯街车也各自保留了原有造型。三张人物三视图分别对应三个角色,没有把同一张图里的三个视角生成为三个人。
头盔的归属与交接关系也保持了连贯:起初由机械师拿着红黑头盔,切到中景后女车手接过头盔,机械师松手收回;切回全景后,红黑头盔仍拿在女车手手中,男车手则全程拿着白色头盔。对于多参考图任务而言,切镜后依然能分清角色身份与各自持有的道具,对后续剪辑很有用。
成片分别在约第 3 秒和第 6.8 秒处切镜,基本落实了全景、中景再到全景的分镜安排。画面光线贴合文字描述的柔和自然光,地面与皮衣的反光较为克制。不过人物表演仍略显拘谨,交接头盔时的手指细节也需要进一步细看。就目前观察到的结果而言,这条样片在三个镜头之间维持了整体的人物与物件对应关系。这组只测试了 Flash,没有标准版的一致性对照。
多参考图测试的英文提示词(精简版)
以下保留原测试的参考图对应关系、三段分镜和主要约束,省略重复描述。
Create a 10-second photorealistic live-action scene in three shots, with hard cuts at 3s and 7s. Exactly three adults, two parked motorcycles and two helmets.

References define appearance only; replace their studio lighting and backgrounds:
@Image 1: one Korean woman, black ponytail, red-and-black racing suit.
@Image 2: one European-American man, short brown hair, yellow-and-black racing suit.
@Image 3: one middle-aged European-American mechanic, salt-and-pepper hair and stubble, navy coveralls.
Each character reference is a three-view sheet of ONE person.
@Image 4: red faired sportbike, angular split headlights.
@Image 5: blue naked roadster, round headlight, exposed engine.
@Image 6: red-and-black helmet, passed from mechanic to woman.
@Image 7: white helmet, held by the male racer throughout.
Preserve faces, outfits, object designs and colors across cuts.

Setting: a working pit garage on an overcast afternoon. Soft neutral daylight enters from camera-right; worn concrete walls, rear workbench and cabinets, dry matte floor. Natural skin, subdued leather reflections, no glossy skin or amber wash. Keep lighting and environment consistent.

0-3s, steady eye-level wide: woman left beside the red bike, mechanic center holding the red-and-black helmet, male racer right beside the blue bike holding the white helmet. Show full bodies and both bikes. Mechanic begins offering his helmet to the woman.

3-7s, steady medium two-shot from the same side of the action axis: woman left, mechanic right, faces and hands visible. She takes the red-and-black helmet with both hands; he releases it and withdraws empty hands. Show clear contact and release without fused fingers or duplicated objects.

7-10s, return to the wide: woman holds her received helmet and steps toward the red bike; male racer keeps his white helmet and steps toward the blue bike. Mechanic stays between them, hands empty. Bikes remain on stands; nobody mounts or puts on a helmet.

Maintain identities, screen direction, object ownership, grounded movement and natural occlusion. Audio: continuous quiet garage ambience, footsteps and helmet handling. No dialogue, music, extra cuts, slow motion, duplicated people or objects, text, logos or watermarks.
生成速度
| 场景 | 模型 | 时长 | 提交至观察到完成 |
|---|---|---|---|
| 摩托车压弯与跟拍 | Flash | 8 秒 | 82.658 秒 |
| 摩托车压弯与跟拍 | Seedance 2.5 | 8 秒 | 200.842 秒 |
| 连续打斗 | Flash | 8 秒 | 82.400 秒 |
| 连续打斗 | Seedance 2.5 | 8 秒 | 197.657 秒 |
| 人物表演与英文台词 | Flash | 8 秒 | 87.419 秒 |
| 两人递钥匙 | Flash | 8 秒 | 89.368 秒 |
| 基于首帧的小动作 | Flash | 8 秒 | 83.066 秒 |
| 七图参考与三镜头交接 | Flash | 10 秒 | 124.013 秒 |
前五条 8 秒 Flash 视频,从提交任务到观察到完成耗时约 82 至 89 秒;两条 8 秒标准版视频分别耗时约 201 秒和 198 秒。10 秒多参考图视频耗时约 124 秒,由于输入素材与时长不同,在此单独记录,不与前面的 8 秒样片直接折算速度差。如果日常工作需要反复调整提示词、多轮生成样片并比对分镜效果,单次生成省下一分多钟,能够明显加快前期的尝试与筛选节奏。
需要说明的是,这批任务虽然使用同一账号提交,但两个版本的测试分布在不同时间段,且每个场景未做多次重复生成取均值。记录的耗时包含了网络波动、服务端排队以及脚本每五秒轮询一次带来的观测延迟。因此,这组数据仅反映本轮测试中 Flash 的实际等待更短,不能直接换算为模型固定的速度优势。
什么时候用 Flash,什么时候选标准版
如果创作任务以动态和动作戏为主,从本轮测试结果来看,Seedance 2.5 标准版依然更稳妥。在两组动态对照中,标准版对动作完整过程、身体受击反应与空间位移的呈现,更贴合这类镜头的拍摄要求。
如果现阶段主要用于快速试戏、确定构图、摸索提示词写法,或者在预算有限的前提下批量推进日常镜头,Flash 缩短的等待时间与更低的单价就很有实际价值。它同样能生成画面质感不错的片段,但在挑片时仍需对照分镜要求,仔细核对构图裁切、动作衔接与局部交互细节。
综合来看,在本轮两组动态测试中,Flash 的运动表现尚未完全追平 Seedance 2.5 标准版,标准版在动作完整度与力量感上依然占优;Flash 的定位则是在维持可用质量的前提下缩短等待时间、降低调用成本,方便创作者在前期高频试错与出片。至于人物表演与台词、细节交互、空间理解以及多参考图分镜一致性,本轮仅生成了 Flash 的测试样本,用于展示它在这几类任务中的实际表现和观察重点,不比较两个版本在这些任务上的高下。