很多用户都会好奇,为什么视频生成的单价比去年已经便宜了不少,但是生成一段10分钟的视频成本并没有降低。在这里我想分享一下成本优化的思路和方案,希望大家能够创作出更多好视频。
下面结合我的生成测试和公开创作者的复盘,介绍几种减少返工、控制成本的做法。
一、算账要看实际的可用镜头
首先第一点要明确,视频创作的最大成本是反复生成才能截取一段可用的。之前有位创作者分享过自己的创作经历,一部十二分钟的AI短片,花了大约一千两百美元,生成了九百多条素材,最后用上的只有两百条左右。对于中长视频的创作,素材可用率并不高。
视频生成的实际成本,往往取决于拿到一个可用镜头需要尝试多少次。例如,假设一个镜头生成三次后才选出一个可用版本,那么它的生成费用就是单次报价的三倍。如果选中的素材也只有一半时长能剪进成片,按最终采用秒数计算的成本还会进一步翻倍。这里的比例只是计算示例,并非行业平均水平。实际需要多少次尝试,会随模型、镜头难度、参考素材和验收标准而变化。因此,比起比较单次生成价格,更有参考价值的是记录总生成费用、尝试次数和最终采用秒数,算清楚每一秒成片实际花了多少钱。
二、先设计好你的分镜粗剪
前面说,要根据镜头的复杂程度选择模型、分配预算。这里还有一个前提,你得先确定这场戏到底需要哪些镜头,每个镜头要表达什么,以及它们剪在一起是否成立。这些问题如果等视频生成以后才发现,删掉的是已经付费的素材,补拍和修改又是一笔费用。
所以我建议,在正式生成视频之前,先做一版分镜设计:每个镜头要表达什么,涉及几个人物,有没有复杂的动作。拿到分镜后,再标出普通镜头和重点镜头。环境空镜、简单过渡可以先测试低成本模型;多人正反打、复杂动作和关键表演,则优先验证高质量模型能否减少返工。模型是否合适,要看实际通过率,不能只凭 Prompt 长短判断。
这一步不是考虑生成,而是提前设计,让你更好的管理你的视频需要哪些模型,哪些需要重点投入Token。如果你的文字较难描述清楚Prompt,那么视频模型也会很难理解你的意图,就别在这块犹豫用哪个模型了。静态粗剪也不能验证所有动作和表演,而是写下来,帮你提前排除一批不必要的生成。先用低成本把镜头的用途和顺序想清楚,再花钱让它们动起来。
同一场戏混用模型时,还要检查画面能不能接上。先用相同的角色参考和场景描述,比较人物、材质、光线与表情的差异;如果后期修补太多,单次生成省下的钱也可能被抵消。模型的选择和预算分配,应在这一步一起确定。
想把这套方法用到自己的故事中,可以从 Arcloop 的AI 短剧生成器开始,输入剧本或故事想法,再结合分镜计划检查场景与镜头。
范例:先为对白和反应留出时间
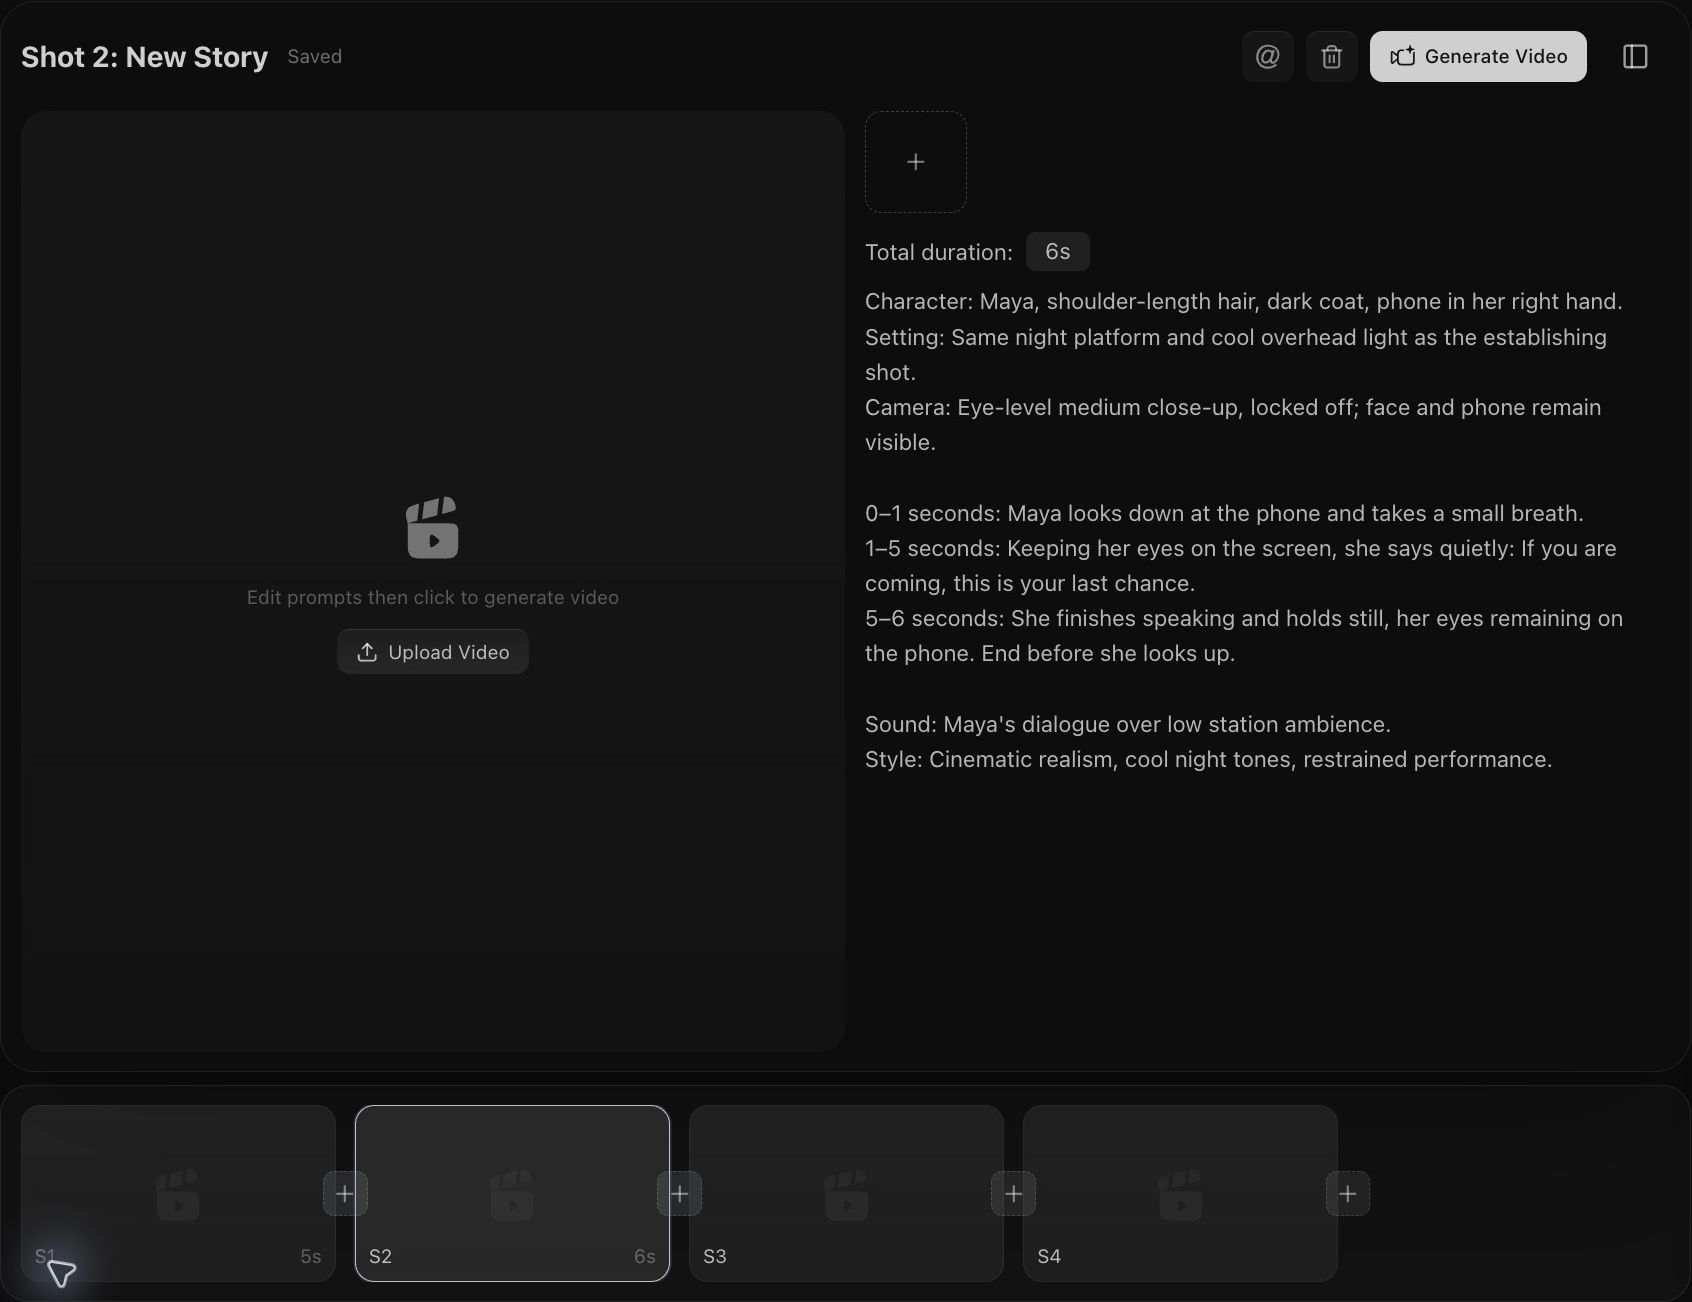
下面是一个 18 秒短场景的分镜计划示例。先确定每个镜头的任务,再为对白和人物反应预留时间;这些时长是设计目标,需要用临时声音和粗剪验证。
| Shot | Purpose | Edit range | Duration |
|---|---|---|---|
| 01 | Establish the Wait | 00:00–00:04 | 4s |
| 02 | Give the Line Room | 00:04–00:10 | 6s |
| 03 | Reveal the Arrival | 00:10–00:13 | 3s |
| 04 | Let the Reaction Land | 00:13–00:18 | 5s |
以第二镜为例,可以先把六秒拆成准备、说话和停顿三个阶段:
Camera: Eye-level medium close-up, locked off.

0–1 seconds: Maya looks down at her phone and takes a small breath.
1–5 seconds: She says quietly: If you are coming, this is your last chance.
5–6 seconds: She holds still, eyes on the phone. End before she looks up.

Sound: Temporary dialogue over low station ambience.
先录一段临时对白,检查六秒是否足够自然地说完,再看最后五秒的反应镜头能否承接情绪。如果对白太赶或反应太短,就先调整分镜和剪辑时长,再进入视频生成。
三、先用故事板做视觉打样
分镜粗剪确定镜头的用途和顺序,故事板则把这些想法画出来。人物站在哪里、看向哪里,前后两个画面能不能接上,放在一起通常更容易判断。它适合在视频生成前做视觉打样,先检查构图、空间关系和情绪变化。
写故事板 Prompt 时,先说清楚 Grid 的要求:几行几列、阅读顺序、每格的画幅,以及每格只呈现一个静态瞬间。角色只保留必要的识别特征,再给每格写清景别和关键状态。文字不宜太复杂,外貌、背景、动作和限制堆得越多,图片模型越难同时落实,反而容易漏掉真正重要的信息。
故事板也增加了一层制作工作。图片模型需要同时处理排格、人物一致性和场景连续性,可能画错某一格,或让前后画面的细节对不上。实际制作时,最好配合专业分镜工具,或支持参考图、局部编辑和单格导出的图片工具,把排版、出图和修改分开处理。
如果只想修改其中一格,我更建议先把这一格裁剪出来,连同必要的角色或场景参考,单独编辑或重新生成,确认后再放回原来的位置。这样能保留其他已经满意的画面,也更方便比较修改前后是否接得上。需要用作视频首帧时,也应先裁出对应画面,再检查清晰度和起始状态。
范例:用六宫格检查同一场戏
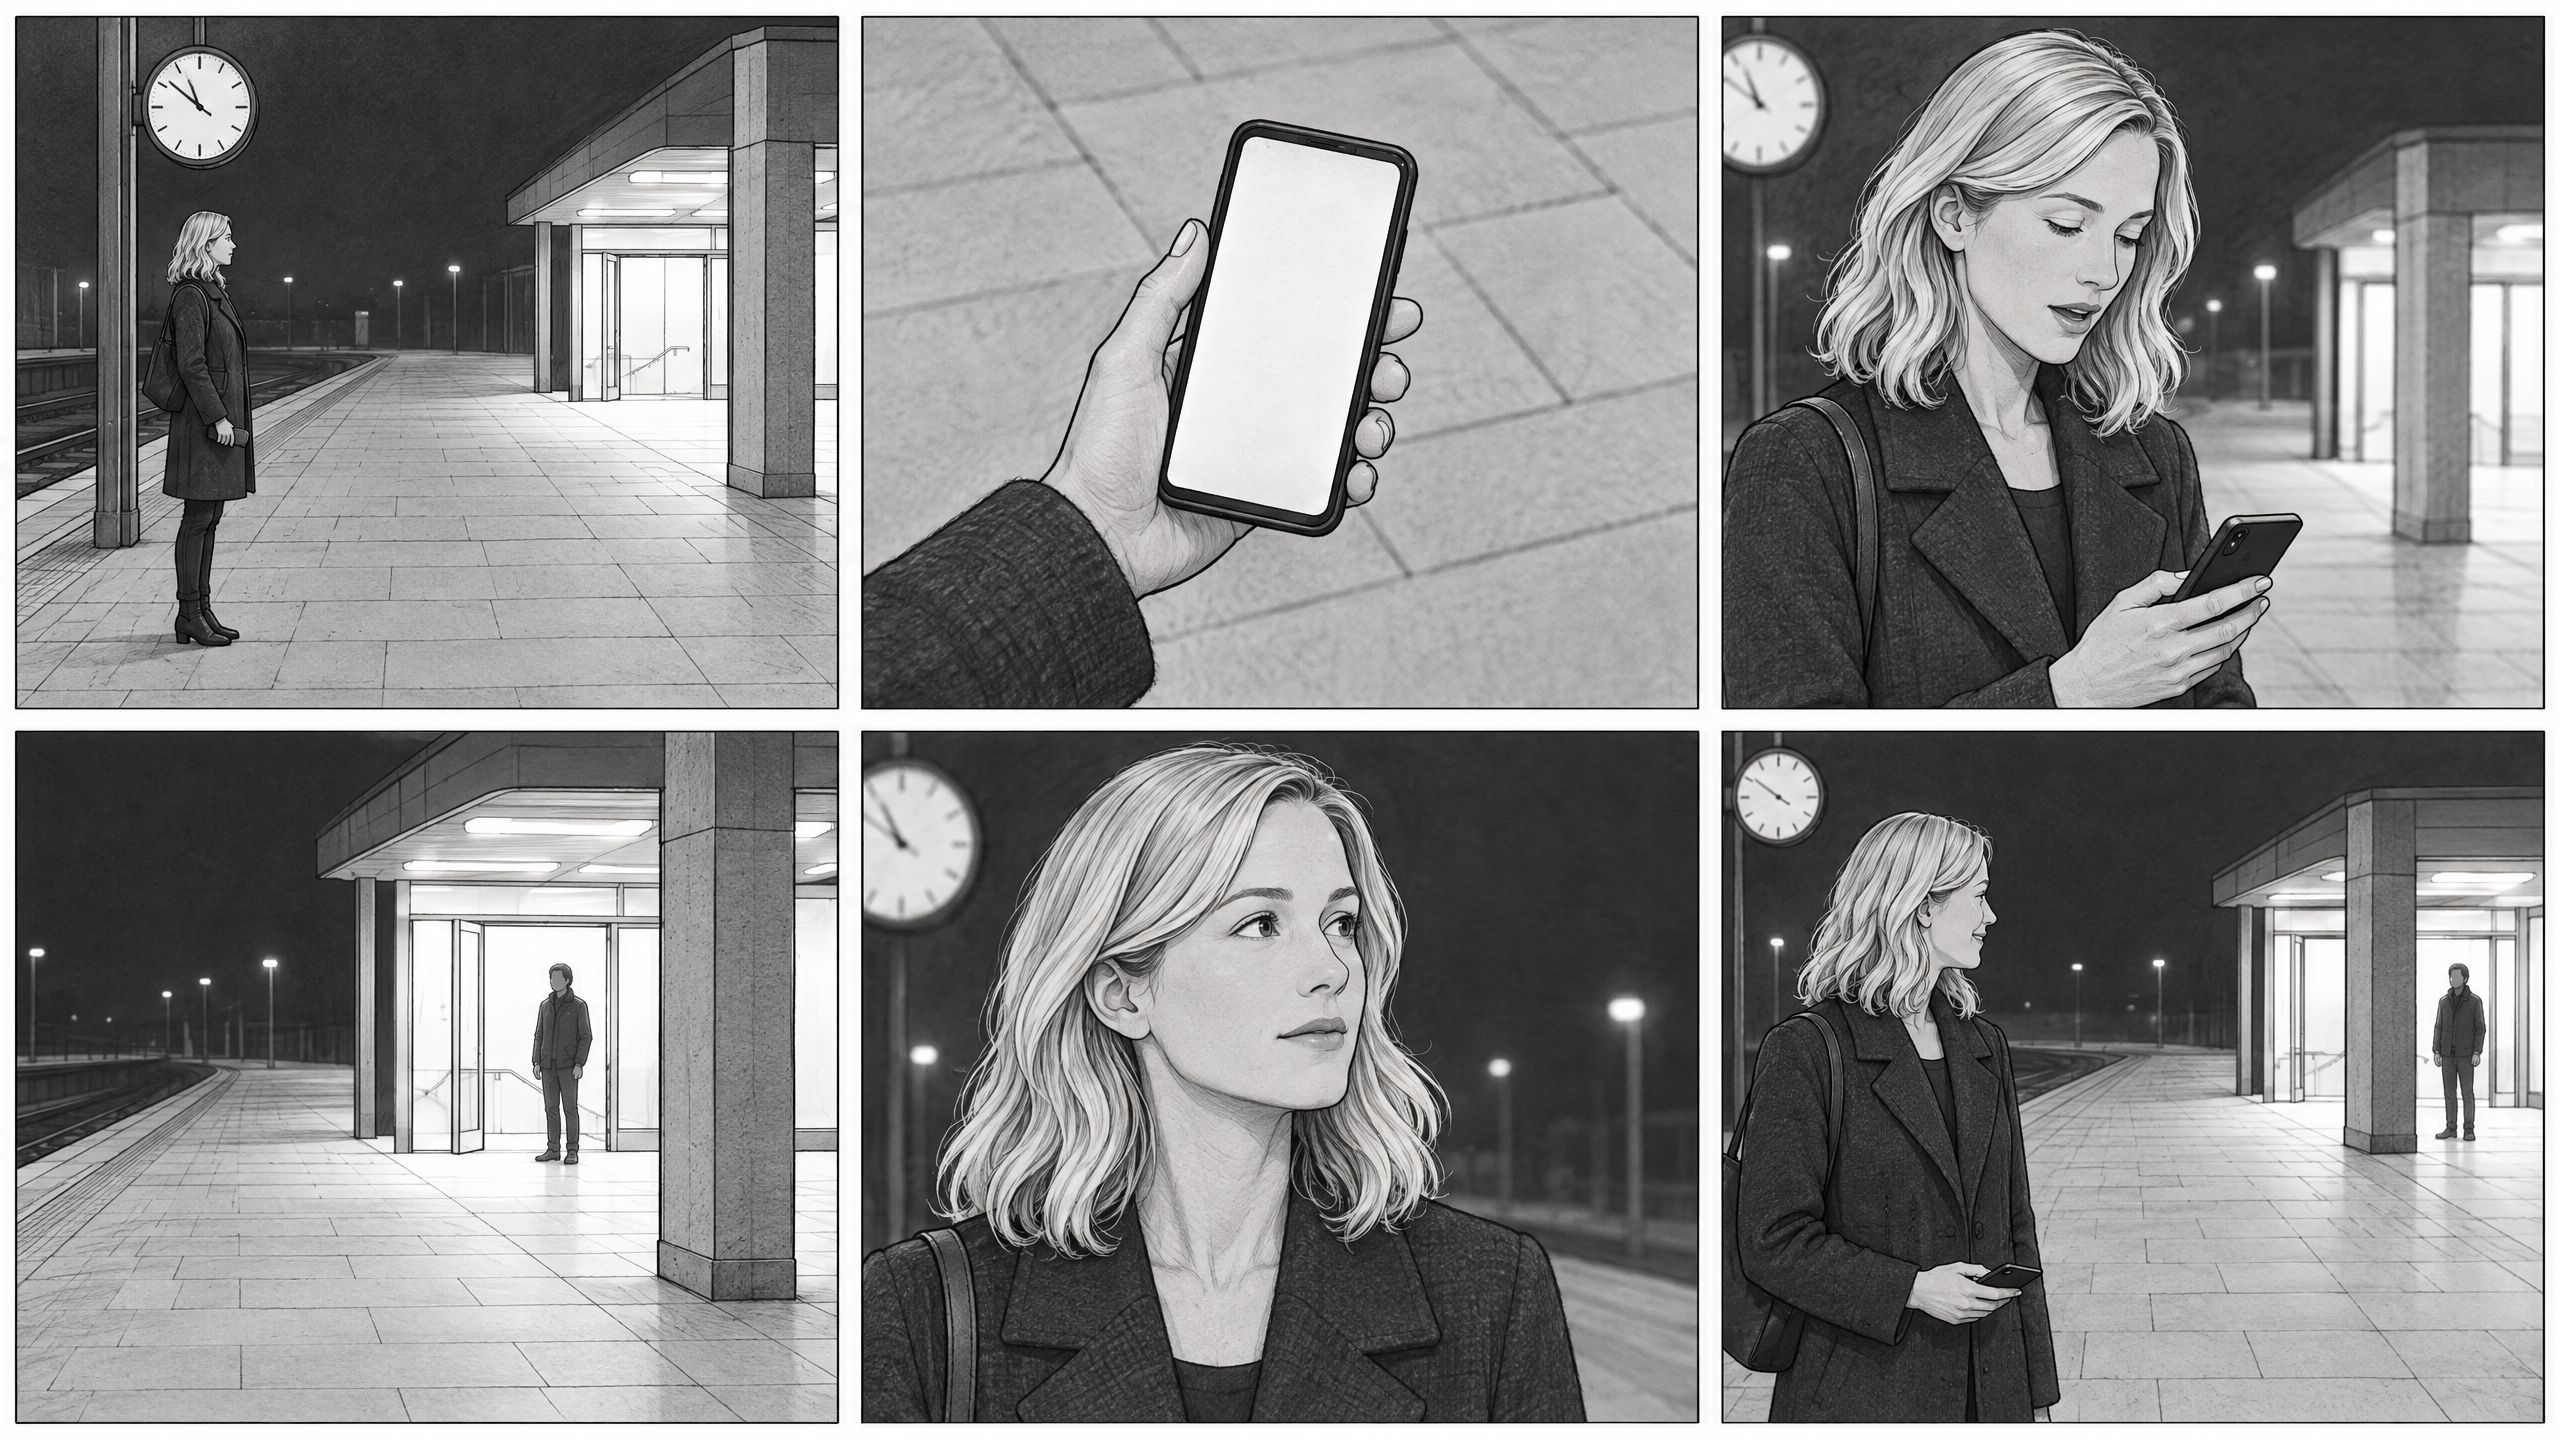
沿用 Part 2 的车站案例,六格依次表现等待、手机特写、说话、来人出现、抬头和微笑。最后一格把 Maya 放在左前景,来人留在右后方的入口,同时交代她的反应和视线对象。下面把提示词缩短,只保留布局、人物标识和每格的关键画面。
Create a six-panel storyboard: 3 columns × 2 rows, six equal landscape panels with narrow white gutters. Read left to right, top row then bottom row. One still moment per panel.

Style: Black-and-white pencil storyboard, simple lines and light gray shading.
Character: Maya is an adult Western woman with shoulder-length blonde hair and a dark coat. Her phone stays in her right hand.
Setting: Night train platform. Maya is on the left; the lit entrance is on the right, on the same platform. Keep the character and station layout consistent.

GRID01 (top-left): Wide shot. Maya waits beneath the station clock. The entrance on the right is empty.
GRID02 (top-center): Close-up. The phone in Maya’s right hand. Blank screen, dark coat sleeve.
GRID03 (top-right): Medium close-up. Maya looks down at her phone, lips parted as she speaks quietly.
GRID04 (bottom-left): Medium-wide shot. One person stands at the lit entrance on the right, facing left. Maya is outside the frame.
GRID05 (bottom-center): Close-up. Maya looks up toward the entrance on the right, her expression softening.
GRID06 (bottom-right): Medium-wide shot. Maya smiles in the left foreground, phone lowered in her right hand. The arriving person remains at the entrance in the right background.

No captions, panel numbers, speech bubbles, or watermarks. Do not draw the GRID labels.
这六格是用于检查故事的视觉节点,实际仍可按 Part 2 的四个镜头组织。图中最后一格是收尾状态,不能直接当作整场戏的起始画面。上图使用 GPT Image 2.5 Flare 生成;这里展示的是根据原始长 Prompt 整理的精简写法,尚未用精简版重新出图,也未进行成本对照测试。
视频范例:参考故事板的剧情,给模型留出发挥空间
把六宫格作为参考图交给视频模型时,可以只要求它参考剧情和情绪推进,再让它自行安排取景、运镜、节奏和细微动作。人物从等待,到说话、发现来人,再到释然微笑,这条故事线保持清楚即可。故事板的黑白线稿、明暗和格子布局不用照搬,视频采用自然色彩和符合场景的光线。
本次视频演示将 Part 2 的 18 秒计划压缩为 15 秒,使用 Seedance 2.0 标准版,设置为 720p、16:9,并开启声音。对于不能省略的动作,需要在 Prompt 中明确点出来:先从口袋取出手机,切手部近景接上抬起动作,再切中近景说话;后面用来人镜头、抬眼反应和双人构图承接。具体取景和各镜头时长仍留给模型安排。下面是实际使用的 Prompt:
Use Image 1 as a six-shot story guide. Keep the same woman, coat and station, with natural colors and believable lighting. Allow small changes in framing and performance.

1. Wide shot: she waits at the station, phone initially inside her right coat pocket. She reaches into that pocket and visibly pulls out the phone.
2. Cut to a hand close-up as the phone clears the pocket. Continue the same movement as she raises it and looks at the screen. Show this action clearly before the dialogue.
3. Match the movement into a medium close-up. Holding the phone in her right hand, eyes on the screen, she quietly says: "If you are coming, this is your last chance."
4. Cut to the entrance as a man arrives and pauses.
5. Cut back to her face: her eyes lift from the phone toward him, then her expression softens.
6. Finish wider, with her in the left foreground and him near the entrance on the right. She lowers the phone and smiles.

Keep the phone action continuous across cuts. Use full-screen shots, quiet station ambience, no grid or captions.
上方视频由这版 Prompt 生成,实测约 15.1 秒、1280 × 720。开头补出了从口袋取出手机、切近景查看的动作,后面接上说话、来人和抬头反应。结尾保留了两人的前后景关系,但微笑不如前一版明显,仍需要检查表演是否满足成片要求。这个案例尚未与纯文字生成做成本或质量对照。
四、先保留模型能力,再降低输出分辨率
选择模型和选择分辨率,是两个不同的问题。480p 的画面清晰度较低,但把 Seedance 2.5 的输出设为 480p,并不等于换成了更弱的模型。打样时先判断它有没有理解镜头顺序、人物动作和情绪,再决定是否需要提高画质。
对于复杂分镜,我更倾向于先用 Seedance 2.5 的 480p 测试,而不是为了 1080p 就选 Seedance 2.0。官方说明,2.5 在指令遵循和制作控制上有所增强,也支持按整秒时间点组织内容。这些能力与输出像素数是不同的维度,值得优先验证。但“2.5 的 480p 一定比 2.0 的 1080p 更理解每条分镜”,仍需要同一段 Prompt 的实际对照,不能仅凭型号和分辨率保证。
费用也支持先用低分辨率测试。以 BytePlus ModelArk 官方美元定价示例为准,在 16:9、输出 5 秒、不输入参考视频的相同条件下:
| 模型与输出分辨率 | 每条 5 秒视频的估算费用 |
|---|---|
| Seedance 2.5 · 480p | $0.514 |
| Seedance 2.0 · 1080p | $1.87 |
前者约便宜 72.5%。这比较的是整条视频费用:2.5 的每 Token 单价虽然更高,480p 所需的输出 Token 更少,合起来仍比 2.0 的 1080p 便宜。以上是官方估算示例,不是本次实测账单;参考视频、时长、画幅和平台加价都会改变最终费用。
具体到一场戏,可以先在 480p 下检查:手机有没有被拿出来,来人是否在正确的位置,人物的视线和前后动作能不能接上。480p 仍可以暴露这些问题,最终的皮肤纹理、发丝和远景细节再到高清阶段检查。不过,低清和高清两次独立生成可能改变动作与表演,不能默认逐帧复现。
如果工具支持 Seedance 2.5 Draft 工作流,可以先生成 480p 草稿,确认场景结构、镜头调度和动作,再用草稿任务生成高清版本。这条流程比重新提交一次独立生成更适合保持前后结果的一致性;草稿和高清任务分别计费,也应计入整场戏的总成本。
参考输入也只保留必要部分。人物外观和静态构图能用图片说明时,就先用图片;需要参考动作或运镜时,再加入相关视频片段。对于会计算输入视频时长的模型,多放一段参考也可能增加费用,所以要把输入和输出一起算。
实测:先用 480p 验证,再参考生成 1080p
下面用“士兵在树下读信”的场景,展示一次低分辨率验证到高清重生成的过程。480p 版本使用原有视频作为参考,要求依次表现树下坐姿、信纸特写、读信近景和拉远全景,并在约第六秒让信纸上出现手写文字。
这版实际输出为 864 × 496、约 15.1 秒。低分辨率已经足以判断四段镜头是否成立、读信动作能否接上。纸上也出现了手写字,但模型把指定的“Come home safe.”扩展成多行内容,没有准确落实文字要求。这样的错误在打样阶段就可以发现;如果文字必须准确,需要继续调整,或在后期处理,不能只提高分辨率就当作解决。
随后,将这条 480p 视频作为参考,仍使用 Seedance 2.0 标准版,输出设置改为 1080p、15 秒。提示词简化为保留人物、场景、动作和镜头顺序,增强自然光影与电影质感:
Use Video 1 as the reference. Keep the same soldier, face, uniform, tree, meadow, letter, actions and shot order. Maintain visual continuity and the original pacing. Enhance the scene with cinematic natural morning light, realistic skin and fabric detail, and restrained film color grading. Preserve the handwritten letter. No added subtitles or dialogue.
高清版本实际输出为 1920 × 1080、约 15.1 秒。从关键帧看,人物、军服、大树和草地总体保持一致,四段镜头结构也保留了。它说明低分辨率视频可以用于验证动作和结构,再为高清生成提供参考;但输出为 1080p,不代表细节必然准确恢复,人物与动作也不能默认逐帧一致。
本次两条视频是分别计费的参考生成任务,采用火山素材库的 asset:// 视频引用。它与前面介绍的 Seedance 2.5 Draft 工作流是两种操作方式。这里展示的是制作流程,未核对美元账单,也没有完成跨模型成本对照;前面的价格表仍是官方估算,不是这两条视频的实测费用。只有把需要的尝试次数和高清生成次数一起计入,才能判断整个流程是否省钱。
五、失败的素材,先看能不能剪
例如,一条六秒的素材,前三秒表演自然,后三秒手部变形。重新生成之前,可以先尝试在出错前切走,插入一个反应镜头,让声音继续。这样或许能保留前半段可用的表演,再根据剪辑效果决定是否需要补拍。
当然也要有底线,主角的脸错了,关键道具错了,动作的因果看不明白,这些影响观众理解故事的问题,不能为了省钱放过去。
剪辑时先圈出能用的时间段,再决定补什么镜头。人物说话时,可以在动作出错前切到听者反应,让对白继续;环境空镜也可以帮助衔接。不过,切走以后仍要检查视线、动作和声音是否连续。这是一种补救思路,不能保证每条失败素材都能救回来。
最后
控制成本,说到底就是控制返工。工具的价格会越来越低,但想不清楚就开始生成,花钱的速度永远比降价快。先想清楚要什么,用最便宜的办法验证,再把预算放在值得花的镜头上,这比任何比价都管用。