Beaucoup d'utilisateurs se demandent pourquoi, alors que le prix unitaire de la génération vidéo a déjà beaucoup baissé par rapport à l'année dernière, le coût de production d'une vidéo de 10 minutes n'a pas diminué. Je souhaite partager ici des idées et des solutions pour optimiser les coûts, en espérant que vous pourrez créer davantage de bonnes vidéos.
En m'appuyant sur mes tests de génération et sur les retours d'expérience publics de créateurs, je présente ci-dessous plusieurs méthodes pour réduire les reprises et maîtriser les coûts.
1. Le calcul doit se baser sur les plans réellement utilisables
Tout d'abord, il faut être clair : le plus gros coût de la création vidéo vient des générations répétées pour obtenir un extrait utilisable. Un créateur a partagé son expérience : pour un court-métrage IA de douze minutes, il a dépensé environ mille deux cents dollars, généré plus de neuf cents éléments, et n'en a finalement utilisé qu'environ deux cents. Pour les vidéos de moyenne et longue durée, le taux d'utilisation des matériaux n'est pas élevé.
Le coût réel de la génération vidéo dépend souvent du nombre d'essais nécessaires pour obtenir un plan utilisable. Par exemple, si un plan nécessite trois générations avant d'en sélectionner une version utilisable, son coût de génération est le triple du prix unitaire. Si seulement la moitié de la durée du matériau sélectionné peut être montée dans le film final, le coût calculé en fonction des secondes finalement utilisées double encore. Ces proportions ne sont que des exemples de calcul, pas des moyennes sectorielles. Le nombre réel d'essais nécessaires varie selon le modèle, la difficulté du plan, les prises de référence et les critères d'acceptation. Par conséquent, plutôt que de comparer les prix de génération unitaire, il est plus utile d'enregistrer le coût total de génération, le nombre d'essais et les secondes finalement utilisées, afin de calculer précisément combien coûte réellement chaque seconde du film fini.
2. Concevez d'abord votre storyboard grossier
Comme mentionné précédemment, il faut choisir le modèle et allouer le budget en fonction de la complexité des plans. Il y a aussi une condition préalable : vous devez d'abord déterminer quels plans sont nécessaires pour cette scène, ce que chaque plan doit exprimer, et si leur montage fonctionne. Si ces problèmes ne sont découverts qu'après la génération vidéo, vous supprimerez des matériaux déjà payés, et les reprises et modifications représenteront un coût supplémentaire.
Je recommande donc, avant de générer officiellement la vidéo, de faire une première conception de storyboard : ce que chaque plan doit exprimer, combien de personnages sont impliqués, s'il y a des actions complexes. Une fois le storyboard obtenu, marquez les plans ordinaires et les plans clés. Les plans d'ambiance et les transitions simples peuvent d'abord être testés avec des modèles à bas coût ; pour les champ-contrechamp à plusieurs personnages, les actions complexes et les performances clés, vérifiez en priorité si un modèle de haute qualité peut réduire les reprises. L'adéquation d'un modèle doit être jugée par le taux de réussite réel, pas seulement par la longueur du prompt.
Cette étape ne consiste pas à penser à la génération, mais à concevoir à l'avance, pour mieux gérer quels modèles votre vidéo nécessite et où investir des tokens en priorité. Si votre texte a du mal à décrire clairement le prompt, le modèle vidéo aura aussi du mal à comprendre votre intention ; ne perdez pas de temps à hésiter sur le modèle à utiliser. Un storyboard grossier statique ne peut pas non plus valider toutes les actions et performances, mais il permet de les écrire et d'éliminer à l'avance un certain nombre de générations inutiles. Utilisez d'abord un faible coût pour clarifier l'utilité et l'ordre des plans, puis dépensez de l'argent pour les animer.
Lorsque vous mélangez des modèles dans une même scène, vérifiez aussi si les images s'enchaînent bien. Comparez d'abord les différences de personnages, de matériaux, de lumière et d'expressions en utilisant les mêmes références de personnages et descriptions de scène ; si les retouches ultérieures sont trop nombreuses, les économies réalisées sur une seule génération peuvent être annulées. Le choix du modèle et l'allocation du budget doivent être déterminés ensemble à cette étape.
Pour essayer cette méthode dans Arcloop, partez d’un scénario ou d’une idée dans le générateur de mini-séries IA. Appuyez-vous sur votre découpage pour examiner les scènes et décider lesquelles méritent une nouvelle version.
Exemple : réservez d'abord du temps pour le dialogue et les réactions
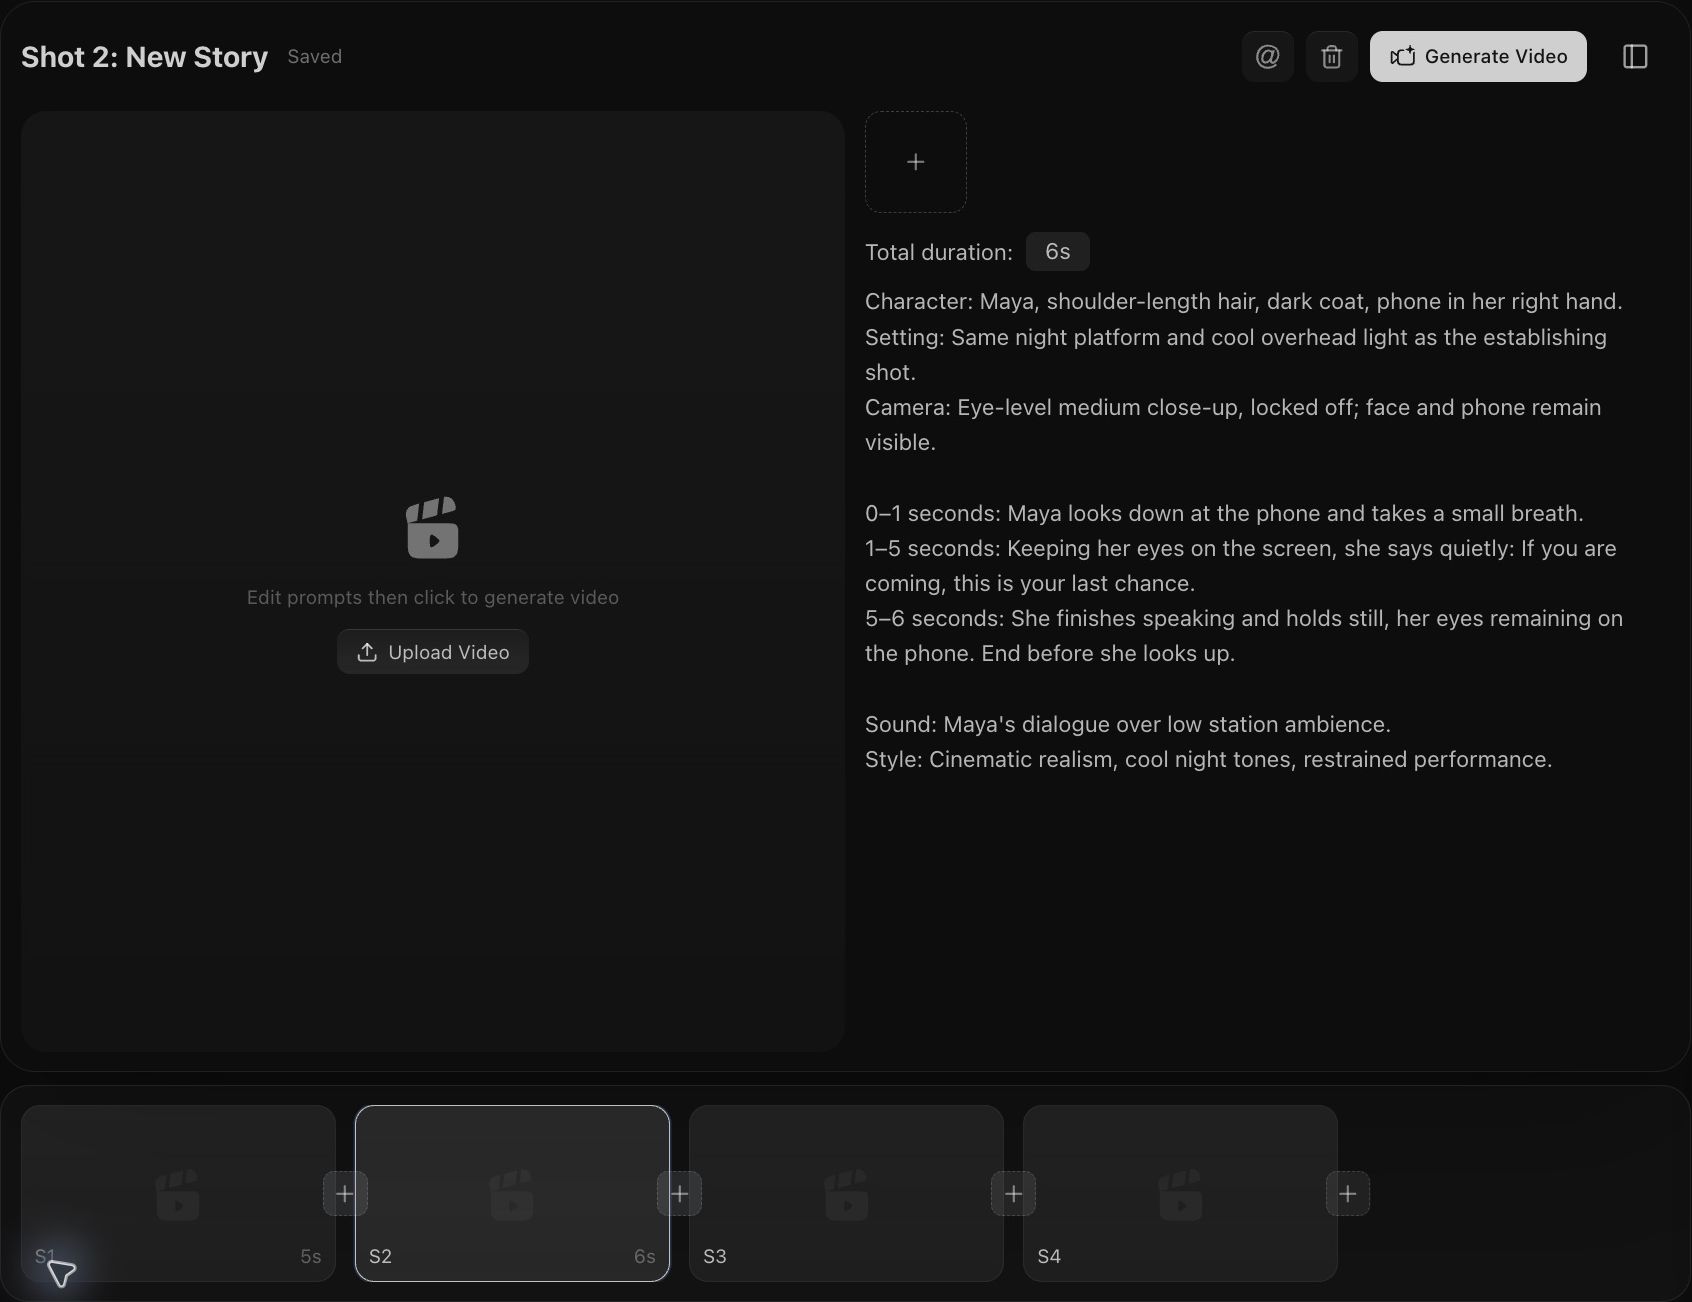
Voici un exemple de plan de storyboard pour une courte scène de 18 secondes. Déterminez d'abord la tâche de chaque plan, puis réservez du temps pour le dialogue et les réactions des personnages ; ces durées sont des objectifs de conception, à valider avec un son temporaire et un montage grossier.
| Plan | Objectif | Plage de montage | Durée |
|---|---|---|---|
| 01 | Établir l'attente | 00:00–00:04 | 4 s |
| 02 | Laisser de la place à la réplique | 00:04–00:10 | 6 s |
| 03 | Révéler l'arrivée | 00:10–00:13 | 3 s |
| 04 | Laisser la réaction s'installer | 00:13–00:18 | 5 s |
Prenons le deuxième plan comme exemple : on peut d'abord diviser les six secondes en trois phases : préparation, parole et pause :
Camera: Eye-level medium close-up, locked off.

0–1 seconds: Maya looks down at her phone and takes a small breath.
1–5 seconds: She says quietly: If you are coming, this is your last chance.
5–6 seconds: She holds still, eyes on the phone. End before she looks up.

Sound: Temporary dialogue over low station ambience.
Enregistrez d'abord un dialogue temporaire pour vérifier si six secondes suffisent pour parler naturellement, puis voyez si le plan de réaction des cinq dernières secondes peut enchaîner l'émotion. Si le dialogue est trop pressé ou la réaction trop courte, ajustez d'abord le storyboard et la durée du montage avant de passer à la génération vidéo.
3. Utilisez d'abord un storyboard pour la prévisualisation visuelle
Le storyboard grossier détermine l'utilité et l'ordre des plans ; le storyboard dessine ces idées. Où se tiennent les personnages, où regardent-ils, si deux images successives s'enchaînent bien : il est généralement plus facile de juger en les mettant côte à côte. Il convient de faire une prévisualisation visuelle avant la génération vidéo, pour vérifier d'abord la composition, les relations spatiales et les changements d'émotion.
Lors de la rédaction du prompt du storyboard, précisez d'abord les exigences de la grille : nombre de lignes et de colonnes, ordre de lecture, format de chaque case, et le fait que chaque case ne présente qu'un instant statique. Les personnages ne doivent conserver que les traits d'identification nécessaires, puis précisez pour chaque case le cadrage et l'état clé. Le texte ne doit pas être trop complexe : plus on accumule d'apparence, de contexte, d'actions et de restrictions, plus le modèle d'image a du mal à tout respecter simultanément, et risque de manquer les informations vraiment importantes.
Le storyboard ajoute aussi une couche de travail de production. Le modèle d'image doit gérer simultanément la disposition des cases, la cohérence des personnages et la continuité de la scène, et peut se tromper sur une case ou faire diverger les détails entre les images. En pratique, il vaut mieux utiliser des outils de storyboard professionnels, ou des outils d'image prenant en charge les images de référence, l'édition locale et l'exportation de cases individuelles, pour séparer la mise en page, la génération d'images et les modifications.
Si vous ne souhaitez modifier qu'une seule case, je recommande plutôt de découper d'abord cette case, puis de l'éditer ou de la régénérer séparément avec les références nécessaires de personnage ou de scène, et de la remettre en place après confirmation. Cela permet de conserver les autres images satisfaisantes et de comparer plus facilement si la modification s'enchaîne bien avec l'avant et l'après. Lorsqu'une case doit servir de première image vidéo, il faut aussi d'abord découper l'image correspondante, puis vérifier la netteté et l'état initial.
Exemple : utiliser une grille de six cases pour vérifier une même scène
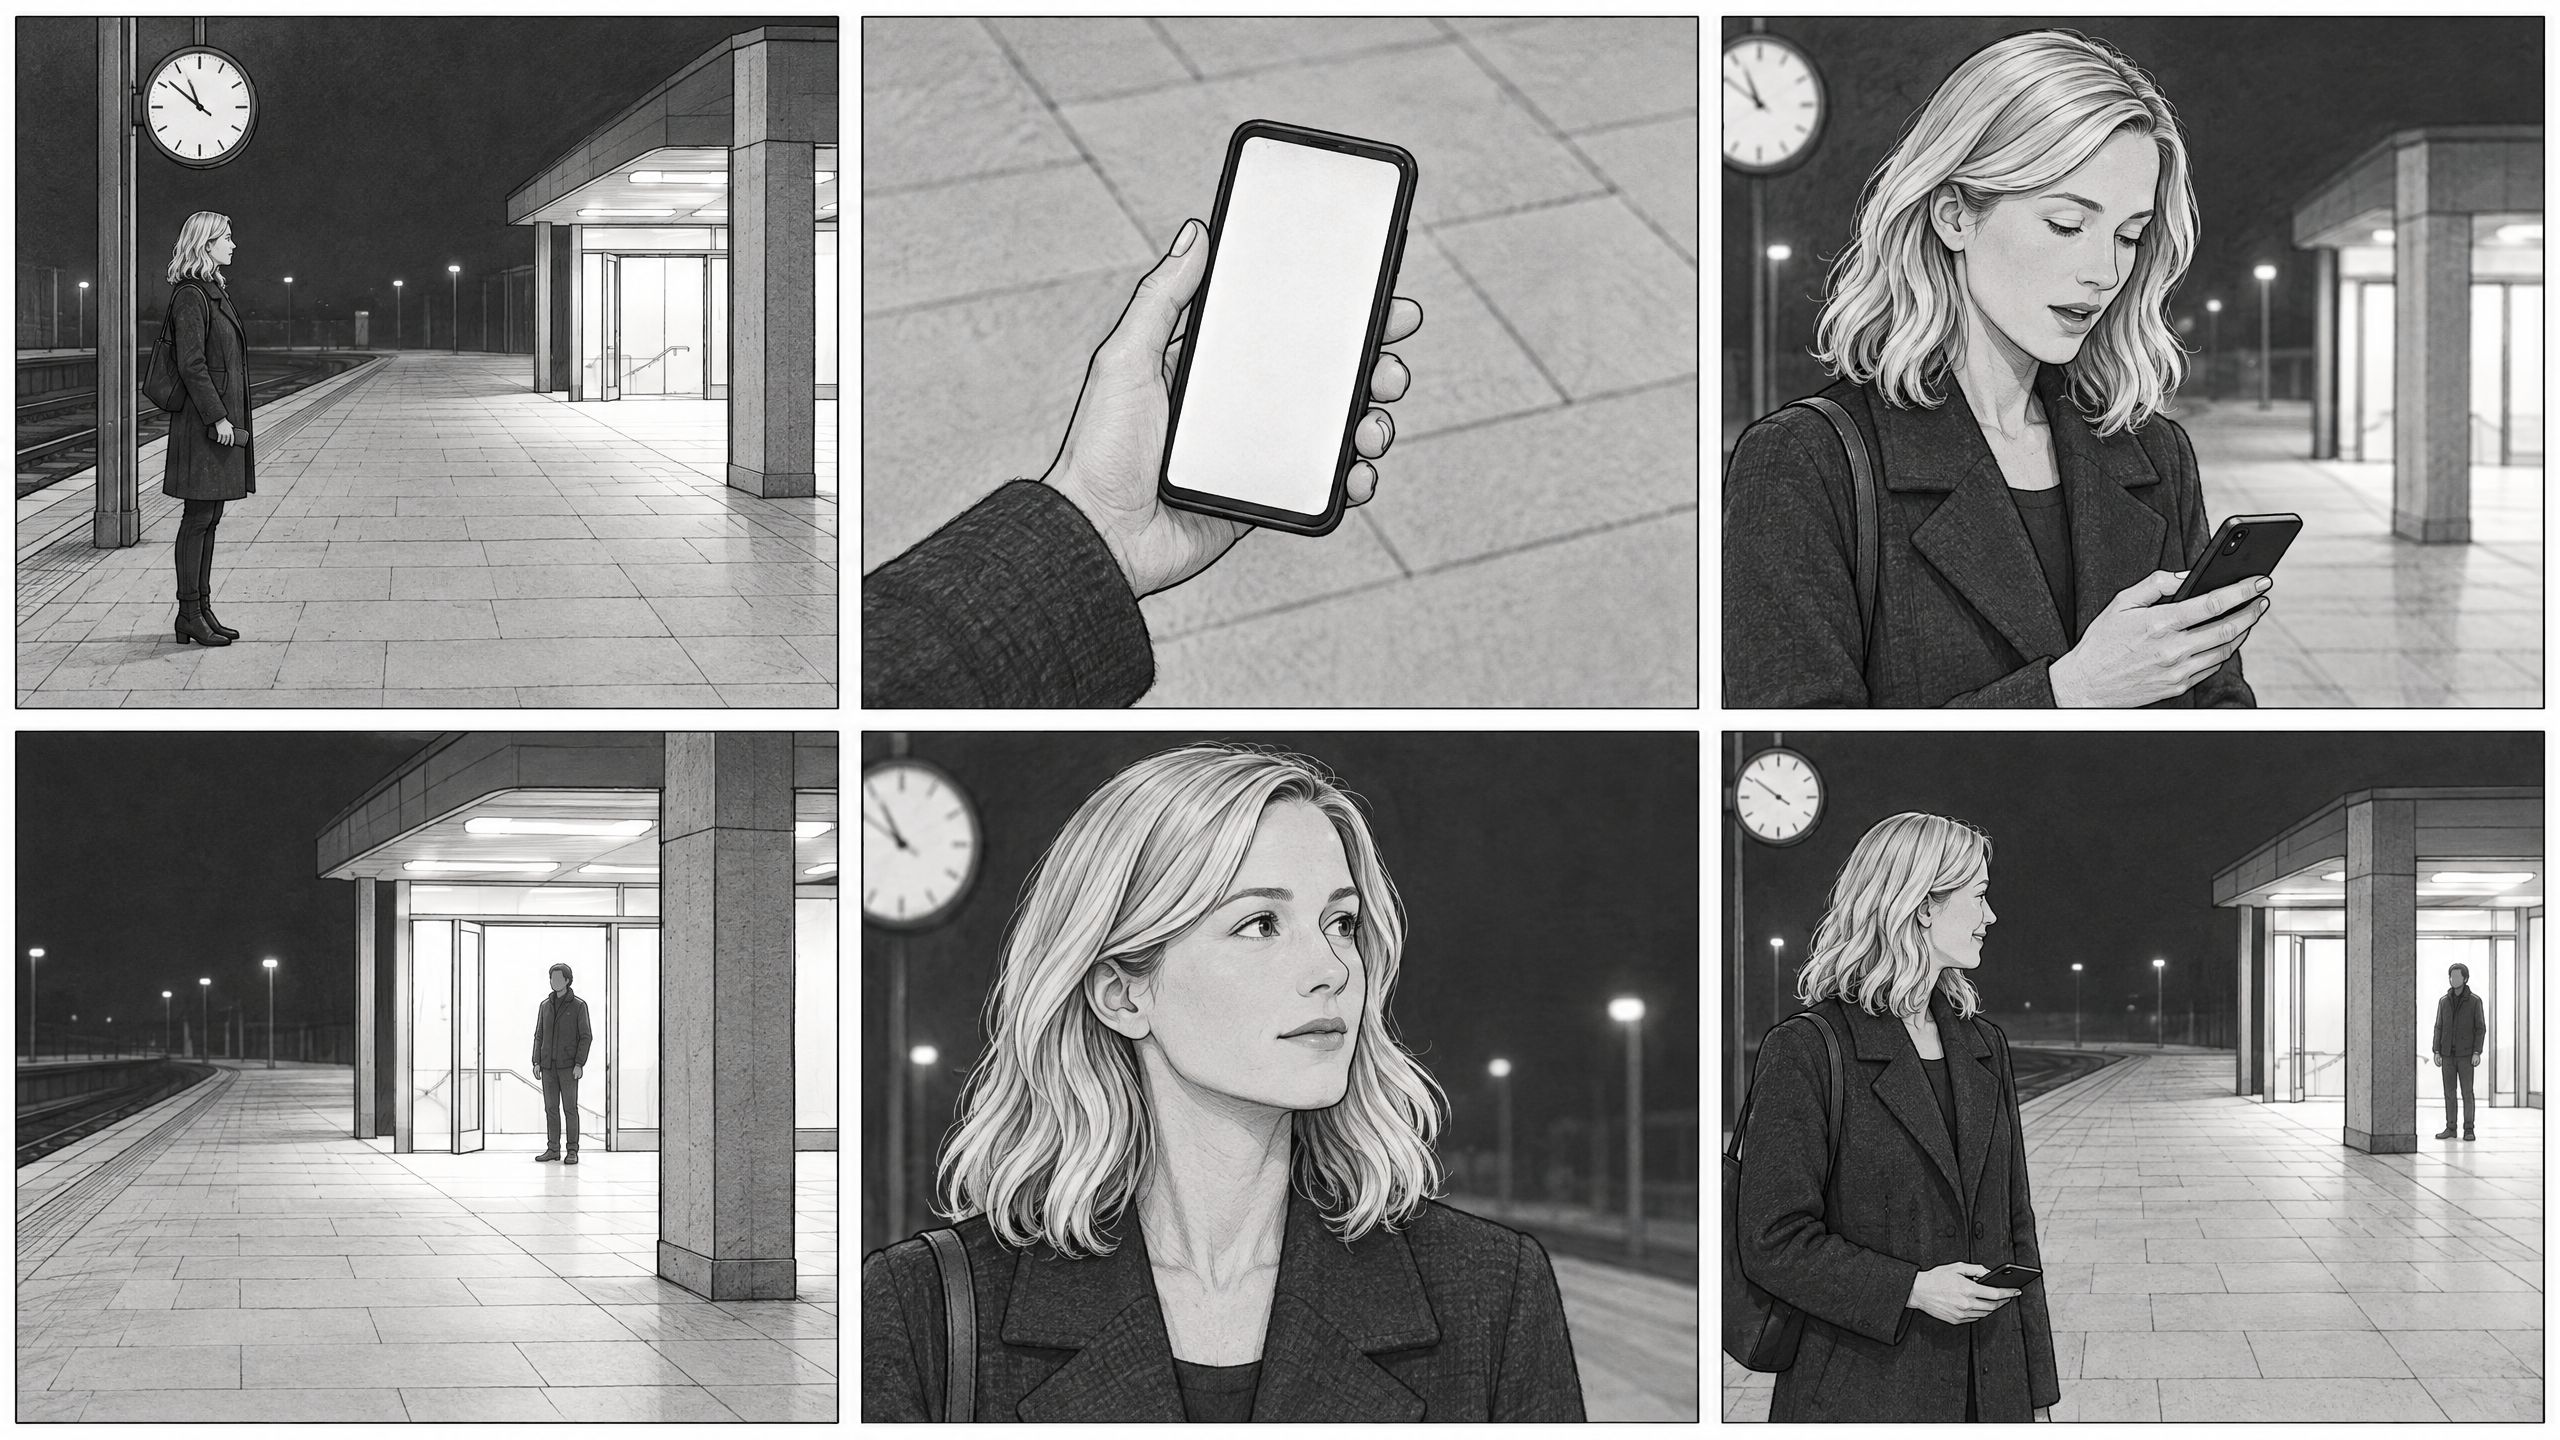
En reprenant le cas de la gare de la partie 2, les six cases montrent successivement l'attente, le gros plan du téléphone, la parole, l'apparition de la personne, le regard levé et le sourire. La dernière case place Maya au premier plan à gauche, la personne restant à l'entrée en arrière-plan à droite, montrant à la fois sa réaction et l'objet de son regard. Voici le prompt raccourci, ne conservant que la disposition, l'identification des personnages et l'image clé de chaque case.
Create a six-panel storyboard: 3 columns × 2 rows, six equal landscape panels with narrow white gutters. Read left to right, top row then bottom row. One still moment per panel.

Style: Black-and-white pencil storyboard, simple lines and light gray shading.
Character: Maya is an adult Western woman with shoulder-length blonde hair and a dark coat. Her phone stays in her right hand.
Setting: Night train platform. Maya is on the left; the lit entrance is on the right, on the same platform. Keep the character and station layout consistent.

GRID01 (top-left): Wide shot. Maya waits beneath the station clock. The entrance on the right is empty.
GRID02 (top-center): Close-up. The phone in Maya’s right hand. Blank screen, dark coat sleeve.
GRID03 (top-right): Medium close-up. Maya looks down at her phone, lips parted as she speaks quietly.
GRID04 (bottom-left): Medium-wide shot. One person stands at the lit entrance on the right, facing left. Maya is outside the frame.
GRID05 (bottom-center): Close-up. Maya looks up toward the entrance on the right, her expression softening.
GRID06 (bottom-right): Medium-wide shot. Maya smiles in the left foreground, phone lowered in her right hand. The arriving person remains at the entrance in the right background.

No captions, panel numbers, speech bubbles, or watermarks. Do not draw the GRID labels.
Ces six cases servent de repères visuels pour vérifier l'histoire, et l'organisation réelle peut toujours suivre les quatre plans de la partie 2. La dernière case de l'image est un état final et ne peut pas être utilisée directement comme image de départ de toute la scène. L'image ci-dessus a été générée avec GPT Image 2.5 Flare ; ce qui est montré ici est une version simplifiée du prompt long d'origine, qui n'a pas encore été utilisée pour régénérer l'image, et aucun test comparatif de coût n'a été effectué.
Exemple vidéo : s'inspirer du storyboard tout en laissant de la liberté au modèle
Lorsque vous fournissez la grille de six cases comme image de référence au modèle vidéo, vous pouvez lui demander uniquement de s'inspirer de l'intrigue et de la progression émotionnelle, puis le laisser organiser lui-même le cadrage, les mouvements de caméra, le rythme et les actions subtiles. Le personnage passe de l'attente à la parole, puis à la découverte de la personne, et enfin à un sourire soulagé ; cette ligne narrative doit rester claire. Les traits en noir et blanc, les ombres et la disposition en grille du storyboard ne doivent pas être copiés ; la vidéo utilise des couleurs naturelles et un éclairage adapté à la scène.
Cette démonstration vidéo compresse le plan de 18 secondes de la partie 2 en 15 secondes, en utilisant Seedance 2.0 Standard, réglé sur 720p, 16:9, avec le son activé. Pour les actions qui ne peuvent pas être omises, il faut les préciser explicitement dans le prompt : d'abord sortir le téléphone de la poche, couper sur un gros plan de la main pour enchaîner le mouvement de lever, puis couper sur un plan rapproché pour parler ; ensuite, utiliser le plan de la personne qui arrive, la réaction du regard levé et la composition à deux personnages pour enchaîner. Le cadrage précis et la durée de chaque plan sont laissés au modèle. Voici le prompt réellement utilisé :
Use Image 1 as a six-shot story guide. Keep the same woman, coat and station, with natural colors and believable lighting. Allow small changes in framing and performance.

1. Wide shot: she waits at the station, phone initially inside her right coat pocket. She reaches into that pocket and visibly pulls out the phone.
2. Cut to a hand close-up as the phone clears the pocket. Continue the same movement as she raises it and looks at the screen. Show this action clearly before the dialogue.
3. Match the movement into a medium close-up. Holding the phone in her right hand, eyes on the screen, she quietly says: "If you are coming, this is your last chance."
4. Cut to the entrance as a man arrives and pauses.
5. Cut back to her face: her eyes lift from the phone toward him, then her expression softens.
6. Finish wider, with her in the left foreground and him near the entrance on the right. She lowers the phone and smiles.

Keep the phone action continuous across cuts. Use full-screen shots, quiet station ambience, no grid or captions.
La vidéo ci-dessus a été générée avec ce prompt, mesurée à environ 15.1 secondes, 1280 × 720. Le début ajoute l'action de sortir le téléphone de la poche et de couper sur un gros plan pour vérifier, puis enchaîne sur la parole, l'arrivée de la personne et la réaction du regard levé. La fin conserve la relation de profondeur entre les deux personnages, mais le sourire est moins prononcé que dans la version précédente ; il faut encore vérifier si la performance répond aux exigences du film final. Ce cas n'a pas encore été comparé en termes de coût ou de qualité avec une génération purement textuelle.
4. Conservez d'abord les capacités du modèle, puis réduisez la résolution de sortie
Choisir un modèle et choisir une résolution sont deux questions différentes. Une image en 480p a une clarté moindre, mais régler la sortie de Seedance 2.5 sur 480p ne revient pas à passer à un modèle plus faible. Lors du brouillon, jugez d'abord s'il a compris l'ordre des plans, les actions des personnages et les émotions, puis décidez s'il faut améliorer la qualité.
Pour les storyboards complexes, je préfère d'abord tester avec Seedance 2.5 en 480p, plutôt que de choisir Seedance 2.0 pour le 1080p. Selon la documentation officielle, la version 2.5 présente des améliorations en matière de suivi des instructions et de contrôle de la production, et prend en charge l'organisation du contenu par points temporels à la seconde près. Ces capacités sont une dimension différente du nombre de pixels de sortie et méritent d'être vérifiées en priorité. Mais l'affirmation « le 480p de la 2.5 comprend toujours mieux chaque plan que le 1080p de la 2.0 » nécessite une comparaison réelle avec le même prompt, et ne peut pas être garantie uniquement par le modèle et la résolution.
Les coûts soutiennent également le test en basse résolution d'abord. En prenant comme référence les exemples de tarification officielle en dollars de BytePlus ModelArk, dans les mêmes conditions de 16:9, sortie de 5 secondes, sans vidéo de référence en entrée :
| Modèle et résolution de sortie | Coût estimé par vidéo de 5 secondes |
|---|---|
| Seedance 2.5 · 480p | $0.514 |
| Seedance 2.0 · 1080p | $1.87 |
Le premier est environ 72.5% moins cher. Cette comparaison porte sur le coût total de la vidéo : bien que le prix par token de la 2.5 soit plus élevé, le 480p nécessite moins de tokens de sortie, et l'ensemble reste moins cher que le 1080p de la 2.0. Ce qui précède est un exemple d'estimation officielle, pas une facture réelle de ce test ; les vidéos de référence, la durée, le format et les majorations de plateforme modifieront le coût final.
Pour une scène donnée, on peut d'abord vérifier en 480p : le téléphone a-t-il été sorti, la personne qui arrive est-elle à la bonne position, le regard des personnages et les actions successives s'enchaînent-ils ? Le 480p peut encore révéler ces problèmes ; les textures de peau, les cheveux et les détails en arrière-plan seront vérifiés à l'étape haute définition. Cependant, deux générations indépendantes en basse et haute résolution peuvent modifier les actions et les performances, et on ne peut pas supposer une reproduction image par image.
Si l'outil prend en charge le flux de travail Seedance 2.5 Draft, vous pouvez d'abord générer un brouillon en 480p, confirmer la structure de la scène, le découpage des plans et les actions, puis utiliser la tâche de brouillon pour générer une version haute définition. Ce flux est plus adapté que de soumettre à nouveau une génération indépendante pour maintenir la cohérence des résultats ; les tâches de brouillon et de haute définition sont facturées séparément et doivent être incluses dans le coût total de la scène.
Les entrées de référence ne doivent conserver que les éléments nécessaires. Lorsque l'apparence des personnages et la composition statique peuvent être expliquées par des images, utilisez d'abord des images ; lorsqu'il faut référencer des actions ou des mouvements de caméra, ajoutez les extraits vidéo pertinents. Pour les modèles qui facturent la durée des vidéos d'entrée, ajouter une référence supplémentaire peut aussi augmenter le coût ; il faut donc calculer ensemble les entrées et les sorties.
Test réel : valider d'abord en 480p, puis régénérer en 1080p avec référence
Voici une démonstration d'un processus de validation en basse résolution puis de regénération en haute définition, avec la scène « un soldat lit une lettre sous un arbre ». La version 480p utilise la vidéo existante comme référence, et demande de montrer successivement la position assise sous l'arbre, le gros plan de la lettre, le plan rapproché de la lecture et le plan large en recul, avec l'apparition d'un texte manuscrit sur la lettre vers la sixième seconde.
Cette version a une sortie réelle de 864 × 496, environ 15.1 secondes. La basse résolution suffit déjà à juger si les quatre plans fonctionnent et si l'action de lecture s'enchaîne. Du texte manuscrit apparaît aussi sur le papier, mais le modèle a étendu la phrase spécifiée « Come home safe. » en plusieurs lignes, sans respecter précisément l'exigence textuelle. De telles erreurs peuvent être détectées dès la phase de brouillon ; si le texte doit être exact, il faut continuer à ajuster ou le traiter en post-production, et on ne peut pas considérer qu'augmenter la résolution résout le problème.
Ensuite, cette vidéo 480p est utilisée comme référence, toujours avec Seedance 2.0 Standard, mais la sortie est réglée sur 1080p, 15 secondes. Le prompt est simplifié pour conserver le personnage, la scène, les actions et l'ordre des plans, en renforçant l'éclairage naturel et l'ambiance cinématographique :
Use Video 1 as the reference. Keep the same soldier, face, uniform, tree, meadow, letter, actions and shot order. Maintain visual continuity and the original pacing. Enhance the scene with cinematic natural morning light, realistic skin and fabric detail, and restrained film color grading. Preserve the handwritten letter. No added subtitles or dialogue.
La version haute définition a une sortie réelle de 1920 × 1080, environ 15.1 secondes. D'après les images clés, le personnage, l'uniforme militaire, le grand arbre et l'herbe restent globalement cohérents, et la structure en quatre plans est conservée. Cela montre qu'une vidéo basse résolution peut servir à valider les actions et la structure, puis fournir une référence pour la génération haute définition ; mais une sortie en 1080p ne garantit pas que les détails soient restitués avec précision, et les personnages et les actions ne peuvent pas être supposés identiques image par image.
Ces deux vidéos sont des tâches de génération avec référence facturées séparément, utilisant la vidéo asset:// de la bibliothèque d’actifs Volcengine. Il s'agit d'une méthode différente du flux de travail Seedance 2.5 Draft présenté précédemment. Ce qui est montré ici est le processus de production, sans vérification de facture en dollars ni comparaison de coûts entre modèles ; le tableau de prix précédent reste une estimation officielle, pas le coût réel de ces deux vidéos. Ce n'est qu'en comptabilisant ensemble le nombre d'essais nécessaires et le nombre de générations haute définition que l'on peut juger si l'ensemble du processus permet d'économiser de l'argent.
5. Pour les prises ratées, voyez d'abord si elles peuvent être sauvées au montage
Prenons une prise de six secondes : le jeu est convaincant pendant les trois premières, puis une main se déforme. Avant de relancer la génération, essayez de couper juste avant l’erreur, d’insérer un plan de réaction et de laisser le son se poursuivre. La partie réussie peut encore trouver sa place dans la scène. Vérifiez le montage avant de décider s’il faut produire d’autres plans.
Bien sûr, il faut aussi fixer des limites : si le visage du protagoniste est faux, si un accessoire clé est faux, si la causalité de l'action est incompréhensible, ces problèmes qui affectent la compréhension de l'histoire par le public ne doivent pas être laissés passer pour économiser de l'argent.
Au montage, délimitez d'abord les plages utilisables, puis décidez quels plans ajouter. Lorsqu'un personnage parle, on peut couper sur la réaction de l'auditeur avant que l'action ne se trompe, et laisser le dialogue continuer ; les plans d'ambiance peuvent aussi aider aux transitions. Cependant, après avoir coupé, il faut encore vérifier la continuité du regard, des actions et du son. C'est une idée de rattrapage, qui ne garantit pas que tous les prises ratées puissent être sauvés.
Enfin
Maîtriser les coûts, c'est en fin de compte maîtriser les reprises. Le prix des outils baissera de plus en plus, mais si vous commencez à générer sans avoir réfléchi, vous dépenserez toujours plus vite que la baisse des prix. Réfléchissez d'abord à ce que vous voulez, validez avec les moyens les moins chers, puis allouez le budget aux plans qui en valent la peine : c'est plus efficace que toute comparaison de prix.