草稿的价值只有一个:帮你决定下一步。角色这样进场,看得懂吗?镜头是不是贴得太近?那一拍停顿,真有人被留住吗?fal 的 H3 Max Turbo 大约一分钟就能回答这类问题——而且这时候改主意,还只是几分钱的事。
本文说的「MiniMax H3 Turbo」,指 fal 托管的 H3 Max Turbo。它首先是个草稿工具:动态分镜、运镜测试、氛围样片、补拍镜头。故事够小、又不要求和前一镜对得上时,它也能把一条独立片段做完——短篇儿童动画就在此列。但一部需要可复现的角色设计、连续性和精确修改的系列动画,我们不会把它当成唯一的生产流程。
想了解模型概况及其在 ArcLoop 上的功能,可以查看 MiniMax H3 Max 模型页。
为什么用 H3 Max Turbo:反馈更快,成本更低
价格是最抢眼的部分,但真正的好处是比较。一个想法只是猜测,三个才是决策。固定机位、缓慢推进、跟拍,各跑一条,趁三条都还在脑子里热着,挑出最服务这场戏的那一个。
fal 在 2026 年 9 月 8 日发布的文生视频基准里,一段五秒 768p 的 Turbo 片段推理耗时 1.54 秒,H3 Max 则是 2.46 秒。这是提供商自己报告的推理时间。排队、提示词扩写、编码、传输都会往钟表上加时间——所以它不是你在进度条前盯着的那个数,也不是 ArcLoop 的性能测量。
做预算时看 fal 公布的这几档标准价。不含促销,不含临时折扣,核对于 2026 年 10 月 25 日。
| 分辨率 | H3 Max Turbo,每秒成片 | H3 Max,每秒成片 |
|---|---|---|
| 480P | $0.025 | $0.05 |
| 768P | $0.04 | $0.08 |
| 1080P | $0.08 | $0.16 |
按 768P 的标价,一次五秒 Turbo 尝试是 $0.20;同一个镜头换 H3 Max 是 $0.40。Turbo 跑二十次,生成费用就是 $4——还没算折扣,也没算围绕它的那些活。价格会动,批量提交前先看一眼接口当天的报价。
Turbo 的位置:草稿、样片,和能独立成立的动画片段
Turbo 只该出现在两种场合:在真投入时间之前先探一探想法,或者把一个小到能自己站住的场景做完。先想清楚这一条是哪种,然后只按这个目的验收,别的都不算数。
| 用途 | 看什么 | 一个有用的结果能确立什么 |
|---|---|---|
| 走位草稿 | 入场、离场、角色之间的距离 | 调度读不读得懂 |
| 动态分镜或运镜测试 | 镜头长度、推进、横移、剪切点 | 整段节奏是不是想要的那个 |
| 画风或氛围样片 | 光线、色彩、动作叠在一起 | 视觉方向配不配这个故事 |
| 提案样片 | 用挑出来的镜头拼成一小段 | 团队或客户看不看得懂方案 |
| 独立儿童动画 | 一个清楚的动作,一句简短回应 | 没有前后剧集,这个小场景成不成立 |
发给客户之前先提醒一句:一条有说服力的提案样片,完全可能是靠临时配音、毛糙转场和连续性漏洞撑起来的。邮件里把这话写上。认可一个概念,和认可每集都要走的那套流程,是两回事。
简单的儿童视频,可以直接当成片
儿童短视频通常不需要连续剧情,也不需要一批下周还回来的角色。黏土机器人送信、小动物跟朋友打招呼、某个角色在叶子底下发现一件怪东西——每一个都可以是完整的一场戏,而不是某场戏的碎片。当全部要求只是一个看得懂的动作加一句简短回应时,Turbo 值得被考虑用来出成片,而不只是出草稿。
本文那只森林邮局就是这么搭的。橘色黏土机器人把信放上柜台,蜗牛邮局长回话。八秒,两个角色,一个场景,两句生成的对白。一个连续镜头里的小叙事节拍,不需要一串互相匹配的机位。
公式很无聊,但很稳:动作保持简单,角色一眼分得清,对白短到听一遍就跟得上。然后整条看一遍,专盯发音清不清楚、有没有多余动作、道具会不会中途变样、结尾到底收没收住。全过,它就是成片。要不要换个大模型重做一遍,是可选项,不是成人礼。
把它和系列作品分开的,是连续性。一部有固定角色、固定声音、事件互相勾连的儿童系列,背的担子和任何叙事动画一样重。而机器人和蜗牛之间一次性的问候,几乎不背什么。
为什么不拿 Turbo 单独做连续动画剧集
一条好看的片段,回答的是另一个问题——不是「下周还能不能再来一遍」那个问题。剧集里的同一个角色,得扛住新机位、新手势、新光线;道具要留在对的那只手上;你只要求改一个动作时,已经确认过的脸、服装和布景应该原封不动地回来。
fal 公开的 Turbo 接口覆盖文生视频,以及带首帧和尾帧控制的图生视频。截至 2026 年 10 月 25 日,我们在公开文档里没有找到独立的 H3 Max Turbo 参考生视频接口。首帧给你的是一个起始构图,它不是角色、场景、声音三套独立参考的打包;而 fal 的 H3 Max 参考生视频是另一个接口,行为也不一样。
声音也得单独安排。Turbo 能生成对白,但当前公开的参数表里没有专门的音色参考输入,于是没有任何东西拦住角色的声线在镜头之间飘。复用首帧锁不住声音。至于 target_audio_url,值得读两遍:它是用你提供的音频替换输出音轨,不是听完那段音频、再用同一个嗓子生成新台词。
只要是长线内容,就得有意识地去搭声音轨——固定的角色录音,或者一套专门的配音流程——再到后期替换、对齐对白。剪辑能处理时值和转场,但环境声和响度仍然得整段对齐。别指望分开生成的片子碰巧共享同一条嗓子。
输入边界的问题就卡在这儿。你可以把几样已经定稿的素材塞进同一张起始图,但这买不来一长串镜头上的稳定。它只是把连续性工作往上推,推到图片准备和审图环节——就算奏效,那也是真金白银的成本。
所以,投入之前先测这条流程。同一场戏取三个相连的镜头——全景、反打、近景——然后提一个小修改。看身份、空间关系、服装细节、道具位置、对白,还要看重试的时候,有多少本来已经确认过的东西被悄悄改掉了。
这些都不意味着 Turbo 做不出成品。有创作者完整记录过一支用 fal H3 Max Turbo 做的 MV:每个场景一张起始图,几次连续性重试,剪辑,再换上自己的音轨。那是实打实的成品项目。它也恰好用上了上面说的那一整套配套工作——而一支 MV,并不是一套可复用的剧集流程。
一段动画样片的实用流程
- 先定这次要判的是什么。 把草稿必须解决的东西写下来:一次入场、一个停顿、一个运镜,还是一场戏的调子。一次测试批不了四件事;硬要一起批,一件都判不下来。
- 准备镜头图。 走图生视频,就把角色、服装、道具放进你真正想要的起始构图里。用尾帧的话,确认它的动作和布局能从起点顺理成章地接过去。
- 生成一小批备选。 起始图、时长、分辨率全部钉死,一次只改一条指令。提示词扩写也钉死,否则你就多了一个会动的变量,最后什么也没学到。
- 放回它要去的语境里看。 做样片,就把选中的镜头配上临时对白或声音剪起来;做独立短片,就连同最终音轨和结尾一起看完。单独成立的一个镜头,照样可能接不上下一个。
- 按交付标准验收。 图、Prompt、耗时、剪辑备注都留着。达到要求就交。如果是连续段落的一部分,就用一套扛得住连续性和修改测试的流程——换个模型,不会自动复现同样的表演,或同样的运镜。
你可以在 AI 动漫生成器 里先备一段样片。围绕某个模型搭流程之前,先确认当前界面到底开放了哪些模型和输入控制项。
两个实例:一次运镜测试,一条黏土动画
两个案例都在 2026 年 10 月 25 日由本地脚本调用 fal H3 Max Turbo 生成。各自用了一张 ImageGen 首帧、图生视频模式、768P 请求、seed 20261025,并设 prompt_expansion_mode=disabled。下面贴的是完整提交原文,不是润色版。角色名只描述画面里看得见的人,不附带任何额外参考素材。
案例一:一次固定机位与小幅推进的对照
问题故意问得很窄:一点点运镜,能不能帮上这场安静的入场?两版共用同一张起始图和同一套动作,只差一句运镜指令。各生成一次——不重抽,也不挑那条好的。
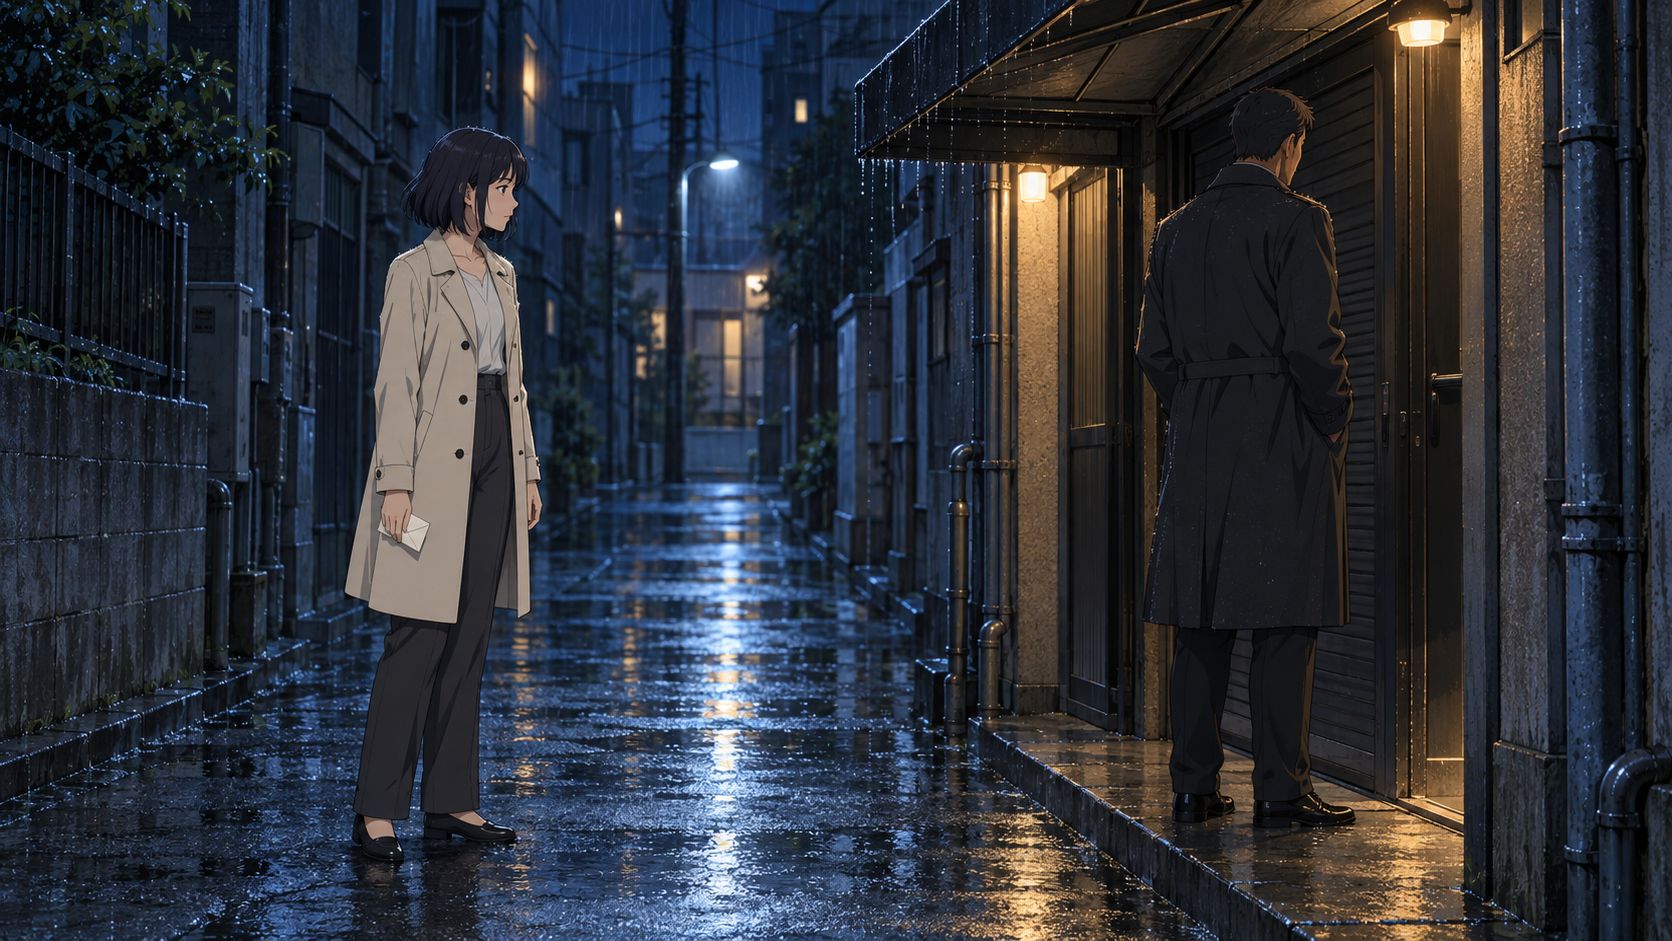
对照视频静音,左 A 右 B。两边都保留完整镜头时长;每一侧以 640×360 显示,放在 1280×720 的画布里。
A——完整提交原文,固定机位:
Animate the supplied first frame into a five-second 2D anime shot.
Rin, the woman in the ivory coat on the left, takes two slow steps to the right toward Sato, then stops before reaching him.
Sato, the man in the dark coat beneath the awning, stays in place with his back turned.
The folded letter stays in Rin's right hand at her side.
Static eye-level camera. Keep both characters fully visible.
Preserve the character designs, clothing, alley layout and blue-and-warm lighting from the starting image.
Gentle rain and distant traffic. No dialogue or music. One continuous shot, no cuts.
B——完整提交原文,小幅推进:
Animate the supplied first frame into a five-second 2D anime shot.
Rin, the woman in the ivory coat on the left, takes two slow steps to the right toward Sato, then stops before reaching him.
Sato, the man in the dark coat beneath the awning, stays in place with his back turned.
The folded letter stays in Rin's right hand at her side.
Very slow, small forward camera push at eye level. Keep both characters fully visible.
Preserve the character designs, clothing, alley layout and blue-and-warm lighting from the starting image.
Gentle rain and distant traffic. No dialogue or music. One continuous shot, no cuts.
按约半秒的间隔抽帧看,两条里凛都朝佐藤走过去然后停下。佐藤基本待在门口一带,信始终能在凛身侧看见。A 大约在 2.5 秒稳定下来,B 在 3 秒左右。推进很轻,背景和构图都还值得再细看。把这些标签当成「要求模型执行的指令」,而不是测出来的相机轨迹。
而这正是重点:这种决策,一份快草稿一个下午就能定。把两版都放进时间线,选调度更清楚的那条。每份 Prompt 只跑一次,既证明不了运镜可控,也排不出这两条指令的高下。
案例二:一条八秒的黏土场景,带英文对白
换个画风,做一个自己就能成立的场景:我们搭了个森林小邮局。橘色黏土机器人把信放到柜台上,蜗牛邮局长回话。紧凑是刻意设计的——一个场景、一个主要动作、一次简短交换——也正因如此,它才是检验独立儿童短片的公平样本。
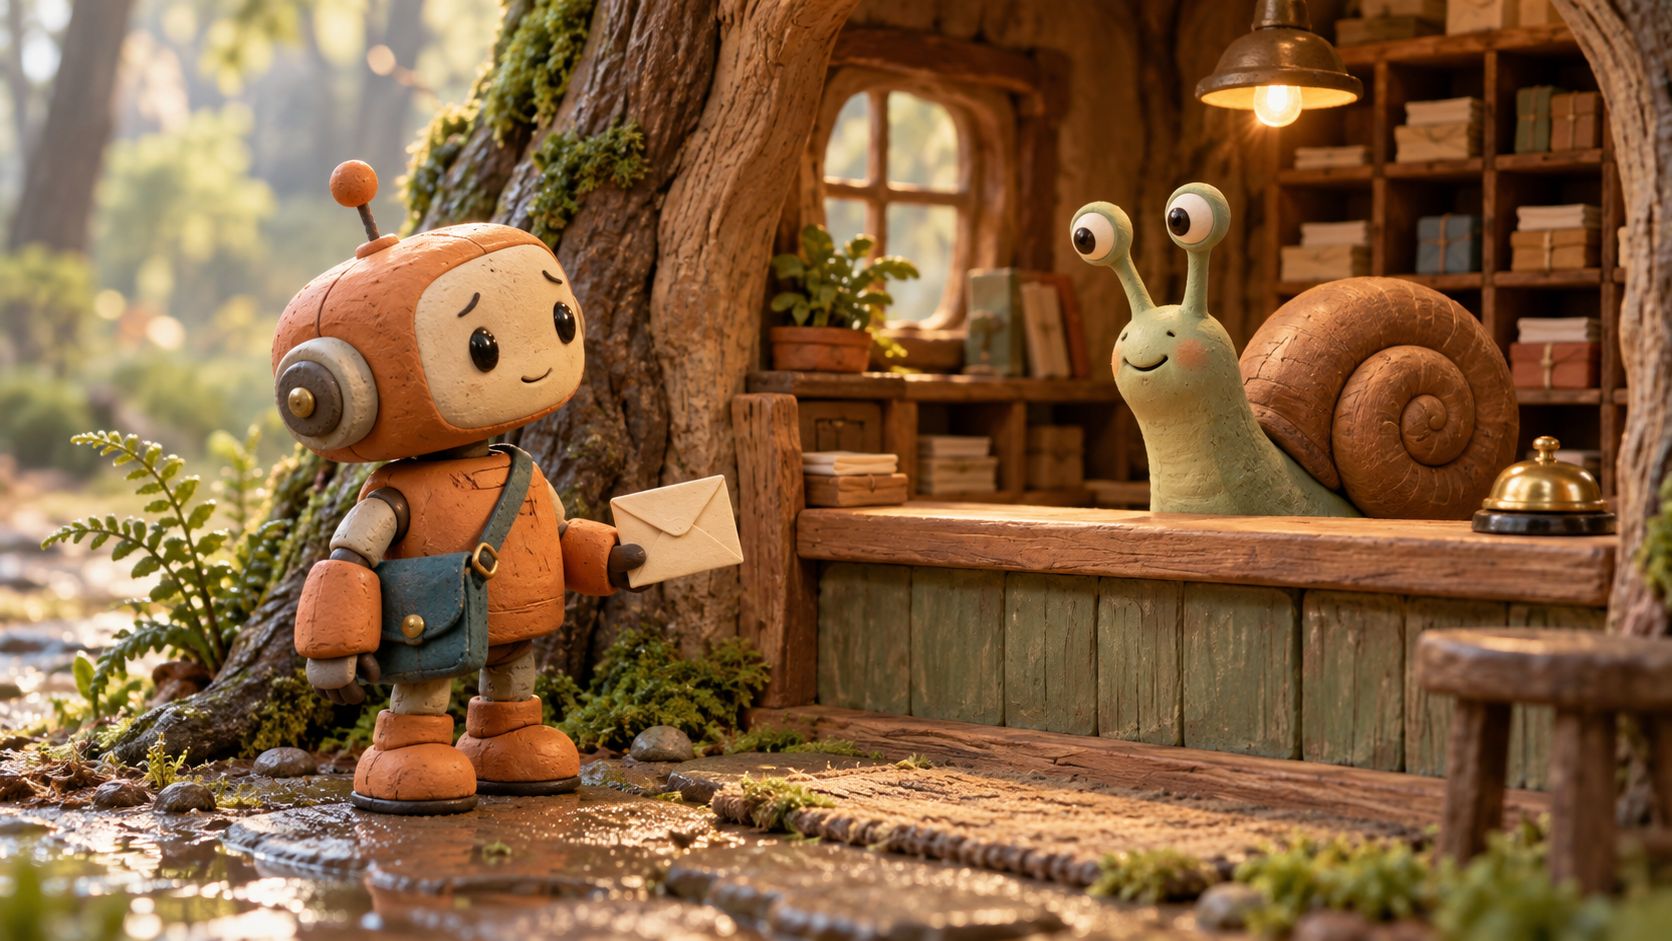
这一条记得开声音。八秒片段里放的是模型自己生成的音轨,没有外部配音,也没有替换音轨。它是英文对白那一版——在这之前还跑过一版纯环境声、一版中文需求;下面的计时只对应这次英文请求,不是整条开发路径。
完整提交原文,包括对白和预期节拍:
Animate the supplied first frame into an eight-second handcrafted 3D clay stop-motion film shot WITH CLEAR AUDIBLE ENGLISH DIALOGUE, synchronized character mouths and natural sound effects.

0–1 seconds: hold the starting pose. The little orange postal robot looks toward the snail postmaster, still holding the single cream envelope.

1–4 seconds: the robot gently extends its envelope-holding arm forward and slightly upward, then lays the envelope flat on the counter in front of the snail. Keep the hand and envelope clearly separate. The robot stays in the same spot. While extending the envelope, the robot says in English, in a bright, friendly, youthful and lightly metallic voice: “Your letter. Please sign here.” Its mouth moves with its own spoken words.

4–5 seconds: the robot releases the envelope and slowly withdraws its now-empty hand. The envelope remains resting flat on the counter. A soft paper rustle and a gentle contact sound accompany the delivery.

5–7 seconds: the friendly snail gives one slow blink, then replies in English in a warm, calm, slightly lower mature voice: “Thank you. Have a lovely day.” Its small mouth moves with its own words. The robot listens silently. The snail stays behind the counter and does not grow hands or arms.

7–8 seconds: hold the completed delivery. The robot looks pleased, the snail looks content, and the single envelope stays on the counter.

Audio is essential: both quoted dialogue lines must be clearly audible, complete and not overlap. Use two distinct character voices, no narrator. All spoken words must be in English only. Quiet forest birds and soft outdoor ambience stay underneath the speech. No music. Do not add subtitles or visible text.

Fixed eye-level camera, one continuous shot, no cuts, no zoom.
Preserve the characters, matte clay texture, subtle fingerprints, warm morning lighting and woodland post-office layout from the first frame. Movement is small, deliberate and tactile, with a gentle stop-motion feel.
抽帧能看到信封被递出、放平、再松手。自动转写没有给台词稿,也没有预设语言,检测到英文,并把两句原样复原:「Your letter. Please sign here.」和「Thank you. Have a lovely day.」。这只能说明音轨里确实有这两句话、而且听得清,不能说明口型逐帧对得上,也不能说明这声音在后面的片子里还稳得住。Prompt 里的时间点是描述的预期顺序,不是核对过的逐帧时间表。
真正有用的是这个形状:一个小场景,不需要一串互相匹配的机位。对白要更长,上面那套声音流程照旧适用。用文字描述一条嗓子,不等于有了可复用的音色参考;片段之间,你多半还是得剪,或者重新配。
实际等待时间与输出设置
| 请求 | 请求时长 | 提交到出结果 | 返回的推理耗时 | 提交到下载完成 |
|---|---|---|---|---|
| 小巷 A,固定机位 | 5 seconds | 6.09s | 1.55s | 9.11s |
| 小巷 B,小幅推进 | 5 seconds | 5.46s | 1.54s | 7.77s |
| 黏土场景,英文对白 | 8 seconds | 7.16s | 2.96s | 10.32s |
「提交到出结果」包含网络往返,以及约每秒一次的状态轮询;不含首帧上传、之后的转码和语音转写核验。推理一栏是提供方返回的 timings.inference。这些数字都不测 ArcLoop 应用链路;三条都是单次运行——记录的是这次发生了什么,不是基准测试,也不是对典型等待时间的承诺。
三条原片回来的都是 1344×768、24 fps。小巷两条各 124 frames,约 5.17 seconds;黏土那条 192 frames,正好八秒。720p 导出保留完整帧序列,等比例缩放并补边到 1280×720——不调速、不插帧、不裁切。我们没有核对过供应商账单,所以前文那笔标准价算术只是估算,不是这几次请求的实际扣费。
别让草稿预算,变成重试预算
不管是在探一场戏,还是在做一条成片,按下生成之前先想清楚:什么才算有用的结果。定个预算,定个重试上限,把「什么时候停」的理由写下来。再加一条:每次重试打算修什么——不然你只是在花钱买变体。
生成费用,和图片准备、审看、剪辑、修补的时间,分开记。做草稿,就数你真正解决掉的走位或机位问题;做生产,就数通过完整交付标准的镜头。这是两种结果,混在一起取平均,什么也说明不了。
还有一种情况:连续几次尝试都在挪动确认过的道具、改掉一张脸、或者把空间关系弄塌,那就停下这批。修起始图,简化动作,或者换到一套带这个镜头所需控制的流程。还在探索的时候,多几版是帮忙;一旦你是在守住一个已经做好的决定,多几版就开始变贵了。
MiniMax H3 Turbo 常见问题
H3 Max Turbo 能用来做完成的动画剧集吗?
做草稿、动态分镜、样片,以及能独立成立的成品动画——包括连续性要求不高的简单儿童短片——可以。至于前后勾连的剧集,在相连镜头测试和修改测试达到你自己的要求之前,别把它当成唯一的生产流程。一条好看的短片,说明不了整部剧的连续性,也说明不了改一次要花多少。
Turbo 能接受多个角色参考吗?
截至 2026 年 10 月 25 日查到的 fal Turbo 公开文档,描述的是文生视频,以及带首帧和尾帧的图生视频。我们没有找到独立的 Turbo 参考生视频接口。要么把场景做进首帧图里,要么在必须分开给参考素材时,换到有文档支持的参考流程。
我需要一块 44 GB 的显卡吗?能导出 1080P 吗?
fal 那边跑着模型,本地不用买显卡。Turbo 的参数表列了 480P/768P/1080P;1080P 是从原生 768P 源细化出来的。至于后半句——不行。像素再多,也修不好连续性、人体结构,或者你修改时有多痛苦。