Un brouillon ne vaut la peine d'être produit que s'il vous aide à décider de la suite. L'entrée se lit-elle ? La caméra est-elle trop près ? La pause retient-elle vraiment l'attention de quelqu'un ? H3 Max Turbo de fal répond à ce genre de questions en une minute environ, à un moment où changer d'avis coûte encore quelques centimes.
Dans ce guide, « MiniMax H3 Turbo » désigne H3 Max Turbo hébergé par fal. C'est d'abord un outil de brouillon : animatiques, tests de caméra, échantillons d'ambiance, plans de raccord. Il peut aussi terminer un clip autonome quand l'histoire est courte et que rien n'a besoin de s'accorder au plan précédent — courte animation pour enfants comprise. Pour un anime épisodique qui exige des designs de personnages reproductibles, de la continuité et des révisions précises, nous n'en ferions pas le seul workflow de production.
Pour découvrir le modèle et ses fonctionnalités sur ArcLoop, consultez la page du modèle MiniMax H3 Max.
Pourquoi utiliser H3 Max Turbo ? Un retour plus rapide, à moindre coût
Le prix fait la une, mais le vrai bénéfice, c'est la comparaison. Une idée reste une supposition. Trois, une décision. Vous pouvez lancer le plan fixe, le lent travelling avant et le mouvement de suivi, puis choisir celui qui sert la scène pendant que les trois sont encore frais dans votre tête.
Le benchmark texte-vers-vidéo publié par fal le 8 septembre 2026 annonce 1,54 seconde d'inférence pour un clip Turbo de cinq secondes en 768p, contre 2,46 secondes pour H3 Max. Ce sont des temps d'inférence déclarés par le fournisseur. File d'attente, expansion de prompt, encodage et livraison s'ajoutent à la montre : ce n'est donc pas le chiffre que vous fixerez en attendant, et ce n'est pas non plus une mesure de performance ArcLoop.
Pour le budget, fal affiche ces tarifs standard. Sans promotion ni remise temporaire, relevés le 25 octobre 2026.
| Résolution | H3 Max Turbo, par seconde produite | H3 Max, par seconde produite |
|---|---|---|
| 480P | $0.025 | $0.05 |
| 768P | $0.04 | $0.08 |
| 1080P | $0.08 | $0.16 |
Au tarif 768P affiché, une tentative Turbo de cinq secondes coûte $0.20. Le même plan sur H3 Max coûte $0.40. Vingt tentatives sur Turbo représentent $4 de frais de génération, avant remises et sans compter tout le travail autour. Les prix bougent : vérifiez l'endpoint avant de lancer un lot.
Où Turbo trouve sa place : brouillons, échantillons et clips d'animation autonomes
Turbo mérite sa place dans deux situations : explorer une idée avant d'y consacrer du vrai temps, et finir une petite scène qui tient debout toute seule. Décidez dans quel cas vous êtes, puis jugez le résultat sur cet objectif, et sur rien d'autre.
| Usage | Ce qu'il faut vérifier | Ce qu'un résultat utile établit |
|---|---|---|
| Brouillon de mise en place | Entrée, sortie et distance entre les personnages | Si le placement est lisible |
| Animatique ou test de caméra | Durée du plan, travelling avant, panoramique et point de coupe | Si la séquence a le rythme voulu |
| Échantillon de look ou d'ambiance | Lumière, couleur et mouvement ensemble | Si la direction visuelle sert l'histoire |
| Échantillon de pitch | Un court passage monté à partir de plans choisis | Si une équipe ou un client comprend la proposition |
| Animation pour enfants autonome | Une action claire et une réaction courte | Si la petite scène fonctionne sans les épisodes autour |
Un bémol avant d'envoyer quoi que ce soit à un client : un échantillon de pitch convaincant peut très bien tenir avec des voix provisoires, des transitions approximatives et des ruptures de continuité. Dites-le dans le mail. Approuver un concept n'est pas approuver le pipeline qu'il faudrait pour chaque épisode.
Les vidéos simples pour enfants peuvent être un travail fini
Une courte vidéo pour enfants n'a souvent besoin ni d'une intrigue continue ni d'un casting qui revient la semaine suivante. Un robot en pâte à modeler qui livre une lettre, un petit animal qui salue un ami, un personnage qui découvre quelque chose de bizarre sous une feuille : chacun de ces moments peut être une scène complète plutôt qu'un fragment. Quand tout l'enjeu tient dans une action lisible et une réponse brève, Turbo vaut d'être envisagé pour le clip final, pas seulement pour le brouillon.
L'exemple du bureau de poste en forêt, plus loin dans cet article, est construit exactement comme ça. Un robot orange en pâte à modeler pose une lettre sur le comptoir ; un escargot maître de poste répond. Huit secondes, deux personnages, un seul décor, deux courtes répliques de dialogue généré. Un petit battement narratif en un seul plan continu, sans avoir à enchaîner des axes de caméra raccord.
La recette est ennuyeuse mais fiable : gardez l'action simple, rendez les personnages faciles à distinguer, et gardez un dialogue assez court pour être suivi à la première écoute. Ensuite, regardez l'ensemble en cherchant une parole nette, des mouvements parasites, des accessoires qui changent en cours de plan et une fin qui tombe vraiment juste. Si le clip passe cette barre, c'est le clip final. Le régénérer dans un modèle plus gros est une option, pas un rite de passage.
Ce qui sépare ce cas du travail de série, c'est la continuité. Une série pour enfants avec des personnages récurrents, des voix récurrentes et des événements liés porte la même charge que n'importe quelle autre animation narrative. Un bonjour sans lendemain entre un robot et un escargot, presque aucune.
Pourquoi nous n'utiliserions pas Turbo seul pour une série animée continue
Un clip qui a l'air bon répond à une autre question qu'un pipeline que vous pourrez relancer la semaine prochaine. Dans une série épisodique, le même personnage doit survivre à de nouveaux angles, de nouveaux gestes, une nouvelle lumière. Les accessoires restent dans la bonne main. Et quand vous demandez de changer une action, le visage, le costume et le décor validés doivent revenir intacts.
Les endpoints publics Turbo de fal couvrent le texte-vers-vidéo et l'image-vers-vidéo avec contrôle de la première et de la dernière image. Au 25 octobre 2026, nous n'avons trouvé aucun endpoint H3 Max Turbo dédié à la vidéo par référence dans la documentation publique. Une première image vous donne une composition de départ. Ce n'est pas un faisceau de références indépendantes pour le personnage, la scène et la voix, et la vidéo par référence de H3 Max chez fal est un autre endpoint, au comportement différent.
La voix demande aussi son propre plan. Turbo génère du dialogue, mais le schéma public actuel n'a pas d'entrée dédiée à une référence vocale : rien n'empêche donc l'identité vocale d'un personnage de dériver d'un plan à l'autre. Réutiliser une première image ne verrouille pas la voix. Et target_audio_url mérite d'être lu deux fois : il remplace la bande-son de sortie par un audio que vous fournissez. Il n'écoute pas ce clip pour générer de nouvelles répliques avec la même voix.
Pour tout ce qui dure, cela signifie construire la piste voix exprès — des enregistrements cohérents par personnage ou un workflow vocal dédié — puis remplacer et synchroniser le dialogue au montage. Le montage gère le timing et les transitions ; l'ambiance et le niveau sonore doivent encore être harmonisés sur toute la séquence. Ne partez pas du principe que des clips générés séparément partageront une voix par hasard.
C'est là que la limite des entrées mord. Vous pouvez entasser plusieurs éléments déjà validés dans une seule image de départ, mais cela ne vous achète pas la stabilité sur une suite de plans. Le travail de continuité remonte en amont, dans la préparation et la revue des images — un coût réel, même quand ça marche.
Testez donc le workflow avant de vous engager. Prenez trois plans raccord d'une même scène — un large, un contrechamp, un gros plan — puis demandez une petite révision. Vérifiez l'identité, la géographie, les détails du costume, la position des accessoires, le dialogue, et la quantité de matière déjà validée qui se fait discrètement réécrire pendant la nouvelle tentative.
Rien de tout cela ne signifie que Turbo ne peut pas produire un travail fini. Un créateur a documenté un clip musical complet réalisé avec fal H3 Max Turbo : une image de départ par scène, quelques reprises de continuité, du montage et une bande-son de remplacement. C'est un projet véritablement fini. Il a aussi demandé exactement le travail d'accompagnement décrit plus haut, et un clip musical ne fait pas un processus épisodique reproductible.
Un workflow pratique pour un court échantillon d'anime
- Choisissez d'abord la décision. Écrivez ce que le brouillon doit trancher : une entrée, une pause, un mouvement de caméra, le ton d'une scène. Un seul test ne peut pas valider les quatre, et vouloir tout valider fait que rien ne devient concluant.
- Préparez l'image du plan. Pour l'image-vers-vidéo, placez le personnage, le costume et les accessoires dans la composition de départ que vous voulez vraiment. Si vous utilisez une image de fin, assurez-vous que son action et sa composition peuvent suivre le début de façon plausible.
- Générez un petit jeu d'alternatives. Gardez fixes l'image de départ, la durée et la résolution, et ne changez qu'une instruction à la fois. Gardez aussi l'expansion de prompt fixe, sinon vous avez ajouté une seconde variable mobile et vous n'avez rien appris.
- Vérifiez le clip dans son contexte prévu. Pour un échantillon, montez les plans retenus avec un dialogue ou un son provisoire. Pour un clip autonome, regardez-le avec son audio final et sa fin. Un plan qui marche seul peut très bien refuser de se raccorder au suivant.
- Validez-le au regard du brief de livraison. Conservez les images, les prompts, les temps et les notes de montage. S'il respecte le brief, livrez-le. S'il fait partie d'une séquence liée, passez à un workflow qui survit aux tests de continuité et de révision — un modèle différent ne reproduira pas automatiquement la même performance ni le même mouvement de caméra.
Vous pouvez commencer à préparer un échantillon dans le générateur d'anime IA. Vérifiez quels modèles et quels contrôles d'entrée l'interface actuelle expose avant de bâtir un workflow dessus.
Deux exemples détaillés : un test de caméra et une animation en pâte à modeler
Les deux exemples ont été générés le 25 octobre 2026 avec fal H3 Max Turbo, piloté depuis un script local. Chacun utilise une première image ImageGen, le mode image-vers-vidéo, une requête en 768P, la graine 20261025 et prompt_expansion_mode=disabled. Les prompts ci-dessous sont le texte complet soumis, pas des versions nettoyées. Les noms de personnages décrivent ce qui est visible dans l'image ; ils ne rattachent aucune référence supplémentaire.
Cas 1 : comparer une caméra fixe et un léger travelling avant
La question était volontairement étroite : un petit mouvement de caméra sert-il une entrée discrète ? Les deux versions partagent l'image de départ et l'action, et ne diffèrent que par une phrase d'instruction caméra. Une génération chacune — pas de nouvelle tentative, pas de sélection de la bonne.
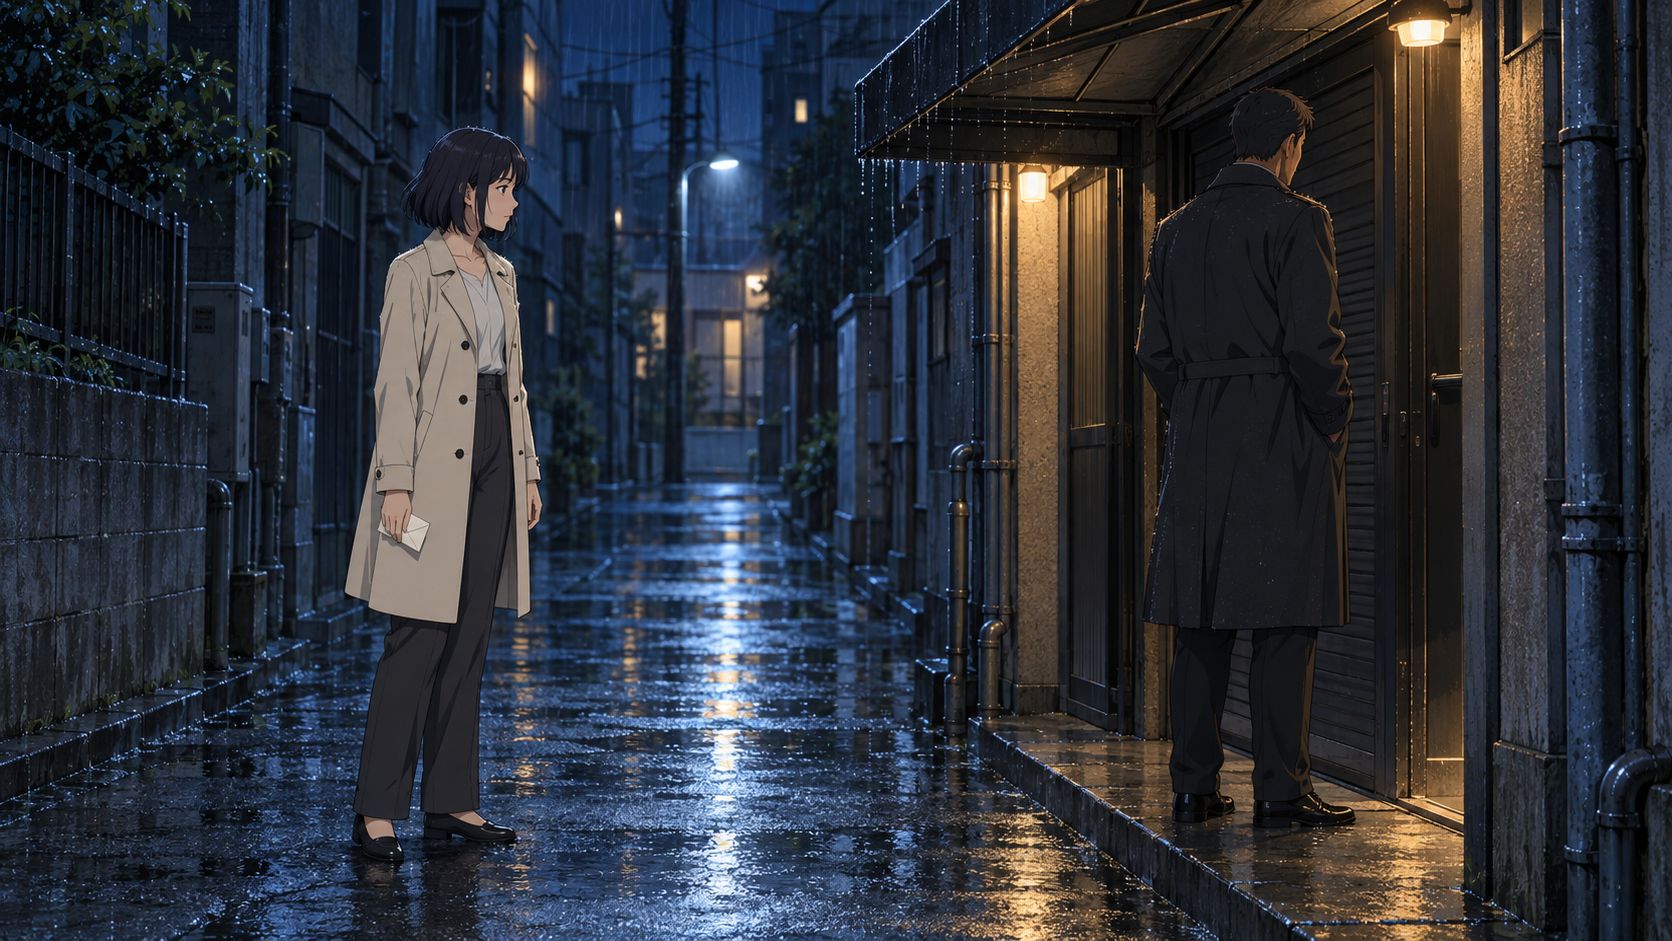
Comparaison muette, A à gauche, B à droite. Les deux conservent la durée complète du plan ; chaque côté est affiché en 640×360 dans un canevas 1280×720.
A — prompt complet soumis, caméra fixe :
Animate the supplied first frame into a five-second 2D anime shot.
Rin, the woman in the ivory coat on the left, takes two slow steps to the right toward Sato, then stops before reaching him.
Sato, the man in the dark coat beneath the awning, stays in place with his back turned.
The folded letter stays in Rin's right hand at her side.
Static eye-level camera. Keep both characters fully visible.
Preserve the character designs, clothing, alley layout and blue-and-warm lighting from the starting image.
Gentle rain and distant traffic. No dialogue or music. One continuous shot, no cuts.
B — prompt complet soumis, léger travelling avant :
Animate the supplied first frame into a five-second 2D anime shot.
Rin, the woman in the ivory coat on the left, takes two slow steps to the right toward Sato, then stops before reaching him.
Sato, the man in the dark coat beneath the awning, stays in place with his back turned.
The folded letter stays in Rin's right hand at her side.
Very slow, small forward camera push at eye level. Keep both characters fully visible.
Preserve the character designs, clothing, alley layout and blue-and-warm lighting from the starting image.
Gentle rain and distant traffic. No dialogue or music. One continuous shot, no cuts.
Échantillonnés à peu près toutes les demi-secondes, les deux clips montrent Rin qui avance vers Sato puis s'arrête. Sato reste globalement près de l'embrasure ; la lettre reste visible au côté de Rin. A s'est stabilisé vers 2,5 secondes, B vers 3. Le travelling avant est subtil, et l'arrière-plan comme le cadrage méritent encore un examen plus attentif. Prenez les étiquettes pour l'instruction demandée, pas pour une trajectoire de caméra mesurée.
C'est justement l'intérêt : voilà une décision qu'un brouillon rapide peut trancher en un après-midi. Mettez les deux versions au montage et gardez la mise en place qui se lit le plus clairement. Une seule exécution par prompt n'établira pas un contrôle caméra fiable, ni ne classera les deux instructions l'une par rapport à l'autre.
Cas 2 : une scène en pâte à modeler de huit secondes avec dialogue en anglais
Pour un autre rendu et une scène autonome, nous avons construit un petit bureau de poste en forêt. Un robot orange en pâte à modeler pose une lettre sur le comptoir ; un escargot maître de poste répond. Compact par construction — un décor, une action principale, un court échange —, ce qui en fait un test honnête pour un clip pour enfants autonome.
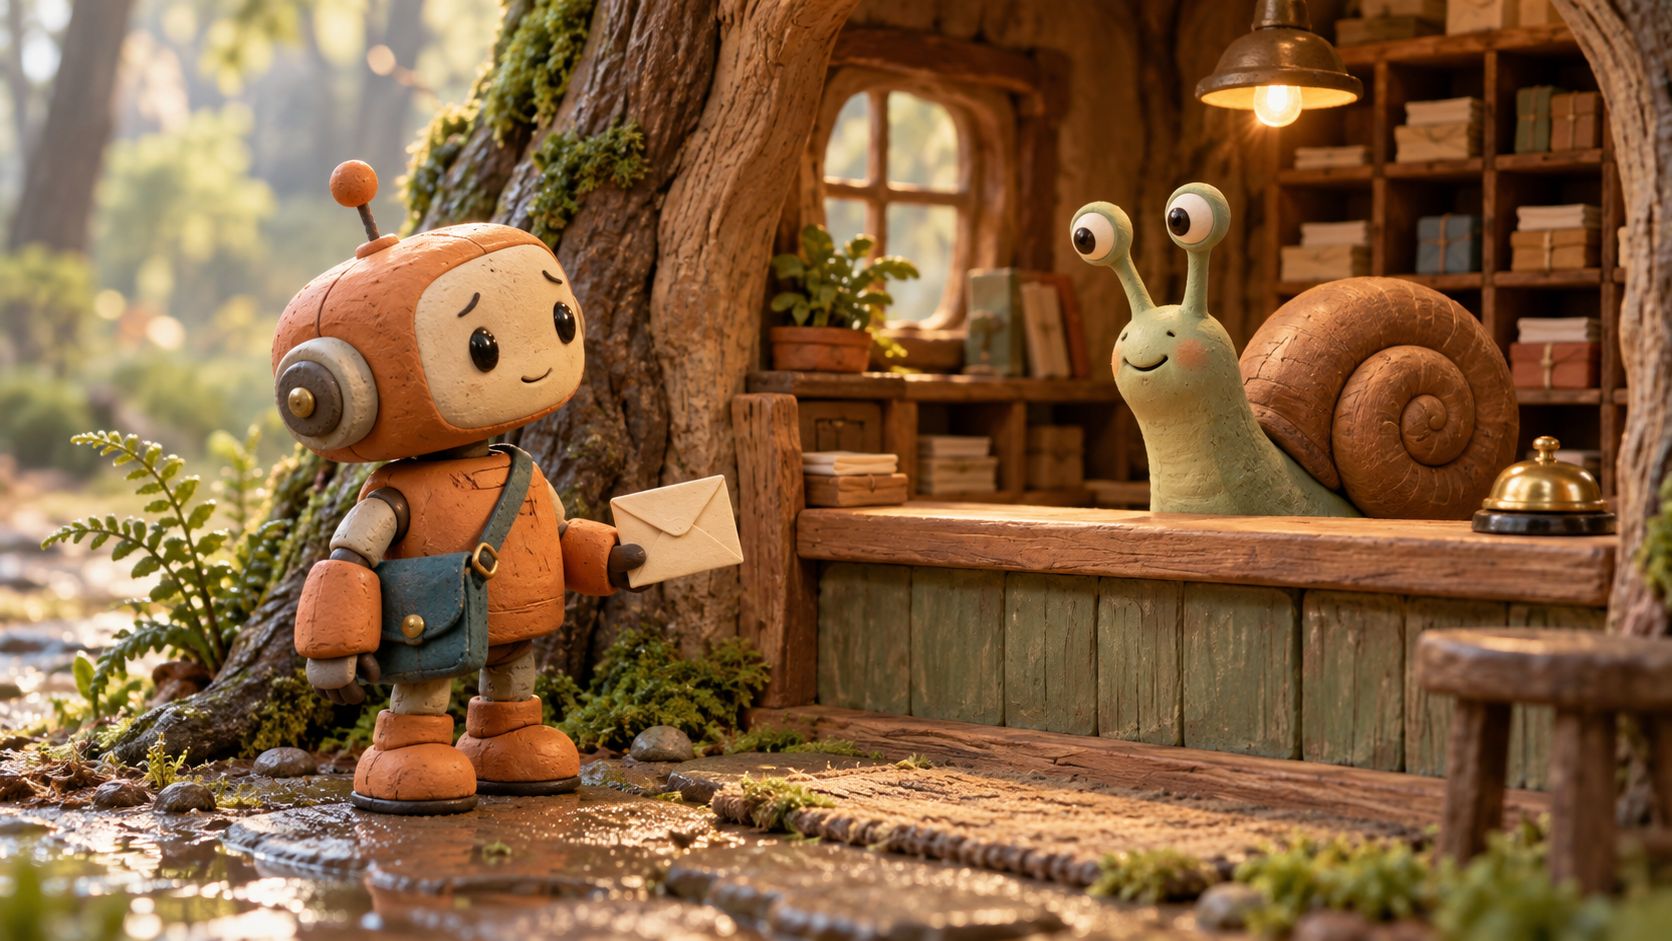
Mettez le son pour celui-ci. Le clip de huit secondes joue la bande-son générée par le modèle lui-même, sans doublage externe ni piste audio de remplacement. C'est la révision avec dialogue anglais, obtenue après une passe en ambiance seule et un brief en mandarin ; le tableau de temps plus bas ne concerne que cette requête anglaise, pas tout le parcours de développement.
Prompt complet soumis, dialogue et temps forts prévus compris :
Animate the supplied first frame into an eight-second handcrafted 3D clay stop-motion film shot WITH CLEAR AUDIBLE ENGLISH DIALOGUE, synchronized character mouths and natural sound effects.

0–1 seconds: hold the starting pose. The little orange postal robot looks toward the snail postmaster, still holding the single cream envelope.

1–4 seconds: the robot gently extends its envelope-holding arm forward and slightly upward, then lays the envelope flat on the counter in front of the snail. Keep the hand and envelope clearly separate. The robot stays in the same spot. While extending the envelope, the robot says in English, in a bright, friendly, youthful and lightly metallic voice: “Your letter. Please sign here.” Its mouth moves with its own spoken words.

4–5 seconds: the robot releases the envelope and slowly withdraws its now-empty hand. The envelope remains resting flat on the counter. A soft paper rustle and a gentle contact sound accompany the delivery.

5–7 seconds: the friendly snail gives one slow blink, then replies in English in a warm, calm, slightly lower mature voice: “Thank you. Have a lovely day.” Its small mouth moves with its own words. The robot listens silently. The snail stays behind the counter and does not grow hands or arms.

7–8 seconds: hold the completed delivery. The robot looks pleased, the snail looks content, and the single envelope stays on the counter.

Audio is essential: both quoted dialogue lines must be clearly audible, complete and not overlap. Use two distinct character voices, no narrator. All spoken words must be in English only. Quiet forest birds and soft outdoor ambience stay underneath the speech. No music. Do not add subtitles or visible text.

Fixed eye-level camera, one continuous shot, no cuts, no zoom.
Preserve the characters, matte clay texture, subtle fingerprints, warm morning lighting and woodland post-office layout from the first frame. Movement is small, deliberate and tactile, with a gentle stop-motion feel.
Les images échantillonnées montrent l'enveloppe tendue, posée à plat, puis lâchée. La transcription automatique — aucun script fourni, aucun préréglage de langue — a détecté l'anglais et retrouvé les deux répliques exactement : « Your letter. Please sign here. » et « Thank you. Have a lovely day. » Cela confirme que les mots sont présents et intelligibles dans la bande-son. Cela ne confirme pas une synchronisation labiale exacte à l'image, ni que les voix tiendront sur les clips à venir. Les horodatages du prompt décrivent la séquence prévue ; ce n'est pas un planning image par image vérifié.
Ce qui est utile, c'est la forme : une petite scène qui n'exige aucune suite d'angles raccord. Pour un dialogue plus long, le workflow vocal ci-dessus s'applique toujours. Une description écrite d'une voix n'est pas une référence vocale réutilisable, et vous serez probablement encore en train de monter ou de redoubler entre deux clips.
Temps d'attente mesurés et réglages de sortie
| Requête | Durée demandée | Soumission au résultat | Inférence rapportée | Soumission au fichier téléchargé |
|---|---|---|---|---|
| Ruelle A, caméra fixe | 5 secondes | 6.09s | 1.55s | 9.11s |
| Ruelle B, léger travelling avant | 5 secondes | 5.46s | 1.54s | 7.77s |
| Scène en pâte à modeler, dialogue anglais | 8 secondes | 7.16s | 2.96s | 10.32s |
« Soumission au résultat » inclut les allers-retours réseau et l'interrogation du statut à intervalles d'environ une seconde ; l'envoi de la première image, le transcodage ultérieur et les vérifications de transcription sont exclus. La colonne Inférence reprend le timings.inference renvoyé par le fournisseur. Aucun de ces chiffres ne mesure le chemin applicatif ArcLoop, et les trois sont des exécutions uniques — un relevé de ce qui s'est passé, pas une promesse d'attente typique.
Les trois vidéos sources sont revenues en 1344×768 à 24 fps. Les clips de la ruelle comptent 124 images, soit environ 5,17 secondes ; le clip en pâte à modeler compte 192 images, exactement huit secondes. Les exports 720p conservent la séquence d'images complète, mise à l'échelle proportionnellement avec des bandes jusqu'en 1280×720 — sans changement de vitesse, sans interpolation, sans coupe. Nous n'avons pas vérifié de facture fournisseur : l'arithmétique aux tarifs standard plus haut dans ce guide reste donc une estimation, pas le coût facturé de ces exécutions.
Éviter que le budget de brouillon ne devienne un budget de reprises
Décidez ce qui compte comme résultat utile avant d'appuyer sur générer, que vous exploriez une scène ou finissiez un clip. Fixez un budget, fixez une limite de reprises, et écrivez la raison pour laquelle vous vous arrêteriez. Notez ensuite ce que chaque reprise était censée corriger — sinon vous achetez juste des variantes.
Suivez les frais de génération séparément de la préparation d'images, de la revue, du montage et des réparations. Pour un brouillon, comptez les questions de mise en place ou de caméra que vous avez réellement tranchées. Pour la production, comptez les plans qui ont passé le standard de livraison complet. Ce sont des résultats différents ; en faire une moyenne ne vous apprend rien.
Et si les tentatives déplacent sans arrêt un accessoire validé, altèrent un visage ou cassent la pièce, arrêtez le lot. Corrigez l'image de départ, simplifiez l'action, ou passez à un workflow doté des contrôles dont ce plan a besoin. Les versions supplémentaires aident tant que vous explorez. Elles deviennent chères dès que vous essayez de protéger une décision déjà prise.
FAQ MiniMax H3 Turbo
H3 Max Turbo convient-il à des épisodes d'anime finis ?
Pour des brouillons, des animatiques, des échantillons et des animations autonomes finies — y compris de simples clips pour enfants aux exigences de continuité légères —, oui. Pour des épisodes liés, n'en faites pas votre seul workflow de production avant que les tests de plans raccord et de révision ne satisfassent vos propres exigences. Un bon petit clip ne dit rien de la continuité à l'échelle d'une série, ni du coût de vos révisions.
Turbo accepte-t-il plusieurs références de personnage ?
La documentation publique Turbo de fal, consultée le 25 octobre 2026, décrit le texte-vers-vidéo et l'image-vers-vidéo à partir d'une première et d'une dernière image. Nous n'avons trouvé aucun endpoint Turbo dédié à la vidéo par référence. Soit vous construisez la scène dans une image de départ, soit vous passez à un workflow de référence documenté quand des éléments de référence distincts sont indispensables.
Faut-il un GPU de 44 Go, et peut-on exporter en 1080P ?
fal héberge le modèle : aucun GPU local à acheter. Ses schémas Turbo listent 480P, 768P et 1080P ; l'option 1080P affine à partir d'une source native en 768P. Et non — plus de pixels ne corrigeront ni la continuité, ni l'anatomie, ni la douleur de vos révisions.