Ein Entwurf lohnt sich nur, wenn er dir hilft zu entscheiden, wie es weitergeht. Liest sich der Auftritt? Steht die Kamera zu nah dran? Hält die Pause wirklich jemanden bei der Stange? fal H3 Max Turbo beantwortet solche Fragen in etwa einer Minute – und ein Sinneswandel kostet dabei nur Kleingeld.
In diesem Leitfaden meint „MiniMax H3 Turbo" das gehostete H3 Max Turbo von fal. Es ist zuerst ein Werkzeug für Entwürfe: Animatics, Kameratests, Stimmungsbilder, Nachaufnahmen einzelner Einstellungen. Es kann auch einen eigenständigen Clip fertigstellen, wenn die Geschichte klein ist und nichts zur vorherigen Einstellung passen muss – kurze Kinderanimation eingeschlossen. Für ein episodisches Anime, das wiederholbare Figurendesigns, Kontinuität und präzise Korrekturen braucht, würden wir es nicht zum einzigen Produktions-Workflow machen.
Einen Überblick über das Modell und seine Funktionen auf ArcLoop findest du auf der Modellseite zu MiniMax H3 Max.
Warum H3 Max Turbo? Schnelleres Feedback zu geringeren Kosten
Der Preis ist die Schlagzeile, der eigentliche Gewinn ist der Vergleich. Eine Idee ist eine Vermutung. Drei sind eine Entscheidung. Du lässt die statische Einstellung, den langsamen Push-in und die Mitlauf-Fahrt laufen und wählst dann die Variante, die der Szene dient – solange alle drei noch frisch im Kopf sind.
Der Text-to-Video-Benchmark von fal vom 8. September 2026 nennt 1.54 Sekunden Inferenz für einen fünfsekündigen Turbo-Clip in 768p, gegenüber 2.46 Sekunden für H3 Max. Das ist die vom Anbieter gemeldete Inferenzzeit. Warteschlange, Prompt-Expansion, Encoding und Auslieferung kommen obendrauf; es ist also nicht die Zahl, auf die du beim Warten starrst – und es ist keine Leistungsmessung von ArcLoop.
Für die Kalkulation nennt fal diese Standardpreise. Keine Aktionen, keine befristeten Rabatte, geprüft am 25. Oktober 2026.
| Auflösung | H3 Max Turbo, pro Ausgabesekunde | H3 Max, pro Ausgabesekunde |
|---|---|---|
| 480P | $0.025 | $0.05 |
| 768P | $0.04 | $0.08 |
| 1080P | $0.08 | $0.16 |
Zum angegebenen 768P-Tarif kostet ein fünfsekündiger Turbo-Versuch $0.20. Dieselbe Einstellung auf H3 Max kostet $0.40. Zwanzig Versuche auf Turbo summieren sich auf $4 an Generierungskosten – vor Rabatten und ohne die Arbeit drumherum. Preise ändern sich, also prüfe den Endpoint, bevor du einen Batch startest.
Wo Turbo passt: Entwürfe, Muster und eigenständige Animationsclips
Turbo verdient seinen Platz in zwei Situationen: eine Idee ausloten, bevor du echte Zeit hineinsteckst, und eine kleine Szene fertigstellen, die für sich steht. Entscheide, welches der beiden du gerade tust, und bewerte das Ergebnis an genau diesem Zweck – an nichts anderem.
| Einsatz | Worauf du achtest | Was ein brauchbares Ergebnis belegt |
|---|---|---|
| Blocking-Entwurf | Auftritt, Abgang und Abstand zwischen den Figuren | Ob die Stellung im Bild lesbar ist |
| Animatic oder Kameratest | Einstellungslänge, Push-in, Schwenk und Schnittpunkt | Ob die Sequenz den beabsichtigten Rhythmus hat |
| Look- oder Stimmungsmuster | Licht, Farbe und Bewegung im Zusammenspiel | Ob die visuelle Richtung zur Geschichte passt |
| Pitch-Muster | Eine kurze Passage aus ausgewählten Einstellungen | Ob ein Team oder eine Kundin den Vorschlag versteht |
| Eigenständige Kinderanimation | Eine klare Aktion und eine kurze Reaktion | Ob die kleine Szene ohne umliegende Episoden funktioniert |
Eine Einschränkung, bevor du etwas an eine Kundin schickst: Ein überzeugendes Pitch-Muster kann trotzdem aus provisorischen Stimmen, groben Übergängen und Kontinuitätsbrüchen zusammengehalten sein. Schreib das in die Mail. Ein Konzept abzunicken ist nicht dasselbe, wie die Pipeline abzunicken, die du für jede Episode brauchst.
Einfache Kindervideos können fertige Arbeit sein
Ein kurzes Kindervideo braucht oft keine durchlaufende Handlung und kein Ensemble, das nächste Woche wiederkommt. Ein Knetroboter, der einen Brief austrägt, ein kleines Tier, das einen Freund begrüßt, eine Figur, die unter einem Blatt etwas Seltsames entdeckt – jedes davon kann eine vollständige Szene sein statt eines Fragments. Wenn es nur um eine lesbare Aktion und eine kurze Reaktion geht, ist Turbo auch für den finalen Clip eine Überlegung wert, nicht nur für den Entwurf.
Das Beispiel mit dem Waldpostamt in diesem Artikel ist genau so gebaut. Ein oranger Knetroboter legt einen Brief auf die Theke, ein Schnecken-Postmeister antwortet. Acht Sekunden, zwei Figuren, ein Ort, zwei kurze Zeilen generierter Dialog. Ein kleiner erzählerischer Takt in einer einzigen Einstellung – ohne Kette aufeinander abgestimmter Kamerawinkel.
Die Formel ist langweilig, aber verlässlich: Aktion einfach halten, Figuren klar unterscheidbar machen, Dialog kurz genug, dass er beim ersten Hören sitzt. Dann schau dir das Ganze auf klare Sprache, verirrte Bewegungen, Requisiten, die mitten in der Einstellung wechseln, und auf ein Ende an, das tatsächlich ankommt. Wenn es diese Latte nimmt, ist es der fertige Clip. Ihn noch mal in einem größeren Modell zu regenerieren ist optional, kein Initiationsritual.
Was das von Serienarbeit trennt, ist Kontinuität. Eine Kinderserie mit wiederkehrenden Figuren, wiederkehrenden Stimmen und verbundenen Ereignissen trägt dieselbe Last wie jede andere erzählende Animation. Eine einmalige Begrüßung zwischen einem Roboter und einer Schnecke trägt fast keine.
Warum wir Turbo nicht allein für eine fortlaufende Anime-Serie einsetzen würden
Ein Clip, der gut aussieht, beantwortet eine andere Frage als eine Pipeline, die du nächste Woche erneut fahren kannst. In einer episodischen Serie muss dieselbe Figur neue Winkel, neue Gesten und neues Licht überstehen. Requisiten bleiben in der richtigen Hand. Und wenn du eine Aktion geändert haben willst, sollten das abgenommene Gesicht, das Kostüm und das Set unangetastet zurückkommen.
Die öffentlichen Turbo-Endpoints von fal decken Text-to-Video und Image-to-Video mit Steuerung über erstes und letztes Bild ab. Stand 25. Oktober 2026 haben wir in der öffentlichen Dokumentation keinen eigenen Reference-to-Video-Endpoint für H3 Max Turbo gefunden. Ein Startbild liefert eine Ausgangskomposition. Es ist kein Bündel unabhängiger Figuren-, Szenen- und Stimmreferenzen, und der Reference-to-Video-Endpoint von fal H3 Max ist ein anderer Endpoint mit anderem Verhalten.
Auch die Stimme braucht einen eigenen Plan. Turbo generiert Dialog, aber das aktuelle öffentliche Schema hat keinen eigenen Eingang für Stimmreferenzen – nichts hindert also die stimmliche Identität einer Figur daran, zwischen Einstellungen zu driften. Ein wiederverwendetes Startbild fixiert die Stimme nicht. Und target_audio_url solltest du zweimal lesen: Der Parameter ersetzt die Tonspur des Ergebnisses durch mitgeliefertes Audio. Er hört sich den Clip nicht an und generiert keine neuen Zeilen in derselben Stimme.
Für alles Längerfristige heißt das: die Stimmspur bewusst bauen – konsistente Aufnahmen der Figuren oder ein eigener Stimm-Workflow – und den Dialog dann im Schnitt ersetzen und synchronisieren. Der Schnitt regelt Timing und Übergänge; Atmosphäre und Lautheit müssen trotzdem über die ganze Sequenz hinweg angeglichen werden. Geh nicht davon aus, dass separat generierte Clips zufällig dieselbe Stimme haben.
Hier beißt die Grenze der Eingaben. Du kannst mehrere etablierte Assets in ein Startbild packen, aber Stabilität über eine Reihe von Einstellungen kaufst du damit nicht. Die Kontinuitätsarbeit wandert stromaufwärts in Bildvorbereitung und Prüfung – echte Kosten, auch wenn es funktioniert.
Teste den Workflow also, bevor du dich festlegst. Nimm drei zusammenhängende Einstellungen aus einer Szene – eine Totale, eine Gegeneinstellung, eine Nahaufnahme – und verlange dann eine kleine Korrektur. Prüfe Identität, Raumgeografie, Kostümdetails, Positionen der Requisiten, Dialog und wie viel bereits abgenommenes Material beim erneuten Lauf still und leise umgeschrieben wird.
Nichts davon heißt, dass Turbo keine fertige Arbeit liefern kann. Ein Creator hat ein komplettes Musikvideo dokumentiert, das mit fal H3 Max Turbo entstanden ist: ein Startbild pro Szene, einige Kontinuitäts-Wiederholungen, Schnitt und eine ersetzte Tonspur. Das ist ein wirklich fertiges Projekt. Es hat auch genau die Begleitarbeit gekostet, die oben steht – und ein Musikvideo ist kein wiederholbarer episodischer Prozess.
Ein praktischer Workflow für ein kurzes Anime-Muster
- Erst die Entscheidung festlegen. Schreib auf, was der Entwurf klären soll: einen Auftritt, eine Pause, eine Kamerabewegung, den Ton einer Szene. Ein Test kann nicht alle vier abnehmen, und der Versuch macht keine davon belastbar.
- Das Einstellungsbild vorbereiten. Bei Image-to-Video bringst du Figur, Kostüm und Requisiten in genau der Ausgangskomposition unter, die du willst. Wenn du ein Endbild nutzt, müssen dessen Aktion und Anordnung plausibel aus dem Start folgen.
- Eine kleine Auswahl generieren. Halte Startbild, Dauer und Auflösung fest und ändere jeweils nur eine Anweisung. Lass auch die Prompt-Expansion fest – sonst hast du eine zweite bewegliche Variable eingeführt und nichts gelernt.
- Den Clip im vorgesehenen Kontext prüfen. Für ein Muster schneidest du die ausgewählten Einstellungen mit provisorischem Dialog oder Ton zusammen. Bei einem eigenständigen Clip schaust du ihn mit finalem Ton und Ende an. Eine Einstellung, die allein funktioniert, kann sich immer noch weigern, an die nächste anzudocken.
- Gegen das Abgabebriefing abnehmen. Behalte Bilder, Prompts, Zeiten und Schnittnotizen. Wenn es das Briefing erfüllt, geht es raus. Ist es Teil einer zusammenhängenden Sequenz, nimm einen Workflow, der die Kontinuitäts- und Korrekturtests übersteht – ein anderes Modell reproduziert nicht automatisch dieselbe Performance oder dieselbe Kamerabewegung.
Ein Muster kannst du im AI Anime Generator vorbereiten. Prüfe vorher, welche Modelle und Eingabesteuerungen die aktuelle Oberfläche überhaupt anbietet, bevor du einen Workflow darum herum baust.
Zwei durchgerechnete Beispiele: ein Kameratest und eine Knetanimation
Beide Beispiele wurden am 25. Oktober 2026 mit fal H3 Max Turbo generiert, angesteuert über ein lokales Skript. Jedes nutzte ein ImageGen-Startbild, den Image-to-Video-Modus, eine 768P-Anfrage, den Seed 20261025 und prompt_expansion_mode=disabled. Die Prompts unten sind der vollständige übermittelte Text, keine aufgeräumten Fassungen. Die Figurennamen beschreiben, was im Bild zu sehen ist; sie hängen keine zusätzlichen Referenzen an.
Fall 1: statische Kamera gegen einen kleinen Push-in
Die Frage war absichtlich eng: Hilft eine kleine Kamerabewegung einem leisen Auftritt? Beide Versionen teilen Startbild und Aktion und unterscheiden sich in genau einem Satz Kameraanweisung. Je eine Generierung – kein zweiter Anlauf, kein Aussuchen des guten Ergebnisses.
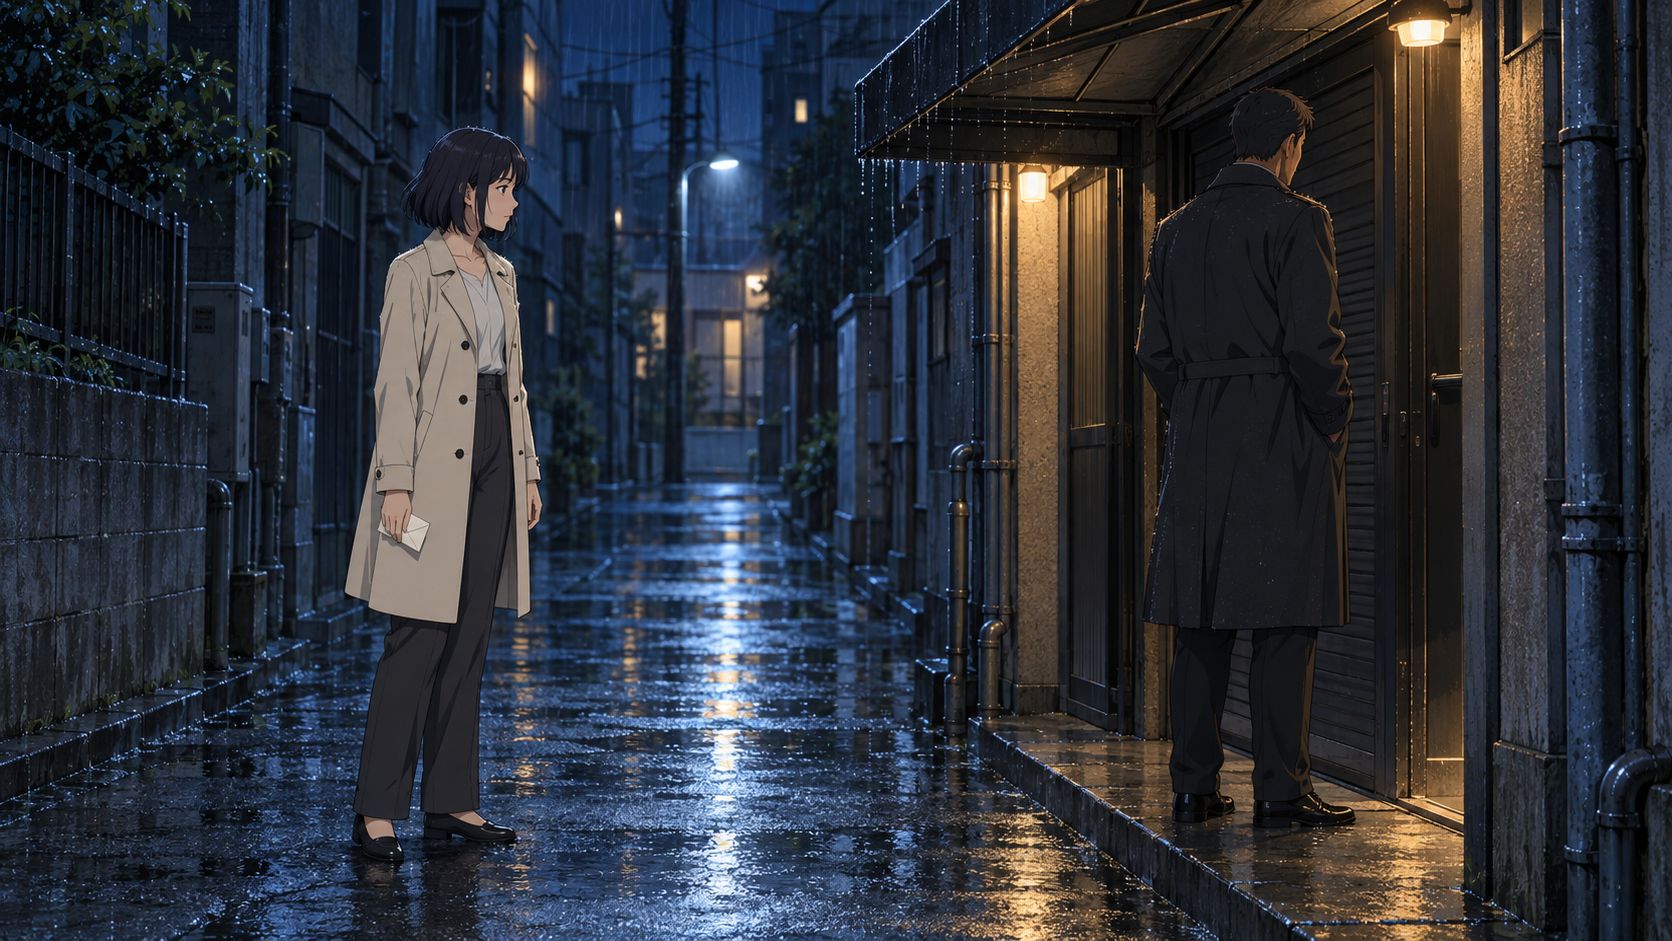
Stummer Vergleich, A links, B rechts. Beide behalten die volle Einstellungsdauer; jede Seite wird mit 640×360 in einer 1280×720 großen Fläche dargestellt.
A — vollständiger übermittelter Prompt, statische Kamera:
Animate the supplied first frame into a five-second 2D anime shot.
Rin, the woman in the ivory coat on the left, takes two slow steps to the right toward Sato, then stops before reaching him.
Sato, the man in the dark coat beneath the awning, stays in place with his back turned.
The folded letter stays in Rin's right hand at her side.
Static eye-level camera. Keep both characters fully visible.
Preserve the character designs, clothing, alley layout and blue-and-warm lighting from the starting image.
Gentle rain and distant traffic. No dialogue or music. One continuous shot, no cuts.
B — vollständiger übermittelter Prompt, kleiner Vorwärtsschub:
Animate the supplied first frame into a five-second 2D anime shot.
Rin, the woman in the ivory coat on the left, takes two slow steps to the right toward Sato, then stops before reaching him.
Sato, the man in the dark coat beneath the awning, stays in place with his back turned.
The folded letter stays in Rin's right hand at her side.
Very slow, small forward camera push at eye level. Keep both characters fully visible.
Preserve the character designs, clothing, alley layout and blue-and-warm lighting from the starting image.
Gentle rain and distant traffic. No dialogue or music. One continuous shot, no cuts.
In Stichproben etwa im Halbsekundentakt zeigen beide Clips, wie Rin auf Sato zugeht und stehen bleibt. Sato bleibt meist am Türbogen; der Brief bleibt an Rins Seite sichtbar. A hat sich nach etwa 2.5 Sekunden beruhigt, B nach etwa 3. Der Push-in ist subtil, und Hintergrund und Bildausschnitt verdienen trotzdem einen genaueren Blick. Nimm die Bezeichnungen als angeforderte Anweisung, nicht als gemessenen Kamerapfad.
Und das ist der Punkt: So eine Entscheidung klärt ein schneller Entwurf an einem Nachmittag. Leg beide Versionen in den Schnitt und nimm die Stellung, die klarer lesbar ist. Ein Lauf pro Prompt belegt keine verlässliche Kamerakontrolle und sortiert die beiden Anweisungen auch nicht gegeneinander.
Fall 2: eine achtsekündige Knet-Szene mit englischem Dialog
Für einen anderen Look und eine in sich geschlossene Szene haben wir ein kleines Waldpostamt gebaut. Ein oranger Knetroboter legt einen Brief auf die Theke, ein Schnecken-Postmeister antwortet. Kompakt aus Prinzip – ein Ort, eine Hauptaktion, ein kurzer Wortwechsel. Genau das macht daraus einen fairen Test für einen eigenständigen Kinderclip.
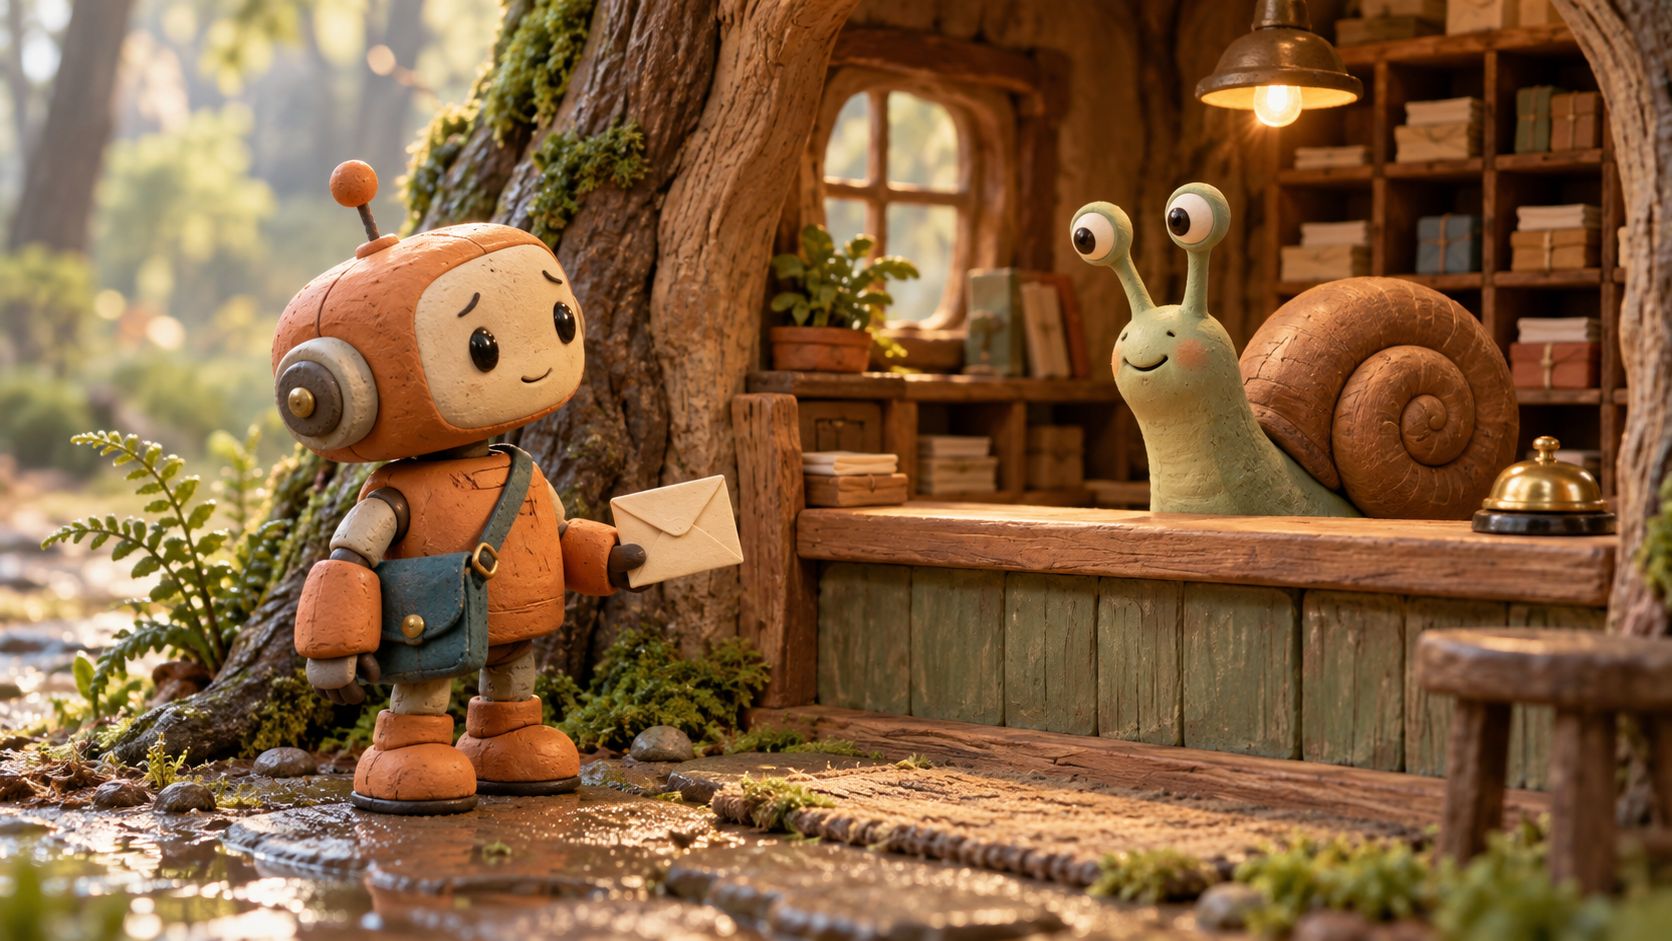
Bei diesem hier schaltest du den Ton ein. Der achtsekündige Clip spielt die vom Modell selbst erzeugte Tonspur, ohne externes Dubbing und ohne ersetzte Audiospur. Es ist die Fassung mit englischem Dialog, entstanden nach einem reinen Ambient-Durchlauf und einem Mandarin-Briefing; die Zeittabelle unten deckt nur diese englische Anfrage ab, nicht den ganzen Entwicklungsweg.
Vollständiger übermittelter Prompt, inklusive Dialog und geplanter Beats:
Animate the supplied first frame into an eight-second handcrafted 3D clay stop-motion film shot WITH CLEAR AUDIBLE ENGLISH DIALOGUE, synchronized character mouths and natural sound effects.

0–1 seconds: hold the starting pose. The little orange postal robot looks toward the snail postmaster, still holding the single cream envelope.

1–4 seconds: the robot gently extends its envelope-holding arm forward and slightly upward, then lays the envelope flat on the counter in front of the snail. Keep the hand and envelope clearly separate. The robot stays in the same spot. While extending the envelope, the robot says in English, in a bright, friendly, youthful and lightly metallic voice: “Your letter. Please sign here.” Its mouth moves with its own spoken words.

4–5 seconds: the robot releases the envelope and slowly withdraws its now-empty hand. The envelope remains resting flat on the counter. A soft paper rustle and a gentle contact sound accompany the delivery.

5–7 seconds: the friendly snail gives one slow blink, then replies in English in a warm, calm, slightly lower mature voice: “Thank you. Have a lovely day.” Its small mouth moves with its own words. The robot listens silently. The snail stays behind the counter and does not grow hands or arms.

7–8 seconds: hold the completed delivery. The robot looks pleased, the snail looks content, and the single envelope stays on the counter.

Audio is essential: both quoted dialogue lines must be clearly audible, complete and not overlap. Use two distinct character voices, no narrator. All spoken words must be in English only. Quiet forest birds and soft outdoor ambience stay underneath the speech. No music. Do not add subtitles or visible text.

Fixed eye-level camera, one continuous shot, no cuts, no zoom.
Preserve the characters, matte clay texture, subtle fingerprints, warm morning lighting and woodland post-office layout from the first frame. Movement is small, deliberate and tactile, with a gentle stop-motion feel.
Bildstichproben zeigen, wie der Umschlag vorgestreckt, flach hingelegt und losgelassen wird. Die automatische Transkription – kein mitgeliefertes Skript, keine Sprachvorgabe – erkannte Englisch und gab beide Zeilen exakt wieder: „Your letter. Please sign here." und „Thank you. Have a lovely day." Das bestätigt, dass die Wörter in der Tonspur vorhanden und verständlich sind. Es bestätigt weder bildgenaue Lippensynchronität noch, dass die Stimmen über künftige Clips hinweg halten. Die Zeitangaben im Prompt beschreiben die geplante Abfolge; sie sind kein verifizierter Bild-für-Bild-Ablauf.
Das Brauchbare ist die Form: eine kleine Szene, die keine Folge aufeinander abgestimmter Winkel braucht. Bei längerem Dialog gilt der Stimm-Workflow von oben weiter. Eine schriftliche Stimmbeschreibung ist keine wiederverwendbare Stimmreferenz, und du wirst zwischen Clips wahrscheinlich trotzdem schneiden oder neu vertonen.
Gemessene Wartezeit und Ausgabeeinstellungen
| Anfrage | Angeforderte Länge | Abgabe bis Ergebnis | Gemeldete Inferenz | Abgabe bis heruntergeladene Datei |
|---|---|---|---|---|
| Gasse A, statische Kamera | 5 Sekunden | 6.09s | 1.55s | 9.11s |
| Gasse B, kleiner Push-in | 5 Sekunden | 5.46s | 1.54s | 7.77s |
| Knet-Szene, englischer Dialog | 8 Sekunden | 7.16s | 2.96s | 10.32s |
Abgabe bis Ergebnis enthält Netzwerk-Roundtrips und Statusabfragen im Sekundentakt; der Upload des Startbilds, spätere Transkodierung und Transkriptionsprüfungen sind nicht enthalten. Die Inferenzspalte ist der vom Anbieter zurückgegebene Wert timings.inference. Keine dieser Zahlen misst den Anwendungspfad von ArcLoop, und alle drei sind Einzelläufe – eine Aufzeichnung dessen, was passiert ist, kein Versprechen einer typischen Wartezeit.
Alle drei Quellvideos kamen mit 1344×768 und 24 fps zurück. Die Gassen-Clips enthalten 124 Frames, also etwa 5.17 Sekunden; der Knet-Clip enthält 192 Frames, exakt acht Sekunden. Die 720p-Exporte behalten die vollständige Bildfolge und werden proportional skaliert und auf 1280×720 gepolstert – keine Geschwindigkeitsänderung, keine Interpolation, kein Beschnitt. Eine Lieferantenrechnung haben wir nicht geprüft; die Preisrechnung weiter oben bleibt deshalb eine Schätzung und nicht die tatsächlich abgerechneten Kosten dieser Läufe.
Damit aus dem Entwurfsbudget kein Wiederholungsbudget wird
Leg fest, was als brauchbares Ergebnis zählt, bevor du auf Generieren drückst – egal, ob du eine Szene auslotest oder einen Clip fertigstellst. Setz ein Budget, setz ein Wiederholungslimit und schreib auf, warum du aufhören würdest. Und notier, was jeder erneute Versuch eigentlich beheben sollte – sonst kaufst du nur Variationen.
Verfolge Generierungskosten getrennt von Bildvorbereitung, Prüfung, Schnitt und Reparatur. Für einen Entwurf zählst du die Stellungs- oder Kamerafragen, die du tatsächlich geklärt hast. Für die Produktion zählst du die Einstellungen, die den vollen Abgabestandard bestanden haben. Das sind unterschiedliche Ergebnisse; einen Mittelwert daraus zu bilden sagt dir nichts.
Und wenn Versuche immer wieder eine abgenommene Requisite verschieben, ein Gesicht verändern oder den Raum zerlegen, stoppt den Batch. Repariert das Startbild, vereinfacht die Aktion oder wechselt zu einem Workflow mit den Steuerelementen, die diese Einstellung braucht. Mehr Varianten helfen, solange du noch auslotest. Teuer werden sie in dem Moment, in dem du eine Entscheidung schützen willst, die du längst getroffen hast.
MiniMax H3 Turbo: Häufige Fragen
Taugt H3 Max Turbo für fertige Anime-Episoden?
Für Entwürfe, Animatics, Muster und fertige eigenständige Animationen – auch einfache Kinderclips mit geringen Kontinuitätsanforderungen – ja. Für zusammenhängende Episoden mach es nicht zum einzigen Produktions-Workflow, bevor Tests mit verbundenen Einstellungen und Korrekturen deine eigenen Anforderungen erfüllen. Ein guter kurzer Clip sagt nichts über serienweite Kontinuität aus und nichts darüber, was Korrekturen kosten.
Nimmt Turbo mehrere Figurenreferenzen an?
Die am 25. Oktober 2026 geprüfte öffentliche Turbo-Dokumentation von fal beschreibt Text-to-Video und Image-to-Video mit erstem und letztem Bild. Einen eigenen Reference-to-Video-Endpoint für Turbo haben wir nicht gefunden. Bau die Szene also in ein Startbild ein oder wechsle zu einem dokumentierten Referenz-Workflow, wenn getrennte Referenz-Assets unverzichtbar sind.
Brauche ich eine 44 GB GPU, und kann ich in 1080P exportieren?
fal hostet das Modell, du musst also keine lokale GPU kaufen. Die Turbo-Schemas listen 480P, 768P und 1080P; die 1080P-Option verfeinert aus einer nativen 768P-Quelle. Und nein – mehr Pixel beheben weder Kontinuität noch Anatomie noch den Schmerz deiner Korrekturrunden.