引言
你想要一个很具体的姿势:重心落在后脚,右臂横过胸前,下巴压低,眼睛朝上看。你一字不差地写出来,生成结果给你一个正常站立、一只手微微抬起的角色。你又加了几句话。现在手的位置对了,重心又不对了。肢体语言牵涉的关节太多,一句话根本锁定不了,每加一句就给模型多一个发挥空间。
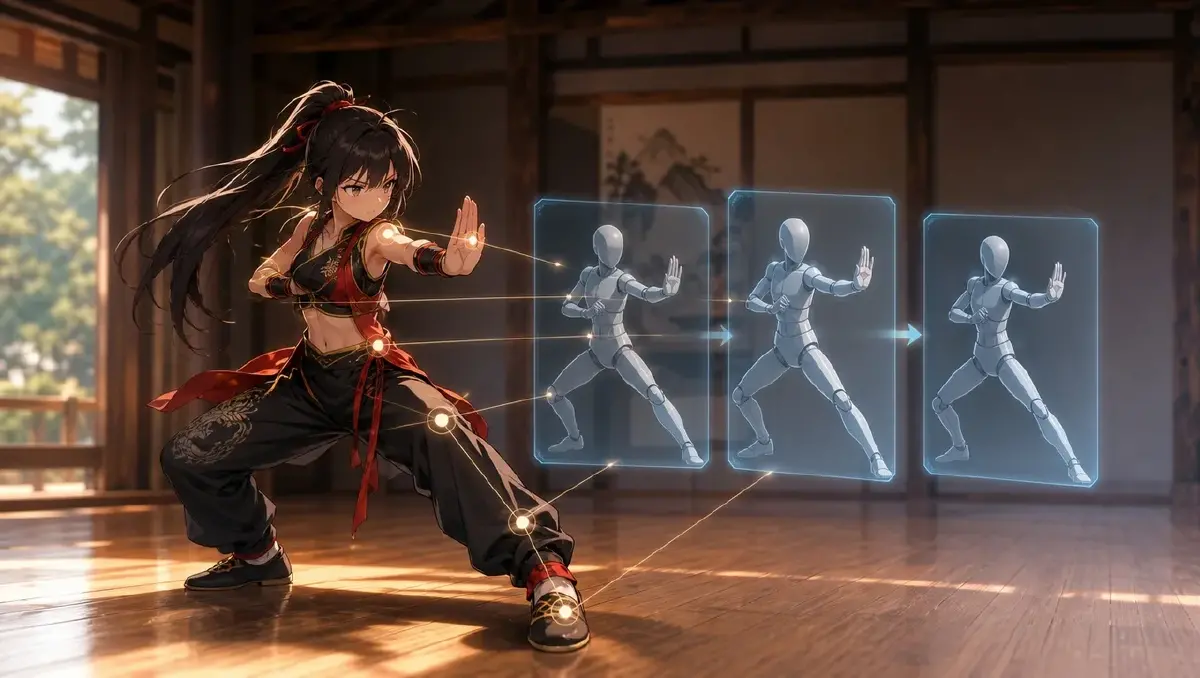
静帧不会被解读,只会被复制。任何包含你想要的姿势的片段——舞蹈视频、打斗场景、走路循环、访谈里某人耸肩——只要截出合适的帧,都能变成姿势参考来源。这篇指南说的就是怎么在 AI 动画视频里使用姿势参考:截哪些帧、怎么绑定才能只提供姿势、怎么写 shot card 让角色资产提供其余的一切。
从片段里能迁移什么,不能迁移什么
从片段里截一张静帧绑到 shot 上,模型能从中获取:
- 姿势本身。 各关节角度、重心分布、手的位置。
- 构图空间。 身体在画面里的位置,周围留了多少余地。
- 时间节奏,如果你取了多张静帧的话。 起始姿势、顶点姿势、结束姿势告诉模型动作的弧线。
- 镜头高度和距离。 从地面拍的静帧会带来低角度视点。
它会尝试获取、而你必须阻断的:
- 风格。 一张照片会把生成结果拉向写实;灰色人台会把它拉向灰色。保持风格参考在位。
- 身份。 片段里的人不是你的角色。用
@引用你的角色,永远不要在文字里描述他们的脸。 - 服装。 静帧里的衣服会渗入。把服装绑到角色资产上。
规则是一个参考只做一件事:静帧提供姿势,资产提供身份,风格参考提供外观。参考选择指南覆盖了所有参考类型的通用原则。
挑选姿势静帧的规则
- 取极值帧,不取过渡帧。 踢腿的最高点、出拳的全伸展、鞠躬的最深处。过渡帧模糊、歧义多。
- 一帧,一个姿势。 如果一帧里同时有两件事——转身加伸手——就取两帧。
- 身体完整入画。 被裁掉的肢体会被模型自行发明。
- 镜头角度和 shot 保持一致。 侧面的姿势静帧对正面镜头没什么用。用你实际要用的角度去找,或者换一个包含这个角度的片段。
- 优先选中性来源。 无贴图的 3D 人台片段是理想选择,因为它除了姿势什么也不带;人台舞蹈指南有一个完整演示。
分步:怎么建立并使用姿势参考集
- 找到包含这个动作的片段。 任何身体完整入画、镜头稳定的来源都行。
- 拖到极值帧,导出静帧。 每个动作三张通常够用:之前、顶点、之后。按动作命名:「shrug-01、shrug-02、shrug-03」。
- 把静帧上传到内容库,绑定为 Visual reference 资产,按动作或场景命名。之后 Agent 就可以重复使用这套参考集了。
- 确认角色是一个资产,带有 Main image,如果动作涉及服装,也要有服装参考。身份绝对不写进 shot 文字里。
- 写 shot card:镜头、
@角色、姿势静帧、以及变化的部分。 「Match pose still shrug-02;她保持这个姿势一拍,然后放下肩膀。」 - 生成图片,和静帧对比。 逐个关节看:重心、手、头部。如果姿势不对,是静帧本身有歧义——换一张更清晰的帧,不要加文字描述。
- 只从匹配成功的静帧出发生成视频。 对于有三张静帧的动作,shot description 按顺序点名:「从 shrug-01 经过 shrug-02 到 shrug-03,持续两秒。」
- 复用这套参考集。 同一个耸肩动作适用于所有角色;只需要换
@。
示例 1:单个定格姿势
Medium shot, camera at chest height, static, plain rehearsal room. @Yuki stands at center matching pose still guard-02: weight on the back foot, left arm across the chest, right hand open at hip height, chin down, eyes up at camera. She holds the pose for the whole shot, breathing visibly, hair settling. Soft overhead light. No camera move, no added movement.
示例 2:跨三张静帧的动作
Medium-wide shot, camera at chest height, static, same rehearsal room. @Yuki moves from pose still shrug-01 (arms at her sides, shoulders neutral) through shrug-02 (shoulders up, palms turned out) to shrug-03 (shoulders dropped, small exhale) over about two seconds. Face stays toward camera the whole time. One clean motion, no repeat, no bounce at the end, hands relaxed. Same light and framing as Shot 1.
示例 3:不同角色做同一个姿势
Medium shot, camera at chest height, static, on the bridge of @Riverside Market. @Hana matches pose still guard-02 exactly: weight back, left arm across the chest, right hand open at hip height, chin down, eyes up. Same pose as Yuki's Shot 1, different character, different place. Outfit from Hana's asset. She holds for the shot; a breeze moves her hair. Late afternoon light from the left.
姿势参考最常见的失效方式
- 照片风格渗入。 生成结果变写实,因为静帧是照片。加强或补充风格参考;静帧只用来提供姿势。
- 片段里的人出现了。 来源素材里的脸或发型出现在结果里。原因是角色用文字描述了而不是用
@引用。修正引用方式。 - 角度不对。 侧面静帧用在正面 shot 上,模型折中处理了。换成正确角度的帧。
- 用了过渡帧。 姿势出来很模糊,因为静帧截在动作中途。取极值帧。
- 一个 shot 堆了太多静帧。 六个参考让模型取了平均值。每个动作最多三张。
常见问题
我可以用自己生成的视频里的静帧作为姿势参考吗? 可以,而且这是最干净的来源:风格相同,角色相同。导出帧,绑定,重复使用。
姿势静帧对手部有效吗? 对手的位置有效。对手指细节效果差一些;手部静帧能帮助整体姿势,但如果手指出了问题,手部与姿势指南里有专门的处理方法。
姿势参考和角色资产上的 Reference image 有什么区别? 资产上的 Reference image 说的是角色从另一个角度或另一套服装看是什么样子。姿势静帧说的是身体在某个 shot 里在做什么。把它们分开,姿势就不会变成角色身份的一部分。
片段本身呢? 把它留在内容库里,用于回看和选帧。Shot 里用的是静帧。
下一步
找一个你一直描述不出来的动作。找一个包含它的片段,导出顶点帧,把它绑定为 Visual reference,写一个 shot:用 @ 引用角色,点名静帧,身体部分只写「match the still」。在 ArcLoop 里打开项目,生成图片,逐个关节对比之后再生成视频。