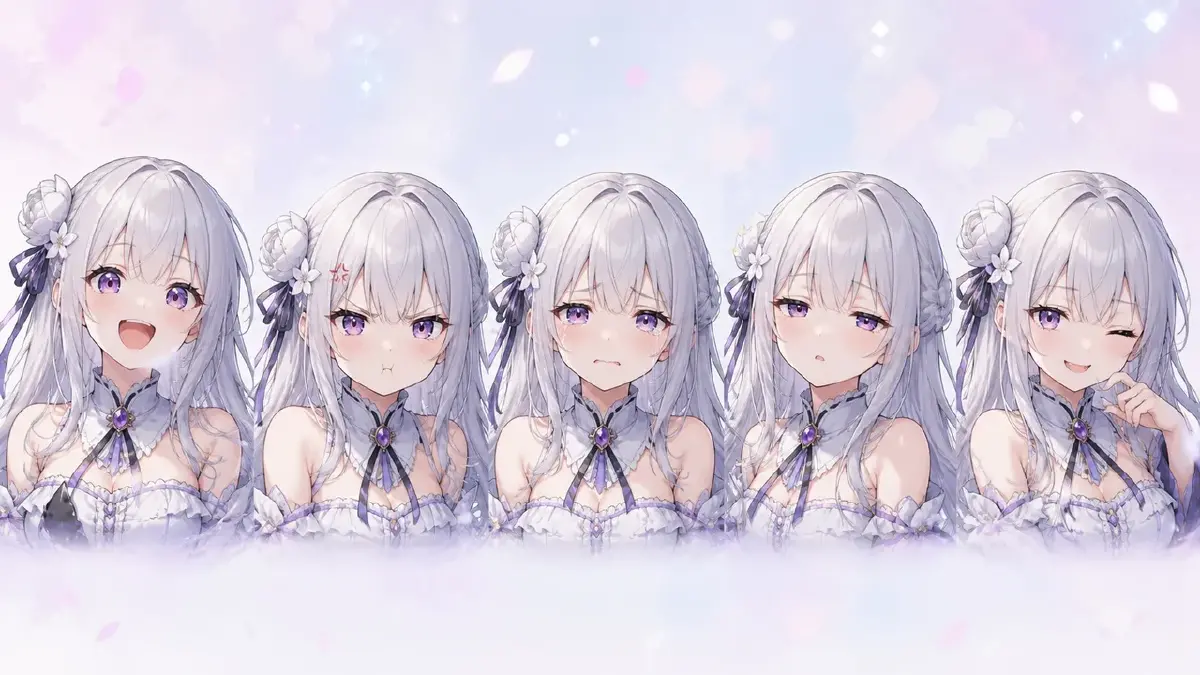
为什么需要表情差分表
Live2D 的绑定本身不会让你的角色变得有表现力。它只是把你交给它的表情播放出来。如果文件里只有一张平静的脸和一个微笑,那就是这个模型的全部情绪范围——而且是永久的,每一场直播都一样。一个 VTuber 真正的性格,是在表情差分表这一步定下来的,而且是在绑定(rigging)开始之前就定下来的。
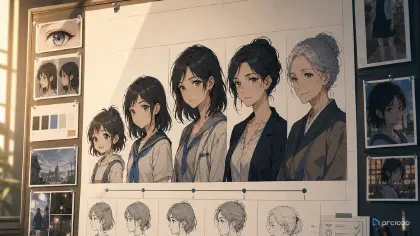
问题在于:一张表情差分表是十几张画,画的是同一张脸,而"一样"恰恰是最难的部分。手绘画师靠结构线和多年练习来解决这个问题。如果你的画是生成的,解决办法就是身份管理的规矩——不然你交给绑定师的就是十个略有不同的角色,最后得到一个一眨眼就变脸的模型。
这篇指南讲清楚一个绑定真正会用到哪些状态,以及怎么把它们做成一张前后一致的差分表。
一个绑定真正会用到的状态
Live2D 的表情是由绑定师混合各个部件状态搭出来的。按这个思路去设计,每一张画都能直接对应一个参数:
眼睛——眨眼链条。 睁眼(基础状态)、半闭、全闭。如果设计需要,再加一个笑眼闭合作为第四种状态。半闭状态是让眨眼看起来柔和而不是机械的关键,也是新手最容易漏掉的一个。
嘴巴——音素组。 对口型是在 A / I / U / E / O 这几种嘴型之间混合切换的——大张、扁平张开、小而圆、半张、圆形张开。口腔内部只要完整画一次:牙齿、舌头、内部阴影。每个音素都会露出其中一部分。
眉毛——情绪的主要载体。 平静、挑眉、生气斜挑、难过斜挑。眉毛状态画起来便宜,绑定起来也便宜,却比脸上任何其他部件都更容易读出情绪。千万不要交一张只有平静眉毛的差分表。
脸部附加效果。 腮红开、眼泪开、恐惧时盖住眼睛的阴影——每一个都单独做成一个可开关的叠加状态。
全脸预设表情。 喜、怒、哀、惊——把上面这些状态组合起来,再加上单个部件做不到的效果(闪亮的眼睛、鬼畜脸)。角色的喜剧感就活在这些预设表情里;三四个够强的预设,胜过十个软绵绵的。
一份标准的首个模型差分表:三种眼睛状态、五种音素嘴型、三种眉毛状态、腮红,再加一两个预设表情。超出这些的部分都是"性格预算"——要花在你的内容真正会触发的状态上。
怎么让十张脸始终是同一张脸
如果各个状态之间的身份对不上,整张表就废了。三条规则能把它们绑在一起:
先锁定主图,再做差分表。 平静表情的那张脸,是每个差分都必须对得上的参考。如果你的设计还在调整中,就还没到做差分的时候——先完成设计锁定。
每张画只改一件事。 一个表情差分改变的应该只是表情。角度一样、光影一样、头发一样、服装一样、构图一样。一旦某个差分连头部角度都变了,绑定师就没法把它当成原地图层替换来用。
引用角色本身,而不是重新描述一遍。 在 ArcLoop 里,把 VTuber 做成一个角色资产,主图 Bind 为它的 Main Image。生成每个状态时都引用这个角色资产——只描述"这次变化了什么":
Same framing and lighting as the master portrait of @Mio.
Only change: eyes half-closed, mouth in the "U" phoneme — small,
round, slightly pursed. Hair, outfit, and angle identical.
因为身份信息由角色资产承载,十次请求生成出来的就是同一张脸的十种状态。这和让一整个 Episode 里的角色阵容保持一致是同一套机制——引用角色资产比每次重新描述角色靠谱得多——只不过这里用在了单张脸的尺度上。
整张差分表最好在一次会话里生成完。就算角色资产锁定了,风格和光影的选择在不同会话之间也会有漂移,一张拖了一周才生成完的表,看得出来。
从差分表到 PSD
差分表是一份设计文档;绑定消耗的是图层。交付时要遵守三条规则:
- 每个状态都要变成一个原地差分图层。 和它要替换的部件在像素级别对齐,命名清晰(
mouth_A、mouth_I、eye_L_half),按部件分组。完整的打包规则在 PSD 规范里。 - 画状态,不要画过渡帧。 插值是绑定去做的事;你只需要提供两端的状态,以及每条链条里那一个让插值不出错的中间状态(比如半闭眼)。
- 标注意图。 在交付说明里给每个预设写一行注释——比如"阴影眼 + 扁平嘴 = 恐惧开关"——能省下绑定师瞎猜带来的整整一轮返工。
最常见的翻车点
- 只有开心的状态。 一张有五种微笑变体、却没有生气、没有难过、没有面无表情的差分表,只会给模型一种情绪。直播需要的是情绪范围,不是重复。
- 表情和角度一起变了。 这是最常见的、没法用的差分类型。每张画只能改一个变量。
- 跳过半闭眼状态。 睁眼直接跳到闭眼、没有中间状态,会产生那种一看就是廉价绑定的机械快门式眨眼。
- 嘴型状态没画口腔内部。 五个音素张开嘴,露出来的却是一个空荡荡的黑洞。在做音素组之前,先把口腔内部认真画一次。
- 在 4000px 下看得出来的细微表情,缩到 200px 就没了。 观众看到的模型是很小的。每个状态都要用缩略图大小测试一遍;如果情绪缩小之后就传达不出来,那就把它做得更夸张一点——这和管理细腻表演可读性的那条规则对每一个差分都适用。
常见问题
第一个模型需要多少种表情?
上面那份标准差分表——大概十几个状态加一两个预设——就足够覆盖眨眼、对口型和基本的情绪范围。具体清单要和绑定师商量确定;每一个状态都同时意味着画工成本和绑定成本。
表情设计应该在素材分层之前还是之后?
要在之前设计,最终画作可以和切图同步进行。状态本身决定了哪些部件需要单独分层出来——音素组要求嘴巴必须完整搭建;阴影眼要求阴影必须是独立图层。
生成出来的差分真的能对齐到可以直接原地替换吗?
只要每次请求都把角度和构图锚定在主图上,构图就能保持接近一致,但要有心理准备,在 PSD 里还需要手动微调对齐。生成技术解决的是身份一致性,最后那几个像素的精度还是得靠你自己。
身体姿势和手部开关状态呢?
同样的规则,只是部件更大:每个姿势变体都是特定图层的原地差分。先从脸部差分表开始——直播的大部分时间都花在脸上——身体开关状态可以留到修改轮次里再补。
在纸面上先把性格定下来
绑定会原原本本地还原你现在设计出来的这套范围,不多也不少。列出状态清单,锁定主图,对着角色资产在一次会话里生成整张差分表,交给绑定师的是一个有十二种情绪的角色,而不是十二个看着眼熟的陌生人。打开你的项目,从眨眼链条开始——三张画,模型就已经开始有生气了。