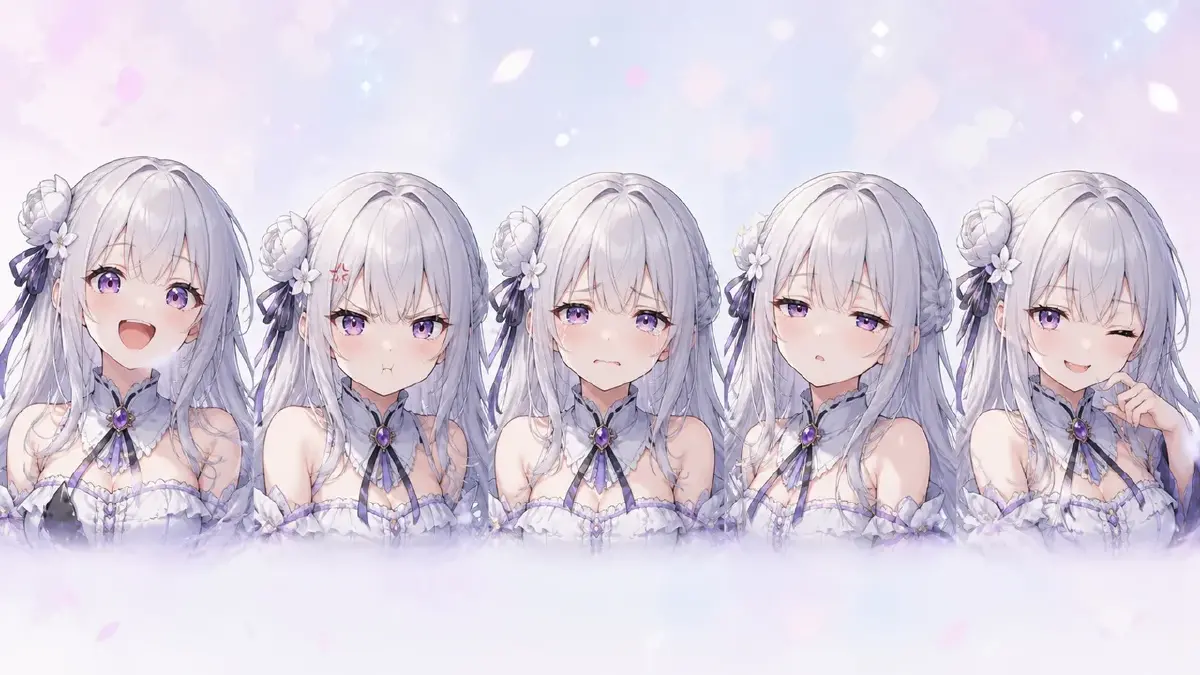
為什麼需要表情差分表
Live2D 的繫結本身不會讓你的角色變得有表現力。它只是把你交給它的表情播放出來。如果檔案裡只有一張平靜的臉和一個微笑,那就是這個模型的全部情緒範圍——而且是永久的,每一場直播都一樣。一個 VTuber 真正的性格,是在表情差分表這一步定下來的,而且是在繫結(rigging)開始之前就定下來的。
問題在於:一張表情差分表是十幾張畫,畫的是同一張臉,而"一樣"恰恰是最難的部分。手繪畫師靠結構線和多年練習來解決這個問題。如果你的畫是生成的,解決辦法就是身份管理的規矩——不然你交給繫結師的就是十個略有不同的角色,最後得到一個一眨眼就變臉的模型。
這篇指南講清楚一個繫結真正會用到哪些狀態,以及怎麼把它們做成一張前後一致的差分表。
一個繫結真正會用到的狀態
Live2D 的表情是由繫結師混合各個部件狀態搭出來的。按這個思路去設計,每一張畫都能直接對應一個引數:
眼睛——眨眼鏈條。 睜眼(基礎狀態)、半閉、全閉。如果設計需要,再加一個笑眼閉合作為第四種狀態。半閉狀態是讓眨眼看起來柔和而不是機械的關鍵,也是新手最容易漏掉的一個。
嘴巴——音素組。 對口型是在 A / I / U / E / O 這幾種嘴型之間混合切換的——大張、扁平張開、小而圓、半張、圓形張開。口腔內部只要完整畫一次:牙齒、舌頭、內部陰影。每個音素都會露出其中一部分。
眉毛——情緒的主要載體。 平靜、挑眉、生氣斜挑、難過斜挑。眉毛狀態畫起來便宜,繫結起來也便宜,卻比臉上任何其他部件都更容易讀出情緒。千萬不要交一張只有平靜眉毛的差分表。
臉部附加效果。 腮紅開、眼淚開、恐懼時蓋住眼睛的陰影——每一個都單獨做成一個可開關的疊加狀態。
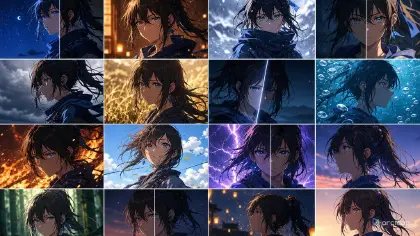
全臉預設表情。 喜、怒、哀、驚——把上面這些狀態組合起來,再加上單個部件做不到的效果(閃亮的眼睛、鬼畜臉)。角色的喜劇感就活在這些預設表情裡;三四個夠強的預設,勝過十個軟綿綿的。
一份標準的首個模型差分表:三種眼睛狀態、五種音素嘴型、三種眉毛狀態、腮紅,再加一兩個預設表情。超出這些的部分都是"性格預算"——要花在你的內容真正會觸發的狀態上。
怎麼讓十張臉始終是同一張臉
如果各個狀態之間的身份對不上,整張表就廢了。三條規則能把它們綁在一起:
先鎖定主圖,再做差分表。 平靜表情的那張臉,是每個差分都必須對得上的參考。如果你的設計還在調整中,就還沒到做差分的時候——先完成設計鎖定。
每張畫只改一件事。 一個表情差分改變的應該只是表情。角度一樣、光影一樣、頭髮一樣、服裝一樣、構圖一樣。一旦某個差分連頭部角度都變了,繫結師就沒法把它當成原地圖層替換來用。
引用角色本身,而不是重新描述一遍。 在 ArcLoop 裡,把 VTuber 做成一個角色資產,主圖 Bind 為它的 Main Image。生成每個狀態時都引用這個角色資產——只描述"這次變化了什麼":
Same framing and lighting as the master portrait of @Mio.
Only change: eyes half-closed, mouth in the "U" phoneme — small,
round, slightly pursed. Hair, outfit, and angle identical.
因為身份資訊由角色資產承載,十次請求生成出來的就是同一張臉的十種狀態。這和讓一整個 Episode 裡的角色陣容保持一致是同一套機制——引用角色資產比每次重新描述角色靠譜得多——只不過這裡用在了單張臉的尺度上。
整張差分表最好在一次會話裡生成完。就算角色資產鎖定了,風格和光影的選擇在不同會話之間也會有漂移,一張拖了一週才生成完的表,看得出來。
從差分表到 PSD
差分表是一份設計文件;繫結消耗的是圖層。交付時要遵守三條規則:
- 每個狀態都要變成一個原地差分圖層。 和它要替換的部件在畫素級別對齊,命名清晰(
mouth_A、mouth_I、eye_L_half),按部件分組。完整的打包規則在 PSD 規範裡。 - 畫狀態,不要畫過渡幀。 插值是繫結去做的事;你只需要提供兩端的狀態,以及每條鏈條裡那一個讓插值不出錯的中間狀態(比如半閉眼)。
- 標註意圖。 在交付說明裡給每個預設寫一行註釋——比如"陰影眼 + 扁平嘴 = 恐懼開關"——能省下繫結師瞎猜帶來的整整一輪返工。
最常見的翻車點
- 只有開心的狀態。 一張有五種微笑變體、卻沒有生氣、沒有難過、沒有面無表情的差分表,只會給模型一種情緒。直播需要的是情緒範圍,不是重複。
- 表情和角度一起變了。 這是最常見的、沒法用的差分型別。每張畫只能改一個變數。
- 跳過半閉眼狀態。 睜眼直接跳到閉眼、沒有中間狀態,會產生那種一看就是廉價繫結的機械快門式眨眼。
- 嘴型狀態沒畫口腔內部。 五個音素張開嘴,露出來的卻是一個空蕩蕩的黑洞。在做音素組之前,先把口腔內部認真畫一次。
- 在 4000px 下看得出來的細微表情,縮到 200px 就沒了。 觀眾看到的模型是很小的。每個狀態都要用縮圖大小測試一遍;如果情緒縮小之後就傳達不出來,那就把它做得更誇張一點——這和管理細膩表演可讀性的那條規則對每一個差分都適用。
常見問題
第一個模型需要多少種表情?
上面那份標準差分表——大概十幾個狀態加一兩個預設——就足夠覆蓋眨眼、對口型和基本的情緒範圍。具體清單要和繫結師商量確定;每一個狀態都同時意味著畫工成本和繫結成本。
表情設計應該在素材分層之前還是之後?
要在之前設計,最終畫作可以和切圖同步進行。狀態本身決定了哪些部件需要單獨分層出來——音素組要求嘴巴必須完整搭建;陰影眼要求陰影必須是獨立圖層。
生成出來的差分真的能對齊到可以直接原地替換嗎?
只要每次請求都把角度和構圖錨定在主圖上,構圖就能保持接近一致,但要有心理準備,在 PSD 裡還需要手動微調對齊。生成技術解決的是身份一致性,最後那幾個畫素的精度還是得靠你自己。
身體姿勢和手部開關狀態呢?
同樣的規則,只是部件更大:每個姿勢變體都是特定圖層的原地差分。先從臉部差分表開始——直播的大部分時間都花在臉上——身體開關狀態可以留到修改輪次裡再補。
在紙面上先把性格定下來
繫結會原原本本地還原你現在設計出來的這套範圍,不多也不少。列出狀態清單,鎖定主圖,對著角色資產在一次會話裡生成整張差分表,交給繫結師的是一個有十二種情緒的角色,而不是十二個看著眼熟的陌生人。開啟你的專案,從眨眼鏈條開始——三張畫,模型就已經開始有生氣了。