H3 还是 H3 Max?先看这个镜头要完成什么
先看交付尺寸,再看哪条结果能用。H3 有常规 2K、4K 输出流程,Max 提供 768P 与精细化处理后的 1080P。下方的四图参考实测中,两者的构图和镜头选择接近,没有看出 Max 明显的运镜优势。 两者在 fal 上都有参考生成接口,角色图、动作片段或声音参考都可以纳入比较。
Max 是 fal 在 H3 基础上后训练的版本,优化方向包括提示词遵循、画面美感和吞吐量。一条结果只要画面、声音合格,也能接上前后镜头,就可以放进成片。做连续剧集时,先测试难点:转身露出脸、手部改变握法,或者运镜过程中说话。
规格核验于 2026 年 10 月 25 日。下表分开说明 fal 接口、MiniMax 公布的基础模型规格与本地工作流,它们开放的设置可能不同。
fal 上的时长与分辨率限制
| 服务与模式 | 时长信息 | 可选输出 | 需要分清的口径 |
|---|---|---|---|
| H3 文生视频 | fal 描述的范围为 5–15 秒,默认 5 秒 | 480P、768P、2K、4K | schema 将 480P、768P 标为原生模式;2K、4K 由 768P 基础结果升分辨率得到 |
| H3 图生视频 | fal 的 H3 指南给出相同的 5–15 秒范围,默认 5 秒 | 480P、768P、2K、4K | 输出画布跟随提供的关键帧 |
| H3 参考生成 | fal 的 H3 指南给出相同的 5–15 秒范围,默认 5 秒 | 480P、768P、2K、4K | 图片、视频、音频共享参考素材总预算 |
| H3 Max 文生视频/图生视频 | 通用指南为 5–15 秒,默认 5 秒;音频相关细节见下文 | 480P、768P、1080P | 1080P 在原生 768P 基础上进行 latent refinement |
| H3 Max 参考生成 | 通用指南为最长 15 秒;schema 默认 5 秒 | 480P、768P、1080P | 参考与关键帧控制不同于普通图生视频模式 |
| H3 Max Extend 续写 | duration 表示新增画面的时长,默认 5 秒 | 480P、768P、1080P、2K | 可返回完整延长视频,或带源片重叠的续写片段 |
作为对照,MiniMax 自己的 H3 公告写的是 4–15 秒、768p 基础输出,以及独立的 2K 重生成阶段。这不意味着每个托管服务都接受 4 秒作为最短时长。上面的 fal 参数表也不代表自部署工作流的输出限制。
批量生成前,核对具体接口的时长字段。Max 文生视频和图生视频 schema 接受浮点数,并注明搭配 target_audio_url 时至少使用 2 秒;该字段没有完整列出指南中的范围。要把这条音频条件与通用范围分开看。Max 还提醒,返回文件可能比请求时长多约 0.7 秒。
表格记录的是文档支持的选项。下方案例分别测试了一次 12 秒、768P 参考生成,没有覆盖表内所有参数边界。ArcLoop 实际开放的设置可能不同。
什么时候用 H3,什么时候用 H3 Max
| 这个镜头最在意什么 | 从哪里开始 | 保留结果前检查什么 |
|---|---|---|
| 通过 fal 常规生成接口交付 2K 或 4K | H3 | 更大的输出尺寸不能修复动作、肢体或一致性问题 |
| 尝试多种运镜、构图或表演 | 用相同输入比较两者 | 本次参考样片的镜头设计接近,比较可用结果、总等待与成本 |
| 动作与声音已经合格的成片 | 保留满足交付尺寸的可用结果 | Max 也可以用于成片;换模型重生成可能改变已经满意的表演 |
| 多个角色、动作或声音参考 | 比较两者的参考生成模式 | 同时检查身份、动作和声音,不照搬文生视频的速度结论 |
| 延长已有片段 | H3 Max Extend 是有文档支持的选项 | 检查重叠、返回模式,以及新旧画面的连接处 |
| 本地执行、自定义节点或已有 LoRA 流程 | H3 基础模型及兼容的本地工具 | 检查实际权重、节点支持、显存和许可;托管 Max 的结果不能证明它能在本地使用 |
Reddit 上比较有用的经验,都在讲模型放进流程后怎么用。一位 Max 用户先快速尝试多个概念,再做较慢的成片处理。另一篇讨论中,使用参考素材的用户更愿意保留已有的基础模型 LoRA 流程,并反馈 Max 参考模式的加速不如文字模式明显。这两份个人报告不足以决定谁的画质更好,但提醒我们,应当测试自己真正要用的模式。
做动画时,让两个模型处理同一个有难度的动作,使用相同参考。检查脸、手、物件移动和对白,再数一数哪些结果愿意留下。计时到文件能播放为止,成本里也算上废片。放到整集的制作中,这比最快的一次生成更能说明问题。
H3 与 H3 Max 视频对比:同样四张参考图
快递员把一个关闭的金属盒带进车站维修间,工程师接过盒子,回应她的提醒,再看向窗外。我们让 H3 和 H3 Max 用三个镜头讲完这段小情节:双人中景、交接特写,以及回答时更近一些的双人镜头。
两条结果在构图和镜头选择上很接近,这组样片没有显示出 Max 明显的运镜或剪辑优势。 两者都呈现了要求的三种景别,节奏有所不同,也都没有准确执行第 4 秒的第一次切镜。对这样的场景,先比较愿意留下的结果和成本,再决定是否为模型名称多付费用。
参考图与统一设置
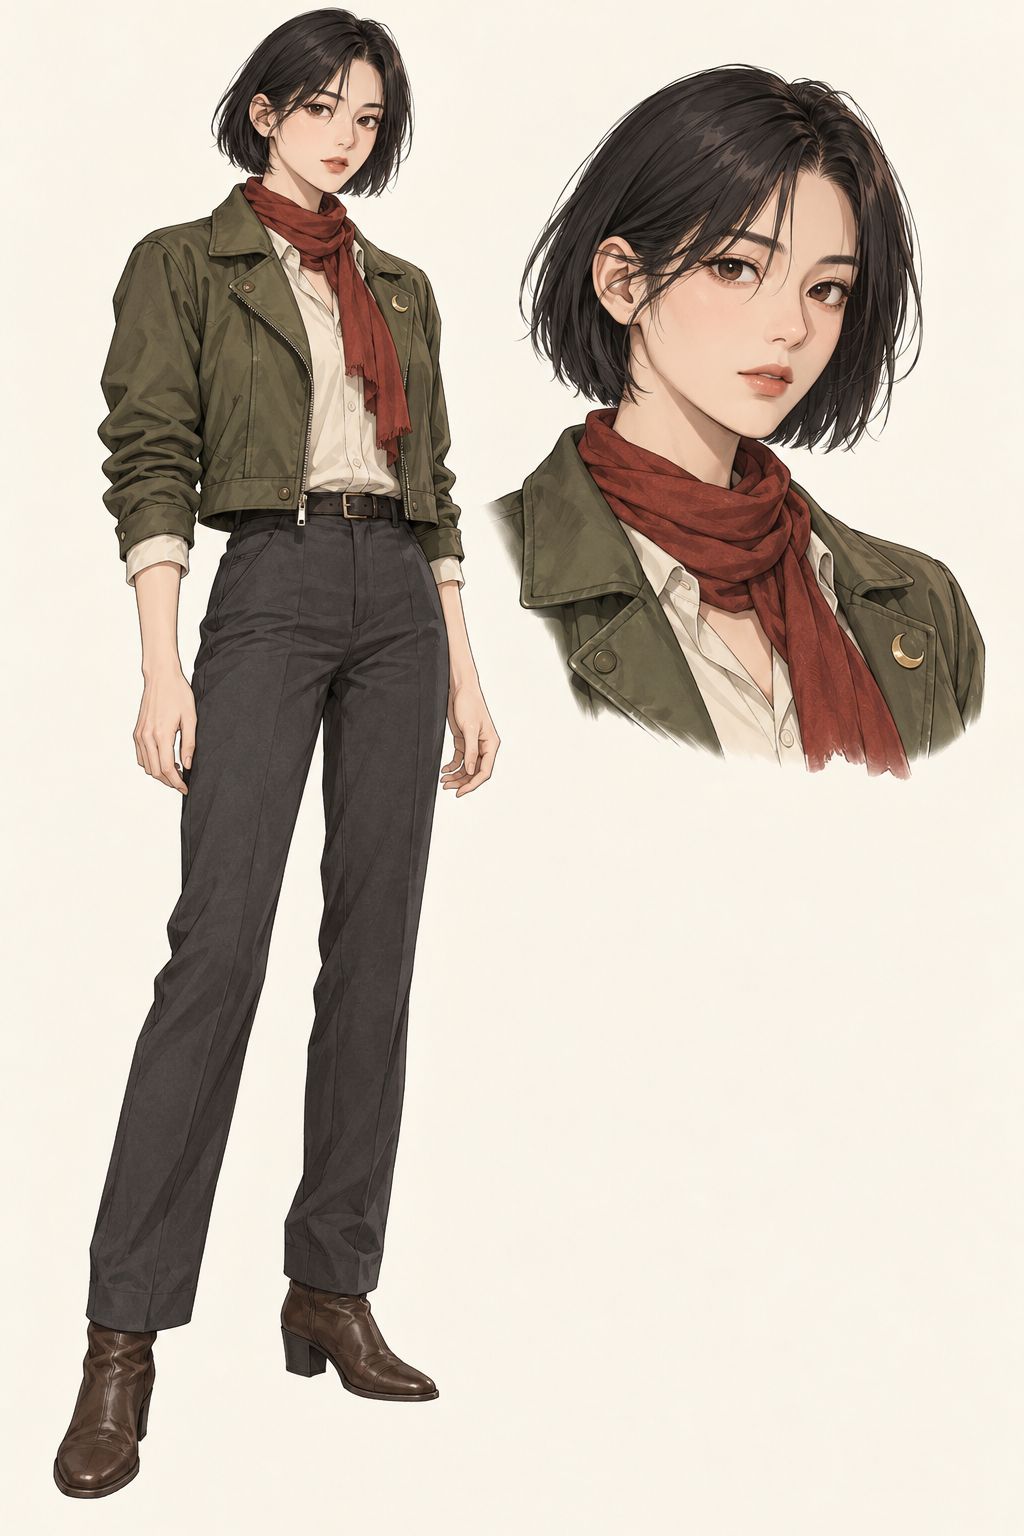
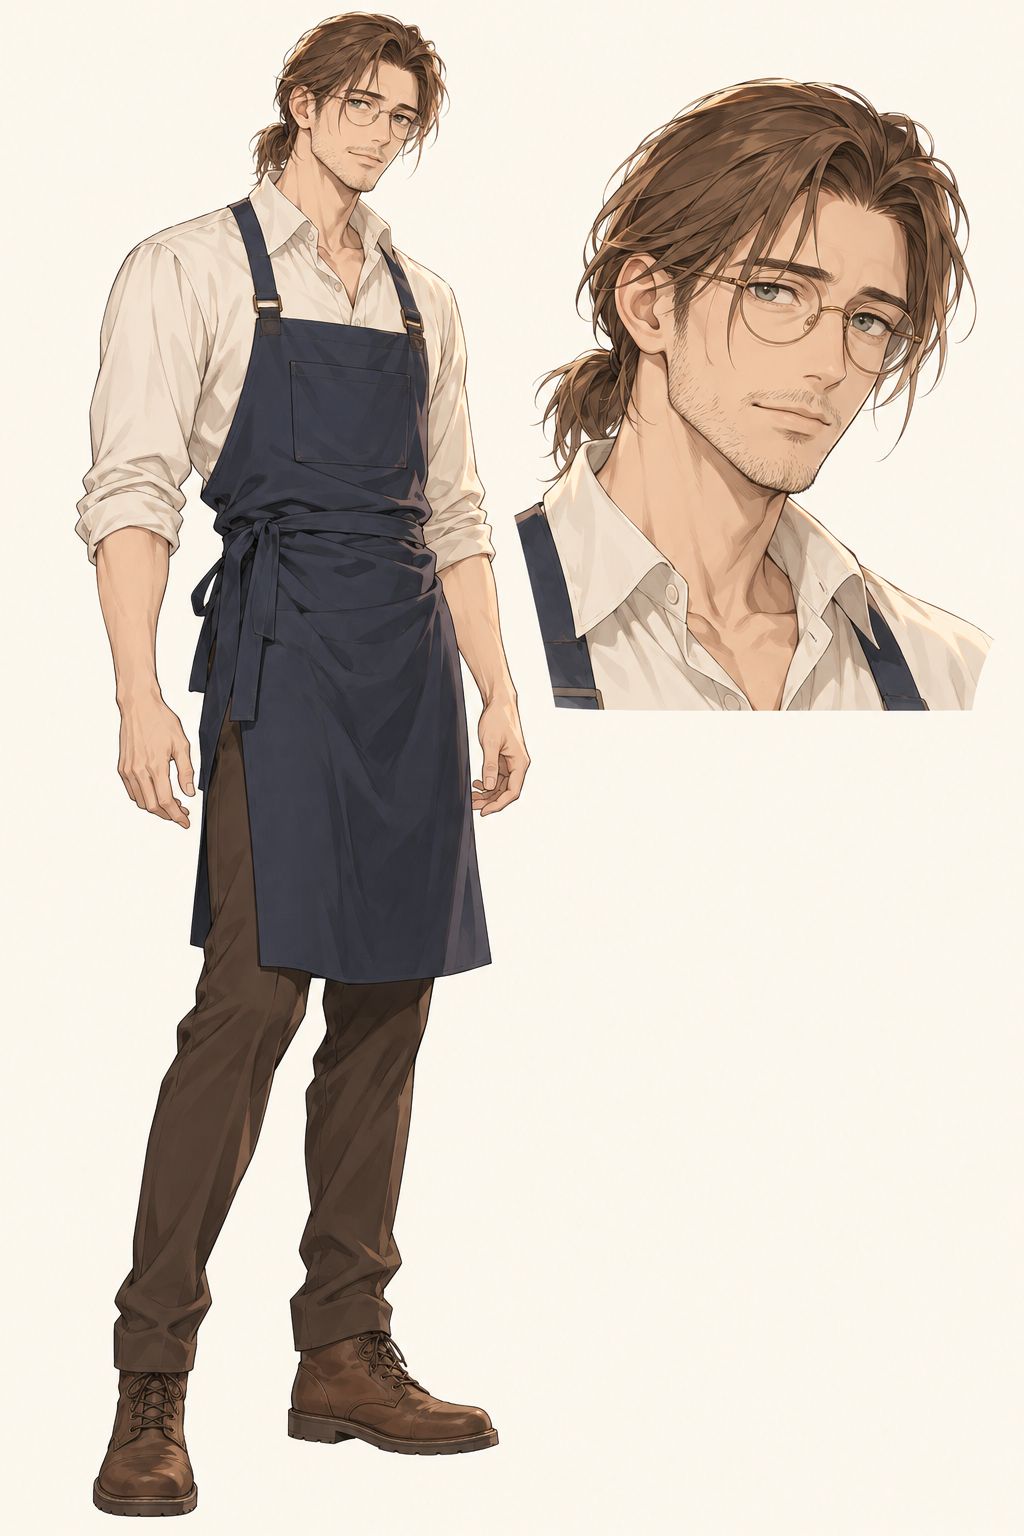
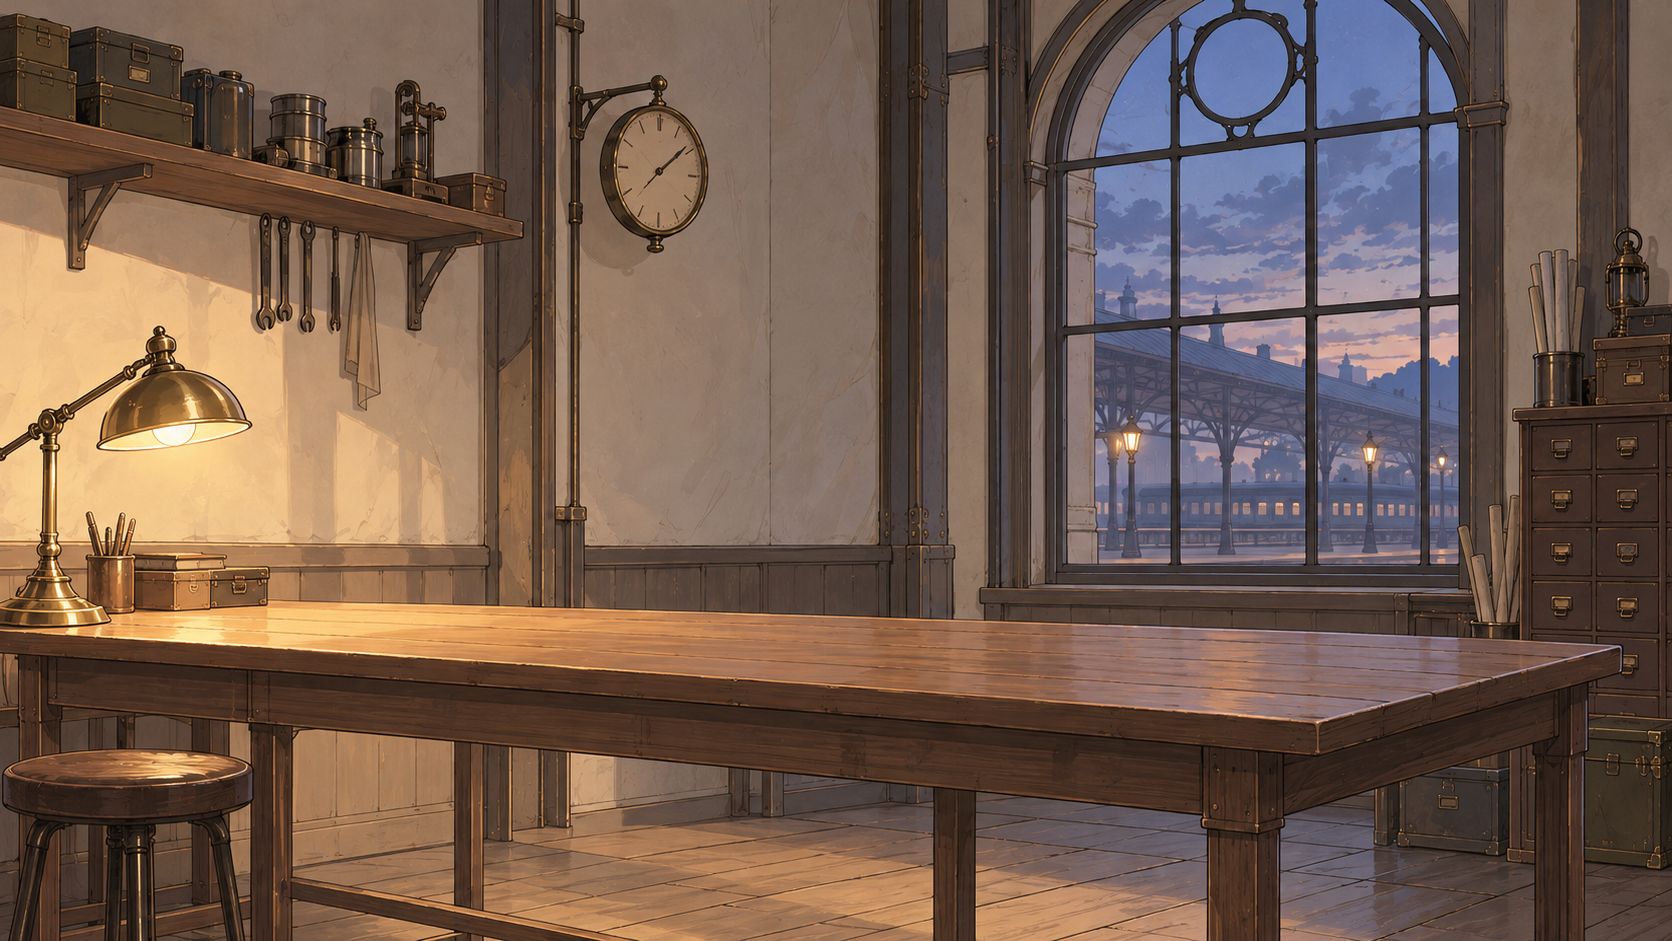
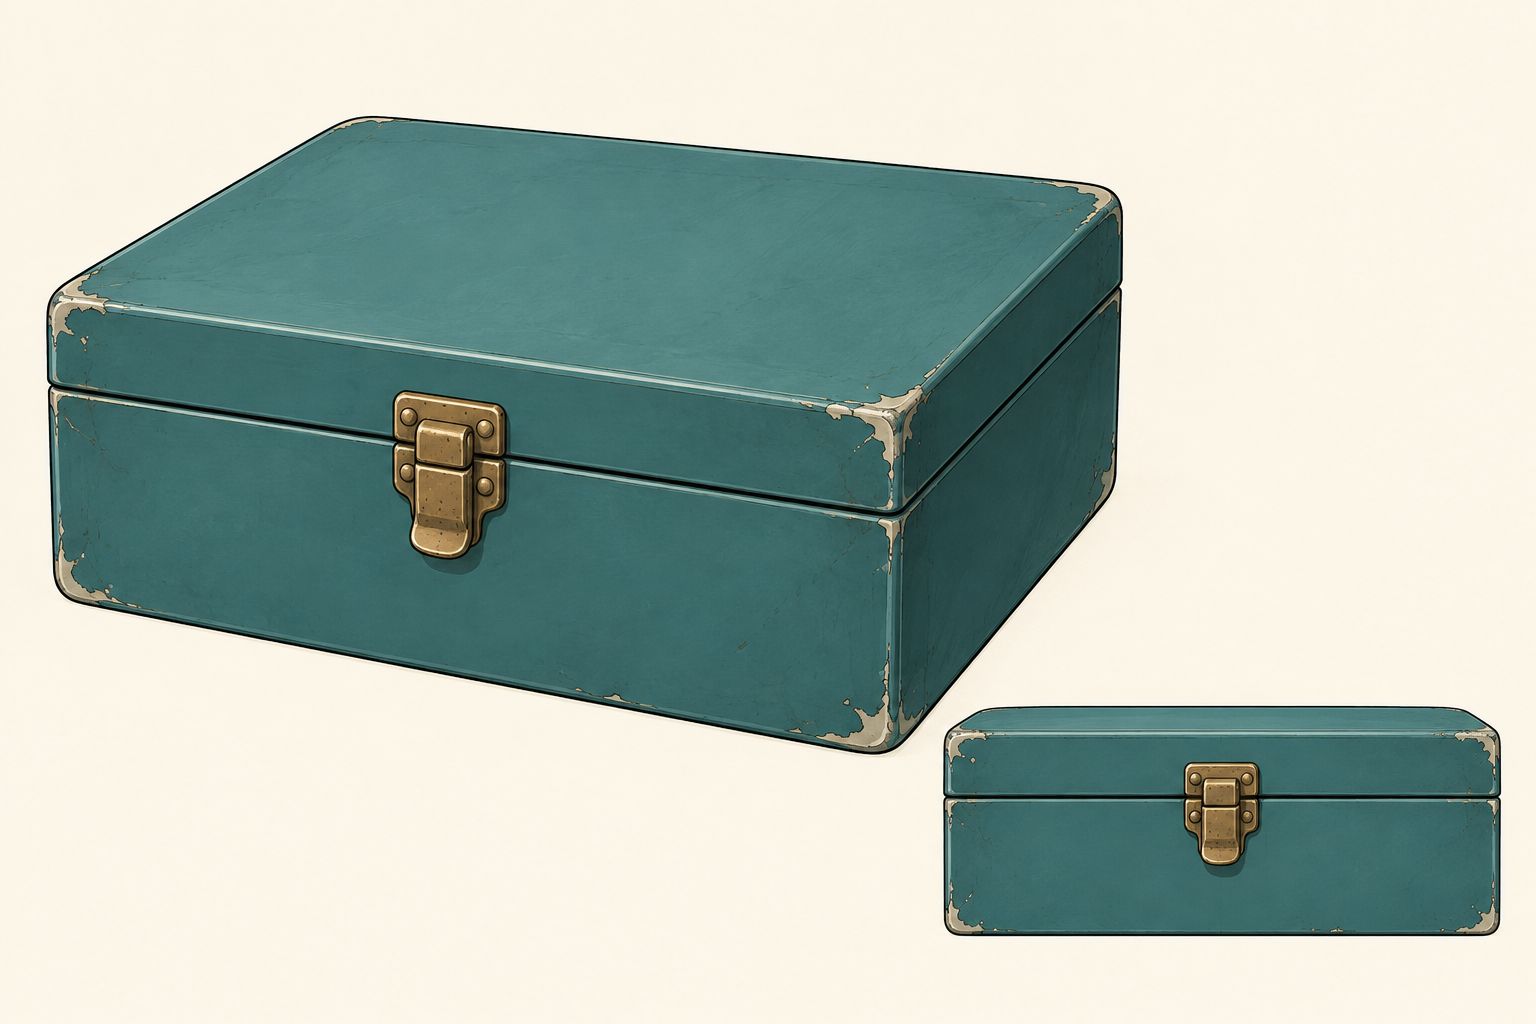
输入依次是两张角色设定图、一张场景图和一张道具图。下面使用的是重绘后的维修间,让场景更贴合角色的韩漫画风。两条视频使用完全相同的这组素材。没有提供动作视频或声音参考,对白由各模型自行生成。
分别播放两条完整结果
MiniMax H3
fal H3 Max
请分别播放,听各自生成的声音。两份源文件均为 1344×768、24 fps、12.25 秒。这里的 1280×720 展示版保留全部 294 帧与原始声音,只做等比例缩放和留边,没有变速、补帧或替换对白。
| 实际记录 | MiniMax H3 | H3 Max |
|---|---|---|
| 提交到返回结果 | 21.282 秒 | 19.585 秒 |
| 提交到本地下载完成 | 29.168 秒 | 25.305 秒 |
| 实际文件时长 | 12.25 秒 | 12.25 秒 |
以上是单次客户端观测,包含请求和轮询时间,不包含参考图上传与展示版导出。Max 这次返回结果约快 1.7 秒;这样的样本量不足以给模型做速度排名。
这组结果对镜头选择有什么帮助
两条视频都遵循了相近的画面结构:Mina 在左、Ivo 在右,切近看盒子交接,再回到两人。Max 较早进入后续镜头,但整体镜头处理接近。仅凭这组结果,看不出为了获得更丰富的构图而优先选择 Max 的明显理由。
切镜要求也说明了后期剪辑的作用。Prompt 要求在第 4 秒和第 8 秒硬切,但两者的开场镜头都比要求更长。把这些时间点当作生成方向;节奏必须准确落点时,再对保留的素材进行剪辑。自动转写在两条视频中都识别出了目标英文台词,但不能据此判断音色身份或精确口型。这一对结果也不足以决定手部结构、完整运动质量或整集一致性谁更好。
对这个场景,如果 H3 的结果已经服务于剪辑,就值得继续保留在选项中。Max 的实际表演、交付选项或周转时间对项目有用时,再选择 Max。成本要核对具体生成模式,并计入参考输入费用;文生视频的活动价不能直接当成多参考请求的账单。
双方实际使用的完整英文 Prompt
A 12-second Korean webtoon-style animated scene, 16:9, with three deliberately edited shots. Fine ink lines, soft restrained cel shading, expressive adult faces. A quiet clockwork railway station workshop at blue hour. Natural real-time performance.

REFERENCE ASSIGNMENTS
Image 1 defines Mina, the adult female courier: short black bob, moss-green jacket, rust-red scarf, gold crescent pin. Image 2 defines Ivo, the adult male engineer: brown low ponytail, round brass glasses, navy apron over a cream rolled-sleeve shirt. Each character sheet shows one person at two scales; those insets are not additional people. Preserve each character's face, hairstyle, clothing and accessories across every cut.
Image 3 defines the empty workshop, wooden counter, brass lamp at screen left and blue arched station windows. Maintain the warm light from left and cool window light from right.
Image 4 shows two views of ONE small teal metal box with one centred brass latch. Use exactly one box, with the same proportions, colour and closed lid in all shots. Do not reproduce the reference-sheet layout or duplicate the box.

SHOT 1 — 0.0 TO 4.0 SECONDS — ESTABLISHING MEDIUM TWO-SHOT
Mina stands at screen left on the near side of the counter. Ivo stands at screen right behind the counter. Start with the closed teal box held by Mina above the clear countertop. Gentle, short camera push-in. Mina sets the box on the counter and begins sliding it towards Ivo. Starting around 0.8 seconds, Mina says in English, clearly and with restrained urgency: "Keep it closed until the last train leaves." Ivo is silent and watches the box. Finish the entire line before the next shot.

HARD CUT ON THE MOVING BOX at 4.0 seconds. Match the box's position and movement across the cut. Stay on the same side of the action axis; keep Mina to the left and Ivo to the right.

SHOT 2 — 4.0 TO 8.0 SECONDS — HANDOVER INSERT CLOSE-UP
Tight view of the same closed teal box and both characters' hands, with their distinct sleeve colours visible. Mina's hand enters from the left, Ivo's hands from the right. Ivo takes a secure two-handed grip before Mina releases the box. Mina withdraws her hand; Ivo lifts the box a few centimetres, then sets it on his side of the counter. Show contact and release as one readable action. Only one box. The lid remains closed. Quiet metal-on-wood and cloth sounds, no dialogue during this insert.

HARD CUT at 8.0 seconds to a MEDIUM-CLOSE TWO-SHOT from the same side of the axis. Match Ivo's hands and the box to the end of the insert. Do not reset the handover or return the box to Mina.

SHOT 3 — 8.0 TO 12.0 SECONDS — REPLY AND REACTION
The box rests on the counter in front of Ivo, his hands beside it. Ivo looks at Mina and says in English in a calm lower male voice: "Then we still have time." Mina is silent. After his line, Mina turns her head towards the station windows, her scarf shifting slightly at her chin; Ivo follows her gaze. Hold the final moment with both characters and the closed box visible. A subtle push-in is allowed, no additional cut.

EDITING AND AUDIO RULES
Exactly three shots with clean hard cuts at about 4 and 8 seconds. Use match-on-action continuity at the handover and respect the 180-degree rule. No dissolves, split screens, panels, slow motion, time jumps or added shots. Keep spatial layout, lighting, faces, outfits and the box consistent through the edits. Generate native English dialogue with distinct voices assigned to the correct speaker. Only the assigned speaker talks; no overlapping speech, no narration, no subtitles or on-screen text. Quiet station ambience and restrained handover foley, no music. No extra people, cloned characters, floating hands, opened box or duplicated props.
参考素材限制:文件数和秒数分别计算
首帧确定开场构图,主体参考提供身份或外观。在 fal 图生视频模式中,画布跟随关键帧;参考生成模式有自己的比例控制,因此横向角色图不自动决定输出横屏。
| 参考规则 | 适用范围 |
|---|---|
| 图片最多 9 张、视频最多 3 段、音频最多 3 段,混合总数最多 12 份 | MiniMax 公布的 H3 Ref2VA 规格;不能假定每个 Max 封装都沿用这些单项上限 |
| 参考视频每段 2–15 秒,合计最多 15 秒 | 本次核对的两个 fal 参考生成 schema |
| 参考音频每段 2–15 秒,合计最多 15 秒 | 本次核对的两个 fal 参考生成 schema |
| 参考图片、视频、音频混合总数最多 12 份 | 本次核对的两个 fal 参考生成 schema |
9 张图加 3 段视频,再加 3 段音频,一共是 15 份。 即使每类都符合 MiniMax 的单项上限,也超过混合总预算。6 张图、3 段各 5 秒的视频、3 段各 5 秒的音频,共 12 份,视频合计 15 秒,音频合计 15 秒。这满足列出的数量与时长预算,但不保证通过其他所有文件校验,也不保证生成效果。
纯音频参考的规则需要核对:MiniMax 公告和 fal 指南要求同时提供视觉输入,两个 fal 当前参考 schema 却写着可以单独或组合提供各类参考。在具体接口的文档差异确认清楚前,建议配上相关画面。本次修订未测试纯音频参考。
原生分辨率、精细化输出与导出尺寸
看分辨率标签时,也要看处理步骤。fal H3 的 2K、4K 输出以 768P 为基础,Max 的 1080P 从 768P 做 latent refinement,Extend 则有单独的 2K 选项。表格将这些路径分开列出。
720p 下载文件也可能只是导出版。上方两条参考视频的源文件均为 1344×768,展示版为 1280×720。这是交付转换,不代表原生 720p 生成模式。标注前,读取实际文件的宽、高、帧率和时长。
制作关键帧前先确定交付比例:横向播放器用横屏,竖屏短片用竖屏。检查实际裁切,把脸、手和字幕放在可见区域内。主体已经被构图裁掉,再高的像素也补不回来。
续写时,别把连接处重复拼进去
Max Extend 接受 1.625–60 秒、最大 50 MB、宽高比介于 0.4 与 2.5 之间的源视频。duration 请求的是新增画面时长;extended 返回源片和续写合成的整段,continuation 则在开头重复源片末尾的 1.625 秒。
例如,源片 10 秒,再请求新增 5 秒,完整返回结果预计约 15 秒;只返回续写时,在帧取整前预计约 6.625 秒。把后者不加裁切地接到原片后面,就会重复连接处。这是基于文档的计算示例,没有实测续写;剪辑前仍需检查实际返回文件。
提示词写接下来发生的动作,生成后检查连接处的位置、光线、动作和声音。Reddit 关于逐镜头与多镜头生成的讨论,提出了一个实际取舍:分开的片段便于替换,同一段连续生成中的对白则共享更多当下的上下文。跨次调用的声音仍然需要逐条检查。
常见问题
H3 Max 只能出草稿吗?
不是。画面、声音和交付规格都合格的片段,可以直接用于成片。Max 的名称和速度不能决定一条结果是否可用;要检查实际视频,尤其是它是否需要与前后镜头匹配。
H3 Max 支持参考生成和续写吗?
支持:fal 有独立的参考生成与 Extend 接口。不能从文生视频表单推断其他模式的控制项,也不能把它们与另一个 H3 Max Turbo 模型混为一谈。
H3 能在本地一次生成超过 15 秒吗?
Reddit 有作者报告做过 42 秒的本地实验,同时说明画质、控制和处理耗时都有代价。这是超出通常公布范围的实验,不代表托管接口接受 42 秒,也不保证本地工作流能稳定交付。
第一个动画镜头应该选哪个?
先看交付尺寸与输入素材。这组参考样片没有显示出仅为镜头设计而优先选择 Max 的明显理由。比较可用结果、成本和周转时间;需要常规 2K、4K 输出流程,或者依赖已有基础模型工作流时,考虑 H3。用 AI 动漫生成工具先搭一个短场景,检查一致性和声音,再扩展成序列。