Саундтрек и озвучка — финальный штрих любого короткометражного ИИ-фильма. Современные видеомодели уже умеют генерировать картинку вместе со звуком, но они не являются специализированными аудиоинструментами. Если вы хотите поднять качество фильма на новый уровень, стоит использовать отдельную модель для генерации звука. В этой статье на примере Seed Audio мы покажем, как создавать индивидуальные звуковые фрагменты для ваших сцен.
Для начала послушайте пример звуковой сцены со страницы модели Seed Audio:
В этом примере сочетаются пространственная реверберация голоса, яркая эмоциональная актёрская подача и фоновая музыка. При прослушивании обратите внимание на то, как затухают окончания фраз, как меняется интонация и как музыка поддерживает игру. Именно такие детали стоит прорабатывать, когда вы создаёте звук отдельно для ключевых сцен.
Рабочий процесс прост: сначала сгенерируйте видеоряд, выберите моменты, которые нужно усилить, затем создайте для них звук, подставьте его под кадр для проверки и завершите монтаж.
Part 01|Когда стоит использовать Seed Audio
Видеомодели могут создавать звук одновременно с изображением, однако эмоциональная подача ключевых реплик, микропаузы и баланс между фоновыми шумами и голосом не всегда дотягивают до уровня, нужного конкретной сцене. Если кадр получился удачным, но диалогу не хватает выразительности или фоновый звук не удаётся настроить как нужно, имеет смысл поработать со звуком отдельно.
Видеопромпты в первую очередь описывают изображение, действие, движение камеры и раскадровку, поэтому места для детального описания звука в них остаётся мало. Когда визуальная часть уже утверждена, ключевые по драматургии эпизоды можно передать специализированной аудиомодели вроде Seed Audio — и подробно описать, как именно должна звучать реплика, как ведёт себя фон и в каком ритме развивается сцена.
| Что нужно усилить | Что можно детально настроить |
|---|---|
| Ключевые реплики и эмоции | Звучит ли одна и та же фраза виновато, осторожно или удивлённо; где стоит логическое ударение, сколько длится пауза до и после слов |
| Баланс голоса и фона | Музыка отступает, когда говорит персонаж, и раскрывается после паузы в конце фразы; шаги и ветер остаются на заднем плане |
| Конкретные звуки сцены | Шаги за кадром, стук в дверь, работа механизмов или соло конкретного инструмента с нужной манерой игры и тембром |
| Эмоциональный поворот | При одном и том же видеоряде тёплое, печальное или тревожное звучание меняет то, как зритель воспринимает встречу |
Определите реплики и логику диалога ещё на этапе создания видео, а затем точечно доработайте звук для выбранных фрагментов — так вы сохраните уже удачные кадры. Если исходный звук на отдельных участках подходит, оставьте его; при замене реплик обязательно сверяйте длительность и артикуляцию губ, а также следите, чтобы новая дорожка не накладывалась на старую.
Эти три музыкальных фрагмента были сгенерированы по отдельности, а затем подложены под один и тот же пятисекундный план для сравнения. Ниже приведены три промпта, которые реально использовались в итоговом ролике:
WARMTH: тёплое фортепиано в мажоре и мягкие струнные показывают, что ожидание было не напрасным.
Create a five-second instrumental film-music cue for a quiet reunion at an old European railway station. Begin immediately with gentle, sparse piano in a warm major harmony. Around the middle, a soft sustained string chord opens with a little hope, as a waiting woman notices someone arriving offscreen. End softly and reassuringly. Intimate and restrained, no big climax. Music only: no speech, narration, singing, voices, station ambience, sound effects or percussion. Do not read the instructions aloud.
SORROW: виолончель, нисходящая минорная мелодия и неразрешённый финал придают встрече оттенок горечи и утраты.
Create a five-second instrumental film score that immediately conveys grief and a painful reunion. Start at once with an expressive solo cello playing a clearly descending minor-key melody, supported by dark sustained violas. Let the melody fall and linger as if someone realizes a loved relationship is lost. Strongly sorrowful and emotionally exposed, intimate rather than epic. No cheerful or comforting resolution. Keep the music clearly audible throughout, ending with an unresolved sustained note. Music only. No speech, singing, voices, piano, ambience or sound effects.
DANGER: повторяющийся бас, пульсация, диссонирующие струнные и резкая тишина в финале заставляют почувствовать угрозу от того, кто приближается за кадром.
Create a five-second instrumental psychological-thriller score with unmistakable immediate danger. From the very first moment, use a tight repeating low-string ostinato and a deep controlled bass pulse. Add close, tense dissonant high strings, building rapidly in density as someone threatening approaches offscreen. Make the tension clear and urgent rather than faint background atmosphere. During the final half-second abruptly cut the music to silence. No jump-scare impact. Music only. No speech, singing, voices, gentle piano, warm harmony, ambience or literal sound effects.
Перед каждым вариантом идёт титр длительностью 0,75 секунды, а общая продолжительность сравнительного ролика составляет около 17,25 секунды. При прослушивании обратите внимание, как одно и то же движение глаз героини три разные музыкальные темы превращают то в облегчение, то в сожаление, то в настороженность.
Part 02|Как писать промпты для Seed Audio
В аудиопромпте нужно чётко задать три вещи: что произносится, как это звучит и в какой момент происходит.
В документации к API генерации аудио приведён пример напряжённого диалога: сцену открывает вибрация телефона, на фоне непрерывно поют птицы, маримба в сочетании с электронными тембрами создаёт саспенс; двое мужчин говорят по очереди, а в финале действие двигают вперёд звуки машины и шагов. В этом примере голоса персонажей, музыка и звуковые эффекты объединены в одном промпте.
| Элемент промпта | Как это реализовано в примере из документации | Что указывать для своей сцены |
|---|---|---|
| Содержание: кто и что говорит | Отдельно заданы реплики двух мужчин и очерёдность их вступления | Имена персонажей, дословные реплики, язык и наличие или отсутствие ответа |
| Звучание: как это слышится | Разграничены низкий плотный и хрипловатый зрелый мужские голоса, указан акцент; определены солирующий инструмент и аккомпанемент | Тембр, интонация, дистанция до персонажа, акустика среды и инструменты — вместо абстрактного «кинематографично» |
| Ритм: как развивается сцена | Сначала звучит сигнальный спецэффект, затем начинается диалог; расспросы и объяснения меняют интонацию, а в конце добавляются звуки движения | Момент вступления голоса, темп речи, паузы между фразами, появление и уход фоновых звуков |
Возьмём для примера сцену встречи на вокзале. Сначала сформулируем основу: одна точная реплика + конкретная манера исполнения + один чёткий звуковой переход. Мужчина за кадром произносит только «You waited.» — тихо, со сдержанной нежностью, а раскрывающееся после фразы фортепиано передаёт эмоцию встречи.
Последовательность звуков в сцене на вокзале такая: лёгкий ветер и фортепиано → два тихих шага → мужской голос произносит реплику, пока музыка остаётся совсем тихой → короткая пауза → фортепиано раскрывается.
Заключите реплику в кавычки и отдельно укажите, что девушка ничего не отвечает; шаги должны быть тише голоса, а объявления по вокзалу и шум поездов звучать не должны. Сначала пропишите эти соотношения, а затем добавьте примерный тайминг под длительность кадра. Временные ориентиры всегда нужно сверять с результатом генерации — особенно точные моменты вступления музыки и звуковых эффектов.
Если для фрагмента нужно соло на маримбе, укажите сам инструмент, мягкость палочек и характер удара, темп игры, плотность нот и способ завершения. Ниже приведён авторский черновой промпт, который можно взять за основу (аудио по нему ещё не генерировалось):
Create an eight-second solo marimba cue for a quiet, suspenseful scene. Use soft mallets and a warm wooden tone. Begin with sparse, slow notes and clear gaps between them. Gradually make the repeating pattern slightly more insistent, then stop before the final beat and leave a short silence. No voices, drums, synthesizers or other instruments.
Ритмическая схема здесь строится по принципу «разреженно → чуть настойчивее → внезапная пауза». Инструмент, манеру игры и развитие звука легко проверить по пунктам, но то, насколько убедительно работают тембр и ритм в кадре, всегда оценивается на слух.
Part 03|Дакинг (Ducking) в диалогах
Дакинг (ducking) — это приём, при котором фоновая музыка приглушается на время реплики персонажа и возвращается к прежнему уровню, когда фраза заканчивается. В тихой сцене встречи можно не только снизить громкость, но и сделать аккомпанемент более разреженным, чтобы всё внимание зрителя сосредоточилось на голосе.
Если вы генерируете голос и фон одновременно в Seed Audio, пропишите это взаимодействие прямо в промпте:
Когда мужчина тихо произносит «You waited.», фортепиано звучит совсем мягко, шум ветра отступает на дальний план, а шаги уже стихли. После реплики выдержите короткую паузу, а затем позвольте фортепиано мягко раскрыться, поддерживая безмолвную реакцию девушки.
Не пишите просто «сделай автоматический дакинг». Конкретно укажите, чей голос должен звучать отчётливо, какие звуки уступают ему место и в какой момент они возвращаются, а после генерации проверьте, справилась ли модель. В нашем примере весь этот баланс был получен за одну общую генерацию.
Если в исходном видео уже есть диалог, можно вырезать оригинальный аудиофрагмент в качестве ориентира и подробно описать, какие тембры, реплики и ритм нужно сохранить, а какую интонацию или баланс с фоном — скорректировать. После генерации послушайте новый вариант вместе с картинкой и замените исходную дорожку нужного фрагмента; подробно о монтаже рассказано в разделе Part 05.
Видеоряд здесь тот же — пятисекундный план на вокзале, сгенерированный в Seedance 2 Fast: девушка ждёт, опустив взгляд, а затем поднимает глаза на кого-то за кадром. Мужской голос произносит всего одну фразу, тихие шаги дают понять, что человек подошёл ближе, а вступающее после слов фортепиано поддерживает молчаливую реакцию героини.
Для создания этого звука использовался приведённый ниже промпт. Мы запросили восьмисекундный фрагмент, чтобы оставить достаточно пространства для шагов до реплики, паузы и раскрытия музыки после неё:
Create one complete eight-second cinematic sound scene at a quiet old European railway platform at dusk. Generate dialogue, subtle footsteps, outdoor ambience and piano music together as one coherent scene. At the beginning, a very gentle distant breeze and sparse soft warm piano establish quiet anticipation. Between about 1.0 and 2.1 seconds, exactly two very soft, unhurried shoe footsteps approach offscreen on dry concrete and stop a few feet away. The footsteps are a delicate background detail, much quieter than the speaking voice, never sharp, heavy or dramatic. Around 2.5 seconds, one adult man just offscreen speaks a single short line in natural, clear British English, with quiet surprise and restrained affection: "You waited." Only those two words, only one male speaker. Keep the music very soft around his words so his intimate delivery remains clear. After the line, leave a brief emotional pause with faint breeze. From about 4.8 seconds, let the piano gently open into a warm sustained chord, supporting the woman's silent reaction, then settle quietly at eight seconds. No additional dialogue, no reply, no narration, no singing, no announcements, no loud trains, no impact sounds. Do not speak these directions. Preserve the quiet intimacy of the reunion throughout.
Исходная аудиодорожка длится восемь секунд; для финального ролика из неё был взят непрерывный отрезок с 1,8 по 6,8 секунды и наложен на пятисекундное видео. На этапе постобработки мы лишь выровняли общую громкость и добавили короткие фейды в начале и в конце — без дополнительного наложения голоса, шагов или музыки и без поканального дакинга.
При прослушивании проверьте три момента: отчётливо ли слышна реплика, достаточно ли деликатно звучат шаги и действительно ли музыка раскрывается только после окончания фразы. Если какой-то из пунктов не сработал, скорректируйте соответствующую часть промпта, оставив уже утверждённый видеоряд.
Part 04|Диалоги с несколькими персонажами
В промптах для нескольких говорящих важно чётко связать между собой имена персонажей, тембры их голосов, принадлежность реплик и очерёдность вступления. Сначала протестируйте голоса обоих героев на коротком обмене из двух реплик и лишь затем переходите к более длинным диалогам.
| Персонаж | Голос и манера игры | Реплика в этом обмене |
|---|---|---|
| Alex, мужчина за кадром | Низковатый, тёплый взрослый мужской голос, естественный британский английский, с лёгким удивлением | “You waited.” |
| Maya, девушка в кадре | Более светлый, мягкий взрослый женский голос, естественный британский английский, спокойно и уверенно | “I said I would.” |
Используйте одни и те же имена персонажей на протяжении всего промпта и перед каждой фразой указывайте, кто именно говорит. Описывайте тембр голоса и актёрскую эмоцию раздельно: один и тот же герой может сначала удивиться, а затем выдохнуть с облегчением, но при этом он должен по-прежнему звучать как тот же самый человек.
После реплики Alex оставьте небольшую паузу на реакцию Maya, прежде чем она ответит. Если персонажи говорят по очереди, прямо укажите, что реплики не должны перекрывать друг друга; если же по сюжету один герой перебивает другого, поясните, кто кого перебивает и на какой фразе. Пока говорят оба персонажа, фоновая музыка должна оставаться совсем тихой и раскрываться только после завершения всего обмена репликами.
Ниже приведён пример авторского промпта для двух персонажей (аудио по нему ещё не генерировалось). Он развивает сцену на вокзале, добавляя ответ девушки, и рассчитан на использование с видеокадром, где есть соответствующая артикуляция и актёрская игра:
Create one complete eight-second sound scene at a quiet railway platform. Two adult characters speak in natural British English.
Alex: a warm, low male voice, a few feet offscreen, quietly surprised. Maya: a softer, brighter female voice, nearby, calm and quietly certain.
Begin with faint wind and sparse piano. Alex says only: "You waited." After he finishes, leave a brief pause for Maya's reaction. Maya then replies only: "I said I would." Keep each voice distinct and consistent. Speak only the quoted dialogue; do not read the character names or instructions. No overlapping dialogue or extra speakers. Keep the piano very quiet during both lines. Let it open gently only after Maya finishes, leaving room for the final reaction.
Сначала послушайте результат, не глядя на экран, и оцените, легко ли различить двух персонажей. Затем сверьте звук с видео: не перепутаны ли реплики местами, не появилась ли лишняя фраза, хватает ли паузы и совпадает ли звук с движением губ.
Если в длинном диалоге из нескольких реплик тембры начинают смешиваться или голоса меняются ролями, сократите задачу до одного короткого обмена «вопрос — ответ», а следующие фразы сгенерируйте отдельными фрагментами. В каждом фрагменте используйте одно и то же описание персонажей, а при склейке проверяйте, насколько однородно звучат голоса, фоновый шум и музыка — само по себе текстовое описание не гарантирует полного совпадения голоса между разными генерациями.
Part 05|Монтаж аудиодорожек
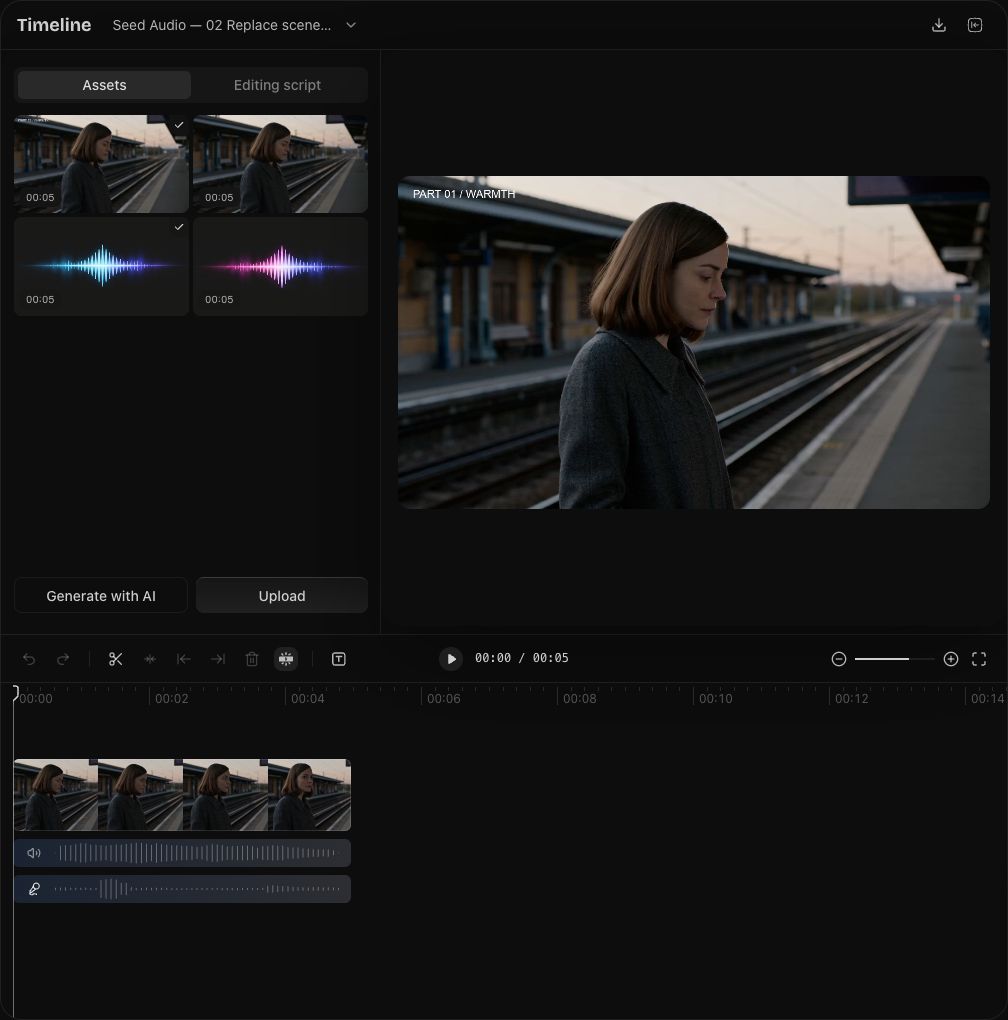
На скриншоте выше показан пример работы в Arcloop: на верхней дорожке остаётся пятисекундное видео с отключённым исходным звуком, а ниже размещается цельный аудиофрагмент, сгенерированный в Seed Audio, где реплика, интершум и музыка полностью заменяют оригинальную дорожку. Сдвиньте аудиоклип так, чтобы фраза и реакция героини точно совпали, а затем воспроизведите сцену целиком и проверьте склейку.
Если вы сгенерировали только фоновую музыку или атмосферный шум, достаточно просто добавить новую аудиодорожку. Оставьте нужные реплики и оригинальный звук видео, поместите новый аудиофайл на дорожку ниже и настройте его начало, конец и громкость. В местах, где говорят персонажи, можно расставить ключевые кадры громкости на фоновой дорожке: плавно увести звук вниз перед началом фразы, удерживать тихо во время речи и вернуть обратно после паузы в конце предложения.
Если же вы сгенерировали готовую сцену, где реплики уже сведены с фоновым звуком, замените оригинальное аудио на соответствующем участке. Отделите звуковую дорожку от видео, разрежьте её на границах нужного фрагмента и отключите или удалите старый звук, а затем выровняйте новую дорожку, чтобы одна и та же реплика не прозвучала дважды. В остальных частях ролика сохраните исходный звук.
После замены проверьте синхронизацию реплик с артикуляцией губ и реакциями персонажей, а также убедитесь, что на стыках фрагментов нет резких скачков; при необходимости добавьте короткие фейды, чтобы атмосферный шум переходил плавно. Учтите: когда голос и музыка уже сведены в один файл, уменьшение общей громкости сделает тише и саму речь. Если нужно изменить баланс между ними, сгенерируйте фрагмент заново или соберите сцену из отдельных дорожек.
Откройте страницу модели Seed Audio и начните с одного ключевого эпизода: определите, кто и что говорит, как должна звучать сцена и в какой момент фон уступает место голосу, а затем подставьте звук в видео и оцените результат.