配樂和配音是 AI 短片的點睛之筆。影片模型雖然已經可以音畫同出,但並非專門的聲音生成工具。如果希望讓影片的質感更進一步,則需要採用獨立的聲音生成模型。本文以 Seed Audio 為例,示範如何為影片生成專屬的聲音片段。
先聽一段 Seed Audio 模型頁的場景聲音案例:
這段聲音把人聲的空間迴響、鮮明的情緒演繹和背景音樂結合在一起。試聽時,可以留意尾音怎樣延續、語氣怎樣起伏,以及音樂怎樣配合表演。這些細節,也是為關鍵情節單獨設計聲音時值得打磨的部分。
先完成畫面,選出需要加強的情節,再生成聲音,放回鏡頭試聽,最後剪輯。
Part 01|Seed Audio 的使用場景
影片模型可以在生成畫面的同時生成聲音,但關鍵對白的情緒演繹、細微停頓,以及背景聲音與人物的配合,未必能達到這場戲需要的效果。畫面已經不錯,對話差點意思,或背景聲無法調整到自己需要的階段,這時就值得單獨加強聲音。
影片提示詞主要用來描述畫面、動作、運鏡和分鏡,能夠分配給聲音的篇幅有限。需要重點演繹的內容,可以在畫面確定後,交給 Seed Audio 這樣的聲音生成模型,集中描述台詞怎樣說、背景怎樣配合、節奏怎樣展開。
| 需要加強的內容 | 可以專門設計什麼 |
|---|---|
| 關鍵台詞與情緒 | 同一句話帶著歉意、試探還是驚訝;重音在哪裡,開口前後停多久 |
| 人聲與背景的配合 | 人物說話時音樂讓位,句末留白後再展開;腳步和風聲保持在背景 |
| 場景中特定的聲音 | 畫外腳步、敲門、機械運轉,或某一種樂器的獨奏、演奏方式與音色 |
| 情緒轉折 | 畫面相同,用溫暖、悲傷或危險的聲音改變觀眾對相遇的理解 |
先在影片製作階段確定台詞和對話關係,再為選定的片段補強聲音,這樣可以繼續使用已經滿意的畫面。已有合適的原聲就保留;替換對白時,要核對時長和嘴型,並避免新舊對白重疊。
這組三段音樂分別生成,再放到同一段五秒畫面下對照。下面是成片實際使用的三條提示詞:
WARMTH:溫暖的大調鋼琴與輕柔弦樂,讓等待得到回應。
Create a five-second instrumental film-music cue for a quiet reunion at an old European railway station. Begin immediately with gentle, sparse piano in a warm major harmony. Around the middle, a soft sustained string chord opens with a little hope, as a waiting woman notices someone arriving offscreen. End softly and reassuringly. Intimate and restrained, no big climax. Music only: no speech, narration, singing, voices, station ambience, sound effects or percussion. Do not read the instructions aloud.
SORROW:大提琴、下行小調旋律與未解決的結尾,讓相遇帶上遺憾。
Create a five-second instrumental film score that immediately conveys grief and a painful reunion. Start at once with an expressive solo cello playing a clearly descending minor-key melody, supported by dark sustained violas. Let the melody fall and linger as if someone realizes a loved relationship is lost. Strongly sorrowful and emotionally exposed, intimate rather than epic. No cheerful or comforting resolution. Keep the music clearly audible throughout, ending with an unresolved sustained note. Music only. No speech, singing, voices, piano, ambience or sound effects.
DANGER:重複低音、脈衝、不協和弦樂與末尾留白,讓畫外來者顯得危險。
Create a five-second instrumental psychological-thriller score with unmistakable immediate danger. From the very first moment, use a tight repeating low-string ostinato and a deep controlled bass pulse. Add close, tense dissonant high strings, building rapidly in density as someone threatening approaches offscreen. Make the tension clear and urgent rather than faint background atmosphere. During the final half-second abruptly cut the music to silence. No jump-scare impact. Music only. No speech, singing, voices, gentle piano, warm harmony, ambience or literal sound effects.
每段前有 0.75 秒標題卡,完整對照約 17.25 秒。試聽時,可以留意同一個抬眼動作怎樣被三種音樂分別解釋成安心、遺憾和警覺。
Part 02|Seed Audio 提示詞寫法
寫聲音提示詞,要交代三件事:說什麼、聽起來怎樣、什麼時候發生。
音訊生成介面文件提供了一個懸疑對話範例:手機震動開啟場景,鳥鳴持續在背景,馬林巴配合電子音色建立懸念;兩位男子交替說話,最後以車輛和腳步聲推進動作。它把人物、音樂和聲音事件寫在同一段提示詞裡。
| 提示詞要素 | 文件範例怎樣處理 | 寫自己的片段時填什麼 |
|---|---|---|
| 內容:誰說什麼 | 分別指定兩位男子的台詞與說話順序 | 角色名、逐字台詞、語言,以及是否有人回應 |
| 聲音:怎樣被聽見 | 區分低沉厚實與沙啞成熟的男聲,指定口音;明確主奏樂器與伴奏 | 音色、語氣、人物距離、環境與樂器,避免只寫「電影感」 |
| 節奏:怎樣展開 | 先有提示性音效,再展開對話;追問與解釋帶動語氣變化,末尾接動作聲音 | 開口時機、語速、句間停頓、背景的進入與退出 |
以車站重逢為例,可以先確定:一句準確的台詞 + 一種具體的表演 + 一次清楚的聲音轉折。 畫外男子只說「You waited.」,用低聲、克制的親近感和句末展開的鋼琴表現相遇。
車站案例的聲音順序是:輕風與鋼琴 → 兩下輕腳步 → 男聲說話,音樂保持很輕 → 短暫停頓 → 鋼琴展開。
台詞用引號標出,註明女孩不回答;腳步要輕於人聲,廣播和列車聲不進入。先把這些關係寫清楚,再按鏡頭時長補充大致時間;時間要求要對照生成結果核對,尤其是音樂和音效的具體落點。
如果片段需要馬林巴獨奏,就寫清樂器、敲擊質感、演奏速度、音符密度與收尾方式。下面是可嘗試的原創提示詞,尚未生成試聽:
Create an eight-second solo marimba cue for a quiet, suspenseful scene. Use soft mallets and a warm wooden tone. Begin with sparse, slow notes and clear gaps between them. Gradually make the repeating pattern slightly more insistent, then stop before the final beat and leave a short silence. No voices, drums, synthesizers or other instruments.
這裡的節奏是「稀疏 → 稍微逼近 → 突然留白」,樂器、演奏方式和聲音進退都可以逐項核對;質感與節奏是否成立,仍要靠試聽判斷。
Part 03|對白中的 Ducking
Ducking 就是在人物說話時降低背景音樂,台詞結束後再恢復。 對安靜的重逢戲,除了降低音量,也可以讓伴奏更稀疏,把聽覺重點留給人物。
用 Seed Audio 同時生成人聲與背景時,把這個關係寫入提示詞:
男子低聲說出「You waited.」時,鋼琴保持很輕,風聲退在遠處,腳步已經停下。台詞後留一個短暫停頓,再讓鋼琴輕輕展開,承接女孩的反應。
不要只寫「自動 ducking」。明確誰需要被聽清、什麼聲音讓位、什麼時候恢復,再檢查模型是否做到了。本例中這些關係都由同一次生成一併處理。
如果影片已經有對白,也可以截取原始聲音作為參考,寫清希望保留的音色、台詞與節奏,以及需要調整的語氣或背景關係。生成後對照畫面試聽,再替換對應片段的原音軌;具體剪輯方式見 Part 05。
畫面沿用 Seedance 2 Fast 生成的五秒車站鏡頭:女孩低頭等待,隨後抬眼看向畫外。男聲只說一句話,輕腳步提示來者靠近,台詞後的鋼琴接住女孩的沉默反應。
這段聲音實際使用了下面的提示詞。生成時要求八秒,為台詞前後的腳步、停頓與音樂展開留出空間:
Create one complete eight-second cinematic sound scene at a quiet old European railway platform at dusk. Generate dialogue, subtle footsteps, outdoor ambience and piano music together as one coherent scene. At the beginning, a very gentle distant breeze and sparse soft warm piano establish quiet anticipation. Between about 1.0 and 2.1 seconds, exactly two very soft, unhurried shoe footsteps approach offscreen on dry concrete and stop a few feet away. The footsteps are a delicate background detail, much quieter than the speaking voice, never sharp, heavy or dramatic. Around 2.5 seconds, one adult man just offscreen speaks a single short line in natural, clear British English, with quiet surprise and restrained affection: "You waited." Only those two words, only one male speaker. Keep the music very soft around his words so his intimate delivery remains clear. After the line, leave a brief emotional pause with faint breeze. From about 4.8 seconds, let the piano gently open into a warm sustained chord, supporting the woman's silent reaction, then settle quietly at eight seconds. No additional dialogue, no reply, no narration, no singing, no announcements, no loud trains, no impact sounds. Do not speak these directions. Preserve the quiet intimacy of the reunion throughout.
原始音訊為八秒,成片截取其中連續的第 1.8–6.8 秒,放入五秒畫面;後製只統一調整整段音量並加首尾短淡化,沒有另行疊加人聲、腳步或配樂,也沒有分軌做 ducking。
試聽時檢查三件事:台詞能否聽清,腳步是否足夠輕,音樂是否在說完後才展開。 如果某項沒有做到,就針對這一項修改提示詞,繼續使用已確認的畫面。
Part 04|多角色對話
多角色提示詞要把角色、音色、台詞歸屬和接話順序對應起來。先用一小輪對話確認兩個人的聲音,再增加台詞。
| 角色 | 聲音與表演 | 本輪台詞 |
|---|---|---|
| Alex,畫外男子 | 偏低、溫暖的成年男聲,自然英式英語,帶一點驚訝 | “You waited.” |
| Maya,畫內女孩 | 較明亮、柔和的成年女聲,自然英式英語,平靜而堅定 | “I said I would.” |
角色名在整段提示詞裡保持一致,逐句註明誰說話。音色與表演分開寫:同一個人可以先驚訝、再放鬆,仍應聽起來像同一個角色。
Alex 說完後,給 Maya 留一點反應時間,再讓 Maya 回答。若希望兩人輪流說話,就明確不重疊;若劇情需要打斷,要說明誰打斷誰、從哪一句開始。兩人說話期間,背景音樂都保持很輕,在整輪對話結束後再展開。
下面是一個原創的雙人提示詞範例,尚未生成試聽。它在車站案例的基礎上增加了女孩的回答,需要搭配有相應表演的畫面使用:
Create one complete eight-second sound scene at a quiet railway platform. Two adult characters speak in natural British English.
Alex: a warm, low male voice, a few feet offscreen, quietly surprised. Maya: a softer, brighter female voice, nearby, calm and quietly certain.
Begin with faint wind and sparse piano. Alex says only: "You waited." After he finishes, leave a brief pause for Maya's reaction. Maya then replies only: "I said I would." Keep each voice distinct and consistent. Speak only the quoted dialogue; do not read the character names or instructions. No overlapping dialogue or extra speakers. Keep the piano very quiet during both lines. Let it open gently only after Maya finishes, leaving room for the final reaction.
先不看畫面,聽能否分辨兩個角色,再對照鏡頭檢查台詞有沒有說反、是否多出一句話、停頓是否夠用,以及嘴型是否相容。
如果連續幾輪對話出現音色混淆或說話人錯位,可以先縮短成一輪問答生成,再分段處理後續對話。各段複用同一組角色描述,並檢查拼接後的音色、環境聲和音樂是否連續;文字描述本身不能保證跨段聲音完全一致。
Part 05|音軌剪輯
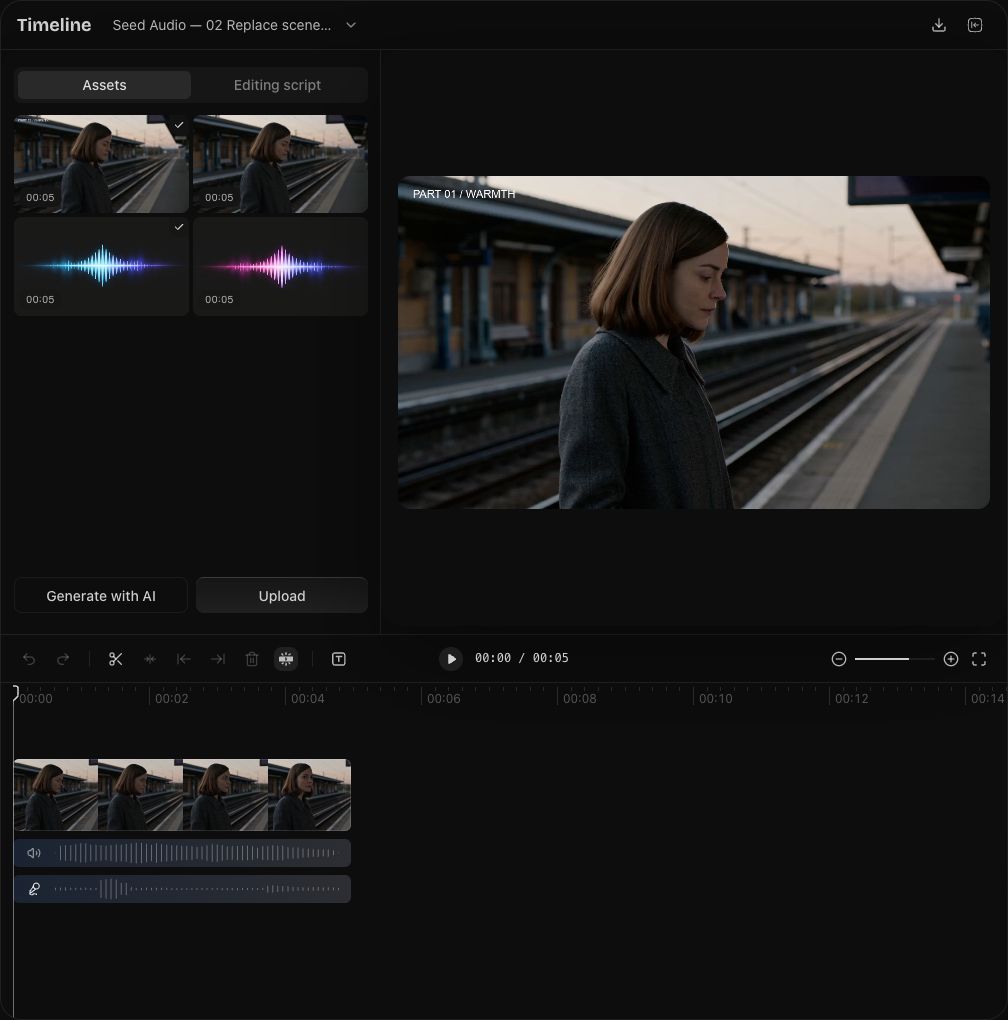
上圖以 Arcloop 為例:保留上方的五秒畫面,將原音軌靜音,再在下方加入 Seed Audio 生成的完整聲音片段,讓對白、環境聲和配樂一起接替原聲。拖動音訊位置,使台詞和人物反應對齊,再完整播放檢查銜接。
如果生成的是純背景音樂或環境聲,新增一條音軌即可。 保留影片中需要的對白和原聲,把新音訊放在下方,調整起止位置和音量。人物說話時,可以在背景軌上加音量關鍵影格:開口前降低,說話期間保持,句末停頓後回升。
如果生成的是背景聲與人物台詞的完整片段,就替換對應位置的原聲。 將影片與原聲音軌分離,在需要替換的範圍內切開並靜音或移除舊音訊,再對齊新音訊,避免同一句台詞播放兩次。其餘片段的原聲繼續保留。
替換後檢查台詞與嘴型、反應是否對得上,片段首尾是否突變;必要時加短淡化,讓環境聲銜接自然。人聲和音樂已經混在同一個檔案裡時,整體降音量會同時降低人聲;需要調整兩者關係,可以重新生成,或使用獨立音軌混音。
打開 Seed Audio 模型頁,從一個關鍵片段開始:確定誰說什麼、聲音怎樣、何時讓位,再放回影片試聽。