A trilha sonora e a dublagem dão o toque final a um curta-metragem de IA. Os modelos de vídeo já conseguem gerar imagem e som juntos, mas não são ferramentas especializadas em geração de áudio. Se você quiser elevar ainda mais a qualidade do seu filme, vale recorrer a um modelo dedicado de geração de som. Este artigo usa o Seed Audio como exemplo para mostrar como criar trechos de áudio sob medida para o seu projeto.
Primeiro, ouça um exemplo de cena sonora da página do modelo Seed Audio:
Esse áudio combina a reverberação espacial da voz, uma atuação emocional marcante e música de fundo. Ao ouvir, repare em como o final das palavras se prolonga, como a entonação oscila e como a música acompanha a interpretação. Esses detalhes também são pontos que vale a pena lapidar ao desenhar o som separadamente para momentos decisivos da trama.
Conclua primeiro o visual, escolha os momentos que precisam de reforço, gere o áudio, insira-o de volta no plano para testar e finalize a edição.
Part 01|Quando usar o Seed Audio
Modelos de vídeo podem gerar som junto com a imagem, mas a entrega emocional de falas importantes, as pausas sutis e o equilíbrio entre o som de fundo e os personagens nem sempre alcançam o resultado que a cena pede. Quando o visual já está bom, mas o diálogo deixa a desejar ou o som ambiente não chega ao ponto esperado, vale a pena trabalhar o áudio separadamente.
Os prompts de vídeo servem principalmente para descrever imagem, ação, movimento de câmera e decupagem, deixando pouco espaço para o som. Nos trechos que exigem uma interpretação mais cuidadosa, você pode definir primeiro o vídeo e depois recorrer a um modelo de geração de som como o Seed Audio para descrever com foco como a fala deve ser dita, como o fundo acompanha a cena e como o ritmo se desenvolve.
| O que precisa de reforço | O que pode ser desenhado sob medida |
|---|---|
| Falas decisivas e emoção | Se a mesma frase soa com pedido de desculpas, hesitação ou surpresa; onde cai a ênfase e quanto tempo dura a pausa antes e depois de falar |
| Equilíbrio entre voz e fundo | A música abre espaço quando o personagem fala e volta a crescer após uma pausa no fim da frase; passos e vento permanecem ao fundo |
| Sons específicos da cena | Passos fora de quadro, batidas na porta, máquinas funcionando, ou o solo, a técnica de execução e o timbre de um instrumento específico |
| Viradas emocionais | Com a mesma imagem, usar um som acolhedor, triste ou ameaçador para mudar a forma como o público interpreta o encontro |
Defina as falas e a dinâmica do diálogo ainda na etapa de criação do vídeo e, depois, reforce o som apenas nos trechos selecionados; assim você aproveita os planos que já ficaram bons. Se o áudio original já funcionar, mantenha-o. Ao substituir diálogos, confira a duração e a sincronia labial, evitando que a fala nova se sobreponha à antiga.
Essas três faixas musicais foram geradas separadamente e colocadas sob o mesmo plano de cinco segundos para comparação. Abaixo estão os três prompts realmente usados no vídeo final:
WARMTH: piano acolhedor em tom maior e cordas suaves fazem a espera encontrar resposta.
Create a five-second instrumental film-music cue for a quiet reunion at an old European railway station. Begin immediately with gentle, sparse piano in a warm major harmony. Around the middle, a soft sustained string chord opens with a little hope, as a waiting woman notices someone arriving offscreen. End softly and reassuringly. Intimate and restrained, no big climax. Music only: no speech, narration, singing, voices, station ambience, sound effects or percussion. Do not read the instructions aloud.
SORROW: violoncelo, melodia descendente em tom menor e final sem resolução dão um tom de pesar ao reencontro.
Create a five-second instrumental film score that immediately conveys grief and a painful reunion. Start at once with an expressive solo cello playing a clearly descending minor-key melody, supported by dark sustained violas. Let the melody fall and linger as if someone realizes a loved relationship is lost. Strongly sorrowful and emotionally exposed, intimate rather than epic. No cheerful or comforting resolution. Keep the music clearly audible throughout, ending with an unresolved sustained note. Music only. No speech, singing, voices, piano, ambience or sound effects.
DANGER: graves repetitivos, pulso constante, cordas dissonantes e silêncio no final fazem quem se aproxima fora de quadro parecer perigoso.
Create a five-second instrumental psychological-thriller score with unmistakable immediate danger. From the very first moment, use a tight repeating low-string ostinato and a deep controlled bass pulse. Add close, tense dissonant high strings, building rapidly in density as someone threatening approaches offscreen. Make the tension clear and urgent rather than faint background atmosphere. During the final half-second abruptly cut the music to silence. No jump-scare impact. Music only. No speech, singing, voices, gentle piano, warm harmony, ambience or literal sound effects.
Cada trecho é precedido por uma cartela de título de 0,75 segundo, totalizando cerca de 17,25 segundos na comparação completa. Ao assistir, repare em como o mesmo gesto de erguer os olhos passa a transmitir alívio, pesar ou alerta conforme cada uma das três músicas.
Part 02|Como escrever prompts para o Seed Audio
Ao escrever um prompt de áudio, deixe claros três pontos: o que é dito, como deve soar e quando acontece.
A documentação da API de geração de áudio traz um exemplo de diálogo de suspense: a vibração de um celular abre a cena, o canto de pássaros permanece ao fundo e uma marimba combinada a timbres eletrônicos cria tensão; dois homens falam alternadamente e, no final, sons de veículos e passos impulsionam a ação. O exemplo reúne personagens, música e eventos sonoros dentro do mesmo prompt.
| Elemento do prompt | Como o exemplo da documentação resolve | O que preencher ao criar seu próprio trecho |
|---|---|---|
| Conteúdo: quem diz o quê | Especifica separadamente as falas dos dois homens e a ordem em que falam | Nome do personagem, fala exata palavra por palavra, idioma e se alguém responde |
| Som: como é ouvido | Diferencia uma voz masculina grave e encorpada de outra rouca e madura, define o sotaque e indica o instrumento principal e o acompanhamento | Timbre, tom emocional, distância do personagem, ambiente e instrumentos, evitando escrever apenas “cinematográfico” |
| Ritmo: como se desenvolve | Começa com um efeito sonoro de alerta antes de abrir o diálogo; perguntas e explicações mudam a entonação, encerrando com sons de ação | Momento de entrada da voz, velocidade da fala, pausas entre frases e entrada ou saída do som de fundo |
Tomando o reencontro na estação como exemplo, podemos definir primeiro: uma fala exata + uma interpretação específica + uma virada sonora clara. O homem fora de quadro diz apenas “You waited.”, expressando o reencontro com voz baixa, intimidade contida e um piano que se abre após a fala.
A ordem dos sons no exemplo da estação é: brisa leve e piano → dois passos suaves → voz masculina falando enquanto a música permanece bem baixa → pausa breve → o piano se abre.
Coloque a fala entre aspas e indique que a jovem não responde; os passos devem soar mais baixos que a voz, sem anúncios de alto-falante nem barulho de trem. Descreva primeiro essas relações com clareza e depois acrescente tempos aproximados conforme a duração do plano; confira essas marcações ouvindo o resultado gerado, principalmente nos pontos exatos em que entram a música e os efeitos.
Se o trecho pedir um solo de marimba, especifique o instrumento, a textura do toque, o andamento, a densidade das notas e a forma de encerramento. Abaixo está um prompt original para experimentar, que ainda não foi gerado para audição:
Create an eight-second solo marimba cue for a quiet, suspenseful scene. Use soft mallets and a warm wooden tone. Begin with sparse, slow notes and clear gaps between them. Gradually make the repeating pattern slightly more insistent, then stop before the final beat and leave a short silence. No voices, drums, synthesizers or other instruments.
Aqui o ritmo segue a progressão “esparso → um pouco mais insistente → pausa súbita”. O instrumento, a forma de tocar e a entrada ou saída do som podem ser conferidos item por item, mas só a audição dirá se a textura e o ritmo realmente funcionam.
Part 03|Ducking em diálogos
Ducking consiste em baixar a música de fundo quando o personagem fala e retomá-la quando a fala termina. Em uma cena silenciosa de reencontro, além de reduzir o volume, você também pode deixar o acompanhamento mais rarefeito para manter o foco auditivo nas pessoas.
Ao gerar voz e fundo juntos com o Seed Audio, inclua essa relação diretamente no prompt:
Quando o homem diz em voz baixa “You waited.”, o piano permanece bem suave, o vento recua ao longe e os passos já pararam. Depois da fala, deixe uma breve pausa antes de o piano se abrir delicadamente, sustentando a reação da jovem.
Não escreva apenas “ducking automático”. Deixe explícito quem precisa ser ouvido com clareza, que som deve recuar e quando ele volta, conferindo depois se o modelo cumpriu a instrução. Neste exemplo, todas essas relações foram resolvidas de uma só vez na mesma geração.
Se o vídeo já tiver diálogo, você também pode recortar o áudio original como referência e especificar o timbre, as falas e o ritmo que deseja preservar, além da entonação ou da relação com o fundo que precisam de ajuste. Depois de gerar, ouça junto com a imagem e substitua a trilha original do trecho correspondente; veja o passo a passo de edição na Part 05.
O vídeo mantém o plano de cinco segundos da estação gerado com o Seedance 2 Fast: a jovem espera de cabeça baixa e depois ergue os olhos para fora de quadro. A voz masculina diz apenas uma frase, os passos leves indicam que alguém se aproxima e o piano após a fala acolhe a reação silenciosa da jovem.
Esse áudio foi gerado com o prompt abaixo. Foram pedidos oito segundos na geração para deixar espaço para os passos antes da fala, a pausa e a abertura da música depois:
Create one complete eight-second cinematic sound scene at a quiet old European railway platform at dusk. Generate dialogue, subtle footsteps, outdoor ambience and piano music together as one coherent scene. At the beginning, a very gentle distant breeze and sparse soft warm piano establish quiet anticipation. Between about 1.0 and 2.1 seconds, exactly two very soft, unhurried shoe footsteps approach offscreen on dry concrete and stop a few feet away. The footsteps are a delicate background detail, much quieter than the speaking voice, never sharp, heavy or dramatic. Around 2.5 seconds, one adult man just offscreen speaks a single short line in natural, clear British English, with quiet surprise and restrained affection: "You waited." Only those two words, only one male speaker. Keep the music very soft around his words so his intimate delivery remains clear. After the line, leave a brief emotional pause with faint breeze. From about 4.8 seconds, let the piano gently open into a warm sustained chord, supporting the woman's silent reaction, then settle quietly at eight seconds. No additional dialogue, no reply, no narration, no singing, no announcements, no loud trains, no impact sounds. Do not speak these directions. Preserve the quiet intimacy of the reunion throughout.
O áudio original tem oito segundos; a versão final recorta o trecho contínuo entre 1,8 e 6,8 segundos para encaixá-lo no plano de cinco segundos. Na pós-produção, apenas ajustamos o volume geral do trecho e aplicamos um fade curto no início e no fim, sem sobrepor voz, passos ou trilha separadamente e sem fazer ducking em faixas isoladas.
Ao ouvir o resultado, verifique três pontos: se a fala está nítida, se os passos estão suaves o bastante e se a música só cresce depois que a frase termina. Se algum item falhar, ajuste o prompt especificamente nesse ponto e continue usando a imagem já aprovada.
Part 04|Diálogo entre múltiplos personagens
Em prompts com múltiplos personagens, é preciso associar claramente cada personagem ao seu timbre, às suas falas e à ordem das respostas. Comece com uma troca curta para validar as duas vozes antes de acrescentar mais texto.
| Personagem | Voz e interpretação | Fala nesta troca |
|---|---|---|
| Alex, homem fora de quadro | Voz masculina adulta grave e acolhedora, inglês britânico natural, com leve surpresa | “You waited.” |
| Maya, jovem em quadro | Voz feminina adulta mais clara e suave, inglês britânico natural, calma e firme | “I said I would.” |
Mantenha os nomes dos personagens consistentes durante todo o prompt e indique quem diz cada frase. Separe a descrição do timbre da indicação de interpretação: a mesma pessoa pode soar primeiro surpresa e depois aliviada, mas ainda deve parecer o mesmo personagem.
Depois que Alex terminar de falar, deixe um pequeno tempo de reação para Maya antes da resposta dela. Se quiser que os dois falem um de cada vez, especifique que não há sobreposição; se a cena exigir uma interrupção, explique quem interrompe quem e a partir de qual frase. Enquanto os dois falam, mantenha a música de fundo bem baixa, deixando-a se abrir apenas quando toda a troca terminar.
Abaixo está um exemplo original de prompt para duas vozes, que ainda não foi gerado para audição. Ele acrescenta a resposta da jovem ao caso da estação e precisa ser usado com um plano que contenha a atuação correspondente:
Create one complete eight-second sound scene at a quiet railway platform. Two adult characters speak in natural British English.
Alex: a warm, low male voice, a few feet offscreen, quietly surprised. Maya: a softer, brighter female voice, nearby, calm and quietly certain.
Begin with faint wind and sparse piano. Alex says only: "You waited." After he finishes, leave a brief pause for Maya's reaction. Maya then replies only: "I said I would." Keep each voice distinct and consistent. Speak only the quoted dialogue; do not read the character names or instructions. No overlapping dialogue or extra speakers. Keep the piano very quiet during both lines. Let it open gently only after Maya finishes, leaving room for the final reaction.
Primeiro, ouça sem olhar para o vídeo para ver se é possível distinguir os dois personagens; depois, confira com a imagem se as falas não foram trocadas, se não surgiu nenhuma frase extra, se as pausas são suficientes e se o movimento labial é compatível.
Se várias rodadas seguidas de diálogo apresentarem confusão de timbres ou troca de interlocutores, reduza primeiro para uma única pergunta e resposta e gere o restante do diálogo em partes separadas. Reutilize a mesma descrição de personagens em cada trecho e verifique se o timbre, o som ambiente e a música mantêm continuidade após a colagem; a descrição em texto, por si só, não garante que a voz fique idêntica entre gerações diferentes.
Part 05|Edição de trilhas de áudio
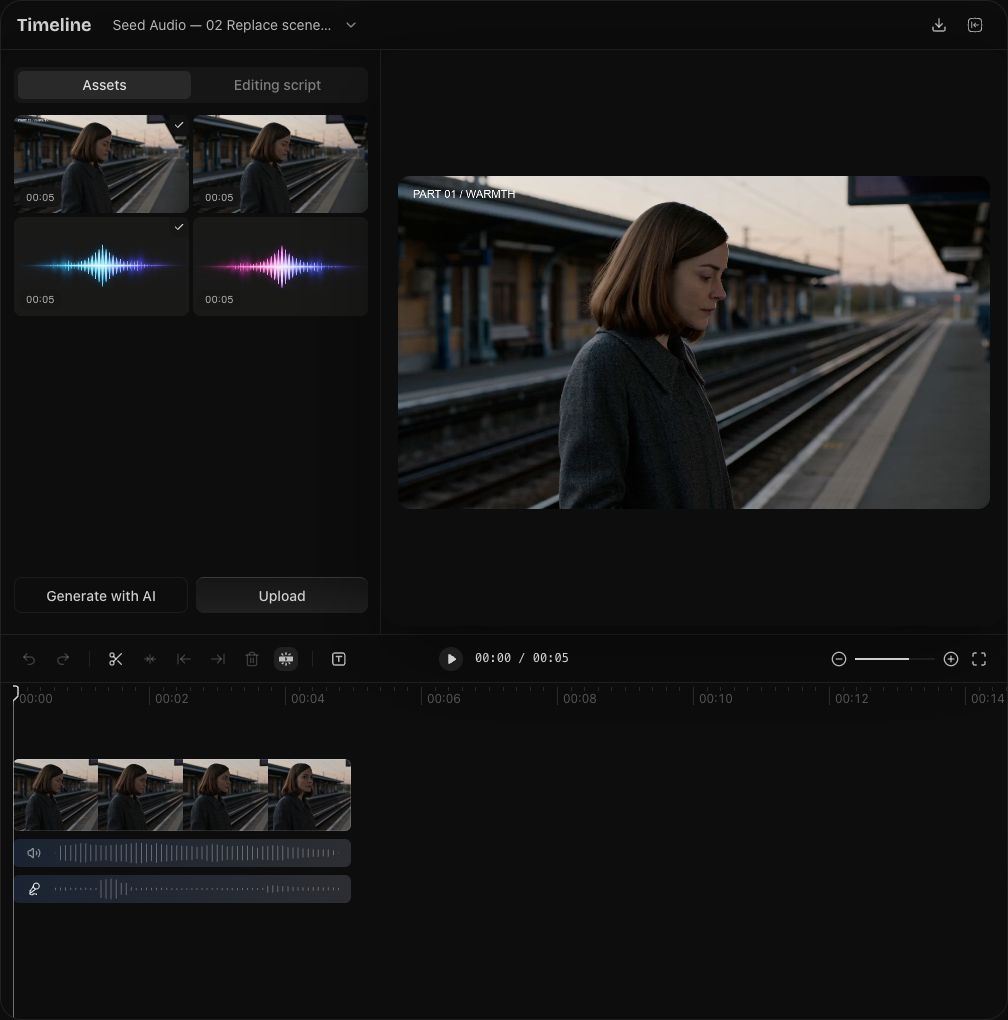
A imagem acima usa o Arcloop como exemplo: mantemos o vídeo de cinco segundos na trilha superior, silenciamos o áudio original e adicionamos abaixo o trecho sonoro completo gerado pelo Seed Audio, fazendo com que diálogo, som ambiente e trilha assumam juntos o lugar do som original. Arraste a posição do áudio para alinhar a fala à reação da personagem e reproduza o trecho inteiro para conferir a transição.
Se você tiver gerado apenas música de fundo ou som ambiente, basta adicionar uma nova faixa de áudio. Mantenha os diálogos e sons originais necessários do vídeo, coloque o novo áudio na faixa de baixo e ajuste os pontos de entrada, saída e volume. Quando um personagem falar, você pode criar keyframes de volume na faixa de fundo: reduza antes de a fala começar, mantenha baixo enquanto ela dura e volte a subir após a pausa final.
Se você tiver gerado um trecho completo contendo tanto o som de fundo quanto a fala do personagem, substitua o áudio original daquele ponto. Separe o vídeo da trilha de áudio original, corte e silencie ou remova o áudio antigo no intervalo que será substituído e alinhe o novo áudio para evitar que a mesma frase toque duas vezes. Nos demais trechos, preserve o som original.
Após a substituição, verifique se a fala bate com o movimento labial e com a reação em cena, e se não há cortes bruscos no início ou no fim do clipe; quando necessário, aplique fades curtos para que o som ambiente se conecte com naturalidade. Quando voz e música já estão mixadas no mesmo arquivo, baixar o volume geral reduzirá também a voz; se precisar ajustar a proporção entre os dois, gere uma nova versão ou faça a mixagem com faixas separadas.
Abra a página do modelo Seed Audio e comece por uma cena decisiva: defina quem diz o quê, como o som deve soar e quando o fundo abre espaço, levando o resultado de volta ao vídeo para testar.