La musique et le doublage apportent la touche finale à un court-métrage IA. Si les modèles vidéo peuvent déjà générer l'image et le son simultanément, ce ne sont pas des outils dédiés à la création sonore. Pour rehausser la qualité de votre film, il est préférable de faire appel à un modèle de génération audio indépendant. Cet article prend l'exemple de Seed Audio pour vous montrer comment générer des extraits sonores sur mesure pour vos films.
Écoutons d'abord un exemple de scène sonore issu de la page du modèle Seed Audio :
Cet extrait combine la réverbération spatiale des voix, une interprétation émotionnelle marquée et une musique de fond. À l'écoute, prêtez attention à la façon dont les fins de phrases se prolongent, aux inflexions du ton et à la manière dont la musique accompagne le jeu d'acteur. Ce sont précisément ces détails qui méritent d'être travaillés lorsque vous concevez le son de vos scènes clés séparément.
Commencez par finaliser l'image, sélectionnez les moments qui ont besoin d'être renforcés, générez le son, réintégrez-le sous le plan pour faire un essai d'écoute, puis passez au montage final.
Part 01|Quand utiliser Seed Audio
Les modèles vidéo peuvent générer du son en même temps que l'image, mais l'interprétation émotionnelle d'une réplique clé, la subtilité d'une pause ou l'équilibre entre l'ambiance sonore et les personnages ne sont pas toujours à la hauteur de ce qu'exige la scène. Lorsque le rendu visuel est déjà satisfaisant mais que le dialogue manque de justesse ou que le fond sonore ne correspond pas à vos attentes, il devient pertinent de retravailler l'audio à part.
Les prompts vidéo servent avant tout à décrire le cadre, l'action, les mouvements de caméra et le découpage ; l'espace disponible pour détailler le son y est limité. Pour les passages qui demandent une interprétation soignée, mieux vaut attendre que l'image soit validée, puis confier le travail à un modèle de génération sonore comme Seed Audio afin de décrire précisément comment les répliques doivent être dites, comment le fond sonore s'articule et à quel rythme la scène se déploie.
| Élément à renforcer | Ce que vous pouvez concevoir sur mesure |
|---|---|
| Répliques clés et émotions | Dire la même phrase avec un ton d'excuse, d'hésitation ou de surprise ; placer l'accent tonique et définir la durée des silences avant et après la prise de parole |
| Équilibre entre voix et fond sonore | Faire passer la musique au second plan pendant les dialogues, laisser un silence en fin de phrase avant qu'elle ne reprenne ; maintenir les bruits de pas et le vent en arrière-plan |
| Sons spécifiques à la scène | Bruits de pas hors champ, coups frappés à une porte, mécanisme en marche, ou encore le solo, le mode de jeu et le timbre d'un instrument particulier |
| Bascule émotionnelle | Sur une même image, utiliser une ambiance chaleureuse, mélancolique ou menaçante pour transformer la perception d'une rencontre par le spectateur |
Définissez d'abord les répliques et la dynamique des dialogues lors de la création vidéo, puis renforcez le son des séquences choisies afin de conserver les images qui vous conviennent déjà. Si la piste audio d'origine est réussie, gardez-la ; si vous remplacez un dialogue, vérifiez bien la durée et la synchronisation labiale, et veillez à ce que l'ancienne et la nouvelle réplique ne se superposent pas.
Ces trois extraits musicaux ont été générés séparément, puis placés sous le même plan de cinq secondes à titre de comparaison. Voici les trois prompts réellement utilisés pour la vidéo finale :
WARMTH : un piano chaleureux en mode majeur et des cordes douces, où l'attente trouve enfin une réponse.
Create a five-second instrumental film-music cue for a quiet reunion at an old European railway station. Begin immediately with gentle, sparse piano in a warm major harmony. Around the middle, a soft sustained string chord opens with a little hope, as a waiting woman notices someone arriving offscreen. End softly and reassuringly. Intimate and restrained, no big climax. Music only: no speech, narration, singing, voices, station ambience, sound effects or percussion. Do not read the instructions aloud.
SORROW : un violoncelle, une mélodie descendante en mode mineur et une fin non résolue, qui teintent la rencontre de regret.
Create a five-second instrumental film score that immediately conveys grief and a painful reunion. Start at once with an expressive solo cello playing a clearly descending minor-key melody, supported by dark sustained violas. Let the melody fall and linger as if someone realizes a loved relationship is lost. Strongly sorrowful and emotionally exposed, intimate rather than epic. No cheerful or comforting resolution. Keep the music clearly audible throughout, ending with an unresolved sustained note. Music only. No speech, singing, voices, piano, ambience or sound effects.
DANGER : des basses répétitives, une pulsation sourde, des cordes dissonantes et un silence final, qui rendent l'arrivée hors champ menaçante.
Create a five-second instrumental psychological-thriller score with unmistakable immediate danger. From the very first moment, use a tight repeating low-string ostinato and a deep controlled bass pulse. Add close, tense dissonant high strings, building rapidly in density as someone threatening approaches offscreen. Make the tension clear and urgent rather than faint background atmosphere. During the final half-second abruptly cut the music to silence. No jump-scare impact. Music only. No speech, singing, voices, gentle piano, warm harmony, ambience or literal sound effects.
Chaque extrait est précédé d'un carton de titre de 0,75 seconde, pour une vidéo comparative complète d'environ 17,25 secondes. À l'écoute, observez comment un même regard qui se lève est tour à tour interprété comme un signe de soulagement, de regret ou de méfiance selon la musique.
Part 02|Rédiger des prompts pour Seed Audio
Pour rédiger un prompt audio, il faut préciser trois éléments : ce qui est dit, comment cela sonne et à quel moment cela se produit.
La documentation de l'API de génération audio propose un exemple de dialogue à suspense : une vibration de téléphone ouvre la scène, des chants d'oiseaux persistent en fond sonore, et un marimba associé à des textures électroniques installe la tension ; deux hommes se répondent, avant que des bruits de véhicule et de pas ne relancent l'action à la fin. Cet exemple réunit les personnages, la musique et les événements sonores au sein d'un seul et même prompt.
| Élément du prompt | Comment l'exemple de la documentation le traite | Quoi indiquer pour votre propre extrait |
|---|---|---|
| Contenu : qui dit quoi | Précise les répliques respectives des deux hommes et l'ordre de prise de parole | Nom du personnage, texte exact de la réplique, langue, et indication de la présence ou non d'une réponse |
| Son : comment c'est perçu | Distingue une voix masculine grave et pleine d'une voix rauque et mûre, précise l'accent ; définit l'instrument principal et l'accompagnement | Timbre, ton, distance du personnage, environnement et instruments, en évitant de se limiter à un terme vague comme « cinématographique » |
| Rythme : comment la scène évolue | Commence par un effet sonore d'appel, puis lance le dialogue ; les questions et explications font évoluer le ton, et des bruits d'action concluent l'extrait | Moment de la prise de parole, débit, pauses entre les phrases, entrée et sortie des éléments d'arrière-plan |
En reprenant l'exemple des retrouvailles à la gare, on peut d'abord fixer une structure simple : une réplique exacte + une intention de jeu précise + une transition sonore claire. L'homme hors champ prononce uniquement « You waited. », traduisant l'émotion de la rencontre par une voix basse, une proximité retenue et un piano qui se déploie après la réplique.
Le déroulé sonore de cette scène de gare est le suivant : brise légère et piano → deux pas feutrés → la voix masculine parle tandis que la musique reste très discrète → courte pause → le piano prend de l'ampleur.
Mettez la réplique entre guillemets et précisez que la jeune femme ne répond pas ; les bruits de pas doivent être plus doux que la voix, sans annonces de gare ni bruits de train. Définissez d'abord clairement ces rapports hiérarchiques, puis ajoutez des repères temporels approximatifs en fonction de la durée du plan ; ces indications de temps devront être vérifiées à l'écoute du résultat généré, en particulier pour les points d'entrée précis de la musique et des effets sonores.
Si votre séquence nécessite un solo de marimba, décrivez clairement l'instrument, la texture de l'attaque, le tempo, la densité des notes et la manière dont le morceau s'achève. Voici un exemple de prompt original que vous pouvez tester (non généré pour écoute dans cet article) :
Create an eight-second solo marimba cue for a quiet, suspenseful scene. Use soft mallets and a warm wooden tone. Begin with sparse, slow notes and clear gaps between them. Gradually make the repeating pattern slightly more insistent, then stop before the final beat and leave a short silence. No voices, drums, synthesizers or other instruments.
Ici, la progression rythmique suit le schéma « épars → légèrement plus insistant → silence soudain ». Le choix de l'instrument, le mode de jeu et l'évolution du son peuvent être vérifiés point par point, mais seule l'écoute permettra de juger si la texture et le rythme fonctionnent réellement.
Part 03|Gérer le ducking pendant les dialogues
Le ducking consiste à baisser le volume de la musique de fond lorsqu'un personnage parle, puis à le rétablir une fois la réplique terminée. Pour une scène de retrouvailles intimiste, outre la baisse du volume, on peut aussi raréfier l'accompagnement musical afin de laisser toute l'attention auditive aux personnages.
Lorsque vous générez simultanément la voix et le fond sonore avec Seed Audio, intégrez directement cette dynamique dans votre prompt :
Lorsque l'homme murmure « You waited. », le piano reste très discret, le souffle du vent recule au loin et les bruits de pas se sont déjà arrêtés. Laissez une courte pause après la réplique, puis laissez le piano s'ouvrir doucement pour accompagner la réaction de la jeune femme.
Ne vous contentez pas d'écrire « ducking automatique ». Précisez explicitement qui doit être entendu clairement, quels sons doivent s'effacer et à quel moment ils reprennent leur place, puis vérifiez à l'écoute si le modèle a bien respecté la consigne. Dans notre exemple, tous ces équilibres sont gérés en une seule génération.
Si votre vidéo comporte déjà un dialogue, vous pouvez également extraire l'audio d'origine pour vous en servir de référence, en décrivant clairement le timbre, le texte et le rythme que vous souhaitez conserver, ainsi que les ajustements à apporter au ton ou à l'équilibre avec l'arrière-plan. Après la génération, écoutez le résultat sur l'image, puis remplacez la piste audio originale du passage concerné ; la méthode de montage détaillée est expliquée dans la Part 05.
L'image reprend le plan de gare de cinq secondes généré avec Seedance 2 Fast : la jeune femme attend tête baissée, puis lève les yeux vers le hors-champ. La voix masculine ne prononce qu'une courte phrase, de légers bruits de pas signalent l'approche de l'interlocuteur, et le piano qui suit la réplique vient soutenir la réaction silencieuse de la jeune femme.
Cet extrait sonore a été obtenu avec le prompt ci-dessous. Une durée de huit secondes a été demandée lors de la génération afin de laisser suffisamment d'espace aux bruits de pas, aux silences et au déploiement de la musique autour de la réplique :
Create one complete eight-second cinematic sound scene at a quiet old European railway platform at dusk. Generate dialogue, subtle footsteps, outdoor ambience and piano music together as one coherent scene. At the beginning, a very gentle distant breeze and sparse soft warm piano establish quiet anticipation. Between about 1.0 and 2.1 seconds, exactly two very soft, unhurried shoe footsteps approach offscreen on dry concrete and stop a few feet away. The footsteps are a delicate background detail, much quieter than the speaking voice, never sharp, heavy or dramatic. Around 2.5 seconds, one adult man just offscreen speaks a single short line in natural, clear British English, with quiet surprise and restrained affection: "You waited." Only those two words, only one male speaker. Keep the music very soft around his words so his intimate delivery remains clear. After the line, leave a brief emotional pause with faint breeze. From about 4.8 seconds, let the piano gently open into a warm sustained chord, supporting the woman's silent reaction, then settle quietly at eight seconds. No additional dialogue, no reply, no narration, no singing, no announcements, no loud trains, no impact sounds. Do not speak these directions. Preserve the quiet intimacy of the reunion throughout.
L'audio d'origine dure huit secondes ; pour le montage final, le segment continu allant de 1,8 à 6,8 secondes a été extrait et placé sous le plan de cinq secondes. En post-production, seul le volume global de l'extrait a été ajusté avec de courts fondus d'entrée et de sortie, sans ajout de pistes séparées pour la voix, les pas ou la musique, et sans ducking multipiste.
À l'écoute, vérifiez trois points : la réplique est-elle parfaitement intelligible, les bruits de pas sont-ils suffisamment discrets, et la musique attend-elle bien la fin de la phrase pour se déployer ? Si l'un de ces critères n'est pas rempli, ajustez le prompt sur ce point précis tout en conservant le plan vidéo déjà validé.
Part 04|Dialogues à plusieurs personnages
Pour un prompt impliquant plusieurs personnages, il faut associer clairement chaque rôle, son timbre de voix, l'attribution des répliques et l'ordre des prises de parole. Commencez par un court échange d'une réplique chacun pour valider les deux voix avant d'allonger le dialogue.
| Personnage | Voix et interprétation | Réplique dans cet échange |
|---|---|---|
| Alex, homme hors champ | Voix masculine adulte assez grave et chaleureuse, anglais britannique naturel, avec une légère surprise | “You waited.” |
| Maya, jeune femme à l'écran | Voix féminine adulte plus claire et douce, anglais britannique naturel, calme et assurée | “I said I would.” |
Gardez exactement les mêmes noms de personnages tout au long du prompt et indiquez phrase par phrase qui prend la parole. Séparez la description du timbre de celle du jeu d'acteur : une même personne peut d'abord exprimer de la surprise puis du soulagement, tout en conservant une voix parfaitement reconnaissable.
Une fois qu'Alex a parlé, laissez un court temps de réaction à Maya avant qu'elle ne réponde. Si vous souhaitez qu'ils parlent chacun à leur tour, précisez explicitement que les voix ne doivent pas se chevaucher ; si le scénario exige une interruption, indiquez qui coupe la parole à qui et à partir de quel passage. Pendant que les deux personnages parlent, la musique de fond doit rester très discrète et ne prendre de l'ampleur qu'une fois l'échange terminé.
Voici un exemple de prompt original à deux interlocuteurs, qui n'a pas été généré pour écoute. Il enrichit la scène de la gare en ajoutant la réponse de la jeune femme et devra être associé à un plan vidéo montrant le jeu correspondant :
Create one complete eight-second sound scene at a quiet railway platform. Two adult characters speak in natural British English.
Alex: a warm, low male voice, a few feet offscreen, quietly surprised. Maya: a softer, brighter female voice, nearby, calm and quietly certain.
Begin with faint wind and sparse piano. Alex says only: "You waited." After he finishes, leave a brief pause for Maya's reaction. Maya then replies only: "I said I would." Keep each voice distinct and consistent. Speak only the quoted dialogue; do not read the character names or instructions. No overlapping dialogue or extra speakers. Keep the piano very quiet during both lines. Let it open gently only after Maya finishes, leaving room for the final reaction.
Écoutez d'abord l'extrait sans regarder l'image pour vérifier que l'on distingue bien les deux personnages, puis contrôlez avec la vidéo que les répliques n'ont pas été inversées, qu'aucune phrase parasite n'a été ajoutée, que les silences sont suffisants et que le résultat est compatible avec les mouvements des lèvres.
Si les timbres se confondent ou que les voix s'inversent lors d'un dialogue sur plusieurs échanges consécutifs, réduisez d'abord la génération à une seule question-réponse, puis traitez la suite du dialogue segment par segment. Réutilisez exactement les mêmes descriptions de personnages pour chaque partie et vérifiez la continuité des voix, de l'ambiance et de la musique une fois les extraits bout à bout ; en effet, une description textuelle identique ne garantit pas à elle seule que les voix générées seront strictement identiques d'une prise à l'autre.
Part 05|Montage des pistes audio
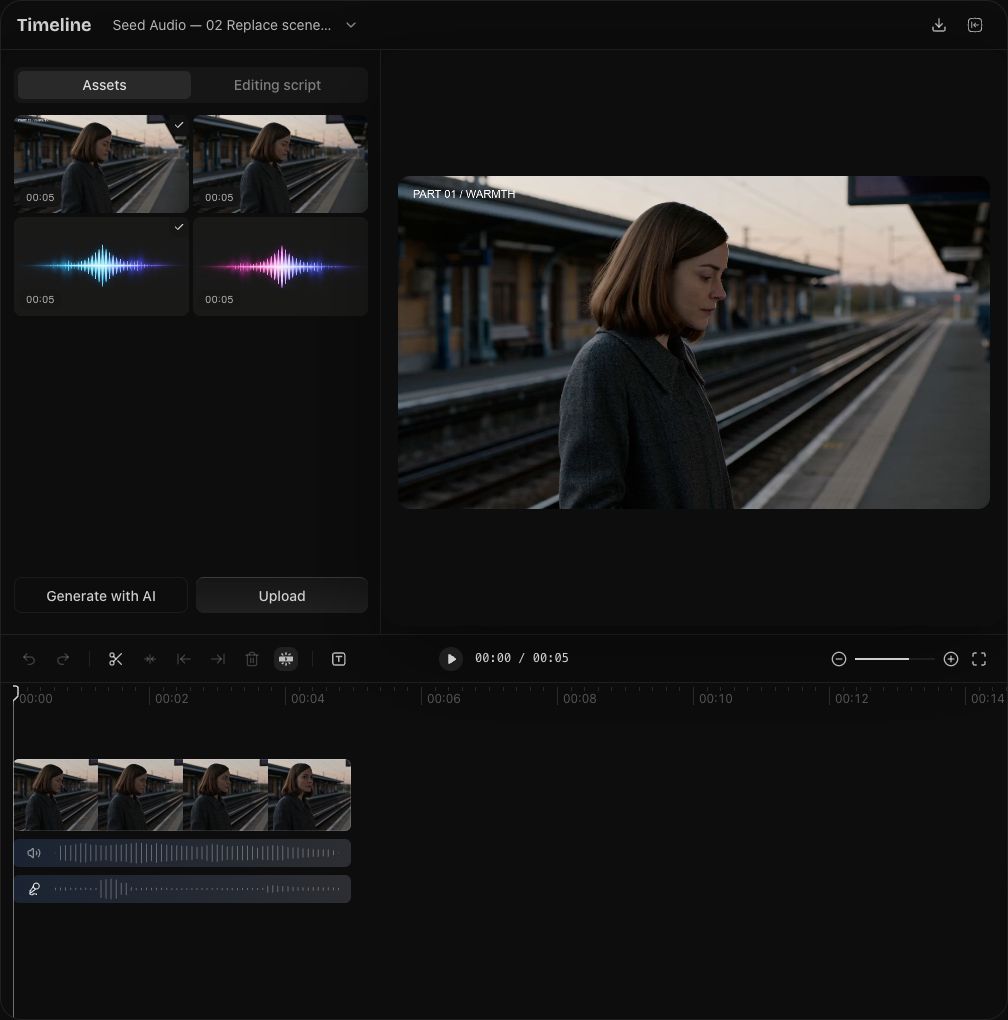
L'image ci-dessus illustre le processus dans Arcloop : on conserve le plan vidéo de cinq secondes sur la piste supérieure, on coupe le son de la piste audio d'origine, puis on place en dessous l'extrait sonore complet généré par Seed Audio afin que le dialogue, l'ambiance et la musique remplacent ensemble le son initial. Il suffit ensuite de faire glisser le clip audio pour aligner la réplique avec la réaction du personnage, puis de lancer la lecture complète pour vérifier la fluidité du raccord.
Si vous avez généré uniquement une musique de fond ou une ambiance sonore, il suffit d'ajouter une piste audio supplémentaire. Conservez les dialogues et les sons d'origine utiles de la vidéo, placez le nouvel extrait audio sur une piste inférieure, puis ajustez ses points d'entrée et de sortie ainsi que son volume. Lorsqu'un personnage parle, vous pouvez placer des images clés (keyframes) de volume sur la piste d'arrière-plan : baissez le niveau juste avant la prise de parole, maintenez-le bas pendant la réplique, puis faites-le remonter après la pause de fin de phrase.
Si vous avez généré une scène sonore complète réunissant le fond sonore et les répliques des personnages, remplacez l'audio d'origine sur le segment correspondant. Détachez la piste audio initiale de la vidéo, scindez-la sur la plage à remplacer pour la mettre en sourdine ou la supprimer, puis alignez le nouvel extrait afin d'éviter que la même réplique ne soit jouée deux fois. Conservez le son d'origine sur le reste des plans.
Une fois le remplacement effectué, vérifiez que les répliques tombent juste par rapport aux mouvements des lèvres et aux réactions des personnages, et assurez-vous qu'il n'y a pas de coupure brusque au début ou à la fin de l'extrait ; au besoin, appliquez de courts fondus pour que l'ambiance sonore s'enchaîne naturellement. Lorsque les voix et la musique sont déjà mixées dans un seul fichier, baisser le volume global réduira également le niveau des voix ; si vous devez rééquilibrer les deux, il faudra soit relancer une génération, soit travailler le mixage à partir de pistes séparées.
Rendez-vous sur la page du modèle Seed Audio et commencez par travailler un extrait clé : définissez qui dit quoi, quelle couleur donner au son et à quel moment la musique doit s'effacer, puis réintégrez la piste dans votre vidéo pour écouter le résultat.