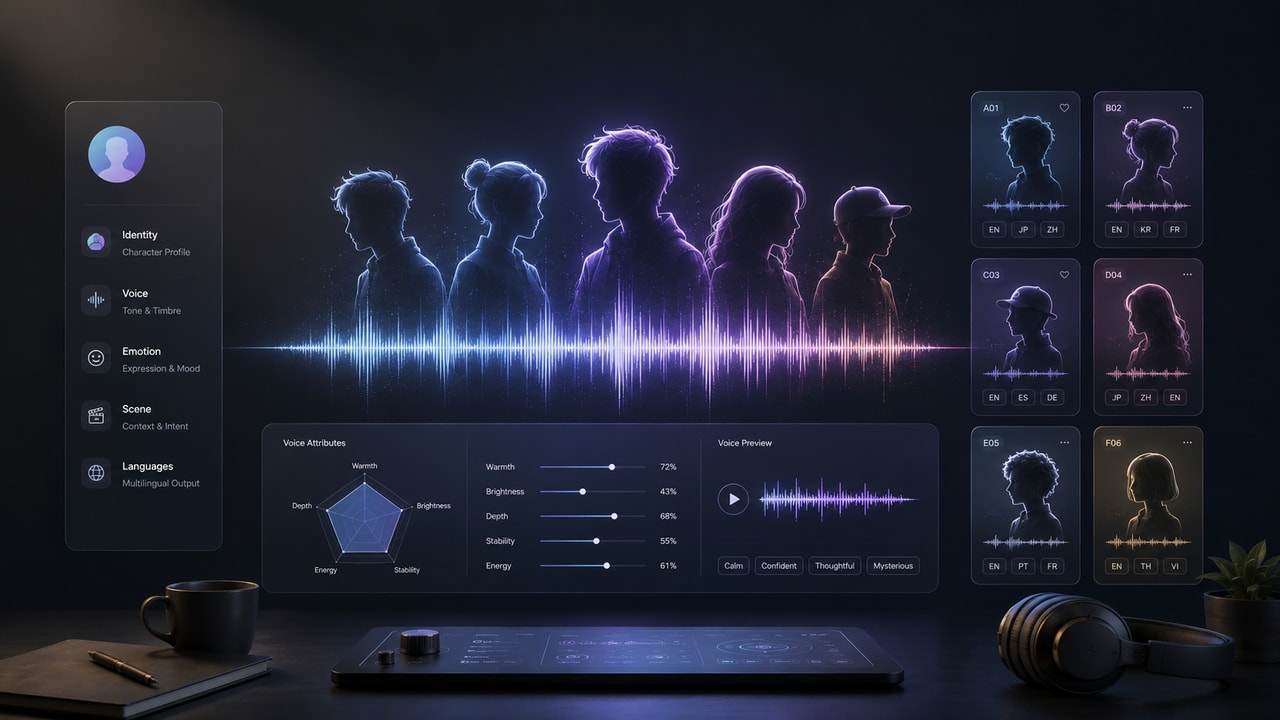
La colonna sonora e il doppiaggio sono il tocco finale di un cortometraggio AI. I modelli video riescono già a generare immagini e audio insieme, ma non sono strumenti dedicati alla creazione sonora. Se vuoi portare la qualità del tuo film a un livello superiore, devi ricorrere a un modello di generazione audio indipendente. Questo articolo prende come esempio Seed Audio per mostrare come generare tracce sonore su misura per un film.
Ascoltiamo prima un esempio di audio ambientale dalla pagina del modello Seed Audio:
Questa traccia unisce il riverbero spaziale della voce, una spiccata interpretazione emotiva e la musica di sottofondo. Durante l'ascolto, fai attenzione a come si prolungano le code vocali, a come varia l'intonazione e a come la musica accompagna la recitazione. Questi dettagli sono esattamente gli aspetti su cui vale la pena lavorare quando si progetta separatamente il suono per i momenti chiave della trama.
Completa prima il video, scegli i passaggi narrativi da valorizzare, poi genera l'audio, inseriscilo nell'inquadratura per riascoltarlo e infine procedi al montaggio.
Part 01|Casi d'uso di Seed Audio
I modelli video possono generare l'audio insieme alle immagini, ma la resa emotiva dei dialoghi chiave, le pause sottili e l'equilibrio tra suoni di sottofondo e personaggi non sempre raggiungono l'effetto richiesto dalla scena. Quando l'inquadratura è già convincente ma il dialogo non rende abbastanza, oppure il sottofondo sonoro non riesce a essere regolato al livello desiderato, vale la pena intervenire sull'audio separatamente.
I prompt video servono soprattutto a descrivere l'immagine, l'azione, i movimenti di macchina e lo storyboard, lasciando uno spazio limitato all'audio. Una volta definito il video, gli elementi che richiedono un'interpretazione mirata possono essere affidati a un modello di generazione sonora come Seed Audio, concentrandosi sul descrivere come devono essere pronunciate le battute, come deve accompagnare il sottofondo e come deve svilupparsi il ritmo.
| Elemento da potenziare | Cosa si può progettare nello specifico |
|---|---|
| Battute chiave ed emozioni | Se la stessa frase esprime scusa, esitazione o sorpresa; dove cade l'accento e quanto dura la pausa prima e dopo aver parlato |
| Equilibrio tra voce e sottofondo | La musica si abbassa quando il personaggio parla e si riapre dopo una pausa a fine frase; passi e vento restano in secondo piano |
| Suoni specifici nella scena | Passi fuori campo, bussare alla porta, macchinari in funzione, oppure l'assolo di uno strumento specifico, la tecnica esecutiva e il timbro |
| Svolta emotiva | A parità di immagine, usare un suono caldo, triste o minaccioso per cambiare il modo in cui lo spettatore interpreta l'incontro |
Stabilisci prima le battute e la dinamica dei dialoghi durante la produzione video, poi potenzia l'audio per le clip selezionate: in questo modo potrai continuare a usare le inquadrature di cui sei già soddisfatto. Se l'audio originale è già adatto, conservalo; quando sostituisci un dialogo, verifica la durata e il labiale ed evita che le battute nuove si sovrappongano a quelle vecchie.
Queste tre tracce musicali sono state generate separatamente e poi messe a confronto sotto la stessa inquadratura di cinque secondi. Ecco i tre prompt effettivamente usati nel video finale:
WARMTH: pianoforte caldo in tonalità maggiore e archi delicati, per dare una risposta all'attesa.
Create a five-second instrumental film-music cue for a quiet reunion at an old European railway station. Begin immediately with gentle, sparse piano in a warm major harmony. Around the middle, a soft sustained string chord opens with a little hope, as a waiting woman notices someone arriving offscreen. End softly and reassuringly. Intimate and restrained, no big climax. Music only: no speech, narration, singing, voices, station ambience, sound effects or percussion. Do not read the instructions aloud.
SORROW: violoncello, melodia discendente in tonalità minore e finale irrisolto, per velare l'incontro di rimpianto.
Create a five-second instrumental film score that immediately conveys grief and a painful reunion. Start at once with an expressive solo cello playing a clearly descending minor-key melody, supported by dark sustained violas. Let the melody fall and linger as if someone realizes a loved relationship is lost. Strongly sorrowful and emotionally exposed, intimate rather than epic. No cheerful or comforting resolution. Keep the music clearly audible throughout, ending with an unresolved sustained note. Music only. No speech, singing, voices, piano, ambience or sound effects.
DANGER: ostinato grave ripetuto, pulsazione profonda, archi dissonanti e silenzio finale, per rendere minaccioso chi arriva fuori campo.
Create a five-second instrumental psychological-thriller score with unmistakable immediate danger. From the very first moment, use a tight repeating low-string ostinato and a deep controlled bass pulse. Add close, tense dissonant high strings, building rapidly in density as someone threatening approaches offscreen. Make the tension clear and urgent rather than faint background atmosphere. During the final half-second abruptly cut the music to silence. No jump-scare impact. Music only. No speech, singing, voices, gentle piano, warm harmony, ambience or literal sound effects.
Ogni segmento è preceduto da un cartello di 0,75 secondi, per un confronto completo di circa 17,25 secondi. Durante l'ascolto, nota come lo stesso gesto di alzare lo sguardo venga interpretato dalle tre musiche rispettivamente come sollievo, rimpianto e allerta.
Part 02|Come scrivere i prompt per Seed Audio
Quando scrivi un prompt audio, devi chiarire tre aspetti: cosa viene detto, come suona e quando accade.
La documentazione dell'API di generazione audio fornisce un esempio di dialogo thriller: la vibrazione di un telefono apre la scena, il cinguettio degli uccelli continua in sottofondo, mentre una marimba abbinata a timbri elettronici costruisce la suspense; due uomini parlano a turno e infine il rumore di un veicolo e dei passi fa avanzare l'azione. Personaggi, musica ed eventi sonori sono descritti tutti all'interno dello stesso prompt.
| Elemento del prompt | Come lo gestisce l'esempio della documentazione | Cosa inserire quando scrivi la tua clip |
|---|---|---|
| Contenuto: chi dice cosa | Specifica separatamente le battute dei due uomini e l'ordine degli interventi | Nomi dei personaggi, battute parola per parola, lingua ed eventuale risposta |
| Suono: come viene percepito | Distingue una voce maschile profonda e corposa da una roca e matura, indicando l'accento; definisce strumento principale e accompagnamento | Timbro, tono emotivo, distanza dei personaggi, ambiente e strumenti, evitando espressioni vaghe come "cinematografico" |
| Ritmo: come si sviluppa | Inizia con un effetto sonoro d'apertura, poi sviluppa il dialogo; domande incalzanti e spiegazioni guidano i cambi di tono, chiudendo con i suoni dell'azione | Momento di attacco della voce, velocità di eloquio, pause tra le frasi, ingresso e uscita del sottofondo |
Prendendo come esempio il ricongiungimento alla stazione, si può partire definendo: una battuta precisa + un'interpretazione specifica + una chiara svolta sonora. L'uomo fuori campo dice soltanto “You waited.”, esprimendo l'incontro con una voce bassa, un'intimità trattenuta e il pianoforte che si apre a fine frase.
La sequenza sonora del caso della stazione è: brezza leggera e pianoforte → due passi leggeri → la voce maschile parla, la musica resta molto bassa → breve pausa → il pianoforte si apre.
Metti la battuta tra virgolette e specifica che la ragazza non risponde; i passi devono essere più bassi della voce, senza far entrare annunci o rumori di treni. Definisci prima con chiarezza queste relazioni, poi aggiungi le indicazioni temporali approssimative in base alla durata dell'inquadratura; i tempi andranno verificati confrontandoli con il risultato generato, specialmente per i punti esatti in cui cadono musica ed effetti sonori.
Se la clip richiede un assolo di marimba, specifica lo strumento, la consistenza del tocco, la velocità di esecuzione, la densità delle note e il modo in cui si chiude. Ecco un prompt originale da provare, non ancora generato per l'ascolto:
Create an eight-second solo marimba cue for a quiet, suspenseful scene. Use soft mallets and a warm wooden tone. Begin with sparse, slow notes and clear gaps between them. Gradually make the repeating pattern slightly more insistent, then stop before the final beat and leave a short silence. No voices, drums, synthesizers or other instruments.
Qui il ritmo segue lo schema "rado → leggermente più incalzante → silenzio improvviso": strumento, tecnica esecutiva e ingresso o uscita del suono possono essere verificati punto per punto, ma per valutare se timbro e ritmo funzionano davvero resta indispensabile l'ascolto.
Part 03|Il ducking nei dialoghi
Il ducking consiste nell'abbassare la musica di sottofondo quando un personaggio parla, per poi riportarla a livello una volta terminata la battuta. Per una scena di ricongiungimento silenziosa e intima, oltre a ridurre il volume si può anche diradare l'accompagnamento, lasciando il centro dell'attenzione uditiva ai personaggi.
Quando usi Seed Audio per generare contemporaneamente voce e sottofondo, inserisci questa relazione direttamente nel prompt:
Quando l'uomo pronuncia a bassa voce “You waited.”, il pianoforte rimane molto lieve, il vento arretra in lontananza e i passi si sono già fermati. Dopo la battuta lascia una breve pausa, poi fai aprire dolcemente il pianoforte per accompagnare la reazione della ragazza.
Non limitarti a scrivere "ducking automatico". Specifica con chiarezza chi deve essere sentito nitidamente, quali suoni devono farsi da parte e quando devono riprendere, poi verifica se il modello ha rispettato le indicazioni. In questo esempio tutte queste relazioni sono state gestite insieme in un'unica generazione.
Se il video contiene già un dialogo, puoi anche estrarre l'audio originale come riferimento, specificando il timbro, le battute e il ritmo che desideri mantenere, insieme alle modifiche da apportare al tono emotivo o al rapporto con il sottofondo. Dopo la generazione, riascolta il risultato sull'inquadratura e sostituisci la traccia audio originale del segmento corrispondente; i dettagli sul montaggio sono spiegati nella Part 05.
Il video mantiene l'inquadratura della stazione di cinque secondi generata con Seedance 2 Fast: la ragazza attende a testa bassa, poi alza lo sguardo verso il fuori campo. La voce maschile pronuncia una sola frase, i passi leggeri suggeriscono l'avvicinarsi di qualcuno e il pianoforte dopo la battuta accoglie la reazione silenziosa della ragazza.
Questa traccia audio è stata realizzata usando il prompt qui sotto. In fase di generazione sono stati richiesti otto secondi per lasciare spazio ai passi, alle pause e all'apertura musicale prima e dopo la battuta:
Create one complete eight-second cinematic sound scene at a quiet old European railway platform at dusk. Generate dialogue, subtle footsteps, outdoor ambience and piano music together as one coherent scene. At the beginning, a very gentle distant breeze and sparse soft warm piano establish quiet anticipation. Between about 1.0 and 2.1 seconds, exactly two very soft, unhurried shoe footsteps approach offscreen on dry concrete and stop a few feet away. The footsteps are a delicate background detail, much quieter than the speaking voice, never sharp, heavy or dramatic. Around 2.5 seconds, one adult man just offscreen speaks a single short line in natural, clear British English, with quiet surprise and restrained affection: "You waited." Only those two words, only one male speaker. Keep the music very soft around his words so his intimate delivery remains clear. After the line, leave a brief emotional pause with faint breeze. From about 4.8 seconds, let the piano gently open into a warm sustained chord, supporting the woman's silent reaction, then settle quietly at eight seconds. No additional dialogue, no reply, no narration, no singing, no announcements, no loud trains, no impact sounds. Do not speak these directions. Preserve the quiet intimacy of the reunion throughout.
L'audio originale dura otto secondi; per il video finale è stato estratto il segmento continuo tra 1,8 e 6,8 secondi, inserendolo nell'inquadratura di cinque secondi. In post-produzione è stato solo regolato uniformemente il volume dell'intera clip aggiungendo brevi dissolvenze in apertura e chiusura, senza sovrapporre separatamente voci, passi o musica e senza applicare ducking su tracce separate.
Durante l'ascolto verifica tre elementi: se la battuta si sente chiaramente, se i passi sono abbastanza leggeri e se la musica si apre solo dopo che l'uomo ha finito di parlare. Se uno di questi punti non riesce, modifica il prompt intervenendo su quell'aspetto specifico, continuando a usare l'inquadratura già approvata.
Part 04|Dialoghi tra più personaggi
Nei prompt con più personaggi occorre associare con precisione ruolo, timbro vocale, attribuzione delle battute e ordine degli interventi. Inizia con un breve scambio di battute per verificare le voci dei due interlocutori, prima di aggiungere altro dialogo.
| Personaggio | Voce e interpretazione | Battuta in questo scambio |
|---|---|---|
| Alex, uomo fuori campo | Voce maschile adulta medio-bassa e calda, inglese britannico naturale, con una lieve sorpresa | “You waited.” |
| Maya, ragazza in campo | Voce femminile adulta più chiara e morbida, inglese britannico naturale, calma e ferma | “I said I would.” |
Mantieni coerenti i nomi dei personaggi in tutto il prompt, indicando frase per frase chi parla. Descrivi separatamente il timbro vocale e l'interpretazione: la stessa persona può mostrarsi prima sorpresa e poi sollevata, ma deve continuare a sembrare lo stesso personaggio.
Dopo che Alex ha parlato, lascia a Maya un breve tempo di reazione prima di farla rispondere. Se vuoi che parlino a turno, specifica che non devono sovrapporsi; se invece la trama richiede un'interruzione, chiarisci chi interrompe chi e a partire da quale frase. Mentre i due parlano, la musica di sottofondo resta molto leggera per poi aprirsi solo al termine dell'intero scambio.
Ecco un esempio di prompt originale a due voci, non ancora generato per l'ascolto. Parte dal caso della stazione aggiungendo la risposta della ragazza e va abbinato a un'inquadratura con la recitazione corrispondente:
Create one complete eight-second sound scene at a quiet railway platform. Two adult characters speak in natural British English.
Alex: a warm, low male voice, a few feet offscreen, quietly surprised. Maya: a softer, brighter female voice, nearby, calm and quietly certain.
Begin with faint wind and sparse piano. Alex says only: "You waited." After he finishes, leave a brief pause for Maya's reaction. Maya then replies only: "I said I would." Keep each voice distinct and consistent. Speak only the quoted dialogue; do not read the character names or instructions. No overlapping dialogue or extra speakers. Keep the piano very quiet during both lines. Let it open gently only after Maya finishes, leaving room for the final reaction.
Ascolta prima senza guardare il video per capire se i due personaggi si distinguono chiaramente, poi confronta con l'inquadratura per verificare che le battute non siano state invertite, che non ci siano frasi in più, che le pause siano sufficienti e che il movimento delle labbra sia compatibile.
Se in uno scambio di più battute consecutive i timbri si confondono o le voci vengono scambiate, puoi prima ridurre la generazione a un singolo botta e risposta e poi gestire il resto del dialogo per segmenti. Riutilizza la stessa descrizione dei personaggi in ogni segmento e controlla che, una volta uniti, timbro vocale, suoni ambientali e musica mantengano continuità; la sola descrizione testuale non garantisce che le voci risultino identiche tra generazioni diverse.
Part 05|Montaggio delle tracce audio
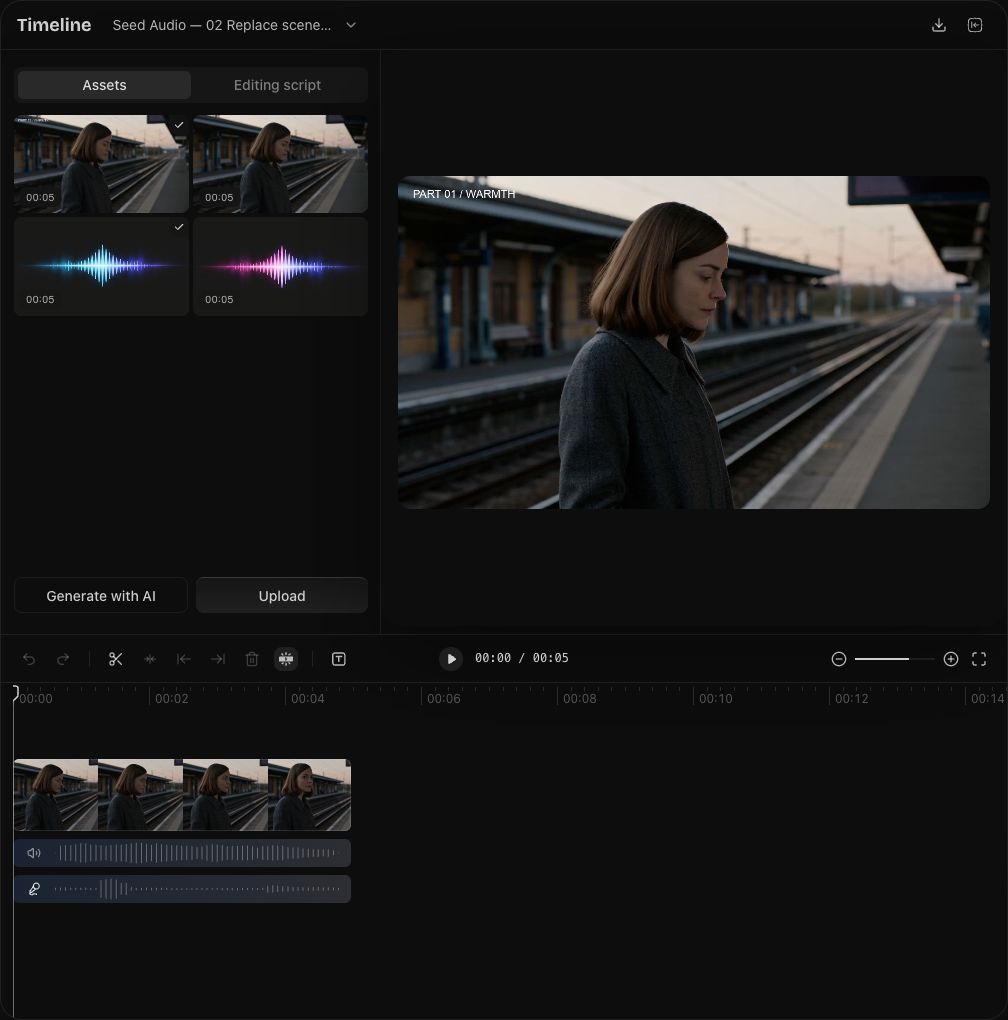
L'immagine qui sopra mostra un esempio in Arcloop: si mantiene l'inquadratura di cinque secondi in alto, si silenzia la traccia audio originale e si aggiunge sotto la clip sonora completa generata con Seed Audio, lasciando che dialogo, suoni ambientali e musica sostituiscano insieme l'audio nativo. Trascina la posizione della traccia per allineare la battuta e la reazione del personaggio, poi riproduci per intero per verificare la fluidità del passaggio.
Se hai generato solo musica di sottofondo o suoni ambientali, basta aggiungere una nuova traccia audio. Mantieni i dialoghi e i suoni originali necessari nel video, posiziona il nuovo audio sotto e regolane i punti di inizio e fine e il volume. Quando un personaggio parla, puoi inserire dei keyframe di volume sulla traccia di sottofondo: abbassa prima che inizi a parlare, mantieni il livello ridotto durante la battuta e rialza dopo la pausa a fine frase.
Se invece hai generato una clip completa che include sia il sottofondo sia le battute dei personaggi, sostituisci l'audio originale nel punto corrispondente. Separa il video dalla traccia audio originale, taglia e silenzia o rimuovi il vecchio audio nell'intervallo da sostituire, quindi allinea il nuovo audio evitando che la stessa battuta venga riprodotta due volte. Mantieni l'audio originale per il resto delle clip.
Dopo la sostituzione, controlla che battute, labiale e reazioni combacino e che non ci siano stacchi bruschi all'inizio o alla fine della clip; se necessario, aggiungi brevi dissolvenze per raccordare con naturalezza i suoni ambientali. Quando voce e musica sono già mixate nello stesso file, abbassare il volume generale ridurrà anche la voce; se occorre modificare l'equilibrio tra i due elementi, puoi rigenerare la traccia oppure eseguire il mixaggio usando tracce separate.
Apri la pagina del modello Seed Audio e inizia da una scena chiave: stabilisci chi dice cosa, come deve suonare e quando il sottofondo deve farsi da parte, poi inserisci la traccia nel video e riascolta.