배경 음악과 더빙은 AI 단편 영화의 완성도를 높이는 핵심 요소입니다. 비디오 모델도 영상과 소리를 동시에 생성할 수 있지만, 전문적인 사운드 생성 도구는 아닙니다. 영화의 질감을 한 단계 더 끌어올리고 싶다면 독립적인 사운드 생성 모델을 사용해야 합니다. 이 글에서는 Seed Audio를 예시로 들어 영상을 위한 맞춤형 사운드 클립을 생성하는 방법을 살펴봅니다.
먼저 Seed Audio 모델 페이지에 있는 장면 사운드 사례를 들어보세요.
이 사운드는 목소리의 공간 잔향, 뚜렷한 감정 연기, 그리고 배경 음악을 하나로 결합했습니다. 들어보실 때 끝음이 어떻게 이어지는지, 어조가 어떻게 오르내리는지, 음악이 연기와 어떻게 어우러지는지 주의 깊게 살펴보세요. 이러한 디테일은 결정적인 장면을 위해 사운드를 별도로 설계할 때 공들여 다듬어야 할 부분이기도 합니다.
먼저 영상을 완성하고 보강이 필요한 장면을 고른 뒤, 사운드를 생성해 샷에 다시 넣어 들어보고 마지막으로 편집을 진행합니다.
Part 01|Seed Audio의 활용 시나리오
비디오 모델은 영상을 만들면서 동시에 소리를 생성할 수 있지만, 핵심 대사의 감정 연기, 미세한 호흡과 멈춤, 배경음과 인물의 조화가 해당 장면이 요구하는 수준에 미치지 못할 때가 있습니다. 영상은 충분히 괜찮은데 대사가 조금 아쉽거나 배경음을 원하는 대로 조정할 수 없는 단계라면, 사운드를 별도로 보강할 가치가 있습니다.
비디오 프롬프트는 주로 화면, 동작, 카메라 무빙, 스토리보드를 묘사하는 데 쓰이므로 소리에 할애할 수 있는 분량이 제한적입니다. 중점적으로 살려야 하는 내용은 화면이 확정된 후 Seed Audio 같은 사운드 생성 모델에 맡겨, 대사를 어떻게 말할지, 배경음이 어떻게 받쳐줄지, 리듬을 어떻게 전개할지 집중적으로 묘사할 수 있습니다.
| 보강이 필요한 내용 | 별도로 설계할 수 있는 요소 |
|---|---|
| 핵심 대사와 감정 | 같은 문장이라도 미안함, 떠보기, 놀람 중 어떤 감정을 담을지, 강세는 어디에 두고 말하기 전후에 얼마나 멈출지 |
| 목소리와 배경음의 조화 | 인물이 말할 때 음악이 뒤로 물러나고 문장 끝에 여백을 둔 뒤 다시 펼쳐지도록 설정, 발소리와 바람 소리는 배경에 유지 |
| 장면 속 특정 사운드 | 화면 밖 발소리, 노크 소리, 기계 작동음 또는 특정 악기의 독주, 연주 방식과 음색 |
| 감정선 전환 | 동일한 화면에 따뜻함, 슬픔 또는 위험한 느낌의 사운드를 입혀 만남에 대한 관객의 해석을 바꿈 |
비디오 제작 단계에서 대사와 대화 관계를 먼저 확정한 뒤 선택한 클립의 사운드를 보강하면, 이미 마음에 드는 영상을 그대로 활용할 수 있습니다. 기존 원본 오디오가 적절하다면 그대로 유지하고, 대사를 교체할 때는 길이와 입모양을 확인하며 기존 대사와 새 대사가 겹치지 않도록 주의해야 합니다.
이 세 가지 음악은 각각 따로 생성한 뒤, 동일한 5초 분량의 영상 아래에 배치해 비교한 것입니다. 다음은 완성된 영상에 실제로 사용된 세 가지 프롬프트입니다.
WARMTH: 따뜻한 장조 피아노와 부드러운 현악기로 기다림이 응답받는 느낌을 줍니다.
Create a five-second instrumental film-music cue for a quiet reunion at an old European railway station. Begin immediately with gentle, sparse piano in a warm major harmony. Around the middle, a soft sustained string chord opens with a little hope, as a waiting woman notices someone arriving offscreen. End softly and reassuringly. Intimate and restrained, no big climax. Music only: no speech, narration, singing, voices, station ambience, sound effects or percussion. Do not read the instructions aloud.
SORROW: 첼로, 하강하는 단조 멜로디와 해결되지 않은 끝맺음으로 만남에 아쉬움을 더합니다.
Create a five-second instrumental film score that immediately conveys grief and a painful reunion. Start at once with an expressive solo cello playing a clearly descending minor-key melody, supported by dark sustained violas. Let the melody fall and linger as if someone realizes a loved relationship is lost. Strongly sorrowful and emotionally exposed, intimate rather than epic. No cheerful or comforting resolution. Keep the music clearly audible throughout, ending with an unresolved sustained note. Music only. No speech, singing, voices, piano, ambience or sound effects.
DANGER: 반복되는 저음, 펄스, 불협화음 현악기와 마지막 여백으로 화면 밖에서 다가오는 이를 위험하게 보이도록 만듭니다.
Create a five-second instrumental psychological-thriller score with unmistakable immediate danger. From the very first moment, use a tight repeating low-string ostinato and a deep controlled bass pulse. Add close, tense dissonant high strings, building rapidly in density as someone threatening approaches offscreen. Make the tension clear and urgent rather than faint background atmosphere. During the final half-second abruptly cut the music to silence. No jump-scare impact. Music only. No speech, singing, voices, gentle piano, warm harmony, ambience or literal sound effects.
각 구간 앞에는 0.75초의 타이틀 카드가 들어가며, 전체 비교 영상은 약 17.25초입니다. 들어보실 때 눈을 들어 올리는 똑같은 동작이 세 가지 음악에 의해 각각 안도감, 아쉬움, 경계심으로 어떻게 다르게 해석되는지 확인해 보세요.
Part 02|Seed Audio 프롬프트 작성법
사운드 프롬프트를 작성할 때는 무엇을 말하는지, 어떻게 들리는지, 언제 발생하는지의 세 가지를 명확히 적어주어야 합니다.
오디오 생성 API 문서는 서스펜스 대화 예시를 하나 제공합니다. 휴대폰 진동으로 장면을 열고, 새소리가 배경에 계속 깔리며, 마림바와 전자음이 어우러져 긴장감을 조성합니다. 두 남자가 번갈아 대화하고 마지막에는 차량 소리와 발소리로 동작을 이어갑니다. 인물, 음악, 사운드 이벤트를 하나의 프롬프트 안에 모두 담아낸 것입니다.
| 프롬프트 요소 | 문서 예시의 처리 방식 | 내 클립을 작성할 때 채워야 할 내용 |
|---|---|---|
| 내용: 누가 무엇을 말하는가 | 두 남자의 대사와 말하는 순서를 각각 지정 | 캐릭터 이름, 정확한 대사 문구, 언어 및 응답 여부 |
| 소리: 어떻게 들리는가 | 낮고 묵직한 남성 목소리와 허스키하고 성숙한 남성 목소리를 구분하고 억양 지정, 메인 악기와 반주 명확화 | 음색, 어조, 인물 간 거리, 환경음 및 악기('영화 같은 느낌'이라고만 쓰는 것은 피함) |
| 리듬: 어떻게 전개되는가 | 암시적인 효과음 후 대화 전개, 추궁과 해명에 따라 어조가 변하고 끝에 동작 사운드 연결 | 말하기 시작하는 타이밍, 말하는 속도, 문장 사이의 멈춤, 배경음의 진입과 퇴장 |
기차역 재회 장면을 예로 들면, 먼저 '정확한 대사 한 줄 + 구체적인 연기 방식 + 명확한 사운드 전환'을 확정할 수 있습니다. 화면 밖의 남자는 그저 "You waited."라고만 말하며, 낮고 절제된 친밀감과 문장 끝에 펼쳐지는 피아노 선율로 만남을 표현합니다.
기차역 사례의 사운드 순서는 다음과 같습니다. 가벼운 바람 소리와 피아노 → 가벼운 발소리 두 번 → 남자가 말할 때 음악은 아주 작게 유지 → 짧은 멈춤 → 피아노 선율 전개.
대사는 따옴표로 표시하고 소녀는 대답하지 않는다고 명시합니다. 발소리는 목소리보다 작아야 하며 안내 방송이나 기차 소리는 넣지 않습니다. 이러한 관계를 먼저 명확히 적은 뒤, 샷의 길이에 맞춰 대략적인 시간을 보충합니다. 시간 요구사항은 생성된 결과물과 대조해 확인해야 하며, 특히 음악과 효과음이 들어가는 구체적인 지점을 체크해야 합니다.
클립에 마림바 독주가 필요하다면 악기, 타건 질감, 연주 속도, 음표 밀도와 마무리 방식을 명확히 적어줍니다. 다음은 시도해 볼 수 있는 창작 프롬프트 예시로, 아직 오디오로 생성하지는 않은 초안입니다.
Create an eight-second solo marimba cue for a quiet, suspenseful scene. Use soft mallets and a warm wooden tone. Begin with sparse, slow notes and clear gaps between them. Gradually make the repeating pattern slightly more insistent, then stop before the final beat and leave a short silence. No voices, drums, synthesizers or other instruments.
여기서 리듬은 '성긴 음 → 점차 다가오는 느낌 → 갑작스러운 여백'으로 전개되며, 악기와 연주 방식, 소리의 치고 빠짐을 항목별로 대조해 확인할 수 있습니다. 질감과 리듬이 제대로 구현되었는지는 여전히 직접 들어보며 판단해야 합니다.
Part 03|대사에서의 Ducking
Ducking이란 인물이 말할 때 배경 음악의 볼륨을 낮추고 대사가 끝난 뒤 다시 원래대로 회복시키는 기법입니다. 조용한 재회 장면에서는 볼륨을 낮추는 것 외에도 반주를 더 성기게 배치해 청각적 초점을 인물에게 남겨둘 수 있습니다.
Seed Audio로 목소리와 배경음을 동시에 생성할 때는 이러한 관계를 프롬프트에 직접 적어줍니다.
남자가 낮은 목소리로 "You waited."라고 말할 때 피아노는 아주 작게 유지되고, 바람 소리는 멀리 물러나며, 발소리는 이미 멈춘 상태입니다. 대사 뒤에 짧은 멈춤을 둔 다음, 피아노가 부드럽게 펼쳐지며 소녀의 반응을 이어받습니다.
단순히 '자동 ducking'이라고만 적지 마세요. 누구의 목소리가 또렷하게 들려야 하는지, 어떤 소리가 뒤로 물러나야 하는지, 언제 다시 커지는지 명확히 적고 모델이 이를 제대로 구현했는지 확인해야 합니다. 이 예시에서는 이러한 관계가 모두 한 번의 생성 과정에서 일괄 처리되었습니다.
영상이 이미 대사를 포함하고 있다면 원본 오디오를 추출해 레퍼런스로 삼으면서 유지하고 싶은 음색, 대사, 리듬과 조정이 필요한 어조나 배경음의 관계를 명확히 적어줄 수도 있습니다. 생성 후 화면과 맞춰 들어본 뒤 해당 구간의 원본 오디오 트랙을 교체하면 됩니다. 구체적인 편집 방식은 Part 05에서 다룹니다.
영상은 Seedance 2 Fast로 생성한 5초짜리 기차역 샷을 그대로 사용했습니다. 고개를 숙이고 기다리던 소녀가 눈을 들어 화면 밖을 바라봅니다. 남자의 목소리로 단 한 마디만 들리고, 가벼운 발소리가 다가오는 이를 암시하며, 대사 뒤의 피아노가 소녀의 침묵하는 반응을 받아줍니다.
이 사운드에는 실제로 아래 프롬프트가 사용되었습니다. 생성 시 대사 전후의 발소리, 멈춤, 음악이 펼쳐질 여유 공간을 확보하기 위해 8초 분량을 요청했습니다.
Create one complete eight-second cinematic sound scene at a quiet old European railway platform at dusk. Generate dialogue, subtle footsteps, outdoor ambience and piano music together as one coherent scene. At the beginning, a very gentle distant breeze and sparse soft warm piano establish quiet anticipation. Between about 1.0 and 2.1 seconds, exactly two very soft, unhurried shoe footsteps approach offscreen on dry concrete and stop a few feet away. The footsteps are a delicate background detail, much quieter than the speaking voice, never sharp, heavy or dramatic. Around 2.5 seconds, one adult man just offscreen speaks a single short line in natural, clear British English, with quiet surprise and restrained affection: "You waited." Only those two words, only one male speaker. Keep the music very soft around his words so his intimate delivery remains clear. After the line, leave a brief emotional pause with faint breeze. From about 4.8 seconds, let the piano gently open into a warm sustained chord, supporting the woman's silent reaction, then settle quietly at eight seconds. No additional dialogue, no reply, no narration, no singing, no announcements, no loud trains, no impact sounds. Do not speak these directions. Preserve the quiet intimacy of the reunion throughout.
원본 오디오는 8초이며, 완성본에서는 그중 연속된 1.8~6.8초 구간을 잘라내어 5초 영상에 넣었습니다. 후반 작업에서는 전체 구간의 볼륨을 일괄 조정하고 앞뒤에 짧은 페이드 효과만 넣었을 뿐, 목소리나 발소리, 배경 음악을 별도로 겹쳐 입히거나 트랙을 나누어 ducking을 적용하지 않았습니다.
들어보실 때는 세 가지를 확인하세요. 대사가 또렷하게 들리는지, 발소리가 충분히 가벼운지, 말이 끝난 뒤에야 음악이 펼쳐지는지 살펴봅니다. 만약 어느 한 가지라도 제대로 되지 않았다면, 이미 확정된 영상은 그대로 둔 채 해당 항목에 맞춰 프롬프트만 수정합니다.
Part 04|다중 캐릭터 대화
다중 캐릭터 프롬프트는 캐릭터, 음색, 대사 주체, 대화를 주고받는 순서를 서로 정확히 매칭해야 합니다. 먼저 짧은 한 턴의 대화로 두 사람의 목소리를 확인한 뒤에 대사를 늘려가는 것이 좋습니다.
| 캐릭터 | 목소리 및 연기 | 이번 턴의 대사 |
|---|---|---|
| Alex, 화면 밖 남자 | 다소 낮고 따뜻한 성인 남성 목소리, 자연스러운 영국식 영어, 약간의 놀람을 머금음 | “You waited.” |
| Maya, 화면 속 소녀 | 비교적 밝고 부드러운 성인 여성 목소리, 자연스러운 영국식 영어, 차분하고 단호함 | “I said I would.” |
캐릭터 이름은 프롬프트 전체에서 일관되게 유지하고, 문장마다 누가 말하는지 표시합니다. 음색과 연기는 구분해서 작성합니다. 같은 사람이 처음에는 놀랐다가 이어서 안도하더라도 여전히 동일한 캐릭터의 목소리로 들려야 하기 때문입니다.
Alex가 말을 마친 뒤 Maya가 반응할 시간을 조금 남겨두고 Maya가 대답하도록 합니다. 두 사람이 번갈아 말하기를 원한다면 대사가 겹치지 않는다고 명확히 적고, 극의 전개상 말을 끊어야 한다면 누가 누구의 말을 어느 구절에서 끊는지 설명해야 합니다. 두 사람이 대화하는 동안 배경 음악은 아주 작게 유지하다가, 대화 한 턴이 모두 끝난 뒤에 펼쳐지도록 합니다.
다음은 두 사람의 대화를 다룬 창작 프롬프트 예시로, 아직 오디오로 생성하지 않은 초안입니다. 기차역 사례를 바탕으로 소녀의 대답을 추가한 것이며, 이에 상응하는 연기가 담긴 영상과 함께 사용해야 합니다.
Create one complete eight-second sound scene at a quiet railway platform. Two adult characters speak in natural British English.
Alex: a warm, low male voice, a few feet offscreen, quietly surprised. Maya: a softer, brighter female voice, nearby, calm and quietly certain.
Begin with faint wind and sparse piano. Alex says only: "You waited." After he finishes, leave a brief pause for Maya's reaction. Maya then replies only: "I said I would." Keep each voice distinct and consistent. Speak only the quoted dialogue; do not read the character names or instructions. No overlapping dialogue or extra speakers. Keep the piano very quiet during both lines. Let it open gently only after Maya finishes, leaving room for the final reaction.
먼저 화면을 보지 않고 두 캐릭터의 목소리가 구분되는지 들어본 뒤, 샷과 대조해 대사가 뒤바뀌지 않았는지, 불필요한 문장이 추가되지 않았는지, 멈춤 시간은 충분한지, 입모양이 잘 맞는지 확인합니다.
여러 턴의 대화가 이어질 때 음색이 섞이거나 화자가 뒤바뀌는 현상이 나타나면, 먼저 한 턴의 문답으로 줄여 생성한 뒤 이어지는 대화를 구간별로 나누어 처리할 수 있습니다. 각 구간에는 동일한 캐릭터 묘사를 재사용하고, 이어 붙인 뒤 음색, 환경음, 음악이 자연스럽게 연결되는지 확인하세요. 텍스트 묘사만으로는 구간 간 목소리가 완전히 일치한다고 보장할 수 없습니다.
Part 05|오디오 트랙 편집
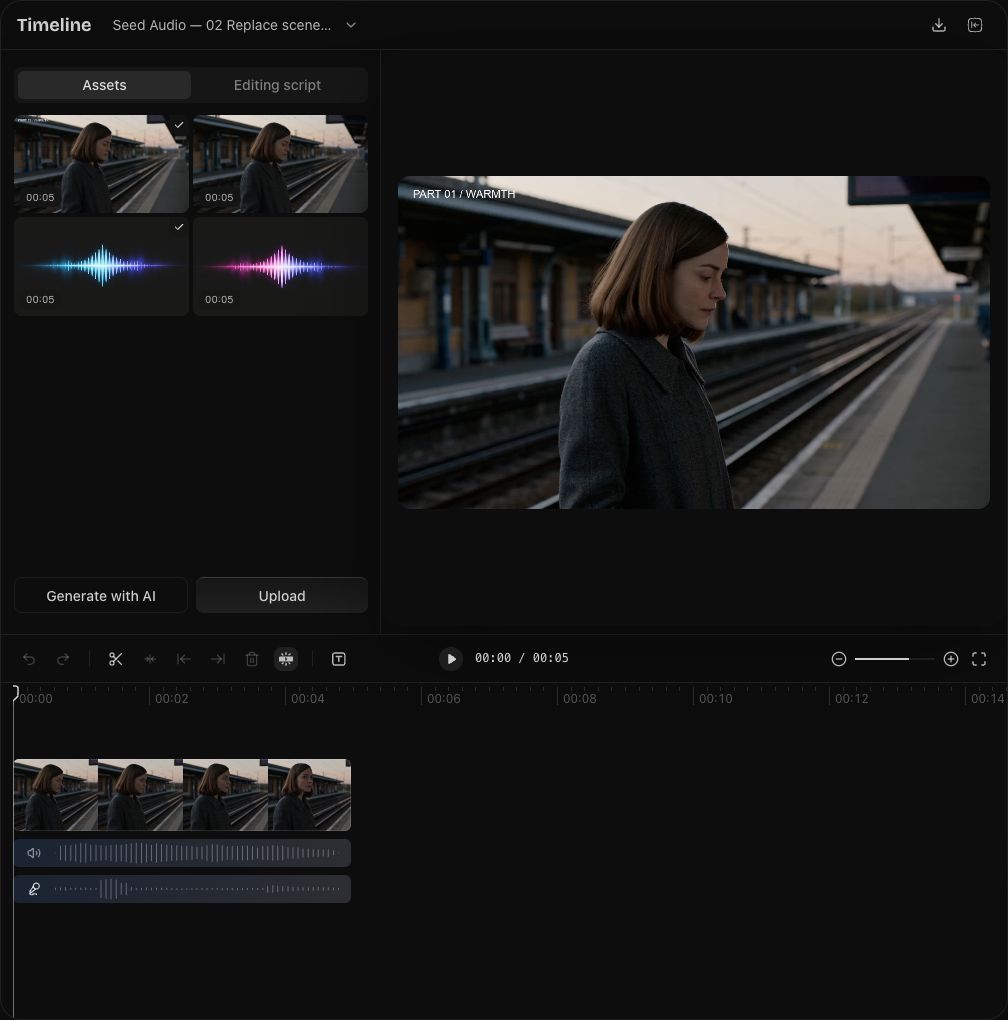
위 이미지는 Arcloop에서의 작업 예시입니다. 상단의 5초 영상을 유지한 채 원본 오디오 트랙을 음소거하고, 하단에 Seed Audio로 생성한 완성형 사운드 클립을 추가해 대사, 환경음, 배경 음악이 한꺼번에 원본 오디오를 대체하도록 했습니다. 오디오 위치를 드래그해 대사와 인물의 반응을 맞춘 뒤 전체를 재생하며 연결이 자연스러운지 확인합니다.
생성한 것이 순수 배경 음악이나 환경음뿐이라면 오디오 트랙을 하나 새로 추가하기만 하면 됩니다. 영상에서 필요한 대사와 원본 오디오는 그대로 남겨두고, 새 오디오를 아래에 배치해 시작 및 종료 위치와 볼륨을 조정합니다. 인물이 말할 때는 배경 트랙에 볼륨 키프레임을 추가해 입을 열기 전에 낮추고, 말하는 동안 유지했다가, 문장 끝의 멈춤 이후에 다시 올라오도록 조절할 수 있습니다.
배경음과 인물 대사가 모두 포함된 완성형 클립을 생성했다면 해당 위치의 원본 오디오를 교체합니다. 영상과 원본 오디오 트랙을 분리한 뒤, 교체할 범위에서 기존 오디오를 잘라내어 음소거하거나 제거하고 새 오디오를 정렬해 같은 대사가 두 번 재생되지 않도록 합니다. 나머지 구간의 원본 오디오는 계속 유지합니다.
교체 후에는 대사와 입모양, 반응이 잘 맞는지, 클립의 시작과 끝이 갑자기 튀지 않는지 확인하고, 필요한 경우 짧은 페이드 효과를 넣어 환경음이 자연스럽게 이어지도록 만듭니다. 목소리와 음악이 이미 하나의 파일에 믹싱되어 있을 때는 전체 볼륨을 낮추면 목소리도 함께 작아집니다. 두 소리의 밸런스를 조정해야 한다면 다시 생성하거나 독립된 오디오 트랙을 사용해 믹싱할 수 있습니다.
Seed Audio 모델 페이지를 열고 결정적인 클립 하나부터 시작해 보세요. 누가 무엇을 말할지, 소리는 어떠해야 할지, 언제 뒤로 물러날지 정한 뒤 영상에 다시 넣어 들어보시기 바랍니다.