Filmmusik und Sprachaufnahmen verleihen KI-Kurzfilmen den letzten Schliff. Videomodelle können zwar Bild und Ton gleichzeitig ausgeben, sind aber keine spezialisierten Werkzeuge für die Audiogenerierung. Wer die klangliche Qualität seines Films gezielt aufwerten möchte, greift daher auf ein eigenständiges Audiomodell zurück. Dieser Artikel zeigt am Beispiel von Seed Audio, wie Sie maßgeschneiderte Klangfragmente für Ihren Film erstellen.
Hören Sie sich zunächst ein Szenenbeispiel von der Modellseite von Seed Audio an:
Dieser Clip verbindet den räumlichen Nachhall der Stimme, eine ausdrucksstarke emotionale Darbietung und passende Hintergrundmusik. Achten Sie beim Anhören darauf, wie die Endsilben ausklingen, wie sich die Sprachmelodie hebt und senkt und wie die Musik das Schauspiel trägt. Genau an solchen Details lohnt sich der Feinschliff, wenn Sie den Ton für Schlüsselmomente separat gestalten.
Der Ablauf ist klar: Stellen Sie zuerst das Bild fertig, wählen Sie die Szenen aus, die klanglich verstärkt werden sollen, generieren Sie den Ton, prüfen Sie die Wirkung direkt im Clip und schneiden Sie das Ergebnis anschließend final zusammen.
Part 01|Einsatzszenarien für Seed Audio
Videomodelle können beim Rendern der Bilder gleich den Ton mitliefern. Doch der emotionale Ausdruck wichtiger Dialoge, feine Sprechpausen sowie das Zusammenspiel von Hintergrundgeräuschen und Figuren erreichen dabei nicht immer die Wirkung, die eine Szene eigentlich braucht. Wenn das Bild bereits überzeugt, der Dialog aber noch flach wirkt oder sich die Geräuschkulisse nicht wie gewünscht abstimmen lässt, lohnt es sich, den Ton separat nachzubearbeiten.
Video-Prompts beschreiben vor allem Bildkomposition, Bewegung, Kameraführung und Einstellungsgrößen – für detaillierte Audioanweisungen bleibt dort wenig Platz. Sobald das Bild steht, können Sie Szenen mit besonderem darstellerischem Gewicht an ein Audiomodell wie Seed Audio übergeben und dort gezielt festlegen, wie eine Zeile gesprochen wird, wie der Hintergrund mitspielt und wie sich der zeitliche Ablauf entfaltet.
| Was verstärkt werden soll | Was sich gezielt gestalten lässt |
|---|---|
| Schlüsseldialoge und Emotionen | Ob derselbe Satz entschuldigend, tastend oder überrascht klingt; wo die Betonung liegt und wie lange vor und nach dem Sprechen pausiert wird |
| Zusammenspiel von Stimme und Hintergrund | Musik nimmt sich während des Sprechens zurück und entfaltet sich erst nach einer kurzen Pause am Satzende; Schritte und Wind bleiben dezent im Hintergrund |
| Spezifische Szenengeräusche | Schritte außerhalb des Bildes, Klopfen, laufende Mechanik oder das Solo eines bestimmten Instruments samt Spielweise und Klangfarbe |
| Emotionale Wendepunkte | Bei identischem Bild verändert ein warmer, trauriger oder bedrohlicher Klang komplett, wie das Publikum eine Begegnung deutet |
Legen Sie Dialoge und Figurenbeziehungen bereits während der Videoproduktion fest und ergänzen Sie den Ton anschließend für ausgewählte Szenen – so können Sie gelungene Videoaufnahmen problemlos weiterverwenden. Ist der Originalton einer Einstellung bereits stimmig, behalten Sie ihn bei; ersetzen Sie hingegen Dialoge, sollten Sie Länge und Lippenbewegungen abgleichen und darauf achten, dass sich alter und neuer Dialog nicht überlagern.
Diese drei Musikvarianten wurden jeweils separat generiert und zum Vergleich unter dieselbe fünfsekündige Videoaufnahme gelegt. Hier sind die drei im fertigen Video verwendeten Prompts:
WARMTH: Warmes Klavier in Dur und sanfte Streicher geben dem Warten eine hoffnungsvolle Antwort.
Create a five-second instrumental film-music cue for a quiet reunion at an old European railway station. Begin immediately with gentle, sparse piano in a warm major harmony. Around the middle, a soft sustained string chord opens with a little hope, as a waiting woman notices someone arriving offscreen. End softly and reassuringly. Intimate and restrained, no big climax. Music only: no speech, narration, singing, voices, station ambience, sound effects or percussion. Do not read the instructions aloud.
SORROW: Cello, eine absteigende Moll-Melodie und ein unaufgelöster Schluss verleihen der Begegnung einen Hauch von Wehmut.
Create a five-second instrumental film score that immediately conveys grief and a painful reunion. Start at once with an expressive solo cello playing a clearly descending minor-key melody, supported by dark sustained violas. Let the melody fall and linger as if someone realizes a loved relationship is lost. Strongly sorrowful and emotionally exposed, intimate rather than epic. No cheerful or comforting resolution. Keep the music clearly audible throughout, ending with an unresolved sustained note. Music only. No speech, singing, voices, piano, ambience or sound effects.
DANGER: Repetitive tiefe Streicher, ein Basspuls, dissonante hohe Lagen und ein abrupter Abbruch ins Stille lassen die sich nähernde Person außerhalb des Bildes bedrohlich wirken.
Create a five-second instrumental psychological-thriller score with unmistakable immediate danger. From the very first moment, use a tight repeating low-string ostinato and a deep controlled bass pulse. Add close, tense dissonant high strings, building rapidly in density as someone threatening approaches offscreen. Make the tension clear and urgent rather than faint background atmosphere. During the final half-second abruptly cut the music to silence. No jump-scare impact. Music only. No speech, singing, voices, gentle piano, warm harmony, ambience or literal sound effects.
Vor jedem Abschnitt steht eine 0,75 Sekunden lange Titelkarte; der gesamte Vergleich dauert rund 17,25 Sekunden. Achten Sie beim Anhören darauf, wie derselbe aufschauende Blick durch die drei Musikstücke nacheinander als Erleichterung, Bedauern und Wachsamkeit gelesen wird.
Part 02|Prompts für Seed Audio schreiben
Ein guter Audio-Prompt klärt drei Dinge: was gesagt wird, wie es klingt und wann es geschieht.
Die API-Dokumentation zur Audiogenerierung enthält ein Beispiel für einen spannungsgeladenen Dialog: Ein vibrierendes Handy eröffnet die Szene, im Hintergrund zwitschern durchgehend Vögel, während eine Marimba zusammen mit elektronischen Klängen Spannung aufbaut; zwei Männer sprechen abwechselnd, und am Ende treiben Fahrzeuggeräusche und Schritte die Handlung voran. Figuren, Musik und Klangereignisse werden dabei in einem einzigen Prompt zusammengeführt.
| Prompt-Element | Umsetzung im Dokumentationsbeispiel | Was Sie für Ihren eigenen Clip angeben sollten |
|---|---|---|
| Inhalt: Wer sagt was | Weist den beiden Männern jeweils ihren Text und die Sprechreihenfolge zu | Rollenname, exakter Wortlaut, Sprache sowie der Hinweis, ob jemand antwortet |
| Klang: Wie es zu hören ist | Unterscheidet zwischen einer tiefen, vollen und einer rauen, reifen Männerstimme samt Akzent; benennt Hauptinstrument und Begleitung | Stimmfarbe, Tonfall, räumliche Distanz der Figuren, Umgebung und Instrumente – statt nur pauschal „filmisch“ zu schreiben |
| Timing: Wie es sich entfaltet | Beginnt mit einem Signalgeräusch, entfaltet dann den Dialog; Nachfragen und Erklärungen verändern den Tonfall, am Ende folgen Bewegungsgeräusche | Einsatzzeitpunkt des Sprechens, Sprechtempo, Pausen zwischen Sätzen sowie Auf- und Abblenden des Hintergrunds |
Für das Wiedersehen am Bahnhof lässt sich die Struktur auf eine einfache Formel bringen: ein präziser Satz + eine konkrete darstellerische Haltung + ein klarer klanglicher Wendepunkt. Der Mann außerhalb des Bildes sagt lediglich „You waited.“ – mit leiser, zurückhaltender Nähe und einem Klavier, das sich erst nach dem Satzende öffnet, um den Moment der Begegnung zu tragen.
Die klangliche Abfolge der Bahnhofsszene lautet: leichter Wind und Klavier → zwei leise Schritte → die Männerstimme spricht, während die Musik ganz leise bleibt → kurze Pause → das Klavier entfaltet sich.
Setzen Sie den gesprochenen Text in Anführungszeichen und vermerken Sie ausdrücklich, dass die junge Frau nicht antwortet; die Schritte müssen leiser sein als die Stimme, und Durchsagen oder Zuggeräusche bleiben komplett außen vor. Formulieren Sie zuerst diese Verhältnisse klar aus und ergänzen Sie dann ungefähre Zeitangaben passend zur Cliplänge. Prüfen Sie das zeitliche Timing anschließend anhand des generierten Ergebnisses – insbesondere die genauen Einsatzpunkte von Musik und Geräuschen.
Wenn eine Szene ein Marimba-Solo erfordert, beschreiben Sie Instrument, Anschlagcharakter, Tempo, Notendichte und die Art des Ausklangs. Hier ist ein eigener Prompt-Entwurf zum Ausprobieren, der noch nicht als Hörbeispiel generiert wurde:
Create an eight-second solo marimba cue for a quiet, suspenseful scene. Use soft mallets and a warm wooden tone. Begin with sparse, slow notes and clear gaps between them. Gradually make the repeating pattern slightly more insistent, then stop before the final beat and leave a short silence. No voices, drums, synthesizers or other instruments.
Die Dramaturgie folgt hier dem Muster „spärlich → etwas drängender → plötzliche Stille“. Instrumentierung, Spielweise sowie das Ein- und Aussetzen des Klangs lassen sich Punkt für Punkt überprüfen; ob Klangfarbe und Rhythmus in der Praxis tragen, entscheidet jedoch immer der Hörtest.
Part 03|Ducking bei Dialogen
Ducking bedeutet, die Hintergrundmusik abzusenken, sobald eine Figur spricht, und sie nach Ende des Satzes wieder anzuheben. In einer ruhigen Wiedersehensszene lässt sich neben der Lautstärke auch die Dichte der Begleitung reduzieren, damit die Aufmerksamkeit ganz bei den Figuren bleibt.
Wenn Sie Stimme und Hintergrund mit Seed Audio in einem Durchgang generieren, schreiben Sie dieses Verhältnis direkt in den Prompt:
Während der Mann leise „You waited.“ sagt, bleibt das Klavier sehr zurückhaltend, der Wind tritt in die Ferne zurück und die Schritte sind bereits verstummt. Nach dem Satz folgt eine kurze Pause, bevor sich das Klavier sanft öffnet und die Reaktion der jungen Frau auffängt.
Schreiben Sie nicht einfach nur „automatisches Ducking“. Geben Sie präzise an, wer klar verständlich sein muss, welche Geräusche Platz machen und wann sie wieder einsetzen – und prüfen Sie anschließend, ob das Modell dies umgesetzt hat. In unserem Beispiel wurden all diese Abstufungen in einer einzigen Generierung gemeinsam erzeugt.
Enthält Ihr Video bereits Dialoge, können Sie auch den Originalton als Referenz heranziehen und genau beschreiben, welche Stimmfarbe, Textzeilen und Rhythmen erhalten bleiben sollen und wo Tonfall oder Hintergrundbalance angepasst werden müssen. Hören Sie sich das Ergebnis zusammen mit dem Bild an und ersetzen Sie dann die Originaltonspur des entsprechenden Abschnitts; wie der Schnitt im Detail funktioniert, erfahren Sie in Part 05.
Das Bild stammt weiterhin aus der mit Seedance 2 Fast erzeugten fünfsekündigen Bahnhofseinstellung: Die junge Frau wartet mit gesenktem Blick und schaut dann zu jemandem außerhalb des Bildes auf. Die Männerstimme spricht nur diesen einen Satz, leise Schritte deuten das Herannahen an, und das Klavier nach der Zeile fängt ihre stumme Reaktion auf.
Für diesen Ton wurde der folgende Prompt verwendet. Angefordert wurden acht Sekunden, damit vor und nach dem Satz genügend Raum für Schritte, Pause und das Aufblühen der Musik bleibt:
Create one complete eight-second cinematic sound scene at a quiet old European railway platform at dusk. Generate dialogue, subtle footsteps, outdoor ambience and piano music together as one coherent scene. At the beginning, a very gentle distant breeze and sparse soft warm piano establish quiet anticipation. Between about 1.0 and 2.1 seconds, exactly two very soft, unhurried shoe footsteps approach offscreen on dry concrete and stop a few feet away. The footsteps are a delicate background detail, much quieter than the speaking voice, never sharp, heavy or dramatic. Around 2.5 seconds, one adult man just offscreen speaks a single short line in natural, clear British English, with quiet surprise and restrained affection: "You waited." Only those two words, only one male speaker. Keep the music very soft around his words so his intimate delivery remains clear. After the line, leave a brief emotional pause with faint breeze. From about 4.8 seconds, let the piano gently open into a warm sustained chord, supporting the woman's silent reaction, then settle quietly at eight seconds. No additional dialogue, no reply, no narration, no singing, no announcements, no loud trains, no impact sounds. Do not speak these directions. Preserve the quiet intimacy of the reunion throughout.
Das generierte Original-Audio ist acht Sekunden lang; für den fertigen Clip wurde der durchgehende Ausschnitt von Sekunde 1,8 bis 6,8 herausgeschnitten und unter das fünfsekündige Video gelegt. In der Nachbearbeitung wurde lediglich die Gesamtlautstärke angepasst sowie am Anfang und Ende kurz ein- und ausgeblendet – es wurden weder Stimme, Schritte oder Musik separat überlagert noch nachträgliches Ducking auf Einzelspuren angewendet.
Prüfen Sie beim Anhören drei Punkte: Ist der Satz klar verständlich, sind die Schritte dezent genug und entfaltet sich die Musik wirklich erst nach dem Sprechen? Falls eines dieser Kriterien noch nicht passt, passen Sie den Prompt gezielt an dieser Stelle an und behalten Sie das bereits abgenommene Bild bei.
Part 04|Dialoge mit mehreren Sprechern
Bei Prompts für mehrere Figuren müssen Rollennamen, Stimmfarben, Textzuordnungen und Sprechreihenfolge eindeutig miteinander verknüpft sein. Testen Sie die Stimmen der beiden Figuren zunächst mit einem kurzen Wortwechsel, bevor Sie längere Dialoge schreiben.
| Rolle | Stimme und Schauspiel | Text in diesem Durchgang |
|---|---|---|
| Alex, Mann außerhalb des Bildes | Eher tiefe, warme erwachsene Männerstimme, natürliches britisches Englisch, leicht überrascht | „You waited.“ |
| Maya, junge Frau im Bild | Hellere, weiche erwachsene Frauenstimme, natürliches britisches Englisch, ruhig und bestimmt | „I said I would.“ |
Verwenden Sie die Rollennamen im gesamten Prompt konsistent und kennzeichnen Sie Satz für Satz, wer gerade spricht. Trennen Sie dabei Stimmfarbe und Spielweise: Dieselbe Person kann erst überrascht und dann erleichtert klingen, sollte aber durchgehend als dieselbe Figur erkennbar bleiben.
Lassen Sie nach dem Satz von Alex einen kurzen Moment für Mayas Reaktion, bevor Maya antwortet. Sollen beide nacheinander sprechen, schließen Sie Überlappungen ausdrücklich aus; verlangt die Szene hingegen eine Unterbrechung, geben Sie genau an, wer wen bei welchem Wort unterbricht. Während beide sprechen, bleibt die Hintergrundmusik sehr leise und öffnet sich erst, nachdem der gesamte Wortwechsel beendet ist.
Hier ist ein eigener Prompt-Entwurf für zwei Sprecher, der noch nicht als Hörbeispiel generiert wurde. Er erweitert das Bahnhofsbeispiel um die Antwort der jungen Frau und setzt entsprechendes Bildmaterial voraus, in dem sie auch sichtbar spricht:
Create one complete eight-second sound scene at a quiet railway platform. Two adult characters speak in natural British English.
Alex: a warm, low male voice, a few feet offscreen, quietly surprised. Maya: a softer, brighter female voice, nearby, calm and quietly certain.
Begin with faint wind and sparse piano. Alex says only: "You waited." After he finishes, leave a brief pause for Maya's reaction. Maya then replies only: "I said I would." Keep each voice distinct and consistent. Speak only the quoted dialogue; do not read the character names or instructions. No overlapping dialogue or extra speakers. Keep the piano very quiet during both lines. Let it open gently only after Maya finishes, leaving room for the final reaction.
Hören Sie sich das Ergebnis zunächst ohne Bild an, um zu prüfen, ob sich beide Figuren klar unterscheiden lassen. Gleichen Sie erst danach mit dem Video ab, ob die Rollen vertauscht wurden, ob ein zusätzlicher Satz hinzugefügt wurde, ob die Pausen ausreichen und ob der Ton zu den Lippenbewegungen passt.
Falls sich bei längeren Wortwechseln über mehrere Runden hinweg Stimmfarben vermischen oder Sprecher vertauscht werden, verkürzen Sie die Generierung zunächst auf ein einzelnes Frage-Antwort-Paar und erstellen Sie den weiteren Dialog abschnittsweise. Verwenden Sie in jedem Abschnitt exakt dieselben Rollenbeschreibungen und prüfen Sie nach dem Zusammensetzen, ob Stimmfarbe, Raumklang und Musik nahtlos ineinander übergehen – denn reine Textbeschreibungen allein garantieren noch keine hundertprozentige Stimmkonsistenz über mehrere Generierungen hinweg.
Part 05|Tonspuren schneiden
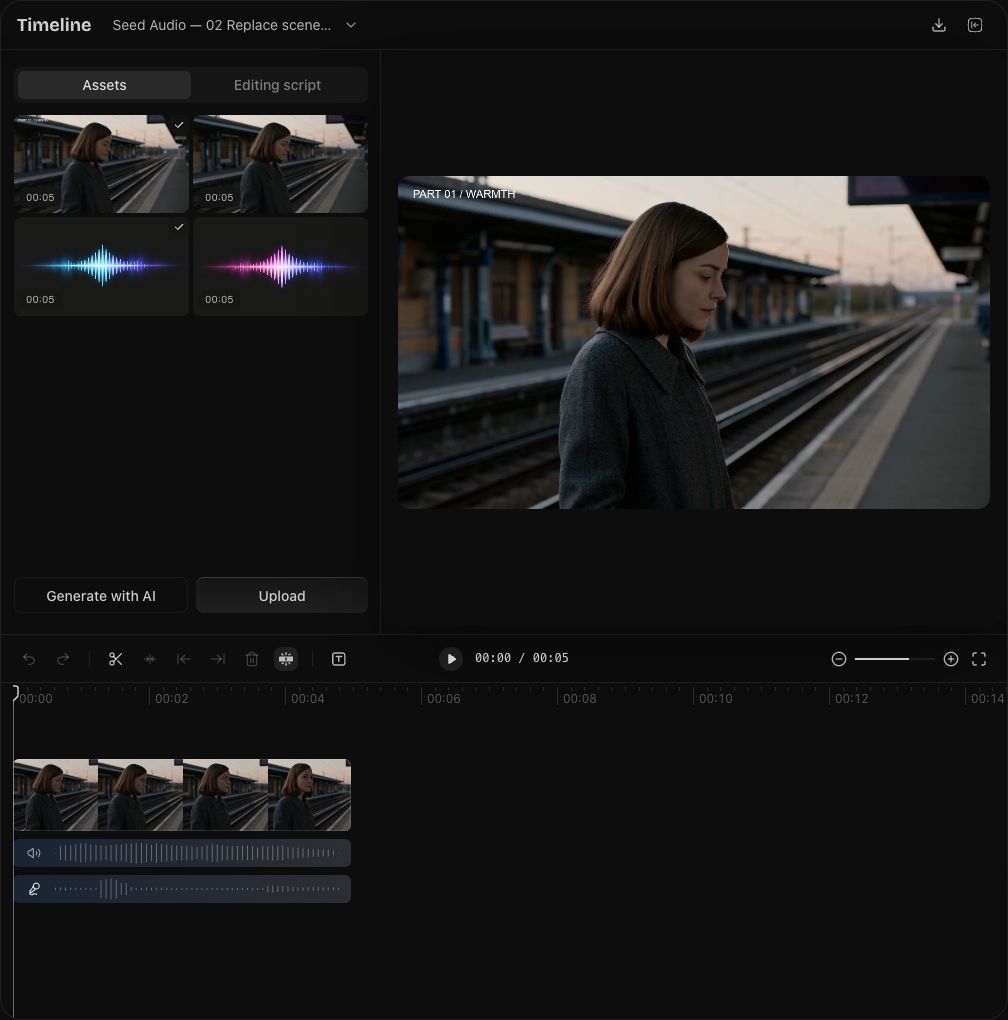
Die Abbildung oben zeigt das Vorgehen am Beispiel von Arcloop: Die fünfsekündige Videospur oben bleibt erhalten, ihre Originaltonspur wird stummgeschaltet, und darunter wird das mit Seed Audio generierte Komplett-Audio eingefügt, sodass Dialog, Umgebungsgeräusche und Musik gemeinsam an die Stelle des Originaltons treten. Verschieben Sie den Audioclip auf der Timeline, bis Textzeile und sichtbare Reaktion der Figur exakt synchron sind, und spielen Sie die Szene anschließend am Stück ab, um die Übergänge zu kontrollieren.
Wenn Sie reine Hintergrundmusik oder Umgebungsgeräusche generiert haben, genügt eine zusätzliche Tonspur. Behalten Sie die benötigten Dialoge und Originalgeräusche des Videos bei, legen Sie das neue Audio darunter und passen Sie Start- und Endpunkt sowie die Lautstärke an. Spricht eine Figur, können Sie auf der Hintergrundspur Lautstärke-Keyframes setzen: kurz vor Sprechbeginn absenken, während des Sprechens niedrig halten und nach der Pause am Satzende wieder anheben.
Haben Sie hingegen eine komplette Szene inklusive Hintergrundklang und gesprochenem Dialog generiert, ersetzen Sie den Originalton an der entsprechenden Stelle. Trennen Sie Video- und Originaltonspur, schneiden Sie den zu ersetzenden Bereich frei, schalten Sie das alte Audio dort stumm oder entfernen Sie es und richten Sie den neuen Clip präzise aus, damit derselbe Satz nicht doppelt zu hören ist. In allen übrigen Einstellungen bleibt der Originalton erhalten.
Prüfen Sie nach dem Austausch, ob Dialog, Lippenbewegungen und Reaktionen zusammenpassen und ob es am Anfang oder Ende des Clips zu abrupten Sprüngen kommt; fügen Sie bei Bedarf kurze Blenden hinzu, damit die Umgebungsgeräusche weich ineinanderfließen. Da Sprache und Musik hier bereits in einer einzigen Datei abgemischt sind, senkt eine Reduzierung der Gesamtlautstärke immer auch die Stimme ab. Wenn Sie das Verhältnis zwischen beiden nachträglich ändern möchten, generieren Sie den Clip entweder neu oder arbeiten Sie mit getrennten Einzelspuren für die Mischung.
Öffnen Sie die Modellseite von Seed Audio und beginnen Sie mit einer Schlüsselszene: Legen Sie fest, wer was sagt, wie es klingen soll und wann der Hintergrund Platz macht – und prüfen Sie die Wirkung anschließend direkt in Ihrem Video.