La música y el doblaje son el toque final de un cortometraje generado con IA. Aunque los modelos de vídeo ya pueden generar imagen y sonido a la vez, no son herramientas especializadas en creación de audio. Si quieres llevar la factura de tu película al siguiente nivel, conviene recurrir a un modelo de generación de sonido independiente. En este artículo tomamos como ejemplo Seed Audio para mostrar cómo generar fragmentos de audio a medida para tus escenas.
Para empezar, escucha este ejemplo de escena sonora de la página del modelo Seed Audio:
Este audio combina la reverberación espacial de la voz, una interpretación cargada de matices emocionales y la música de fondo. Al escucharlo, fíjate en cómo se sostienen los finales de frase, cómo sube y baja la entonación y cómo la música acompaña la actuación. Estos detalles son justo los que merece la pena pulir cuando se diseña el sonido por separado para los momentos clave de la historia.
El flujo consiste en terminar primero la imagen, elegir los momentos que necesitan refuerzo, generar el sonido, colocarlo de nuevo sobre el plano para probarlo y, por último, editar.
Part 01|Casos de uso de Seed Audio
Los modelos de vídeo pueden generar sonido al mismo tiempo que la imagen, pero la interpretación emocional de un diálogo clave, las pausas sutiles o el equilibrio entre el sonido de fondo y los personajes no siempre alcanzan lo que pide la escena. Cuando el plano ya funciona bien pero al diálogo le falta intención, o no consigues ajustar el ambiente al punto exacto que buscas, merece la pena reforzar el sonido por separado.
Los prompts de vídeo se usan sobre todo para describir la imagen, la acción, el movimiento de cámara y la planificación, por lo que queda poco espacio para detallar el audio. En las escenas que requieren una interpretación especial, una vez fijada la imagen, puedes recurrir a un modelo de generación de sonido como Seed Audio para centrarte en describir cómo se dice la frase, cómo acompaña el fondo y cómo evoluciona el ritmo.
| Qué necesita refuerzo | Qué se puede diseñar a medida |
|---|---|
| Frases clave y emoción | Si una misma frase suena a disculpa, tanteo o sorpresa; dónde cae el acento y cuánto dura la pausa antes y después de hablar |
| Equilibrio entre voz y fondo | Que la música ceda espacio cuando habla el personaje y se abra tras el silencio al final de la frase; que los pasos y el viento se mantengan en segundo plano |
| Sonidos específicos de la escena | Pasos fuera de campo, golpes en una puerta, maquinaria en marcha o el solo de un instrumento concreto, su técnica de ejecución y su timbre |
| Giros emocionales | Con el mismo plano visual, usar un sonido cálido, triste o amenazante para cambiar cómo interpreta el espectador un encuentro |
Define primero las frases y la relación entre los diálogos durante la fase de generación de vídeo, y refuerza después el sonido de los fragmentos seleccionados; así podrás seguir aprovechando los planos que ya te convencen. Si el audio original ya funciona, consérvalo; al sustituir diálogos, comprueba la duración y la sincronía labial, y evita que la frase nueva se solape con la antigua.
Estas tres piezas musicales se generaron por separado y se colocaron bajo el mismo plano de cinco segundos para compararlas. Estos son los tres prompts exactos utilizados en el vídeo final:
WARMTH: un piano cálido en modo mayor y cuerdas suaves hacen que la espera encuentre respuesta.
Create a five-second instrumental film-music cue for a quiet reunion at an old European railway station. Begin immediately with gentle, sparse piano in a warm major harmony. Around the middle, a soft sustained string chord opens with a little hope, as a waiting woman notices someone arriving offscreen. End softly and reassuringly. Intimate and restrained, no big climax. Music only: no speech, narration, singing, voices, station ambience, sound effects or percussion. Do not read the instructions aloud.
SORROW: el violonchelo, una melodía descendente en modo menor y un final sin resolver tiñen el reencuentro de pesar.
Create a five-second instrumental film score that immediately conveys grief and a painful reunion. Start at once with an expressive solo cello playing a clearly descending minor-key melody, supported by dark sustained violas. Let the melody fall and linger as if someone realizes a loved relationship is lost. Strongly sorrowful and emotionally exposed, intimate rather than epic. No cheerful or comforting resolution. Keep the music clearly audible throughout, ending with an unresolved sustained note. Music only. No speech, singing, voices, piano, ambience or sound effects.
DANGER: bajos repetitivos, pulso grave, cuerdas disonantes y un corte a silencio al final hacen que quien llega fuera de campo resulte amenazante.
Create a five-second instrumental psychological-thriller score with unmistakable immediate danger. From the very first moment, use a tight repeating low-string ostinato and a deep controlled bass pulse. Add close, tense dissonant high strings, building rapidly in density as someone threatening approaches offscreen. Make the tension clear and urgent rather than faint background atmosphere. During the final half-second abruptly cut the music to silence. No jump-scare impact. Music only. No speech, singing, voices, gentle piano, warm harmony, ambience or literal sound effects.
Cada fragmento va precedido de una cartela de 0,75 segundos, sumando unos 17,25 segundos en la comparativa completa. Al escucharlo, fíjate en cómo un mismo gesto de levantar la mirada se interpreta sucesivamente como alivio, pesar o alerta según la música.
Part 02|Cómo escribir prompts en Seed Audio
Al redactar un prompt de sonido hay que dejar claras tres cosas: qué se dice, cómo suena y cuándo ocurre.
La documentación de la API de generación de audio incluye un ejemplo de diálogo de suspense: la vibración de un móvil abre la escena, el canto de los pájaros se mantiene de fondo y una marimba combinada con timbres electrónicos crea tensión; dos hombres hablan por turnos y, al final, el sonido de un vehículo y unos pasos impulsa la acción. Todo —personajes, música y eventos sonoros— se describe dentro de un mismo prompt.
| Elemento del prompt | Cómo lo resuelve el ejemplo de la documentación | Qué indicar al escribir tu propio fragmento |
|---|---|---|
| Contenido: quién dice qué | Especifica por separado las frases de los dos hombres y el orden en que hablan | Nombre del personaje, frase literal palabra por palabra, idioma y si alguien responde o no |
| Sonido: cómo se percibe | Distingue entre una voz masculina grave y densa y otra ronca y madura, indica el acento y define el instrumento principal y el acompañamiento | Timbre, tono emocional, distancia del personaje, entorno e instrumentos, evitando limitarse a poner «cinematográfico» |
| Ritmo: cómo se desarrolla | Empieza con un efecto sonoro que sitúa la acción, sigue con el diálogo —donde las preguntas y explicaciones cambian el tono— y cierra con sonidos de movimiento | Momento de entrada de la voz, velocidad de locución, pausas entre frases y entrada o salida del fondo |
Tomando como ejemplo el reencuentro en la estación, podemos fijar primero la fórmula: una frase exacta + una interpretación concreta + un giro sonoro claro. El hombre fuera de campo solo dice "You waited.", expresando el reencuentro con una voz baja, una cercanía contenida y un piano que se abre al terminar la frase.
La secuencia sonora del caso de la estación es: brisa suave y piano → dos pasos suaves → la voz masculina habla mientras la música se mantiene muy baja → breve pausa → el piano se despliega.
La frase se marca entre comillas y se especifica que la chica no responde; los pasos deben sonar más flojos que la voz, sin que entren anuncios de megafonía ni ruidos de trenes. Primero se dejan claras estas relaciones y luego se añaden tiempos aproximados según la duración del plano; las indicaciones temporales deben comprobarse siempre frente al resultado generado, sobre todo en los puntos exactos donde caen la música y los efectos.
Si una escena pide un solo de marimba, basta con detallar el instrumento, la textura del golpeo, el tempo, la densidad de notas y la forma de cerrar. A continuación tienes un prompt original de prueba que aún no ha sido generado para escucha:
Create an eight-second solo marimba cue for a quiet, suspenseful scene. Use soft mallets and a warm wooden tone. Begin with sparse, slow notes and clear gaps between them. Gradually make the repeating pattern slightly more insistent, then stop before the final beat and leave a short silence. No voices, drums, synthesizers or other instruments.
Aquí la progresión rítmica es «notas espaciadas → ligera insistencia → silencio repentino». El instrumento, la forma de tocar y la entrada o salida del sonido se pueden verificar punto por punto, aunque comprobar si la textura y el ritmo funcionan de verdad siempre dependerá de escucharlo.
Part 03|Ducking en los diálogos
El ducking consiste en atenuar la música de fondo cuando habla un personaje y recuperarla cuando termina su frase. En una escena de reencuentro tranquila, además de bajar el volumen, también se puede hacer que el acompañamiento sea más espaciado para dejar todo el protagonismo auditivo a los personajes.
Cuando uses Seed Audio para generar la voz y el fondo al mismo tiempo, incorpora esta relación directamente en el prompt:
Cuando el hombre dice en voz baja "You waited.", el piano se mantiene muy suave, el viento queda relegado a lo lejos y los pasos ya se han detenido. Tras la frase, deja una breve pausa antes de que el piano se abra suavemente para recoger la reacción de la chica.
No escribas simplemente «ducking automático». Especifica quién debe escucharse con claridad, qué sonidos ceden espacio y en qué momento vuelven a subir, y luego comprueba si el modelo lo ha cumplido. En nuestro ejemplo, todas estas relaciones se resolvieron de una sola vez en la misma generación.
Si el vídeo ya cuenta con diálogo, también puedes extraer el audio original como referencia y describir qué timbre, texto y ritmo quieres conservar, así como qué matices de entonación o relación con el fondo necesitas ajustar. Tras generarlo, pruébalo sobre la imagen y sustituye la pista de audio original de ese fragmento; encontrarás los detalles de edición en la Part 05.
La imagen reutiliza el plano de estación de cinco segundos generado con Seedance 2 Fast: la chica espera con la cabeza baja y luego levanta la mirada hacia fuera de campo. La voz masculina pronuncia una única frase, unos pasos suaves indican que alguien se acerca y el piano posterior a la frase sostiene la reacción silenciosa de ella.
Para este sonido se utilizó exactamente el siguiente prompt. Al generarlo se pidieron ocho segundos para dejar margen suficiente a los pasos previos, la pausa posterior a la frase y el desarrollo musical:
Create one complete eight-second cinematic sound scene at a quiet old European railway platform at dusk. Generate dialogue, subtle footsteps, outdoor ambience and piano music together as one coherent scene. At the beginning, a very gentle distant breeze and sparse soft warm piano establish quiet anticipation. Between about 1.0 and 2.1 seconds, exactly two very soft, unhurried shoe footsteps approach offscreen on dry concrete and stop a few feet away. The footsteps are a delicate background detail, much quieter than the speaking voice, never sharp, heavy or dramatic. Around 2.5 seconds, one adult man just offscreen speaks a single short line in natural, clear British English, with quiet surprise and restrained affection: "You waited." Only those two words, only one male speaker. Keep the music very soft around his words so his intimate delivery remains clear. After the line, leave a brief emotional pause with faint breeze. From about 4.8 seconds, let the piano gently open into a warm sustained chord, supporting the woman's silent reaction, then settle quietly at eight seconds. No additional dialogue, no reply, no narration, no singing, no announcements, no loud trains, no impact sounds. Do not speak these directions. Preserve the quiet intimacy of the reunion throughout.
El audio original dura ocho segundos, de los cuales para el vídeo final se recortó el tramo continuo entre el segundo 1,8 y el 6,8 para encajarlo en el plano de cinco segundos; en posproducción solo se ajustó el volumen general del clip y se aplicaron breves fundidos de entrada y salida, sin superponer voces, pasos ni música por separado, y sin hacer ducking por pistas independientes.
Al escucharlo, comprueba tres cosas: si la frase se entiende con claridad, si los pasos son lo bastante sutiles y si la música espera a que termine de hablar para abrirse. Si falla alguno de estos puntos, corrige esa indicación concreta en el prompt manteniendo el plano visual ya validado.
Part 04|Diálogos entre varios personajes
En los prompts con varios personajes hay que vincular con claridad cada personaje, su timbre, qué frase le corresponde y el orden de intervención. Lo más práctico es validar primero las voces de ambos con un breve intercambio de una sola réplica antes de añadir más texto.
| Personaje | Voz e interpretación | Frase en este turno |
|---|---|---|
| Alex, hombre fuera de campo | Voz masculina adulta grave y cálida, inglés británico natural, con un punto de sorpresa | “You waited.” |
| Maya, chica en plano | Voz femenina adulta más clara y suave, inglés británico natural, serena y firme | “I said I would.” |
Mantén los mismos nombres de personaje durante todo el prompt e indica frase por frase quién habla. Separa la descripción del timbre de la actuación: una misma persona puede sonar primero sorprendida y luego aliviada, pero debe seguir reconociéndose como el mismo personaje.
Después de que hable Alex, deja un pequeño margen para la reacción de Maya antes de que ella conteste. Si quieres que hablen por turnos, especifica que no se pisen; si el guion pide una interrupción, aclara quién corta a quién y a partir de qué frase. Mientras hablan los dos, la música de fondo debe mantenerse muy baja y abrirse solo cuando termine todo el intercambio.
A continuación se muestra un ejemplo de prompt original para dos voces, que aún no ha sido generado para escucha. Parte del caso de la estación y añade la respuesta de la chica, por lo que requeriría acompañarse de un plano donde ella realice esa actuación:
Create one complete eight-second sound scene at a quiet railway platform. Two adult characters speak in natural British English.
Alex: a warm, low male voice, a few feet offscreen, quietly surprised. Maya: a softer, brighter female voice, nearby, calm and quietly certain.
Begin with faint wind and sparse piano. Alex says only: "You waited." After he finishes, leave a brief pause for Maya's reaction. Maya then replies only: "I said I would." Keep each voice distinct and consistent. Speak only the quoted dialogue; do not read the character names or instructions. No overlapping dialogue or extra speakers. Keep the piano very quiet during both lines. Let it open gently only after Maya finishes, leaving room for the final reaction.
Escúchalo primero sin mirar la imagen para comprobar si se distinguen bien los dos personajes; luego contrástalo con el plano para verificar que no se hayan intercambiado las frases, que no sobre texto, que las pausas den tiempo suficiente y que encaje con el movimiento de labios.
Si al encadenar varios turnos de conversación se confunden los timbres o se cruzan los hablantes, acórtalo primero a un único par de pregunta y respuesta y genera el resto del diálogo por bloques separados. Reutiliza exactamente las mismas descripciones de personaje en cada bloque y revisa al unirlos que el timbre, el ambiente y la música mantengan la continuidad, ya que la descripción por texto por sí sola no garantiza que las voces suenen idénticas entre distintas generaciones.
Part 05|Edición de pistas de audio
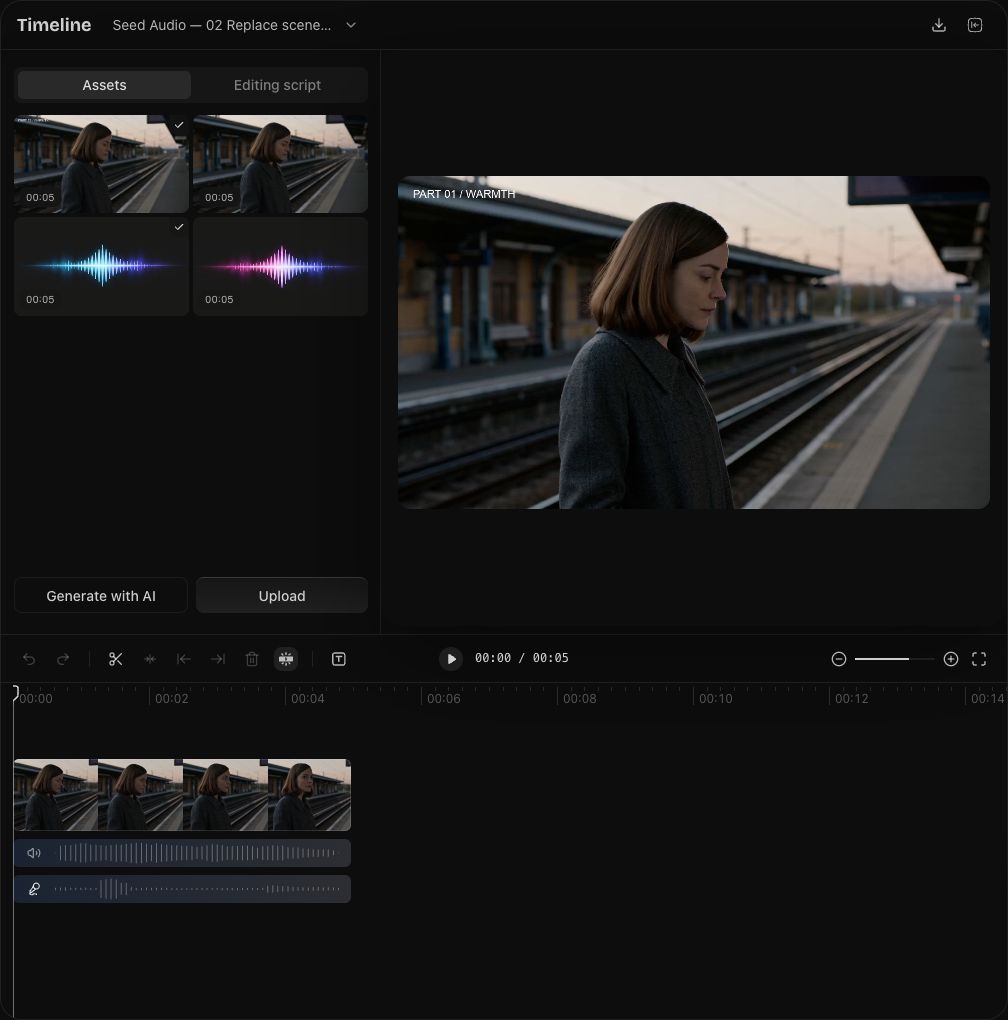
La imagen superior muestra el proceso en Arcloop: se conserva arriba el plano de vídeo de cinco segundos, se silencia su pista de audio original y se añade debajo el clip de sonido completo generado con Seed Audio para que el diálogo, el ambiente y la música sustituyan juntos al sonido de origen. Basta con arrastrar el clip de audio para alinear la frase con la reacción del personaje y reproducir el conjunto para revisar la transición.
Si lo que has generado es únicamente música de fondo o sonido ambiente, solo tienes que añadir una pista nueva. Conserva los diálogos y sonidos originales del vídeo que te interesen, coloca el nuevo audio debajo y ajusta sus puntos de entrada, salida y volumen. Cuando hable un personaje, puedes añadir fotogramas clave de volumen en la pista de fondo: baja el nivel justo antes de que empiece a hablar, mantenlo bajo durante la locución y vuelve a subirlo tras la pausa al final de la frase.
Si has generado una escena sonora completa con ambiente y diálogo incluidos, sustituye el audio original en ese tramo. Separa el vídeo de su pista de audio original, corta y silencia o elimina el audio antiguo en el segmento que vayas a reemplazar y alinea el audio nuevo para evitar que la misma frase suene dos veces. En el resto de planos puedes conservar el sonido original.
Tras la sustitución, comprueba que el diálogo cuadre con la boca y las reacciones, y que no haya cortes bruscos al principio ni al final del clip; si hace falta, aplica breves fundidos para que el sonido ambiente enlace con naturalidad. Ten en cuenta que, cuando la voz y la música vienen ya mezcladas en un mismo archivo, bajar el volumen general reducirá también la voz; si necesitas cambiar el equilibrio entre ambas, puedes volver a generar el clip o trabajar la mezcla con pistas independientes.
Abre la página del modelo Seed Audio y empieza por un momento clave de tu corto: define quién dice qué, cómo debe sonar y cuándo cede espacio el fondo, y llévalo de vuelta a tu vídeo para escucharlo en contexto.