劇伴とセリフは、AIショートフィルムの完成度を決定づける重要な要素です。動画生成モデルは映像と音声を同時に出力できるようになりましたが、音声生成に特化したツールではありません。作品の質感をさらに高めたい場合は、独立した音声生成モデルを取り入れる必要があります。本記事では、Seed Audioを例に、映像に合わせた専用の音声クリップを生成する方法を解説します。
まずは、Seed Audioのモデルページにあるシーン音声のサンプルを聴いてみましょう。
この音声では、声の空間的な残響、鮮明な感情表現、そしてBGMがひとつにまとまっています。試聴する際は、語尾の余韻がどう残るか、口調がどう変化するか、そして音楽がどのように演技に寄り添っているかに注目してみてください。こうしたディテールは、重要なシーンの音声を個別にデザインする際にもこだわりたいポイントです。
まずは映像を完成させ、強化したいシーンを選んでから音声を生成し、カットに戻して試聴したうえで最終的な編集を行います。
Part 01|Seed Audioの活用シーン
動画生成モデルは映像と同時に音声も生成できますが、重要なセリフの感情表現や微妙な間、環境音・BGMと登場人物とのバランスが、そのシーンで求められる水準に達しないことがあります。映像は良くできているのに会話が今ひとつだったり、背景音を思い通りに調整できなかったりする場合は、音声を個別に作り込む価値があります。
動画プロンプトは主に画面構成、動き、カメラワーク、カット割りを記述するために使われるため、音声の指定に割ける文字数には限りがあります。重点的に表現したい部分については、映像が確定した後にSeed Audioのような音声生成モデルに任せ、セリフの言い回し、背景音の合わせ方、テンポの展開を集中的に記述するとよいでしょう。
| 強化したい要素 | 個別にデザインできること |
|---|---|
| 重要なセリフと感情 | 同じ一言でも謝罪、探り、驚きのどれを含ませるか。どこにアクセントを置き、話し始める前後にどれくらい間を取るか |
| 声と背景音のバランス | 人物が話している間は音楽を抑え、文末の余白の後に再び広げる。足音や風の音は背景にとどめる |
| シーン内の特定の音 | 画面外の足音、ノック、機械の稼働音、あるいは特定の楽器の独奏、奏法、音色 |
| 感情の転換 | 同じ映像でも、温かさ、悲しみ、危険を感じさせる音によって、出会いのシーンに対する観客の解釈を変える |
動画制作の段階でセリフと会話の関係性を決めておき、選んだクリップの音声を後から補強すれば、すでに満足している映像をそのまま活かせます。元の音声が適切ならそのまま残し、セリフを差し替える場合は尺と口元の動き(リップシンク)を確認して、新旧のセリフが重ならないようにします。
これら3つの音楽は個別に生成し、同じ5秒間の映像に合わせて比較したものです。以下は、完成した動画で実際に使用した3つのプロンプトです。
WARMTH:温かみのある長調のピアノと柔らかな弦楽で、待ち続けた思いが報われる感覚を表現します。
Create a five-second instrumental film-music cue for a quiet reunion at an old European railway station. Begin immediately with gentle, sparse piano in a warm major harmony. Around the middle, a soft sustained string chord opens with a little hope, as a waiting woman notices someone arriving offscreen. End softly and reassuringly. Intimate and restrained, no big climax. Music only: no speech, narration, singing, voices, station ambience, sound effects or percussion. Do not read the instructions aloud.
SORROW:チェロ、下降する短調のメロディ、未解決のまま終わる響きによって、再会に悔恨の情を添えます。
Create a five-second instrumental film score that immediately conveys grief and a painful reunion. Start at once with an expressive solo cello playing a clearly descending minor-key melody, supported by dark sustained violas. Let the melody fall and linger as if someone realizes a loved relationship is lost. Strongly sorrowful and emotionally exposed, intimate rather than epic. No cheerful or comforting resolution. Keep the music clearly audible throughout, ending with an unresolved sustained note. Music only. No speech, singing, voices, piano, ambience or sound effects.
DANGER:反復する低音、パルス、不協和音のストリングス、そして最後の無音によって、画面外から近づく人物の危険性を際立たせます。
Create a five-second instrumental psychological-thriller score with unmistakable immediate danger. From the very first moment, use a tight repeating low-string ostinato and a deep controlled bass pulse. Add close, tense dissonant high strings, building rapidly in density as someone threatening approaches offscreen. Make the tension clear and urgent rather than faint background atmosphere. During the final half-second abruptly cut the music to silence. No jump-scare impact. Music only. No speech, singing, voices, gentle piano, warm harmony, ambience or literal sound effects.
各パートの前に0.75秒のタイトルカードが入り、比較動画全体は約17.25秒です。試聴する際は、目を上げる同じ仕草が、3種類の音楽によってそれぞれ「安堵」「悔恨」「警戒」としてどのように異なって解釈されるかに注目してみてください。
Part 02|Seed Audioのプロンプトの書き方
音声プロンプトを書くときは、「何を言うか」「どう聴こえるか」「いつ起きるか」の3点を明確にします。
音声生成APIのドキュメントには、サスペンス調の会話サンプルが掲載されています。スマートフォンのバイブレーション音でシーンが始まり、背景では鳥のさえずりが続く中、マリンバと電子音がサスペンス感を醸成し、2人の男性が交互に話し、最後は車と足音で動きを進めるというものです。この例では、登場人物、音楽、サウンドイベントが1つのプロンプトにまとめられています。
| プロンプトの要素 | ドキュメントのサンプルでの扱い | 自分のクリップを書くときに記述する内容 |
|---|---|---|
| 内容:誰が何を言うか | 2人の男性それぞれのセリフと話す順番を指定 | キャラクター名、一言一句そのままのセリフ、言語、返答の有無 |
| 音響:どのように聴こえるか | 低く厚みのある声と、かすれた渋い男性の声を区別し、アクセントを指定。主旋律の楽器と伴奏を明確化 | 声質、口調、人物の距離感、環境音と楽器(「映画風」といった曖昧な表現は避ける) |
| テンポ:どのように展開するか | きっかけとなる効果音から会話を始め、問い詰めと弁明で口調を変化させ、最後に動きの音へつなげる | 話し始めるタイミング、話す速さ、文と文の間、背景音のフェードイン・フェードアウト |
駅での再会シーンを例にとると、まずは「正確な一文のセリフ+具体的な演技+明確な音の変化」を決めます。画面外の男性は「You waited.」とだけ言い、低く抑えた親密な声のトーンと、文末で広がるピアノによって再会を表現します。
この駅のケースにおける音の順序は、「そよ風とピアノ → 軽い足音が2回 → 男性が話し、音楽はごく小さく保たれる → 短い間 → ピアノが広がる」となります。
セリフは引用符で囲み、女性は返答しないことを明記します。足音は声より小さくし、構内アナウンスや列車の音は入れません。まずこうした関係性を明確に書いてから、カットの尺に合わせておおよその時間を補足します。時間指定については、特に音楽や効果音が入る具体的なタイミングを生成結果と照らし合わせて確認してください。
クリップにマリンバの独奏が必要な場合は、楽器、打鍵の質感、演奏のテンポ、音の密度、終わり方を具体的に記述します。以下は試作用のオリジナルプロンプトです(音声はまだ生成していません)。
Create an eight-second solo marimba cue for a quiet, suspenseful scene. Use soft mallets and a warm wooden tone. Begin with sparse, slow notes and clear gaps between them. Gradually make the repeating pattern slightly more insistent, then stop before the final beat and leave a short silence. No voices, drums, synthesizers or other instruments.
ここでの展開は「まばらな音 → 少し緊迫感を増す → 突然の余白」となっており、楽器、奏法、音の出入りを項目ごとに確認できます。ただし、質感やテンポが狙い通りに成立しているかどうかは、実際に試聴して判断する必要があります。
Part 03|セリフにおけるダッキング(Ducking)
ダッキング(Ducking)とは、登場人物が話している間はBGMの音量を下げ、セリフが終わったら元に戻す手法のことです。静かな再会シーンでは、音量を下げるだけでなく、伴奏の音数を減らして聴覚上の焦点を人物に集めることも有効です。
Seed Audioで声と背景音を同時に生成する場合は、この関係性をプロンプトに書き込んでおきます。
男性が低い声で「You waited.」と言うとき、ピアノはごく静かに保たれ、風の音は遠くに退き、足音はすでに止まっている。セリフの後に短い間を置き、そこからピアノをそっと広げて女性の反応を受け止める。
単に「自動ダッキング」とだけ書くのは避けましょう。誰の声をはっきり聴かせる必要があるのか、どの音が控えめになるのか、いつ元の音量に戻るのかを明確に記述し、モデルがその通りに生成できているかを確認します。今回の例では、こうしたバランスがすべて1回の生成でまとめて処理されています。
動画にすでにセリフが入っている場合は、元の音声を切り出してリファレンスにし、維持したい声質、セリフ、テンポと、調整したい口調や背景音とのバランスを明記する方法もあります。生成後に映像と合わせて試聴し、該当箇所の元の音声トラックと差し替えます。具体的な編集手順についてはPart 05で解説します。
映像には、Seedance 2 Fastで生成した5秒間の駅のカット(うつむいて待つ女性が、やがて顔を上げて画面外を見つめるシーン)を引き続き使用しています。男性の声は一言だけで、軽い足音が誰かの接近を示し、セリフの後に広がるピアノが女性の無言の反応を受け止めます。
この音声には、実際に以下のプロンプトを使用しました。セリフ前後の足音、間、そして音楽の広がりに余裕を持たせるため、生成時は8秒間で指定しています。
Create one complete eight-second cinematic sound scene at a quiet old European railway platform at dusk. Generate dialogue, subtle footsteps, outdoor ambience and piano music together as one coherent scene. At the beginning, a very gentle distant breeze and sparse soft warm piano establish quiet anticipation. Between about 1.0 and 2.1 seconds, exactly two very soft, unhurried shoe footsteps approach offscreen on dry concrete and stop a few feet away. The footsteps are a delicate background detail, much quieter than the speaking voice, never sharp, heavy or dramatic. Around 2.5 seconds, one adult man just offscreen speaks a single short line in natural, clear British English, with quiet surprise and restrained affection: "You waited." Only those two words, only one male speaker. Keep the music very soft around his words so his intimate delivery remains clear. After the line, leave a brief emotional pause with faint breeze. From about 4.8 seconds, let the piano gently open into a warm sustained chord, supporting the woman's silent reaction, then settle quietly at eight seconds. No additional dialogue, no reply, no narration, no singing, no announcements, no loud trains, no impact sounds. Do not speak these directions. Preserve the quiet intimacy of the reunion throughout.
元の音声は8秒間ですが、完成した動画ではそのうち連続する1.8〜6.8秒の部分を切り出して5秒間の映像に当てています。編集段階では全体の音量調整と前後の短いフェード処理のみを行っており、声、足音、劇伴を別々に重ねたり、トラックを分けてダッキング処理を行ったりはしていません。
試聴する際は、「セリフがはっきり聴き取れるか」「足音が十分に控えめか」「話し終えた後に音楽が広がるか」の3点を確認します。もしどれかがうまくいっていない場合は、その項目に絞ってプロンプトを修正し、確定済みの映像にそのまま合わせていきます。
Part 04|複数キャラクターの会話
複数キャラクターのプロンプトでは、役名、声質、誰のセリフか、そして会話の順番を明確に対応づける必要があります。まずは短い1往復のやり取りで2人の声を確認してから、セリフを増やしていくのが確実です。
| キャラクター | 声質と演技 | 今回のセリフ |
|---|---|---|
| Alex(画面外の男性) | やや低めで温かみのある成人男性の声、自然なイギリス英語、少し驚いたニュアンス | “You waited.” |
| Maya(画面内の女性) | 明るめで柔らかな成人女性の声、自然なイギリス英語、落ち着いていて芯がある | “I said I would.” |
キャラクター名はプロンプト全体で統一し、誰が話しているかを一文ごとに明記します。声質と演技は分けて記述しましょう。同じ人物が最初に驚き、次に安堵したとしても、同じキャラクターの声に聴こえる必要があります。
Alexが話し終えた後、Mayaが反応するための短い間を置いてから、Mayaに返答させます。2人に交互に話させたい場合は、声が重ならないように指定します。展開上、言葉を遮る必要がある場合は、誰が誰を遮り、どのセリフから割り込むのかを明記します。2人が話している間はBGMをごく小さく保ち、一連の会話が終わってから広がるようにします。
以下は、2人の会話を想定したオリジナルのプロンプト例です(音声はまだ生成していません)。駅のケースをベースに女性の返答を追加したもので、それに対応する演技が含まれた映像と組み合わせて使用します。
Create one complete eight-second sound scene at a quiet railway platform. Two adult characters speak in natural British English.
Alex: a warm, low male voice, a few feet offscreen, quietly surprised. Maya: a softer, brighter female voice, nearby, calm and quietly certain.
Begin with faint wind and sparse piano. Alex says only: "You waited." After he finishes, leave a brief pause for Maya's reaction. Maya then replies only: "I said I would." Keep each voice distinct and consistent. Speak only the quoted dialogue; do not read the character names or instructions. No overlapping dialogue or extra speakers. Keep the piano very quiet during both lines. Let it open gently only after Maya finishes, leaving room for the final reaction.
まずは映像を見ずに音声だけを聴き、2人のキャラクターを聴き分けられるか確認します。その後、映像と照らし合わせて、セリフの順番が逆になっていないか、余計な一言が入っていないか、間が十分か、そして口元の動きと矛盾しないかをチェックします。
何往復も続く会話で声質が混ざったり話者が入れ替わったりする場合は、いったん1往復の質疑応答に短縮して生成し、続く会話はクリップを分けて処理するとよいでしょう。各クリップで同じキャラクター設定を繰り返し使い、つなぎ合わせた後に声質、環境音、音楽が自然につながっているかを確認します。テキストの記述だけでは、複数クリップ間で声が完全に一致することまでは保証されません。
Part 05|音声トラックの編集
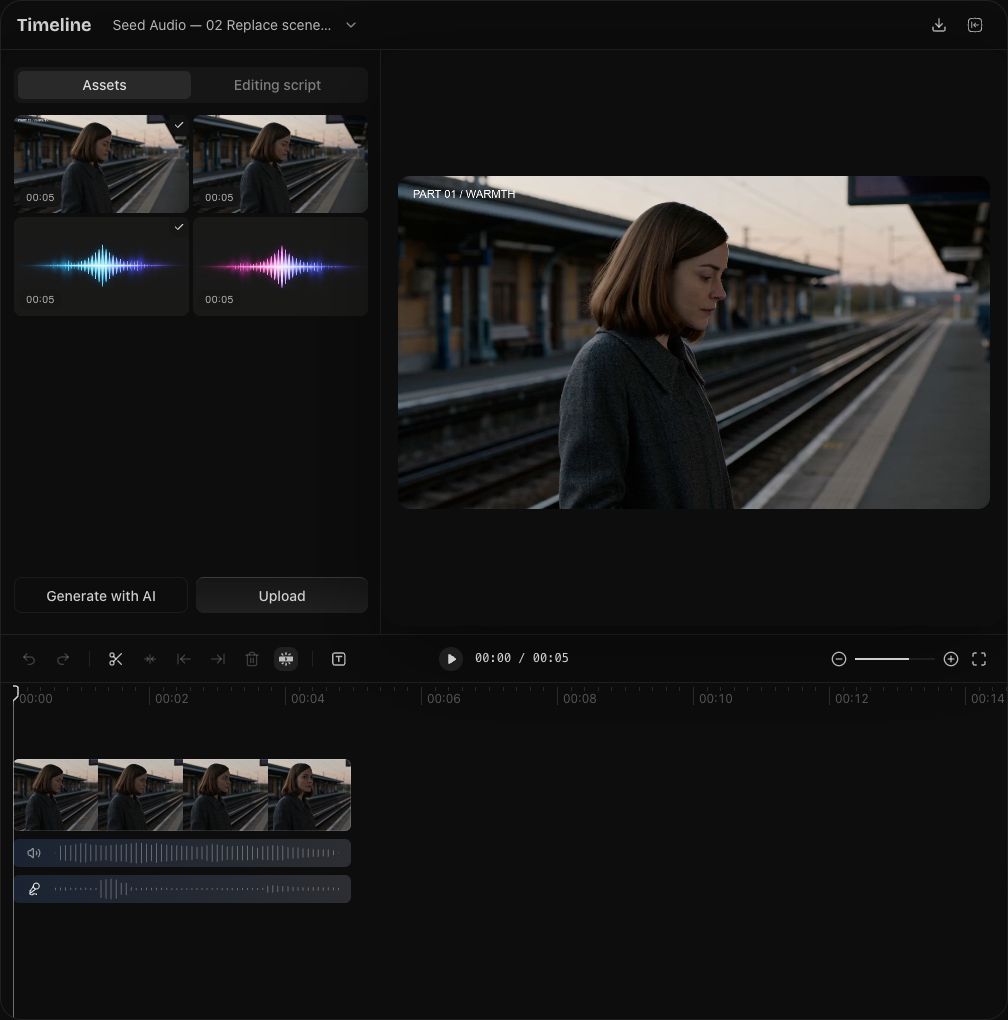
上の画像はArcloopでの操作例です。上段にある5秒間の映像はそのまま残して元の音声トラックをミュートにし、下段にSeed Audioで生成した完成版の音声クリップを追加することで、セリフ、環境音、劇伴をまとめて元の音声と差し替えています。音声の位置をドラッグしてセリフと人物の反応タイミングを合わせ、最初から再生してつながりを確認します。
生成したのがBGMや環境音のみであれば、音声トラックを1本追加するだけで済みます。動画内の必要なセリフや元の音声は残したまま、新しい音声を下段に配置し、開始・終了位置と音量を調整します。人物が話す箇所では、背景音トラックに音量キーフレームを打ち、話し始める前に下げ、話している間は維持し、文末の間を置いてから元に戻すようにします。
背景音と人物のセリフが一体になったクリップを生成した場合は、該当箇所の元の音声を丸ごと差し替えます。動画と元の音声トラックを切り離し、差し替えたい範囲を分割して古い音声をミュートまたは削除したうえで、同じセリフが二重に再生されないよう新しい音声の位置を合わせます。それ以外のクリップの元の音声はそのまま残します。
差し替えた後は、セリフと口元の動きや反応が合っているか、クリップの前後で音が急に途切れたり変わったりしないかを確認します。必要に応じて短いフェード処理を加えると、環境音が自然につながります。声と音楽が1つのファイルにミックスされている場合、全体の音量を下げると声も一緒に小さくなってしまいます。両者のバランスを調整したい場合は、プロンプトを調整して再生成するか、別々の音声トラックを用意してミックスしてください。
Seed Audioのモデルページを開き、まずは重要な1シーンから試してみましょう。誰が何を言い、どんな音で、いつ背景音が控えめになるのかを決めて生成し、動画に戻して聴き比べてみてください。